
线性回归模型检验方法拓展-三大检验
第四章线性回归模型检验方法拓展——三大检验作为统计推断得核心内容,除了估计未知参数以外,对参数得假设检验就是实证分析中得一个重要方面。
对模型进行各种检验得目得就是,改善模型得设定以确保基本假设与估计方法比较适合于数据,同时也就是对有关理论有效性得验证。
一、假设检验得基本理论及准则假设检验得理论依据就是“小概率事件原理”,它得一般步骤就是(1)建立两个相对(互相排斥)得假设(零假设与备择假设)。
(2)在零假设条件下,寻求用于检验得统计量及其分布。
(3)得出拒绝或接受零假设得判别规则。
另一方面,对于任何得检验过程,都有可能犯错误,即所谓得第一类错误P(拒绝H|H0为真)=α与第二类错误P(接受H|H0不真)=β在下图,粉红色部分表示P(拒绝H0|H0为真)=α。
黄色部分表示P(接受H0|H0不Array真)=β。
而犯这两类错误得概率就是一种此消彼长得情况,于就是如何控制这两个概率,使它们尽可能得都小,就成了寻找优良得检验方法得关键。
下面简要介绍假设检验得有关基本理论。
参数显著性检验得思路就是,已知总体得分布(,)F X θ,其中θ就是未知参数。
总体真实分布完全由未知参数θ得取值所决定。
对θ提出某种假设001000:(:,)H H θθθθθθθθ=≠><或,从总体中抽取一个容量为n 得样本,确定一个统计量及其分布,决定一个拒绝域W ,使得0()P W θα=,或者对样本观测数据X ,0()P X W θα∈≤。
α就是显著性水平,即犯第一类错误得概率。
既然犯两类错误得概率不能同时被控制,所以通常得做法就是,限制犯第一类错误得概率,使犯第二类错误得概率尽可能得小,即在0()P X W θα∈≤ 0θ∈Θ得条件下,使得()P X W θ∈,0θ∈Θ-Θ达到最大,或1()P X W θ-∈,0θ∈Θ-Θ达到最小。
其中()P X W θ∈表示总体分布为(,)F X θ时,事件W ∈{X }得概率,0Θ为零假设集合(0Θ只含一个点时成为简单原假设,否则称为复杂原假设)。
0Θ-Θ为备择假设集合,并且0Θ与0Θ-Θ不能相交。
由前述可知,当1H 为真时,它被拒绝(亦即H 0不真时,接受H 0)得概率为β,也就就是被接受(亦即H 0不真时,拒绝H 0)得概率就是1β-(功效),我们把这个接受1H 得概率称为该检验得势。
在对未知参数θ作假设检验时,在固定α下,对θ得每一个值,相应地可求得1β-得值,则定义=1()()P X W θβθ-∈称1βθ-()为该检验得势函数。
统计检验得势(函数)主要用于比较假设检验得优劣。
于就是一个好得检验方程就是00max (),..(),s t βθθβθαθ∈Θ-Θ⎧⎨≤∈Θ⎩ 或 00min(1()),..(),s t βθθβθαθ-∈Θ-Θ⎧⎨≤∈Θ⎩为了理论上得深入研究与表达方便,我们常用函数来表示检验法。
定义函数1,()0,X W X X Wϕ∈⎧=⎨∉⎩它就是拒绝域W 得线性函数,仅取值0或1。
反之,如果一个函数中()X ϕ只取0或1,则{|()1}W X X ϕ==可作为一个拒绝域。
也就就是说,W 与ϕ之间建立了一种对立关系,给出一个ϕ就等价于给出了一个检验法,(我们称ϕ为检验函数)。
那么,对于检验法ϕ得势函数为()()()(,)E X X dF X θβθϕθΦ=Φ=⎰于就是,一个好得检验法又可写为00max (),..(),s t E X θβθθϕαθΦ∈Θ-Θ⎧⎨≤∈Θ⎩称满足上式得检验法为最优势检验(MPT)。
如果对于复杂原假设与备择假设,则称为一致最优势检验(UMPT )。
奈曼—皮尔逊(Neyman Pearson -)基本引理给出于()X ϕ就是MPT 得充要条件。
定理 设1,,n X X 就是来自总体分布密度为(,)p X θ得样本,θ为未知参数,对于简单假设检验问题0011:,:H H θθθθ==,检验函数()X ϕ就是显著性水平为α得最优势检验(MPT)得充要条件就是,存在常数0K ≥,使得()X ϕ满足0()E X θϕα=10101,(,)(,)()0,(,)(,)p X Kp X X p X Kp X θθϕθθ>⎧=⎨<⎩当当这就就是著名得奈曼—皮尔逊基本引理,需要指出得就是,上述定理中得检验函数()X ϕ通常称为似然比检验函数,若记10(,)()(,)p X X p X θλθ=称()X λ为似然比统计量。
如果()X λ较大,意味着1(,)p X θ较大。
所以在0H 为真时观测到样本点X 得可能性比1H 为真时观察到样本点X 得可能性小,因而应拒绝原假设0H ;反之,如果()X λ较小则应接受0H 。
此外,利用()X λ,上述定理中得()X ϕ可写为1,()()0,()X K X X K λϕλ>⎧=⎨<⎩这说明对于简单假设检验问题,似然比检验就是最优得,反之最优势检验法也一定就是似然比检验法。
而大量得文献都已证明了传统假设检验中得Z 检验、t 检验、2χ检验与F 检验都就是最优势检验。
于就是,我们可以放心地回到这部份得主题——计量经济模型得(假设)检验方法。
二、一般线性框架下得假设检验设多元回归模型为122k k Y X X u βββ=++++ (2-43)式(2-43)得统计检验通常包括以下三种情况1、单个系数得显著性检验。
2、若干个回归系数得联合检验。
3、回归系数线性组合得检验。
从检验得方面瞧,考虑以下典型假设01、0:0j H β=。
即解释变量j X 对Y 没有影响,这就是最常见得参数显著性检验。
02、00:j j H ββ= 。
0i β就是某一具体值。
例如j β表示价格弹性,我们也许希望它就是-1。
03、012:1H ββ+=。
这里得β可以瞧成生产函数中资本与劳动得弹性,此时检验就是否规模报酬不变。
04、023:H ββ=或230ββ-=。
即检验2X 与3X 得系数就是否相同。
05、012:0k H βββ===。
即检验全部解释变量都对Y 没有影响。
06、0:0II H β=。
这里得含义就是把β向量分为两个子向量I β与II β,分别含有1k 与2k 个元素。
检验0:0II H β=就就是检验某一些解释变量II X (X 得一部分)对Y 没有影响。
诸如以上得情形都可归于一般得线性框架RB r = (2-44)注意:这里1(,)k B ββ'=。
其中R 就是由已知常数构成得q k ⨯矩阵(q k ≤),r 就是各元素为常数(一般就是0或1)得1q ⨯矩阵。
于就是,对于上述情形,R 得具体表示为(i)(010),0.(1)R r q ===(ii)0(010),.(1)i R r q β===(iii)(1,1,00), 1.(1)R r q === (iv)(0,1,1,0),0.(1)R r q =-==(v),0.()k R I r q k ===(vi)2200,0.()0k R r q k I ⎛⎫=== ⎪⎝⎭ 将上述假设问题一般化,则0:0H RB r -=为了检验这个假设,应先估计出ˆB,计算ˆRB r -,若其值较“小”,(接近于0),则不应否定原假设;而如果其值较大,那么应对0H 提出怀疑。
为此我们先考察ˆRB得分布。
对于OLS 得ˆB,我们知道21ˆ~(,())B N B X X σ-'。
这里得X 就是所有解释变量观测值组成得n k ⨯矩阵,其中不含全就是1得第一列,ˆRB得数学期望与方差分别就是ˆ()E RBRB = 21ˆˆˆˆ()[()()]()Var RBE R B B B B R RVarBR R X X R σ-'''''=--== 所以21ˆ~(,())RBN RB R X X R σ-'' 于就是,在0:0H RB r -=成立得条件下21ˆ~(0,())RBr N R X X R σ-''- 那么,由有关得数理统计知识可知,其中得方差经过构造,服从自由度为q 得卡方分布,q 为参数中非零得个数,即2112ˆˆ()[()]()~()RBr R X X R RB r q σχ--'''-- (2-45) 此外,我们还可以证明22'~()E En k χσ- (残差平方与得分布)。
因此,由上述两式,可构造在0H 下得F 检验统计量11ˆˆ()[()]()~(,)'()RB r R X X R RB r q F F q n k E E n k --'''--=-- (2-46) 注意,2ˆ'()E E n k σ-=(亦即22ˆi e n k σ=-∑)。
于就是,检验得程序就是,如果计算出得F 值大于某个事先选定得临界值,则拒绝0H 。
具体描述如下01、0:0j H β=此时ˆRB 为ˆjβ。
1()R X X R -''为jj c ,即1()X X -'主对角线上得第j 个元素,1()X X -'就是一K 阶对称方阵。
因此222ˆˆ~(1,)ˆˆˆ()j j jj j F F n k c Var ββσβ==- (2-47) 取平方根 ˆ~()ˆˆ()j j t t n k se ββ=-,这就就是传统得关于回归参数显著性得t 检验法。
02、00:j j H ββ=类似01,这里ˆ~()ˆˆ()j j j t t n k se βββ-=- (2-48)此时也可以计算,比如j β得95%置信区间,而不用检验关于j β得具体假设,这个置信区间就是0.025ˆˆˆ()j jt se ββ±。
03、012:1H ββ+=ˆRB 给出了两个估计系数得与12ˆˆββ+,而此时1111222()2R X X R c c c -''=++,式中1()ij X X c -'=,R=(1,1,,0)。
那么1121111112221122122[()]ˆˆˆˆˆˆˆ[(2)][2(,)][()]ˆR X X R c c c Var Cov Var Var σββββββσ-----''=++=++=+于就是检验统计量为ˆˆ~()t t n k =- (2-49)或者,也可以计算12ββ+得95%置信区间12ˆˆ()t ββ+±04、023:H ββ=类似03,可推得此时得检验统计量为ˆˆ~()t t n k =- (2-50)05、023:0k H βββ===此时 k R I =,0r =,q k =,那么ˆˆ'~(,)'()()B X XB k ESS k F F k n k E E n k RSS n k '==--- (2-51) 这就就是我们熟悉得关于回归方程显著性得F 检验。
经济计量学--习题与解答说课讲解
经济计量学--习题与解答说课讲解目录第一章绪论第二章一元线性回归模型第三章多元线性回归模型第四章违背经典假定的回归模型第五章分布滞后模型第六章虚拟解释变量模型第七章联立方程模型《经济计量分析》模拟试题一《经济计量分析》模拟试题二第一章绪论练习题一、单项选择题1.经济计量学一词的提出者为()A.弗里德曼B.丁伯根C.费瑞希D.萨缪尔森2.下列说法中正确的是()A.经济计量学是经济学、统计学和数学合流而构成的一门交叉学科。
B.经济计量学是经济学、数理统计学和政治经济学合流而构成的一门交叉学科。
C.经济计量学是数理经济学和政治经济学合流而构成的一门交叉学科。
D.经济计量学就是数理经济学。
3.理论经济计量学的主要目的为()A.研究经济变量之间的依存关系B.研究经济规律C.测度由经济计量学模型设定的经济关系式D.进行经济预测4.下列说法中不是应用经济计量学的研究目的为()A.测度经济系统的发展水平B.经济系统结构分析C.经济指标预测D.经济政策评价5.经济计量学的建模依据为()A.统计理论B.预测理论C.经济理论D.数学理论6.随机方程式构造依据为()A.经济恒等式B.政策法规C.变量间的技术关系D.经济行为7.经济计量学模型的被解释变量一定是()A.控制变量B.政策变量C.内生变量D.外生变量8.在同一时点或时期上,不同统计单位的相同统计指标组成的数据是()A.时期数据B.时点数据C.时序数据D.截面数据二、多项选择题1.在一个经济计量模型中,可作为解释变量的有()A.内生变量B.外生变量C.控制变量D.政策变量E.滞后变量2.对经济计量模型验证的准则有()A.最小二乘准则B.经济理论准则C.统计准则D.数学准则E.经济计量准则3.经济计量模型的应用在于()A.设定模型B.检验模型C.结构分析D.经济预测E.规划政策三、名词解释1.经济计量学2.理论经济计量学3.应用经济计量学4.内生变量5.外生变量6.随机方程7.非随机方程8.时序数据9.截面数据四、简答题1.简述经济计量分析的研究步骤。
论高校课堂人数与课堂效果的关系——基于多元线性回归的一个实证检验

目 , 前 相当数量的高校对于基础课或专业基础课采取几 解释变量, 将班级授课规模以外的因素视为控制变量 , 引入 检验授课规模的显著性和偏效应的 个班级合堂授课的方式。这种大班( 超大班) 授课是否影响 到多元线性回归模型中, 授课效果①, 如果具有统计上的显著性, 那么, 影响的机制和 大小, 以此来说明授课班级规模对授课绩效的单独影响。这 途径是什么? 本文对这一问题进行实证分析, 为改善课堂教 种方法的难度在于很难找到适当的变量去表示所列示的各 种因素。 学效果提供参考建议。 幸运的是, 笔者在教学实际工作巾, 遇到一个可以做该
内涵, 本文以期末学生的平时成绩作为学习态度的代理变
收稿 日期 :02— 9— 3 2 1 0 2 基 金项 目 : 育 部人 文 社 会 科 学 研 究 专 项 任 务项 目 ( 校 思 想 政 治 工 作 ) 编 号 :2 D Z 0 7 。 教 高 ( 1J S 3 9 ) 作 者 简 介 : 庆 刚 , 疆 大 学 科 学 技 术 学 院 副教 授 , 济 学 博 士 , 要 从 事 经 济 学教 学 科 研 作 。 孙 新 经 主
一
、
研 究方法
研究的自 然事件。某学期, 对同一学院同一年级的 5 个班教
一
根据以往相关文献… , 影响授课效果的因素大体可分为 授经济管理类的专业基础课——宏观经济学。期末采用同 的试卷 , 笔者也是唯一评卷人。这 5个班分成两个合堂班 三大类 : 学生因素、 教师因素和环境因素( 见表 1。 ) 和一个单独班授课。三个授课单位数量分别为 1 1 9 0人、 3人 表 1 影 响教 学 效 果 因 素 分 类 列 表
中级计量经济学重点
第一章满足经典假定下的参数估计一、基本概念——变量、数据与模型(一)、经济变量具有特定的经济含义影响经济系统的因素,它是构成方程式的最基本要素,变量的基本特征是要求具有可观测和可计量。
1、变量的类型●被解释变量(应变量、因变量)●解释变量(自变量)被解释变量与解释变量之间的关系强调的是单向因果关系,即解释变量影响被解释变量,反之不行。
注:被解释变量为服从正态分布的连续随机变量(这是“经典”的核心)。
●内生变量(强调其随机性和不可控制性)●外生变量(强调其确定性和可控制性)●内生变量与外生变量的关系:外生变量控制影响内生变量,而内生变量不能控制影响外生变量●滞后内生变量(动态变量、能否控制信息)●前定变量=外生变量+滞后内生变量(二)数据1、时间数列数据;2、截面数据;3、面板数据4、虚拟变量数据(离散数据)(三)模型设定1、模型和方程:方程是模型的基本单位;决定方程的两要素是变量的个数和方程的函数形式。
2、在模型设定过程中应注意的问题基于经济理论的认识;模型的数学形式;变量的取舍。
3、计量经济模型对数据质量的基本要求●真实性●可靠性●完整性●一致性●可比性二、在总体回归函数中引入随机扰动项的原因:初级计量P26-27.三、经典假定的内容(一)经典假定1、零均值假定。
2、同方差假定。
3、无自相关假定。
4、解释变量与随机误差项不相关。
5、无多重共线性假定。
6、正态性假定。
还有:回归模型关于参数线性;在重复抽样中X 值是固定的(或X 是非随机的);X 的值要有变异;模型设定是正确的。
(二)多元线性回归模型的基本假定(用矩阵表示)。
1、零均值假定2、同方差和无自相关假定22(|),()(,|,)0,i i i j i j Var u X i j Cov Var U I Cov u u X X i j σσ⎧==⎪-=⎨=≠⎪⎩(条件方差不变、条件自相关等于0)3、随机扰动项与解释变量不相关假定 ()0E X U '=4、无多重共线性假定。
统计学三大检验方法

统计学三大检验方法引言统计学三大检验方法是指假设检验、置信区间估计和方差分析。
这三种方法是统计学中非常重要的工具,用来对样本数据进行分析和推断。
本文将详细介绍这三种方法的原理、应用和步骤。
一、假设检验假设检验是一种基于样本数据对总体参数进行推断的方法。
它的目的是判断样本数据对某一假设的支持程度。
假设检验的步骤可以分为以下几个部分:1.明确研究问题和假设。
首先确定研究的目的和问题,然后提出关于总体参数的假设,包括原假设和备择假设。
2.选择合适的检验统计量。
根据问题和数据的特点,选择适合的检验统计量,如均值差检验的t统计量、比例差检验的z统计量等。
3.设定显著性水平。
显著性水平是在假设检验中用来判断是否拒绝原假设的标准,通常取0.05或0.01。
4.计算检验统计量的观察值。
根据样本数据计算出具体的检验统计量的观察值。
5.给出结论。
通过计算观察值与临界值的比较,得出对原假设的结论,并解释结果的意义。
二、置信区间估计置信区间估计是一种用来对总体参数进行估计的方法。
它通过样本数据计算出的区间,给出了总体参数的一个估计范围。
1.确定置信水平。
置信水平是在置信区间估计中用来描述区间的可靠程度,通常取0.95。
2.选择适合的估计方法。
根据总体参数的类型和样本数据的特点,选择适合的估计方法,如均值估计的t分布、比例估计的正态分布等。
3.计算置信区间。
根据样本数据和所选的估计方法,计算出具体的置信区间,通常采用公式:估计值±临界值×标准差/√n。
4.解释结果。
解释置信区间的意义,并进行合理的解释和讨论。
三、方差分析方差分析是一种用于比较两个或多个组之间差异的方法。
它是通过分解总体方差,分析组内与组间的差异,来判断组间的差异是否显著。
1.确定研究问题。
确定需要比较的组,并明确研究的目的和问题。
2.设定假设。
设定组间差异的原假设和备择假设。
3.计算方差。
计算组内方差和组间方差。
4.计算F统计量。
根据方差计算出F统计量。
《§118 独立性检验》教学讲解课件
(教学讲解课件)
结构性特征值的作用
①频率:……
② 3δ原则:参《选修2-3》P:79~80
已知某组数据Y1,Y2,Y3,……的平均值为μ,标准差为σ 则在正常状态下,可以认为:
①数值Yi分布在区间(μ-σ, μ+σ)内的概率为0.6826 ②数值Yi分布在区间(μ-2σ, μ+2σ)内的概率为0.9544 ③数值Yi分布在区间(μ-3σ, μ+3σ)内的概率为0.9974
3.独立性检验的基本思想:
与反证法很类似 S1:先假设两个变量之间独立(没有关系): S2:然后根据小概率事件原理
检验“假设”是否具有“矛盾”
4.回归分析与独立性检验的区别:
①回归分析重在分析两变量是否具有因果关系 ②独立性检验重在分析两变量是否相互影响
一、有关概念: 二、独立性检验的简介: 三、检验独立性的方法:
<一>.频率法: <二>.等高条形图法: <三>.卡方检验:
1.卡方检验简述: 2.操作步骤及三个细节: 3.书写格式:
概率与统计简述
样本
抽样
估计 推断
总体
回归分析 分布列及期望 相关分析
(独立性检验)
概率 计数
回归分析重在分析两变量是否具有因果关系 相关分析重在分析两变量是否相互影响 (独立性检验)
法1:散点图法:
3.拟合效果的判定:
法2:残差法:
①残差图法: ②残差平方和法:
法3:相关指数R2法:
误差 e (Error)
残差 =真实值-预报值 yi yˆi 点(个体)误差 偏差 =真实值-均值 yi y
回归差 =预报值-均值 yˆi y
随机(整体)误差
详解利用SPSS进行Logistic_回归分析
第8 章利用SPSS 进行Logistic 回归分析现实中的很多现象可以划分为两种可能,或者归结为两种状态,这两种状态分别用0和1 表示。
如果我们采用多个因素对0-1 表示的某种现象进行因果关系解释,就可能应用到logistic 回归。
Logistic 回归分为二值logistic 回归和多值logistic 回归两类。
首先用实例讲述二值logistic 回归,然后进一步说明多值logistic 回归。
在阅读这部分内容之前,最好先看看有关SPSS 软件操作技术的教科书。
§8.1 二值logistic 回归8.1.1 数据准备和选项设置我们研究2005 年影响中国各地区城市化水平的经济地理因素。
城市化水平用城镇人口比重表征,影响因素包括人均GDP、第二产业产值比重、第三产业产值比重以及地理位置。
地理位置为名义变量,中国各地区被分别划分到三大地带:东部地带、中部地带和西部地带。
我们用各地区的地带分类代表地理位置。
第一步:整理原始数据。
这些数据不妨录入Excel 中。
数据整理内容包括两个方面:一是对各地区按照三大地带的分类结果赋值,用0、1 表示,二是将城镇人口比重转换逻辑值,变量名称为“城市化”。
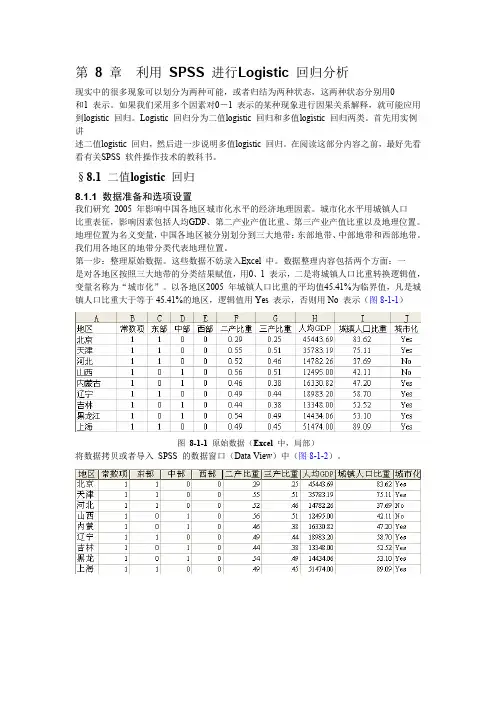
以各地区2005 年城镇人口比重的平均值45.41%为临界值,凡是城镇人口比重大于等于45.41%的地区,逻辑值用Yes 表示,否则用No 表示(图8-1-1)图8-1-1 原始数据(Excel 中,局部)将数据拷贝或者导入SPSS 的数据窗口(Data View)中(图8-1-2)。
图8-1-2 中国31 个地区的数据(SPSS 中,局部)第二步:打开“聚类分析”对话框。
沿着主菜单的“Analyze→Regression→Binary Logistic K”的路径(图8-1-3)打开二值Logistic 回归分析选项框(图8-1-4)。
图8-1-3 打开二值Logistic 回归分析对话框的路径对数据进行多次拟合试验,结果表明,像二产比重、三产比重等对城市化水平影响不显著。
基于线性回归的旅游市场预测方法探析
基于线性回归的旅游市场预测方法探析作者:解芳君魏敏来源:《当代旅游》2012年第04期摘要:旅游管理活动离不开旅游市场预测。
为了更好地发展旅游产业,提高旅游产业的管理水平,旅游市场预测工作是必不可少的。
而由于旅游产品在旅游市场上的易逝性、不可贮存等特点,对旅游市场预测工作提出了更高的要求。
本文对国内外文献进行深入研究,提出了基于线性回归的旅游市场预测的相关方法。
关键词:旅游市场;预测;方法旅游市场预测是分析旅游市场动向,了解旅游市场需求趋势和需求预测,对确定区域旅游发展的方向,制定旅游产品战略和市场战略具有重要的意义。
传统的预测方法过于重视预测的准确性,而忽视了预测方法的可行性以及预测结果的可操作性,因而难以对预测的结果做出科学的检验。
基于简单线性回归视角的旅游市场预测,可以建立科学的预测值评价体系,既可以确保预测值的准确性和稳定性,又可确保预测方法的可行性以及预测结果的可操作性。
因此,本文的旅游市场预测结果可以作为政府旅游产业政策制定的科学依据。
一、引言国际上旅游市场预测开始于20世纪60年代,但快速发展却是在20世纪80年代。
国内外学者对旅游市场预测进行了多角度的探索与研究。
在20世纪90年代之前,大多采用的是传统的定性与定量相结合的研究方法,如时间序列方法、移动平移法等。
而20世纪90年代之后,随着人工智能理论的成熟以及在各行业的广泛应用,学者将这些方法逐渐引入旅游市场预测与评价。
旅游市场预测不是简单的主观意见,它是科学的研究,需要定量和定性结合,预测与现实结合,不断比较,不断修改自己的预测模型,这样才能得到较好的运用。
在预测过程中,要有历史的数据,一般越多越好(数据要确保真实)。
要观察数据的散点图,看数据符合什么的规律。
还要选择合适的方法,有平均移动法、加权移动法、一次指数法、时间序列法,其中要考虑趋势、季节、周期、突发等因素,还有很重要的回归法等等。
同时,分析这些数据你可以选择分析软件,比如excel和spss等等。
如何在R语言中使用Logistic回归模型?
如何在R语⾔中使⽤Logistic回归模型?在实际应⽤中,Logistic模型主要有三⼤⽤途:1)寻找危险因素,找到某些影响因变量的"坏因素",⼀般可以通过优势⽐发现危险因素;2)⽤于预测,可以预测某种情况发⽣的概率或可能性⼤⼩;3)⽤于判别,判断某个新样本所属的类别。
Logistic模型实际上是⼀种回归模型,但这种模型⼜与普通的线性回归模型⼜有⼀定的区别:1)Logistic回归模型的因变量为⼆分类变量;2)该模型的因变量和⾃变量之间不存在线性关系;3)⼀般线性回归模型中需要假设独⽴同分布、⽅差齐性等,⽽Logistic回归模型不需要;4)Logistic回归没有关于⾃变量分布的假设条件,可以是连续变量、离散变量和虚拟变量;5)由于因变量和⾃变量之间不存在线性关系,所以参数(偏回归系数)使⽤最⼤似然估计法计算。
下⾯简单介绍该模型的理论知识,主要参考《统计建模与R软件》:应⽤:接下来使⽤R语⾔实现Logistic模型的应⽤,仍然使⽤《Logistic回归模型——⽅法与应⽤》书中的案例数据。
该数据的应变量表⽰⾼中⽣是否进⼊⼤学,⾃变量包含性别(GENDER)、⾼中类型(KEYSCH,是否为重点中学)和⾼中平均成绩(MEANGR)。
接下来列出⽂中所需R语⾔包:foreign包⽤于导⼊SPSS数据集;sjmisc包⽤于实现Logistic模型的拟合优度检验pROC包⽤于绘制模型的ROC曲线#读取数据发现原本为离散的变量COLLEGE、KEYSCH和GENDER成了数值变量,需要重新将这些变量设置为因⼦变量。
#数据初探:#将数据拆分为训练数据集和测试数据集本⽂对Logistic模型的应⽤使⽤stats包中⾃带的glm()函数,下⾯看看glm()函数的使⽤⽅法:glm(formula, family = gaussian, data, weights, subset,na.action, start = NULL, etastart, mustart, offset,control = list(...), model = TRUE, method = "glm.fit",x = FALSE, y = TRUE, contrasts = NULL, ...)formula指定模型的因变量和⾃变量,类似于y~x1+x2+x3的形式;family指定模型的连接函数和误差函数;data指定要分析的数据框;weights模型拟合中指定先验权重;subset指定数据⼦集⽤于模型拟合;na.action指定缺失值的处理办法,默认跳过缺失值;start⽤于指定参数估计的初始值;control为⼀个列表,指定⼴义线性模型的收敛度,最⼤迭代次数等;#建模由参数估计的结果可知,截距项和三个⾃变量是⾮常显著的。
金融计量学大纲
《金融计量学》课程教学大纲一、课程基本信息课程名称:金融计量学英文名称:Financial Econometrics课程类别:学科基础课学时:45学分:3适用对象: 金融学本科专业考核方式:考试先修课程:高等数学、线性代数、概率统计、统计学、宏观经济学、微观经济学、金融学、投资学、财务管理二、课程简介本课程是金融学的学科基础课,主要为后续的专业课和专业选修课奠定金融学定量分析和实证研究的方法论基础。
其主要内容可以分为三大部分:第一部分是金融计量学基础,主要包括一元线性回归模型、多元线性回归模型、放宽基本假定后的回归模型、虚拟变量模型、非线性模型等内容;第二部分是金融时间序列模型,主要包括单位根检验、自回归移动平均(ARMA)模型、协整检验、修正误差模型(ECM)、广义自回归条件异方差(GARCH)模型等内容;第三部分是金融计量学的应用实例,主要向学生介绍国内学者对于有效市场假说(EMH)、资本资产定价模型(CAPM)和GARCH模型等三个问题所做的研究。
三、课程性质与教学目的本课程是金融学或金融工程本科专业的学科基础课程,教学的主要目的在于向学生介绍现代金融计量学的基础理论、模型和方法,培养学生在经济金融理论的基础上,借助计量分析软件建立金融计量学模型的能力,拓宽学生分析、研究现实经济金融问题的思路,增强学生的数量分析和实际动手能力,从而为对我国金融市场进行实证研究打下坚实的基础。
四、教学内容及要求第一章绪论(一)目的与要求1.介绍计量经济学与金融计量学的基本概念、研究内容及建模步骤2.使学生在总体上对金融计量学建立初步的认识3.使学生充分认识到金融计量学在金融学科中的地位和作用,培养学生的学习兴趣(二)教学内容第一节基本概念1.金融计量学的发展历史与概念2.金融计量学模型3.金融计量学与计量经济学的关系4.计量经济学在经济学科中的地位5.计量经济学与其他学科之间的关系6.金融计量学在金融学中的地位7. 金融计量学的主要研究内容第二节金融计量学模型的建模步骤和要点1.理论模型的设计:确定模型的变量、确定模型的数学形式、确定模型待估参数的期望值2.样本数据的收集:数据的类型、数据质量3.模型参数的估计4.模型的检验:经济意义检验、统计检验、计量经济学检验、模型预测检验5.金融计量学模型成功三要素:理论、方法与数据6.金融计量学应用软件介绍:EViews、SPSS、SAS、GAUSS第三节金融计量学模型的应用1.结构分析2.经济预测3.政策评价4.理论检验与发展(三)思考与实践1.什么是金融计量学?什么是计量经济学?两者的关系是什么?2.计量经济学方法与一般经济数学方法有什么区别?3.为什么说计量经济学是一门经济学科?它在经济学科体系中的作用和地位是什么?4.金融计量学的主要研究内容包括哪些?5. 试结合一个具体金融问题说明建立与应用金融计量学模型的主要步骤。
基于多元线性回归分析的白酒行业股价估量模型——以600519国酒茅台为例
基于线性回归分析的白酒行业股价估量模型——以600519贵州茅台为例一、宏观经济分析通过半个学期的证券投资学学习,我们知道不论是股票发行者还是从购买者,对宏观经济的分析都是必须的。
首先,我们回顾一下近几年的国内市场状况:2011年,我国通胀压力严重,上半年CPI 一直处于高位,2011年四月CPI同比上涨5.3%,5月份CPI同比上涨5.5%。
而面对居高不下的CPI 央行不断上调银行准备金率和存款准备金率。
与此同时我国GDP增速比2010年也有所放缓。
这一点也可以从很小的方面看出来,就本校而言,今年来学校招聘的单位数量较去年前年有很明显的降低,显然是整体经济低迷造成的结果。
而证券交易又面临着自身的难题:以上海证券交易所为例,主要存在以下问题:1.市场规模很小,受众面很窄;2.存在严重的信息不对称,使得监管成本上升;3.缺少卖空机制,使得股票市场泡沫增大;4.流动性不足。
流动性是指市场中存在大量的流通性强的金融工具,同时又有大量参加流通的主体。
5.市场中介机构不完善。
6.不注重投资者回报,几乎没有企业发放红利,使得证券市场只有投机价值而没有投资价值。
这些问题都是严重影响股票合理定价的,所以使得对贵州茅台的股票定价更为困难。
基本为零的每股收益使得传统的红利贴现模型在这里无法适用。
二、白酒行业分析及茅台公司具体分析随着我国居民生活品质的提升和健康消费意识的形成,白酒消费也逐渐回归理想,白酒需求转变为追求健康、品质和品位。
高知名度、高美誉度和高品质度的“三高”白酒称谓精英人士的首选,品牌消费观念正在强化。
贵州茅台高档白酒的品牌价值、定价权优势奠定了高档白酒在激烈的市场竞争中的强势地位。
茅台作为中国高档白酒的代名词,在竞争中处于非常强势的地位。
较高的每股净资产是吸引股票市场投资者的“诱饵”。
另一方面,政府渠道的长期发展使得茅台酒的销路不存在任何问题,所以在整体经济低迷的情况下,茅台酒业的销量也不会有明显的减少。