
卷积神经网络 ppt课件
• 若输入层有 m 个节点,隐层有 n 个节点,那么 Θ = [θT] 为 n×m 的矩阵, x 为长为 m 的向量,b 为长为 n 的向量,激活函数作用在向量的每个分量 上, f(x) 返回一个向量
隐层输出层
可以视为级联在隐层上的一个感知器。若为二分类,则常用 LogisticRegression;若为多分类,则常用Softmax Regression。
• (x)=act( 3 θ(4-i)(4-j)Xijb )
i,j
卷积总结公式:
• 如果卷积层 c 中的一个卷积核j连接到输入图 X1, X2, ..., Xi ,且这个卷
Θ 积核的权重矩阵为 ,那么这个卷积核的输出为 j 这个输出矩阵大小为(m-p+1)(n-q+1).
下采样(池化)
• 下采样,即池化,目的是减小特征图,池化规模一般为2×2。常用的池化 方法有:
核心!权值、偏置估计(结论如下,推导见“卷积神经网络全面 解析”)
• 残差定义:
假设有层 p, q, r ,分别有 l, m, n 个节点,依序
前者输出全连接到后者作为输入。t为标签,Oyp为输出,E为损失函数, 为
p层输出向量,Φ表示激活函数,层 q 有权重矩阵 [Θq]m×l ,偏置向
量 [bq]m×1 ,层 r有权重矩阵 [Θr]n×m ,偏置向量 [br]n×1 。那么
光栅化层
• 从上一层传过来的残差为
• 重新整理成为一系列的矩阵即可,若上一层 Q 有 q 个池化核,则传播到池 化层的残差
池化层
• 对应池化过程中常用的两种池化方案,这里反传残差的时候也有两种上采 样方案:
• 最大池化:将1个点的残差直接拷贝到4个点上。均值池化:将1个点的残 差平均到4个点上。即传播到卷积层的残差
这种方式。
• 对神经中枢 j 的输出 Oj ,使用池化函数 downsample ,池化后的结果为
光栅化
• 图像经过池化下采样后,得到的是一系列的特征图,而多层感知器接受的 输入是一个向量。因此需要将这些特征图中的像素依次取出,排列成一个 向量。具体说,对特征图 X1, X2, ..., Xj ,光栅化后得到的向量
• 其中,运算 w = u○v 表示 wi = uivi 。函数作用在向量或者矩阵上,表示 作用在其每个分量上。
卷积神经网络的三大优点
• 局部感受野
• 权值共享:在卷积神经网中,同一个卷积核内,所有的神经元的权值是相 同的,从而大大减少需要训练的参数。作为补充,在CNN中的每个隐层,一 般会有多个卷积核。
• 另外,还需要一系列的辅助方法,包括:conv2d(二维离散卷积,valid 和full模式),downsample(池化中需要的下采样,两种边界模式), upsample(池化中的上采样)等。
卷积神经网络初步解析
陈遥
单层感知器
• 感知器可谓是最早的人工神经网络。 • 单层感知器是一个具有一层神经元、采用阈值激活函数的前向网络。通过
对网络权值的训练,可以使感知器对一组输人矢量的响应达到元素为0或1 的目标输出,从而实现对输人矢量分类的目的。
单层感知器作用范围
• 感知器是一个简单的二类分类的线性分类模型,要求我们的样本是线性可 分的。
多层感知器
多层感知器的思路是,尽管原始数据是非线性可分的,但是可以通过某种方 法将其映射到一个线性可分的高维空间中,从而使用线性分类器完成分类。 图1中,从X到O这几层,正展示了多层感知器的一个典型结构,即输入层隐 层输出层。
输入层隐层
• 是全连接的网络,即每个输入节点都连接到所有的隐层节点上。更详细地 说,可以把输入层视为一个向量 x ,而隐层节点 j 有一个权值向量 θj 以 及偏置 bj ,激活函数使用 sigmoid 或 tanh ,那么这个隐层节点的输出应 该是
• 池化:在卷积神经网络中,没有必要一定就要对原图像做处理,而是可以 使用某种“压缩”方法,这就是池化,也就是每次将原图像卷积后,都通过 一个池化的过程,来减小图像的规模。
卷积神经网络的正向过程
• 卷积 • 下采样 • 光栅化 • 多层感知器预测。
卷积
• 考虑一个大小为5×5的图像,和一个3×3的卷积核。这里的卷积核共有 9个参数,记为 Θ =[θij]3×3
多层感知器预测
将光栅化后的向量连接到多层感知器
CNN参数更新
多层感知器层
• 残差定义 • 使用多层感知器的参数估计方法,得到其最低的一个隐层 s 的残差向量 • δs 。
• 现在需要将这个残差传播到光栅化层 r ,光栅化的时候并没有对向量的值 做修改,因此其激活函数为恒等函数,其导数为单位向量。
• 对权值和偏置的更新:
卷积层
• 其中,rot180 是将一个矩阵旋转180度; Oq'是连接到该卷积层前的池化 层的输出。
•
卷积层的残差反传?
整体思路
• 以层为单位,分别实现卷积层、池化层、光栅化层、MLP隐层、分类层这 五个层的类。其中每个类都有output和backpropagate这两个方法。
• 最大池化(Max Pooling):取4个点的最大值。这是最常用的池化方法。 • 均值池化(Mean Pooling):取4个点的均值。 • 高斯池化 • 可训练池化:训练函数 f ,接受4个点为输入,输出1个点。不常用。
• 由于特征图的变长不一定是2的倍数,所以在边缘处理上也有两种方案: 忽略边缘。即将多出来的边缘直接省去。 保留边缘。即将特征图的变长用0填充为2的倍数,然后再池化。一般使用
隐层输出层
可以视为级联在隐层上的一个感知器。若为二分类,则常用 LogisticRegression;若为多分类,则常用Softmax Regression。
• (x)=act( 3 θ(4-i)(4-j)Xijb )
i,j
卷积总结公式:
• 如果卷积层 c 中的一个卷积核j连接到输入图 X1, X2, ..., Xi ,且这个卷
Θ 积核的权重矩阵为 ,那么这个卷积核的输出为 j 这个输出矩阵大小为(m-p+1)(n-q+1).
下采样(池化)
• 下采样,即池化,目的是减小特征图,池化规模一般为2×2。常用的池化 方法有:
核心!权值、偏置估计(结论如下,推导见“卷积神经网络全面 解析”)
• 残差定义:
假设有层 p, q, r ,分别有 l, m, n 个节点,依序
前者输出全连接到后者作为输入。t为标签,Oyp为输出,E为损失函数, 为
p层输出向量,Φ表示激活函数,层 q 有权重矩阵 [Θq]m×l ,偏置向
量 [bq]m×1 ,层 r有权重矩阵 [Θr]n×m ,偏置向量 [br]n×1 。那么
光栅化层
• 从上一层传过来的残差为
• 重新整理成为一系列的矩阵即可,若上一层 Q 有 q 个池化核,则传播到池 化层的残差
池化层
• 对应池化过程中常用的两种池化方案,这里反传残差的时候也有两种上采 样方案:
• 最大池化:将1个点的残差直接拷贝到4个点上。均值池化:将1个点的残 差平均到4个点上。即传播到卷积层的残差
这种方式。
• 对神经中枢 j 的输出 Oj ,使用池化函数 downsample ,池化后的结果为
光栅化
• 图像经过池化下采样后,得到的是一系列的特征图,而多层感知器接受的 输入是一个向量。因此需要将这些特征图中的像素依次取出,排列成一个 向量。具体说,对特征图 X1, X2, ..., Xj ,光栅化后得到的向量
• 其中,运算 w = u○v 表示 wi = uivi 。函数作用在向量或者矩阵上,表示 作用在其每个分量上。
卷积神经网络的三大优点
• 局部感受野
• 权值共享:在卷积神经网中,同一个卷积核内,所有的神经元的权值是相 同的,从而大大减少需要训练的参数。作为补充,在CNN中的每个隐层,一 般会有多个卷积核。
• 另外,还需要一系列的辅助方法,包括:conv2d(二维离散卷积,valid 和full模式),downsample(池化中需要的下采样,两种边界模式), upsample(池化中的上采样)等。
卷积神经网络初步解析
陈遥
单层感知器
• 感知器可谓是最早的人工神经网络。 • 单层感知器是一个具有一层神经元、采用阈值激活函数的前向网络。通过
对网络权值的训练,可以使感知器对一组输人矢量的响应达到元素为0或1 的目标输出,从而实现对输人矢量分类的目的。
单层感知器作用范围
• 感知器是一个简单的二类分类的线性分类模型,要求我们的样本是线性可 分的。
多层感知器
多层感知器的思路是,尽管原始数据是非线性可分的,但是可以通过某种方 法将其映射到一个线性可分的高维空间中,从而使用线性分类器完成分类。 图1中,从X到O这几层,正展示了多层感知器的一个典型结构,即输入层隐 层输出层。
输入层隐层
• 是全连接的网络,即每个输入节点都连接到所有的隐层节点上。更详细地 说,可以把输入层视为一个向量 x ,而隐层节点 j 有一个权值向量 θj 以 及偏置 bj ,激活函数使用 sigmoid 或 tanh ,那么这个隐层节点的输出应 该是
• 池化:在卷积神经网络中,没有必要一定就要对原图像做处理,而是可以 使用某种“压缩”方法,这就是池化,也就是每次将原图像卷积后,都通过 一个池化的过程,来减小图像的规模。
卷积神经网络的正向过程
• 卷积 • 下采样 • 光栅化 • 多层感知器预测。
卷积
• 考虑一个大小为5×5的图像,和一个3×3的卷积核。这里的卷积核共有 9个参数,记为 Θ =[θij]3×3
多层感知器预测
将光栅化后的向量连接到多层感知器
CNN参数更新
多层感知器层
• 残差定义 • 使用多层感知器的参数估计方法,得到其最低的一个隐层 s 的残差向量 • δs 。
• 现在需要将这个残差传播到光栅化层 r ,光栅化的时候并没有对向量的值 做修改,因此其激活函数为恒等函数,其导数为单位向量。
• 对权值和偏置的更新:
卷积层
• 其中,rot180 是将一个矩阵旋转180度; Oq'是连接到该卷积层前的池化 层的输出。
•
卷积层的残差反传?
整体思路
• 以层为单位,分别实现卷积层、池化层、光栅化层、MLP隐层、分类层这 五个层的类。其中每个类都有output和backpropagate这两个方法。
• 最大池化(Max Pooling):取4个点的最大值。这是最常用的池化方法。 • 均值池化(Mean Pooling):取4个点的均值。 • 高斯池化 • 可训练池化:训练函数 f ,接受4个点为输入,输出1个点。不常用。
• 由于特征图的变长不一定是2的倍数,所以在边缘处理上也有两种方案: 忽略边缘。即将多出来的边缘直接省去。 保留边缘。即将特征图的变长用0填充为2的倍数,然后再池化。一般使用
合集下载
深度学习课件-卷积神经网络的实现及常用框架
讲解卷积层、池化层和全 连接层等关键组件的工作 原理。
卷积操作和卷积核
详细解释卷积操作的原理, 并介绍不同类型的卷积核 及其应用。
优化函数和Dropout技术
1
优化函数
介绍梯度下降、随机梯度下降(SGD)
Dropout技术
2
和Adam等优化函数及其在CNN中的应 用。
探讨Dropout技术的原理和使用方法,
介绍TensorFlow深度学习框 架的安装、使用和常见应 用场景。
P y Torc h
介绍PyTorch深度学习框架 的安装、使用和特点。
Caffe
介绍Caffe深度学习框架的 安装、使用和适用领域。
深度学习环境构建和配置
1 环境构建
讲解如何搭建适用于深度学习的开发环境,包括硬件和软件要求。
2 配置要点
深度学习课件-卷积神经 网络的实现及常用框架
通过该课件,您将了解卷积神经网络(CNN)的原理和实现,以及常用的深 度学习框架,如TensorFlow、PyTorch、Caffe和Keras等。
卷积神经网络简介
CNN的应用背景
介绍卷积神经网络(CNN) 在图像识别、自然语言处 理等领域的广泛应用。
网络结构和原理
分享在构建深度学习环境时的一些注意事项和常见问题解决方法。
实战案例:手写数字识别
1
问题定义
说明手写数字识别的问题背景和目标。
模型构建
2
详细介绍使用TensorFlow构建CNN模型
的步骤和技巧。
3
模型评估
展示模型在测试集上的准架构,通过增加深度 和小卷积核来提高模型性能的 经典CNN模型。
迁移学习和应用案例
1 迁移学习
探讨如何使用预训练的CNN模型进行迁移学习,以提高模型的训练效 果。
卷积操作和卷积核
详细解释卷积操作的原理, 并介绍不同类型的卷积核 及其应用。
优化函数和Dropout技术
1
优化函数
介绍梯度下降、随机梯度下降(SGD)
Dropout技术
2
和Adam等优化函数及其在CNN中的应 用。
探讨Dropout技术的原理和使用方法,
介绍TensorFlow深度学习框 架的安装、使用和常见应 用场景。
P y Torc h
介绍PyTorch深度学习框架 的安装、使用和特点。
Caffe
介绍Caffe深度学习框架的 安装、使用和适用领域。
深度学习环境构建和配置
1 环境构建
讲解如何搭建适用于深度学习的开发环境,包括硬件和软件要求。
2 配置要点
深度学习课件-卷积神经 网络的实现及常用框架
通过该课件,您将了解卷积神经网络(CNN)的原理和实现,以及常用的深 度学习框架,如TensorFlow、PyTorch、Caffe和Keras等。
卷积神经网络简介
CNN的应用背景
介绍卷积神经网络(CNN) 在图像识别、自然语言处 理等领域的广泛应用。
网络结构和原理
分享在构建深度学习环境时的一些注意事项和常见问题解决方法。
实战案例:手写数字识别
1
问题定义
说明手写数字识别的问题背景和目标。
模型构建
2
详细介绍使用TensorFlow构建CNN模型
的步骤和技巧。
3
模型评估
展示模型在测试集上的准架构,通过增加深度 和小卷积核来提高模型性能的 经典CNN模型。
迁移学习和应用案例
1 迁移学习
探讨如何使用预训练的CNN模型进行迁移学习,以提高模型的训练效 果。
卷积神经网络在图像识别中的应用ppt课件
3. 对S2层的特征图进行卷积得到C3层;
4. 对C3层的特征图进行下采样得到S4层;
5. S4层的特征图光栅化后变成的向量输入到传统的全连接神经网络进行进一步分类,得到输
出;
ppt课件.
5
➢卷积和下采样(降采样)过程
input
*∑
∑ X∑
ppt课件.
6
➢ 卷积过程
11100
01110
101
00111
ppt课件.
12
➢ 程序中可设置的参数
learning_rate = 0.05 batch_size = 40 n_epochs = 100 nkerns = [20, 50]
poolsize = (2, 2)
//学习速率 //一次输入CNN的样本数 //最大训练步数 //第一层卷积核个数为20,
结构组织的用于转化图像的网络Neocognition.
3. 根据Fukushima的观点,LeCun提出了以LeNet为代表的卷积神
经网络。
ppt课件.
3
➢ 卷积神经网络的特点
1. 卷积神经网络是一类特别设计用来处理二维数据的多层神经 网络。
2. 卷积神经网络被认为是第一个真正成功的采用多层层次结构 网络的具有鲁棒性的深度学习方法。
否
是否符
合期望
是
输出结果
ppt课件.
9
Olivetti Faces是纽约大学的一个比较小的人脸库 包含40个人的人脸图片,每个人10张人脸样本,共400份样本
ppt课件.
10
➢ 程序所参考的卷积神经网络结构:LeNet-5
两个“卷积+子采样层”LeNetConvPoolLayer 全连接层相当于MLP(多层感知机)中的隐含层HiddenLayer 输出层采用逻辑回归LogisticRegression
[课件]卷积神经网络CNNPPT
23
1998年LeNet——数字/字符识别
LeNet-5
Feature
map
a set of units whose weighs are constrained to be identical.
24
1998年LeNet——数字/字符识别
例如:C3层参数个数
(3*6+4*9+6*1)*25
33
VGG Net (2014)
K. Simonyan, A. Zisserman. Very deep convolutional networks for large-scale image recognition. arXiv preprint arXiv:1409.1556, 2014
34
140948422014sparseinteractions有限连接kernel比输入小连接数少很多学习难度小计算复杂度低sparseinteractions有限稀疏连接局部连接连接数少很多计算复杂度低层级感受野生物启发parametersharing参数共享tiedweights进一步极大的缩减参数数量equivariantrepresentations等变性配合pooling可以获得平移不变性三个步骤卷积突触前激活net非线性激活detectorpoolinglayer的两种定义复杂定义简单定义pooling10定义没有需要学习的参数replacescertainlocationsummarystatisticnearbyoutputs种类maxpoolingweightedaveragepoolingwhypooling
30
AlexNet for ImageNet
深度的重要性
深度学习卷积神经网络 (4)【精品PPT文档】
1
1. Background
2. Characteristic
3. Transfer Learning
4. MatConvNet
Background
In the 1960s, Hubel and Wiesel propose the local receptive field
when researching the visual cortex of cat.
Convolutions. CVPR 2015.
VGGNet Simonyan K, Zisserman A. A Very Deep Convolutional
Networks for Large-Scale Image Recognition. ICLR 2015.
ResNet He K, Zhang X, Ren S, et al. Deep Residual Learning for Image
MatConvNet
19
20Biblioteka 122imagenet-caffe-alex.mat
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 input conv1 relu1 norm1 pool1 conv2 relu2 norm2 pool2 conv3 relu3 conv4 relu4 conv5 relu5 pool5 fc6 relu6 fc7 relu7 fc8 prob 227x227x3 single 55x55x96 single 55x55x96 single 55x55x96 single 27x27x96 single 27x27x256 single 27x27x256 single 27x27x256 single 13x13x256 single 13x13x384 single 13x13x384 single 13x13x384 single 13x13x384 single 13x13x256 single 13x13x256 single 6x6x256 single 1x1x4096 single 1x1x4096 single 1x1x4096 single 1x1x4096 single 1x1x1000 single 1x1x1000 single
1. Background
2. Characteristic
3. Transfer Learning
4. MatConvNet
Background
In the 1960s, Hubel and Wiesel propose the local receptive field
when researching the visual cortex of cat.
Convolutions. CVPR 2015.
VGGNet Simonyan K, Zisserman A. A Very Deep Convolutional
Networks for Large-Scale Image Recognition. ICLR 2015.
ResNet He K, Zhang X, Ren S, et al. Deep Residual Learning for Image
MatConvNet
19
20Biblioteka 122imagenet-caffe-alex.mat
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 input conv1 relu1 norm1 pool1 conv2 relu2 norm2 pool2 conv3 relu3 conv4 relu4 conv5 relu5 pool5 fc6 relu6 fc7 relu7 fc8 prob 227x227x3 single 55x55x96 single 55x55x96 single 55x55x96 single 27x27x96 single 27x27x256 single 27x27x256 single 27x27x256 single 13x13x256 single 13x13x384 single 13x13x384 single 13x13x384 single 13x13x384 single 13x13x256 single 13x13x256 single 6x6x256 single 1x1x4096 single 1x1x4096 single 1x1x4096 single 1x1x4096 single 1x1x1000 single 1x1x1000 single
卷积神经网络CNN硬件实现PPT课件

卷积神经网络CNN 硬件实现
1
第一部分
整体概述
THE FIRST PART OF THE OVERALL OVERVIEW, PLEASE SUMMARIZE THE CONTENT
2
Main paper
• 2009/CNP: An FPGA-based Processor for Convolutional Networks
…, c8*x2; …, c8*x3; …, c8*x4;
10
2013A / new Architecture
• 二维卷积框图C
– 该卷积结构将卷积的计算与卷积 窗的输入值分隔开,经过比较, 优势在于右边的2D Array Processor可以多个同时进行并 行计算得到多个输出结果,实现 了输入数据的复用,而前一种则 由于没有分开所以无法实现
19
2013B/A Memory-Centric Architecture—ICCD
• The effect of the memory bottlenect can be reduced by a flexible memory hierarchy that supports the complex data access patterns in CNN workload.
c2*x2+c1*x1+c0*x0,
4. C0*x3, c1*x3+c0*x2,
c2*x3+c1*x2+c0*x1,
5. C0*x4, c1*x4+c0*x3,
c2*x4+c1*x3+c0*x2,
6. C0*x5, c1*x5+c0*x4,
c2*x5+c1*x4+c0*x3,
1
第一部分
整体概述
THE FIRST PART OF THE OVERALL OVERVIEW, PLEASE SUMMARIZE THE CONTENT
2
Main paper
• 2009/CNP: An FPGA-based Processor for Convolutional Networks
…, c8*x2; …, c8*x3; …, c8*x4;
10
2013A / new Architecture
• 二维卷积框图C
– 该卷积结构将卷积的计算与卷积 窗的输入值分隔开,经过比较, 优势在于右边的2D Array Processor可以多个同时进行并 行计算得到多个输出结果,实现 了输入数据的复用,而前一种则 由于没有分开所以无法实现
19
2013B/A Memory-Centric Architecture—ICCD
• The effect of the memory bottlenect can be reduced by a flexible memory hierarchy that supports the complex data access patterns in CNN workload.
c2*x2+c1*x1+c0*x0,
4. C0*x3, c1*x3+c0*x2,
c2*x3+c1*x2+c0*x1,
5. C0*x4, c1*x4+c0*x3,
c2*x4+c1*x3+c0*x2,
6. C0*x5, c1*x5+c0*x4,
c2*x5+c1*x4+c0*x3,
AI人工智能培训课件-卷积神经网络-4.2
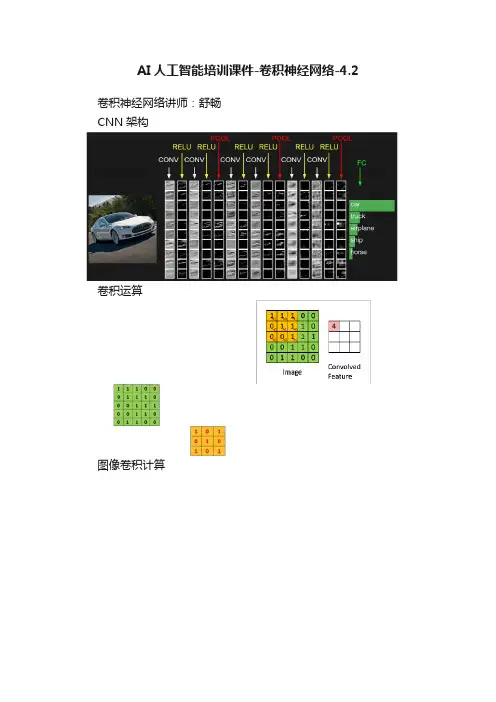
AI人工智能培训课件-卷积神经网络-4.2卷积神经网络讲师:舒畅CNN架构卷积运算图像卷积计算卷积层输出大小计算设图片大小为L*L,卷积核为k*k,步长stride为s,填充padding 为p,则卷积运算后输出的大小为O=(L-k+2*p)/s+1激活函数(relu)采用relu原因引入非线性函数作为激励函数,这样深层神经网络不再是输入的线性组合(原始感知机),可以逼近任意函数若采用sigmoid等函数,算激活函数时为指数运算,计算量大而采用Relu激活函数,整个过程的计算量减小对于深层网络,sigmoid函数反向传播时,很容易就会出现梯度消失的情况(在sigmoid接近饱和区时,变换太缓慢,导数趋于0,这种情况会造成信息丢失),从而无法完成深层网络的训练。
池化层全连接层Softmax分类器cat car frog 3.2 5.1 -1.7catcar frog Softmax函数Softmax分类器3.25.1-1.7catcarfrog Softmax 分类器3.2 5.1 -1.7 unnormalized log probabilities exp normalizeprobabilities L_i = -log(0.13) = 0.89 24.5 164.0 0.18 0.13 0.87 0.00 unnormalized probabilities交叉熵(cross entropy)信息量:假设X是一个离散型随机变量,其取值集合为χ,概率分布函数p(x)=P(X=x), x∈χ,则定义事件X=x0的信息量为:交叉熵:分类问题中的使用:MSE损失函数MSE(Mean Squared Error)m表示样本数量,loss为m个样本的loss均值技术成就梦想。