
SPSS多元统计分析实验报告
学生实验报告
实 验 课名称:SPSS统计分析
实验项目名称:多元线性回归分析
专 业 名 称:统计学
班 级:
学 号:
学 生 姓 名:
教 师 姓 名:
2014 年 12 月 20日
组别 同组同学
实验日期 2014 年 12 月 20 日 实验名称 多元统计分析
一、 实验名称:
多元统计分析
二、 实验目的和要求:
通过运用SPSS软件的多元统计分析揭示主管性格与雇员对
其整体满意度之间的关系掌握多元统计分析的原理及建模过
程。
三、 实验内容:
① 初步选出6个调查项目作为可能的解释变量:Y对主管工作情
况的总体评价;X1处理雇员的抱怨;X2不允许特权;X3学习
新知识的机会;X4根据工作业绩升职;X5对不良表现,对于吹
毛求疵;X6提升到更好工作的速度;
② 选择模型中的变量:变量X1、X2和X5反映雇员与主管人员之
间直接的人际关系,直接纳入模型,X3和X4主要和工作有关,
通过逐步法进入模型,X6并不是对主管的直接评价,不予考虑。
③ 运用SPSS软件进行多元分析对模型进行整理,比较调整的R
系数、方差分析表、回归分析结果(各系数机器t检验等)、共
显性检验等统计方法,得出结果。
四、 实验仪器与设备:
SPSS软件、兼容SPSS软件的电脑一台、老师给的数据素
材。
五、 实验原理:
多元线性回归模型是一元线性回归模型的扩展,其基本原
理与一员线性回归模型类似,计算公式如下:
设随机变量y与一般变量x1,x2……xk的线性回归模型
为:
y=β0+β1*x1+β2*x2+……+βk*xk+ε
其中β0,β1,β2……+βk是k+1个未知参数,β0
称为回归常数,β1,β2……+βk称为回归系数,y称为被解释
变量;x1,x2……xk称为解释变量。通过最小二乘法估算出各系
数,并测定方程的拟合程度、检验回归方程和回归系数的显著性,
得到最后的方程。
六、 实验结果与分析
通过以上建模和检验过程,最后得到的符合实际且具有统计
意义的方程为:Y=0.78X1,即雇员对主管的满意程度只与主管处
理雇员的抱怨有关,且成正相关。
七、 讨论和回答问题及体会:
1. 通过学习,我掌握了多元线性回归的基本原理和步骤,并
学会运用SPSS软件进行处理该类问题和比较熟练地分析
结果。
2. 在学习中,我感触比较深的是,看着题目很简单,但实际
操作时总会遇到很多或大或小的问题,但我会不断探索,
多次尝试,这个过程加深了我对SPSS软件操作的熟练程
度。
3.
统计学作为一种现实科学,其存在是有实际意义的,通过
此例的学习和研究,我越发认识到统计学的优越性和现实
性
。
多元线性回归SPSS实验报告
非标准化系数
标准系数
模型
B
标准 误差 试用版
t
Sig、
1
(常量)
-544、366 327、704
-1、661
、141
普通高校数(所)
、032
、047
、068
、683
、516
研究与试验发展机构数(个)
、009
、008
、142
1、086
、313
发表科技论文数量(篇)
、001
、000
、632
3、749
、749
、000 3672、177
教职工总数(万人)
3、046 4、394 、556 、693
、511
、000 2996、649
a、 因变量: 毕业生数(万人)
从容差与方差膨胀因子来瞧,在校学生数与教职工总数与其她解释变量的多重共 线性很严重。在重新建模中可以考虑剔除该变量
共线性诊断a
方差比例
模型
维数
6 74881、319 776、216
、000a
残差
675、288
7
96、470
总计
449963、199
13
a、 预测变量: (常量), 教职工总数(万人), 专利申请授权数(件), 研究与试验发展机 构数(个), 普通高校数(所), 发表科技论文数量(篇), 在校学生数(万人)。
b、 因变量: 毕业生数(万人)
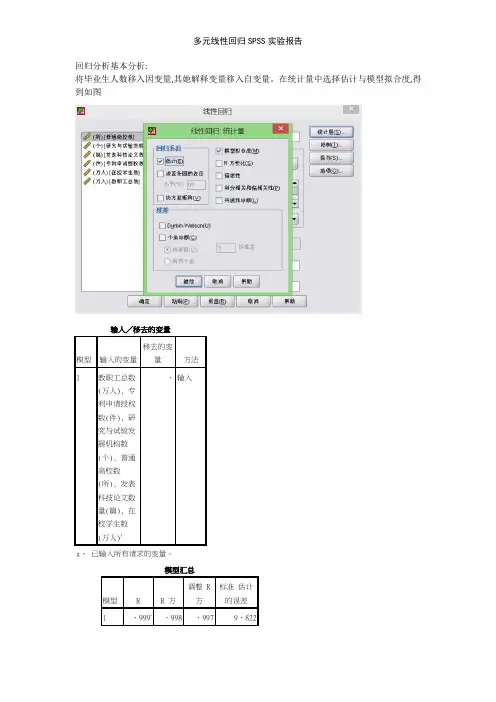
2、重建回归方程
多元线性回归 SPSS 实验报告
输入/移去的变量b
模型
输入的变量
移去的变量
方法
1
教职工总数(万
人), 专利申请授
权数(件), 研究
SPSS多元回归实验报告

实验八报告一、数据来源Employee data. sav 二、基本结果(1)确定自变量、因变量:)确定自变量、因变量:一般而言,因变量y与各自变量xj(j=1,2,3,…,n)之间的多元线性回归模型:之间的多元线性回归模型:其中:b0是回归常数;b k (k=1,2,3,…,n)是回归参数;e是随机误差。
是随机误差。
根据employee data.sav的数据,其中Y是当前工资salary,X1是起始资金salbegin,X2是工作经验prevexp,X3是工作时间jobtime,X4是工作种类jobcat,X5是受教育年限edcau。
(2)做出因变量与自变量的散点图:)做出因变量与自变量的散点图:从散点图可以看出因变量与各自变量之间存在线性关系。
(3)检验因变量Y是否服从正态分布的模型假定——因变量Y并没有很好地服从正态分布。
地服从正态分布。
的残差图(4)线性回归Y的残差图此标准化残差图表明,此线性回归的标准化残差呈楔形分布而非带状分布,不满足回归模型同方差的假定。
布,不满足回归模型同方差的假定。
当前薪金多元线性回归分析的残差图图当前薪金多元线性回归分析的残差图(5)通过以上检验可以看出,当前薪金并不是好的变量,对当前薪金进行Ln变换(取对数)生成新的随进变量logsale,将logsale作为因变量Y用逐步回归的方法进行回归分析:的方法进行回归分析:1)p-p图:图:较好的服从了正态分布。
发现取对数后,logY较好的服从了正态分布。
2)logY的标准化残差图:的标准化残差图:上图表明因变量Y(logsale)的标准化残差近似呈带状分布,满足模型同方差的假定。
差的假定。
3)逐步回归的判定系数:)逐步回归的判定系数:通过逐步回归,得到方程的判定系数如下表。
R²越接近1,说明回归方程解释了因变量总变异量的绝大部分比例。
本估计的回归方程有一个好的拟合,,可以认为拟合度高。
在模型5中达到0.810,且调整后的R²达到0.808,可以认为拟合度高。
多元统计分析 实验报告

多元统计分析实验报告1. 引言多元统计分析是一种用于研究多个变量之间关系的统计方法。
在实验中,我们使用了多元统计分析方法来探索一组数据中的变量之间的关系。
本报告将介绍我们的实验设计、数据收集和分析方法以及结果和讨论。
2. 实验设计为了进行多元统计分析,我们设计了一个实验,收集了一组相关变量的数据。
我们选择了X、Y和Z这三个变量作为我们的研究对象。
为了获得准确的结果,我们采用了以下实验设计:1.确定研究目的:我们的目标是探索X、Y和Z之间的关系,并确定它们之间是否存在任何相关性。
2.数据收集:我们通过调查问卷的方式收集了一组数据。
我们请参与者回答与X、Y和Z相关的问题,以获得关于这些变量的定量数据。
3.数据整理:在收集完数据后,我们将数据进行整理,将其转化为适合多元统计分析的格式。
我们使用Excel等工具进行数据整理和清洗。
4.数据验证:为了确保数据的准确性,我们对数据进行验证。
我们检查数据的有效性,比较数据之间的一致性,并排除任何异常值。
3. 数据分析在数据收集和整理完毕后,我们使用了一些常见的多元统计分析方法来分析我们的数据。
以下是我们使用的方法和步骤:1.描述统计分析:我们首先对数据进行了描述性统计分析。
我们计算了X、Y和Z的均值、标准差、最大值和最小值等。
这些统计量帮助我们了解数据的基本特征。
2.相关性分析:接下来,我们进行了相关性分析,以确定X、Y和Z之间是否存在相关关系。
我们计算了变量之间的相关系数,并绘制了相关系数矩阵。
这帮助我们确定变量之间的线性关系。
3.回归分析:为了更进一步地研究X、Y和Z之间的关系,我们进行了回归分析。
我们建立了一个多元回归模型,通过回归方程来预测因变量。
同时,我们还计算了回归系数和R方值,以评估模型的拟合度和预测能力。
4. 结果和讨论根据我们的实验设计和数据分析,我们得出了以下结果和讨论:1.描述统计分析结果显示,X的平均值为x,标准差为s;Y的平均值为y,标准差为s;Z的平均值为z,标准差为s。
管理同学spss描述统计分析实验报告

描述统计分析一、实验目的与要求1. 了解统计描述的常用工具及SPSS 中的统计描述模块。
2. 掌握分类变量和连续变量的统计描述方法及指标。
二、实验内容提要1.根据数据,分析受访者的年龄分布情况,尝试分城市/合并描述。
2.根据SPSS 自带数据Employee ,分析员工性别、受教育程度、少数民族、职位类别的分布情况,并尝试分析这些属性之间的关系以及这些属性和工资之间的关系。
三、实验步骤 根据数据在数据栏中找到拆分文件,点击,将城市添加到分组方式中,对城市进行拆分,点击确定。
在分析中选择描述统计下的描述,点击确定。
描述统计量 S0. 城市 N 极小值 极大值 均值 标准差 100北京 S3. 年龄 378 18 65 有效的 N (列表状态) 378200上海 S3. 年龄 387 18 65 有效的 N (列表状态) 387300广州S3. 年龄38218 65 有效的 N (列表状态) 382根据SPSS 自带数据Employee在分析一栏中的描述统计下找到频率,点击确定。
性别分析表 Gender频率百分比 有效百分比 累积百分比 有效 Female 216Male258 合计474受教育程度分析表Educational Level (years)频率百分比有效百分比累积百分比有效 8 53 12 190 14 6 15 116 1659 1711 18 9 19 27 20 2 .4 .4 21 1 .2 .2合计474少数民族分析表Minority Classification频率百分比有效百分比累积百分比有效 No370 Yes104合计4742.选择分析,描述统计下的交叉表,点击确定,分析性别和受教育程度之间的情况,将性别添加到行,将受教育程度添加到列中,点击确定。
3. 选择数据下的分类汇总,分析受教育程度和工资之间的关系,将受教育程度添加到分组变量中,将工资添加到变量摘要中,将数据集名称记为a,点击确定。
多元统计课程实验报告
一、实验背景随着社会经济的发展和科学技术的进步,数据量日益庞大,如何从大量数据中提取有价值的信息,成为统计学研究的热点问题。
多元统计分析作为统计学的一个重要分支,通过对多个变量之间的关系进行分析,为决策者提供有力的数据支持。
本实验旨在通过实际操作,让学生熟练掌握多元统计分析方法,提高数据分析能力。
二、实验目的1. 掌握多元统计分析的基本概念和方法;2. 学会运用多元统计分析方法解决实际问题;3. 提高数据分析能力,为后续课程打下坚实基础。
三、实验内容本次实验以某城市居民消费数据为例,运用多元统计分析方法对其进行分析。
四、实验步骤1. 数据导入首先,将实验数据导入统计软件(如SPSS、R等)。
本实验采用SPSS软件,数据集包含以下变量:(1)收入(y):居民年收入;(2)教育程度(x1):居民最高学历;(3)年龄(x2):居民年龄;(4)家庭人口(x3):家庭人口数量;(5)住房面积(x4):家庭住房面积。
2. 描述性统计分析对数据集进行描述性统计分析,包括各变量的均值、标准差、最大值、最小值等。
3. 相关性分析运用皮尔逊相关系数、斯皮尔曼等级相关系数等方法,分析变量之间的相关关系。
4. 主成分分析运用主成分分析方法,提取主要成分,降低数据维度。
5. 聚类分析运用K-means聚类分析方法,将居民划分为不同的消费群体。
6. 随机森林回归分析运用随机森林回归分析方法,预测居民收入。
五、实验结果与分析1. 描述性统计分析根据描述性统计分析结果,可知居民年收入、教育程度、年龄、家庭人口、住房面积的平均值、标准差、最大值、最小值等。
2. 相关性分析通过相关性分析,发现收入与教育程度、年龄、家庭人口、住房面积之间存在显著的正相关关系。
3. 主成分分析根据主成分分析结果,提取出两个主成分,累计方差贡献率为84.95%,可以解释大部分的变量信息。
4. 聚类分析通过K-means聚类分析,将居民划分为3个消费群体。
spss分析实验报告

SPSS分析实验报告引言SPSS(统计包括社会科学)是一种常用的统计分析软件,广泛应用于社会科学领域的数据分析。
本文将以“step by step thinking”为思维导向,详细介绍如何使用SPSS进行实验数据的分析和结果解读。
步骤一:数据导入首先,我们需要将实验数据导入SPSS软件中。
打开SPSS软件,点击“文件”菜单,并选择“导入数据”。
选择数据文件所在位置,并按照指示完成数据导入过程。
确认数据导入完成后,我们可以开始进行下一步分析。
步骤二:数据清洗在进行实验数据分析之前,我们需要对数据进行清洗,以确保数据的准确性和可靠性。
数据清洗的步骤包括删除重复数据、处理缺失值和异常值等。
通过点击SPSS软件中的“数据”菜单,我们可以找到相应的数据清洗工具,并按照指示进行操作。
步骤三:描述性统计描述性统计是对数据进行总体特征描述的过程。
在SPSS软件中,我们可以使用“统计”菜单中的“描述统计”工具进行描述性统计分析。
该工具可以计算数据的均值、标准差、中位数等统计量,为后续的分析提供参考。
步骤四:检验假设在进行实验数据分析时,我们通常需要检验某些假设是否成立。
SPSS软件提供了多种假设检验工具,如t检验、方差分析等。
通过点击“分析”菜单,并选择相应的假设检验工具,我们可以输入所需的参数,并进行假设检验。
根据检验结果,我们可以判断实验数据是否支持或拒绝了我们的假设。
步骤五:相关性分析相关性分析用于研究两个或多个变量之间的关系。
SPSS软件中的“相关”工具可以计算出变量之间的相关系数,并绘制相应的相关图表。
通过相关性分析,我们可以了解变量之间的线性关系,并得出相关系数的显著性程度。
步骤六:回归分析回归分析是一种用于预测和解释变量之间关系的统计方法。
在SPSS软件中,我们可以使用“回归”工具进行回归分析。
通过输入自变量和因变量,并进行回归分析,我们可以得到回归方程和相关统计指标,进而进行预测和解释。
结果解读根据以上分析步骤,我们可以得到一系列实验数据的统计分析结果。
(整理)多元统计分析-实验一.
实验一
一、实验内容
1、实验目的
考察北京、天津、上海、内蒙古、辽宁、山西、江苏、浙江、山东九省市人均生活消费支出情况。
2、实验要求
分别使用SPSS软件和Excel作出散点图、雷达图并作简要分析。
二、实验报告
1、数据来源
选取九省市人均食品、衣着、居住等七项指标作分析,数据取自于2007年统计年鉴(见下表1)。
2、数据作图
散点图矩阵
图 1.1
图 1.2
3、结果分析
分析1:由上图1.1可以看出,九省市的教育文化及娱乐服务费用支出分别与食品费用支出、交通和通信费用支出存在正向的线性关系;交通和通信费用支出分别与食品费用支出、教育文化及娱乐服务费用支出存在正向线性关系;食品费用支出分别与交通和通信费用支出、教育文化及娱乐服务费用支出存在正向线性关系。
分析2:由上图1.2可以看出,上海(红色)的图形面积最大,表明上海人均生活成本最高,其次是北京(深蓝色)与浙江(蓝色),山西的(棕色)人均生活成本最小。
另外,上海的人均交通和通信、教育文化及娱乐服务、食品等费用支出在九省市中均是最高的,且相差幅度较大。
主成分分析、因子分析实验报告--SPSS
主成分分析、因子分析实验报告--SPSS主成分分析、因子分析实验报告SPSS一、实验目的主成分分析(Principal Component Analysis,PCA)和因子分析(Factor Analysis,FA)是多元统计分析中常用的两种方法,旨在简化数据结构、提取主要信息和解释变量之间的关系。
本次实验的目的是通过使用 SPSS 软件对给定的数据集进行主成分分析和因子分析,深入理解这两种方法的原理和应用,并比较它们的结果和差异。
二、实验原理(一)主成分分析主成分分析是一种通过线性变换将多个相关变量转换为一组较少的不相关综合变量(即主成分)的方法。
这些主成分是原始变量的线性组合,且按照方差递减的顺序排列。
主成分分析的主要目标是在保留尽可能多的数据信息的前提下,减少变量的数量,从而简化数据分析和解释。
(二)因子分析因子分析则是一种探索潜在结构的方法,它假设观测变量是由少数几个不可观测的公共因子和特殊因子线性组合而成。
公共因子解释了变量之间的相关性,而特殊因子则代表了每个变量特有的部分。
因子分析的目的是找出这些公共因子,并估计它们对观测变量的影响程度。
三、实验数据本次实验使用了一份包含多个变量的数据集,这些变量涵盖了不同的领域和特征。
数据集中的变量包括具体变量 1、具体变量 2、具体变量 3等,共X个观测样本。
四、实验步骤(一)主成分分析1、打开 SPSS 软件,导入数据集。
2、选择“分析”>“降维”>“主成分分析”。
3、将需要分析的变量选入“变量”框。
4、在“抽取”选项中,选择主成分的提取方法,如基于特征值大于1 或指定提取的主成分个数。
5、点击“确定”,运行主成分分析。
(二)因子分析1、同样在 SPSS 中,选择“分析”>“降维”>“因子分析”。
2、选入变量。
3、在“描述”选项中,选择相关统计量,如 KMO 检验和巴特利特球形检验。
4、在“抽取”选项中,选择因子提取方法,如主成分法或主轴因子法。
判别分析实验报告SPSS
判别分析实验报告SPSS实验目的:判别分析(Discriminant Analysis)是一种经典的多元统计分析方法,用于解释和预测分类变量。
该实验旨在使用SPSS软件进行判别分析,探索一组变量对分类结果的贡献和预测能力。
实验步骤:1.数据收集:从一些公司的人力资源数据库中随机选择了200个员工作为样本,收集了以下变量:性别(男、女)、教育程度(本科、研究生、博士)、工龄(年)、绩效评分(0-5)、离职与否(是、否)。
2.数据清洗:检查数据中是否存在缺失值,并对缺失值进行处理。
删除离职与否变量中缺失值。
3.数据探索:使用SPSS进行描述性统计分析,了解样本的基本情况。
分别计算男女性别比例和各教育程度及离职状态的分布情况。
4. 变量选择:使用SPSS进行判别分析,将离职与否作为分类变量,性别、教育程度、工龄和绩效评分作为预测变量。
使用Wilks' Lambda检验选择预测变量,确定对分类结果的贡献。
5.判别函数计算:根据选择的预测变量,计算判别函数。
使用判别函数对样本进行分类,并计算分类结果的准确率。
实验结果:1.数据探索结果显示,样本中男女性别比例约为1:1,教育程度主要集中在本科和研究生,离职比例为14%。
2. 判别分析结果显示,Wilks' Lambda检验结果为0.632,p值小于0.05,说明选取的预测变量对分类结果有统计上显著的贡献。
3.计算得到的判别函数为D=-0.311(性别)+0.236(教育程度)+0.011(工龄)+0.585(绩效评分)。
4.使用判别函数对样本进行分类,分类准确率为81.5%。
其中,离职样本的分类准确率为75%,非离职样本的分类准确率为82%。
实验结论:通过判别分析实验,我们得出以下结论:1.性别、教育程度、工龄和绩效评分这四个变量对员工的离职与否有显著的预测能力。
2.预测变量中绩效评分对离职结果的贡献最大,说明绩效评分较低的员工更容易离职。
spss数据分析实验报告
统计分析与spss的应用
一、实验目的
学会用spss作基本统计量的计算、绘制常用的统计图形以及用多选项分析进行数据分析。
二、实验原理
运用spss软件对各省市经济进行统计分析,绘制相应的统计图表进行分析。
三、实验内容及步骤
实验内容:以各地区各项经济支出为数据,运用相关分析方法对数据进行分析。
实验步骤:
1.将数据导入到spss软件中,文件类型是EXCEL文档;
2.打开spss软件,在页面上方点击分析,找到降维,点击因子分析;
3.导入各项数据;
4.在因子分析:描述统计,选中统计量的原始分析结果与相关矩阵
的系数,点击继续;
5.在因子分析:抽取,方法选择主成分,分析选择线性相关矩阵,
输出全选,抽取选择第一个;
6.在因子分析:旋转,在方法栏选中最大方差法,输出项全选;
7.在因子分析:选项,在缺失值中选中按列表排除个案;
8.然后得到一些统计图表;
四、实验器材
计算机中spss软件
五、实验结果分析
数据的公因子方差
解释的总方差
碎石图
成分矩阵及旋转成分矩阵
旋转空间的成分图
六、实验结论
Spss在数据分析方面提供了强大的能力,可以快速地进行相关分析,重点在于分清数据的公因子方差、碎石图、旋转空间的成分图。
七、实验总结及心得
Spss有着强大的相关分析功能,在使用spss的同时一定要与统计学的知识理论联系在一起,理清每种统计方法的含义,看懂各种统计表。