
字符串匹配程序
字符串匹配程序
程序:
CRLF MACRO ;宏定义
MOV AH, 02H ;显示回车
MOV DL, 0DH
INT 21H
MOV AH, 02H ;显示换行
MOV DL, 0AH
INT 21H
ENDM
DATA SEGMENT ;数据段
MESS1 DB 'MATCH', 0DH, 0AH, '$'
MESS2 DB 'NO MATCH', 0DH, 0AH, '$'
MESS3 DB 'INPUT STRING1:', 0DH, 0AH, '$'
MESS4 DB 'INPUT STRING2:', 0DH, 0AH, '$'
MAXLEN1 DB 81
ACTLEN1 DB ?
STRING1 DB 81 DUP(?)
MAXLEN2 DB 81
ACTLEN2 DB ?
STRING2 DB 81 DUP(?)
DATA ENDS
STACK SEGMENT STACK ;堆栈段
STA DB 50 DUP(?)
TOP EQU LENGTH STA
STACK ENDS
CODE SEGMENT ;代码段
ASSUME CS: CODE, DS: DATA, ES: DATA, SS: STACK
START: MOV AX, DATA
MOV DS, AX
MOV ES, AX
MOV AX, STACK
MOV SS, AX
MOV SP, TOP
MOV AH, 09H ;显示提示信息1
MOV DX, OFFSET MESS3 ;把MESS3的偏移地址给DX
INT 21H
CRLF
MOV AH, 0AH ;接收输入字符串1
MOV DX, OFFSET MAXLEN1 ;把MAXLEN1的首地址给DX
INT 21H
CRLF
MOV AH, 09H ;显示提示信息2
MOV DX, OFFSET MESS4 ;把MESS4的偏移地址给DX INT 21H
MOV AH, 0AH ;接收输入字符串2
MOV DX, OFFSET MAXLEN2 ;把MAXLEN2的首地址给DX
INT 21H
CRLF
CLD ;CF=0,SI=SI+1,DI=DI+1
MOV SI, OFFSET STRING1 ;把STRING1的偏移地址给SI
MOV CL, [SI-1] ;CL=[SI-1](字符串1送CL)
MOV CH, 00H ;CH清零
KKK: MOV DI, OFFSET STRING2 ;把STRING2的偏移地址给DI
PUSH CX ;把CX压入堆栈
MOV CL, [DI-1] ;CL=[DI-1](字符串2送CL)
MOV CH, 00H ;CH清零
MOV AL, [SI] ;AL=[SI]
MOV DX, DI ;DX=DI
REPNZ SCASB ;两字符串比较
JZ GGG ;相等跳转GGG
INC SI ;SI=SI+1(不等取下一个字符)
POP CX ;CX弹出
LOOP KKK ;CX为0时跳转KKK(继续比较)
MOV AH, 09H ;显示判断结果2
MOV DX, OFFSET MESS2 ;把MESS1偏移地址给DX
INT 21H
JMP PPP ;跳转到PPP
GGG: MOV AH, 09H ;显示判断结果1
MOV DX, OFFSET MESS1 ;把MESS1偏移地址给DX
INT 21H
PPP: MOV AX, 4C00H ;返回DOS
INT 21H
CODE ENDS
END START
运行结果:
Microsoft (R) Segmented-Executable Linker Version 5.13
Copyright (C) Microsoft Corp 1984-1991. All rights reserved.
Run File [4.exe]:
List File [NUL.MAP]:
Libraries [.LIB]:
Definitions File [NUL.DEF]:
D:\masm60>4.EXE
INPUT STRING1:
I LOVE YOU INPUT STRING2:
I LOVE CHINA
MATCH
D:\masm60>4.EXE
INPUT STRING1:
YOU
INPUT STRING2:
CHINA
NO MATCH
D:\masm60>
PYTHON正则表达式re模块使用说明
PYTHON正则表达式re模块使⽤说明
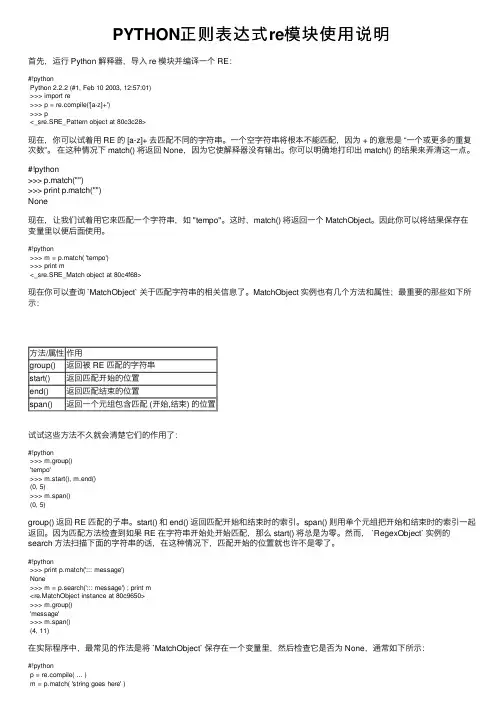
⾸先,运⾏ Python 解释器,导⼊ re 模块并编译⼀个 RE:
#!python
Python 2.2.2 (#1, Feb 10 2003, 12:57:01)
>>> import re
>>> p = pile('[a-z]+')
>>> p
<_sre.SRE_Pattern object at 80c3c28>
现在,你可以试着⽤ RE 的 [a-z]+ 去匹配不同的字符串。⼀个空字符串将根本不能匹配,因为 + 的意思是 “⼀个或更多的重复
次数”。 在这种情况下 match() 将返回 None,因为它使解释器没有输出。你可以明确地打印出 match() 的结果来弄清这⼀点。
#!python
>>> p.match("")
>>> print p.match("")
None
现在,让我们试着⽤它来匹配⼀个字符串,如 "tempo"。这时,match() 将返回⼀个 MatchObject。因此你可以将结果保存在
变量⾥以便后⾯使⽤。
#!python
>>> m = p.match( 'tempo')
>>> print m
<_sre.SRE_Match object at 80c4f68>
现在你可以查询 `MatchObject` 关于匹配字符串的相关信息了。MatchObject 实例也有⼏个⽅法和属性;最重要的那些如下所
⽰:
⽅法/属性作⽤
group()返回被 RE 匹配的字符串
start()返回匹配开始的位置
end()返回匹配结束的位置
span()返回⼀个元组包含匹配 (开始,结束) 的位置
试试这些⽅法不久就会清楚它们的作⽤了:
#!python
>>> m.group()
'tempo'
>>> m.start(), m.end()
(0, 5)
>>> m.span()
(0, 5)
group() 返回 RE 匹配的⼦串。start() 和 end() 返回匹配开始和结束时的索引。span() 则⽤单个元组把开始和结束时的索引⼀起
20个简单汇编语言程序
20个简单汇编语言程序
汇编语言是一种底层编程语言,其语法简洁、速度快,被广泛应用于嵌入式系统和设备驱动程序的开发。本文将介绍20个简单的汇编语言程序,帮助读者了解该语言的基本语法和用法,以便更好地进行编程。
1. 程序1:将两个数相加并显示结果。这个程序演示了如何使用汇编语言进行简单的算术操作。
2. 程序2:计算并显示斐波那契数列。这个程序展示了如何使用循环和条件语句来求解数学问题。
3. 程序3:判断一个数是否是素数。这个程序演示了如何使用分支语句来进行逻辑判断。
4. 程序4:将一个字符串逆序输出。这个程序展示了如何使用栈来实现字符串逆序。
5. 程序5:计算一个字符串的长度。这个程序展示了如何使用循环和计数器来确定字符串的长度。
6. 程序6:将一个字符串转换为大写。这个程序演示了如何使用位运算来进行字符转换。
7. 程序7:计算一个数的阶乘。这个程序展示了如何使用循环和累加运算来求解阶乘。 8. 程序8:判断一个字符串是否是回文。这个程序演示了如何使用循环和栈来进行字符串回文判断。
9. 程序9:实现快速排序算法。这个程序展示了如何使用递归和分区操作来进行快速排序。
10. 程序10:实现冒泡排序算法。这个程序演示了如何使用循环和比较操作来进行冒泡排序。
11. 程序11:计算一个数组的平均值。这个程序展示了如何使用循环和累加运算来求解平均值。
12. 程序12:查找一个数组中的最大值。这个程序演示了如何使用循环和比较操作来进行最大值查找。
13. 程序13:判断一个数是否是回文。这个程序展示了如何使用循环和取余操作来进行数字回文判断。
14. 程序14:实现字符串拼接操作。这个程序演示了如何使用循环和指针操作来进行字符串拼接。
15. 程序15:实现矩阵乘法运算。这个程序展示了如何使用循环和累加运算来进行矩阵乘法。
16. 程序16:计算一个数的平方根。这个程序演示了如何使用二分法和近似计算来求解平方根。
scanf在c++中的用法

第 1 页 共 2 页 scanf在c++中的用法
在C语言中,scanf函数是一个非常重要的输入函数,它用于从标准输入(通常是键盘)读取数据,并将其存储到指定的变量中。scanf函数在C程序中经常被使用,用于各种数据类型的输入,包括整数、浮点数、字符、字符串等。本文将详细介绍scanf函数的用法,包括其基本语法、使用注意事项以及一些常见的问题和解决方法。
一、基本语法
scanf函数的语法非常简单,只需要指定要读取的数据类型和变量即可。基本语法如下:
```c
intscanf(constchar*format,...);
```
其中,format是一个格式化字符串,用于指定要读取的数据类型和格式。后面的省略号表示要读取的变量列表。返回值是一个整数,表示成功读取的变量个数。
二、使用注意事项
在使用scanf函数时,需要注意以下几点:
1.格式化字符串必须与要读取的数据类型匹配。例如,如果使用%d格式化字符串读取整数,则必须使用整型变量来存储读取的数据。
2.格式化字符串中的%必须与实际要读取的数据类型匹配。例如,%d只能读取整数,而%f只能读取浮点数。
3.如果要读取多个数据,可以使用逗号分隔格式化字符串中的各个占位符。例如,%d,%f等。
4.变量必须事先声明并分配足够的空间来存储读取的数据。否则,可能会导致数据丢失或未定义行为。
5.如果格式化字符串中的格式错误或无法匹配变量类型,则scanf函数可能会返回不完整的结果或错误。因此,在使用scanf函数时,需要仔细检查返回值,确保所有变量都被正确读取。
三、常见问题和解决方法
在使用scanf函数时,可能会出现一些常见的问题和解决方法:
1.输入缓冲区溢出:如果格式化字符串的长度超过了变量所能容纳的数据长度,则可能会导致输入缓冲区溢出。解决方法是确保格式化字符串的长度与变量长度匹配,或者使用安全的格式化字符串,如%ld等。
2.格式化字符串与变量类型不匹配:如果格式化字符串与要读取的变量类型不匹配,则可能会导致数据丢失或未定义行为。解决方法是仔细检查格式化字符串和变量的类型是否匹配。
python常用的正则表达式大全

python常⽤的正则表达式⼤全
1.正则表达式
正则表达式是⽤来匹配与查找字符串的,从⽹上爬取数据⾃然或多或少会⽤到正则表达式,python的正则表达式要先引⼊re模块,正则表达式以r引导,例如:
其中**r“\d+”**正则表达式表⽰匹配连续的多个数值,search是re中的函数,从"abc123cd"字符串中搜索连续的数值,得到"123",返回⼀个匹配对象,结果如上.2.字符串"\d"匹配0~9之间的⼀个数值
3.字符"+"重复前⾯⼀个匹配字符⼀次或者多次.
注意:**r"b\d+"**第⼀个字符要匹配"b",后⾯是连续的多个数字,因此"是b1233",不是"a12".
4.字符"*"重复前⾯⼀个匹配字符零次或者多次.“" 与 "+"类似,但有区别,列如:
可见 r"ab+“匹配的是"ab”,但是r"ab “匹配的是"a”,因为表⽰"b"可以重复零次,但是”+“却要求"b"重复⼀次以上.
5.字符"?"重复前⾯⼀个匹配字符零次或者⼀次.
匹配结果"ab”,重复b⼀次.
6.字符".“代表任何⼀个字符,但是没有特别声明时不代表字符”\n".
结果“.”代表了字符"x".
7."|"代表把左右分成两个部分 .
结果匹配"ab"或者"ba"都可以.
8.特殊字符使⽤反斜杠"“引导,例如”\r"、"\n"、"\t"、"\"分别表⽰回车、换⾏、制表符号与反斜线⾃⼰本⾝.
9.字符"\b"表⽰单词结尾,单词结尾包括各种空⽩字符或者字符串结尾.
结果匹配"car",因为"car"后⾯是⼀个空格.
10."[]中的字符是任选择⼀个,如果字符ASCll码中连续的⼀组,那么可以使⽤"-"字符连接,例如[0-9]表⽰0-9的其中⼀个数字,[A-Z]表⽰A-Z的其中⼀个⼤写字符,[0-9A-z]表⽰0-9的其中⼀个数字或者A-z的其中⼀个⼤写字符.
11."^"出现在[]的第⼀个字符位置,就代表取反,例如[ ^ab0-9]表⽰不是a、b,也不是0-9的数字.
js中search的用法

js中search的用法
search()是JavaScript中一个字符串方法,主要用于查找字符串中是否包含指定的文本,并返回匹配文本的位置。具体来说,search()方法搜索字符串中与正则表达式匹配的字符串,并返回匹配的位置索引。以下是一些search()的用法和示例:
语法:
string.search(regexp)
参数:
regexp:正则表达式,用于匹配“搜索串”。
返回值:
如果找到了匹配项,该方法返回第一个匹配项的位置(索引)。如果没有匹配项,则返回-1。
示例1:
var str = "Hello World!";
var n = str.search("World");
console.log(n);
输出:
6
该示例中,search()方法查找字符串中包含“World”文本的位置,返回6,因为“World”出现在字符串中的第7个位置,程序计算从0开始。
10
该示例中,search()方法使用正则表达式搜索字符串,查找包含数字的第一个位置索引。在此示例中,正则表达式/\d+/匹配任何一个或多个数字的字符串。因此,程序返回数字“3”所在的位置索引,即10。
27 该示例中,search()方法使用正则表达式查找字符串是否包含“javascript”文本。由于正则表达式使用了标志“i”,不区分大小写,因此程序返回文本“JavaScript”所在的位置索引,即27。
总结
c++ 字符串 空白字符 正则表达式

C++中的字符串操作与正则表达式
1. 概述
C++作为一种广泛应用的编程语言,其字符串处理和正则表达式应用一直备受关注。字符串是程序中常用的数据类型之一,而正则表达式则是用于进行复杂的模式匹配和文本搜索的工具。本文将就C++中的字符串操作和正则表达式应用进行深入探讨,旨在帮助读者更好地理解和运用这两项重要的技术。
2. C++中的字符串操作
字符串是由字符组成的序列,在C++中可以用char数组或者string类来表示和操作。在处理字符串时,经常需要进行拼接、比较、查找、截取等操作。C++提供了丰富的字符串操作函数和方法,如下所示:
- 字符串拼接:使用"+"运算符或者append()方法可以将两个字符串拼接起来。
- 字符串比较:可以使用"=="、"!="等运算符进行字符串的比较,也可以使pare()方法对字符串进行比较。
- 字符串查找:可以使用find()方法或者find_first_of()、find_last_of()等方法来查找字符串中的子串或者字符。
- 字符串截取:使用substr()方法可以实现对字符串的截取操作。
3. C++中的空白字符
空白字符是指在文本中不可见的字符,如空格、制表符、换行符等。在C++中,空白字符的处理往往涉及到字符串的格式化和解析。以下是一些常见的空白字符处理场景:
- 去除空白字符:可以使用erase()方法结合remove_if()函数来去除字符串中的空白字符。
- 拆分字符串:可以使用stringstream类来将包含空白字符的字符串按空白字符进行拆分。
- 去除首尾空白字符:可以使用erase()方法结合find_first_not_of()和find_last_not_of()方法来去除字符串首尾的空白字符。
4. C++中的正则表达式
正则表达式是一种用于描述字符串模式的工具,可以实现对文本的复杂模式匹配和搜索。在C++中,可以使用正则表达式库来处理字符串的匹配和替换。下面是一些常见的正则表达式操作:
字符串数据,长度不匹配
字符串数据,长度不匹配
字符串数据是计算机科学中非常重要的一种数据类型,它由一系列字符组成,可以表示文本、数字、符号等信息。在计算机程序中,字符串数据通常用来存储和处理文本信息,例如用户输入的文本、文件中的文本内容等。字符串数据的长度是指字符串中字符的数量,不同的字符串长度可能不同,这也是字符串数据的一个重要特征。
在实际应用中,字符串数据的长度可能会出现不匹配的情况。例如,当我们需要将两个字符串进行比较时,如果它们的长度不同,就需要进行一些特殊的处理。在这种情况下,我们需要了解字符串长度不匹配的原因,以及如何处理这种情况。
首先,字符串长度不匹配可能是由于数据输入错误或数据处理错误导致的。例如,当用户输入的文本长度超过了程序预设的最大长度时,就会出现字符串长度不匹配的情况。此外,当程序处理字符串数据时,如果没有考虑到字符串长度不匹配的情况,也可能会导致程序出错。
其次,字符串长度不匹配也可能是由于数据本身的特性导致的。例如,当我们需要比较两个字符串的大小时,如果它们的长度不同,就需要进行一些特殊的处理。在这种情况下,我们通常会将较短的字符串进行填充,使其长度与较长的字符串相同,然后再进行比较。
处理字符串长度不匹配的方法有很多种,具体的方法取决于具体的应用场景。下面介绍几种常见的处理方法:
1. 填充字符串:当需要比较两个字符串的大小时,可以将较短的字符串进行填充,使其长度与较长的字符串相同。填充的方法可以是在字符串的前面或后面添加空格、0等字符,也可以是重复字符串本身。
2. 截取字符串:当需要比较两个字符串的前几个字符时,可以使用字符串截取的方法。例如,如果需要比较两个字符串的前5个字符,可以使用substring方法截取字符串的前5个字符,然后再进行比较。
3. 忽略字符串长度:在某些情况下,字符串长度可能不是很重要,可以忽略字符串长度的差异。例如,当需要比较两个字符串的相似度时,可以使用字符串匹配算法,忽略字符串长度的差异,计算它们的相似度。
正则表达式工具RegexBuddy使用教程
正则表达式⼯具RegexBuddy使⽤教程
1. 界⾯介绍
(1)初始界⾯选项介绍
(2)如何使⽤匹配
(3)如何使⽤正则替换
(4)如何使⽤Debug
2.界⾯菜单翻译
Case sensitivity 区分⼤⼩写
Case insensitive: Differences between uppercase and lowercase characters are ignored. cat matches CAT, Cat, or cAt or any other
capitalization in addition to cat.
不区分⼤⼩写:忽略⼤⼩写字符之间的差异。cat匹配CAT, Cat,cAt或cat的其他任何⼤写字母.
Case sensitive: Differences between uppercase and lowercase characters are significant. cat matches only cat. 区分⼤⼩写:⼤⼩写字符之间的差异是显著的。cat只匹配cat。
Free-spacing mode ⾃由间距模式
Free-spacing: Unescaped spaces and line breaks in the regex are ignored so you can use them to format your regex to make it more
readable. In most applications this mode also makes # the start of a comment that runs until the end of the line.
⾃由间距:regex中未转义的空格和换⾏符被忽略,因此可以使⽤它们格式化正则表达式,使其更可读。在⼤多数应⽤程序中,此模式还使#
成为注释的开头,直到⾏的结尾。
Exact spacing: Unescaped spaces, line breaks, and # characters in the regex are treated as literal characters that the regex must match.
cmake string(regex replace使用方法
第 1 页 共 3 页 cmake string(regex replace使用方法
========================
简介
--
CMake是一个广泛使用的开源项目构建系统,它可以帮助开发人员创建跨平台应用程序。CMake有许多强大的功能,其中一个就是字符串的正则表达式替换(string(regex replace))。这个功能可以让你使用正则表达式匹配文本模式,并将其替换为指定的文本。在本篇文章中,我们将介绍CMake的字符串(regex replace)的使用方法。
语法
--
```scss
string(regex_replace regex_pattern input_string
replacement)
```
其中:
* `regex_pattern`:这是一个字符串,它定义了要匹配的模式。它必须是一个有效的正则表达式。
* `input_string`:这是要替换的字符串。
* `replacement`:这是要替换匹配模式的文本的字符串。
示例
--
以下是一个使用`string(regex_replace)`函数的示例:
```cmake 第 2 页 共 3 页 set(input_string "Hello, world! This is a test.")
set(regex_pattern "\w+") # 匹配一个或多个字母数字字符
set(replacement "Pattern matched!")
string(REGEX_REPLACE ${regex_pattern} ${replacement}
output "${input_string}")
message("Output: ${output}") # 输出 "Output: Hello,
Pattern matched! This is a test. Pattern matched!"
数据结构实验报告-基于字符串模式匹配算法的病毒感染检测问题
武 汉 工 程 大 学
电气信息学院
《 数据结构 》实验报告[ 1 ] 专业班级 电子信息类01 实验时间 年 月 日 学生学号 实验地点 电气楼308 学生姓名 指导教师 实验项目 基于字符串模式匹配算法的病毒感染检测问题 实验类别 基础实验 实验学时 4学时
实验目的及要求 实验目的: 1.掌握字符串的顺序存储表示方法
2.掌握字符串模式匹配算法BF算法或KMP算法的实现
实验要求:
输入多组数据,每组数据占1行,输入0 0时结束输入;每组数据输
出1行。利用模式匹配算法对主串和模式串进行匹配,若匹配成功,输出
“YES”,否则输出“NO”。 成 绩 评 定 表
类 别 评 分 标 准 分值 得分 合 计
上机表现 按时出勤、遵守纪律 认真完成各项实验内容 30分
报告质量 程序代码规范、功能正确 填写内容完整、体现收获 70分
说明:
评阅教师:
日 期: 年 月 日 《数据结构》实验报告 实 验 内 容 一、实验内容 1、问题描述:医学研究者最近发现了某新病毒,通过对这些病毒的分析,得知他们的DNA
序列都是环状的。现在研究者已收集了大量的病毒DNA和人的DNA数据,想快速检测出这些
人是否感染了相应的病毒。为了研究方便,研究者将人的DNA和病毒DNA均表示成由一些字
母组成的字符串序列,然后检测眸中病毒DNA序列是否在患者的DNA序列中出现过,如果出
现过,则此人感染了该病毒,否则没有感染。例如,假设病毒的DNA序列为baa,患者1的
DNA序列为aaabbba,则感染;患者2的DNA序列为babbba,则未感染。(注意,恩德DNA序
列式线性的,而病毒的DNA序列为环状的)。
2、输入要求:多组数据,每组数据占1行,为序列A和B,A对应病毒的DNA序列,B对
应人的DNA序列。A和B都为“0”时输入结束。
3、输出要求:对于每组数据输出1行,若患者感染了病毒输出“YES”,否则输出“NO”。
二、实验步骤