
MySQL性能优化pdf
INDEX(i) :: WHERE a.i = b.i
索引优化 – 索引不能1
以通配符开始的LIKE条件
INDEX(s) :: WHERE s LIKE “%foo”
Bitwise 运算
INDEX(i) :: WHERE i & 4
非前缀查询
INDEX(i, j) :: WHERE j = 5
索引优化 – InnoDB 特点
优点
1. 2. 3.
行级锁,并发优势 支持事务 数据库大小无限制
缺点
1. 2. 3.
查询速度稍慢(PK查询快) 如果损坏,修复的手段不多 死锁
索引优化 – 一般规则
每query每table只能使用一个索引(MySQL 5.0 支持 index
merge) 尽量使用多字段索引,复用单索引 索引不是万能的
索引优化 – 索引能
主键查询
PRIMARY KEY(i) :: WHERE i = 5
索引查询
INDEX(i) :: WHERE i = 7
前缀查询
INDEX(s) :: WHERE s LIKE “foo%” INDEX(i, j) :: WHERE i = 5
Join
索引优化 – 索引简介
索引类型
B树 Hash表
倒排树
索引优化 - MyISAM vs. InnoDB
MyISAM 索有的索引都是对等的,KEY与PRIMARY KEY 效果相
同,都是包含一个指向数据文件的指针
InnoDB 使用 PRIMARY KEY 聚簇索引(clustered index)
mysql> \s -------------Mysql Ver 14.7 Distrib 4.1.12, for unknown-freebsd4.7 (i386) using readline 4.3
root@localhost Not in use more '' ; 4.1.12-standard-log 10 Localhost via UNIX socket latin1 latin1 latin1 latin1 /tmp/mysql.sock 23 days 19 hours 28 min 23 sec Flush tables:
*************************** 1. row *************************** id: 1 # 子查询的ID select_type: SIMPLE # 查询的类型:simple、subquery、union table: QSP_SEED # 表名 type: range # 表的操作类型 possible_keys: DF_KEY,BW_KEY # 备选的索引 key: DF_KEY # 实际使用的索引 key_len: 264 # 实际使用索引的长度 ref: NULL # 索引引用的值 rows: 10 # 预计需要扫描的行数 Extra: Using where # 其它信息
Threads: 14 Questions: 28510630 Slow queries: 87 Opens: 1286 123 Open tables: 35 Queries per second avg: 13.858 --------------
MySQL性能探测- slow_log
vi /usr/local/mysql/data/slow.log
MySQL性能探测- \s
Connection id: Current database: Current user: SSL: Current pager: Using outfile: Using delimiter: Server version: Protocol version: Connection: Server characterset: Db characterset: Client characterset: Conn. characterset: UNIX socket: Uptime: 2697076
非常量查询
INDEX(s) :: WHERE foo(s) = “FOO” INDEX(s) :: WHERE s = f(t)
索引优化 – 索引不能2 索引越多越好?
更新成本
内存、硬盘空间占用成本
选择成本
不一定会使用索引:optimizer 1/3rd 规则
CREATE TABLE EMPLOYEE ( … SEX TINYINT NOT NULL, # 只有两个值 KEY IDX_SEX ( SEX ) ) ENGINE = InnoDB;
一般会退化成为全表扫描(Full Table Scan),为什么? 例外:表很小、只需要索引扫描
索引优化 – Explain 示例
mysql> explain select * from QSP_SEED where SITE in ( "24188" ) and DF_STATUS = 1 and DF_EXPECT < "2006-08-31 17:16:15" order by DF_EXPECT asc\G
Lock time 太大表示锁冲突 Rows_examined 太大表示SQL语句需要优化
MySQL MyIsam 性能探测 - 索引命中率
mysql> SHOW STATUS LIKE '%key_read%'; +-------------------+---------+ | Variable_name | Value | +-------------------+---------+ | Key_read_requests | 1726173 | | Key_reads | 583 | Key_reads / Key_read_requests < 1/1000 +-------------------+---------+ 2 rows in set (0.00 sec)
非select语句转换成为相同条件的select语句
Explain输出注意
key字段的值为空 type字段的值为“ALL”表示全表扫描 rows字段的值太大 Extra字段的值为: Using filesort : 需要外部排序 Using temporary : 需要创建(内存、磁盘)临时表
数据与 PRIMARY KEY存放在一起 其他索引包含PKV(PRIMARY KEY values ) 指向数据
索引优化 – MyIsam 特点
1. 2.
优点
查询快(读多、更新删除少)读与插入不冲突 文件数据库,容易控制
1.
缺点
2. 3.
表级锁,读改混合会冲突,性能低 大量更新下容易坏,需要定期修复 表大小超过4G需要特殊设置
查询优化
查询优化
1.IS NULL 与 IS NOT NULL 不能用null作索引,任何包含null值的列都将不会被包含在索引中 2.select * from employee where last_name like ‘%cliton%’ ,不能使用索引 3.In和exists EXIST,系统会首先检查主查询,然后运行子查询直到它找到第一个匹配项 , IN 首先执行子查询,结果列表存放在在一个加了索引的临时表中。在执行子查询 之前,系统先将主查询挂起,待子查询执行完毕,存放在临时表中以后再执行 主查询 mysql -udpd -h192.168.205.62 -pdpd -P3307 dpd_magazine select id from item where status=1 and not exists (select item_id from item_file where item_file.item_id=item.id); select id from item where status=1 and id not in (select item_id from item_file);
# Time: 070114 2:00:55 # User@Host: root[root] @ localhost [] # Query_time: 55 Lock_time: 0 Rows_sent: 0 Rows_examined: 9286 SET timestamp=1168711255; update QSP_15_PRF.QSP_SEED as q, TSP_15_PRF.TSP_SEED as t SET q.DF_STATUS = 100 WHERE q.URL = t.URL;
Qcache_inserts : 多少次未命中然后插入的. Qcache_hits : 多少次命中的.
查询缓存碎片率 = Qcache_free_blocks / Qcache_total_blocks * 100% 缓存的命中率 = Qcache_queries_in_cache/Com_select SHOW STATUS LIKE 'open%tables';
查询缓冲
1.Mysql查询缓冲变量 SHOW STATUS LIKE 'qcache%';
Qcache_free_blocks中相邻内存块的个数,数目大可能有碎片
Qcache_free_memory缓存中的空闲内存 Qcache_hits,Qcache_insert命中次数除以插入次数就是不中比率 Qcache_not_cache Qcache_lowmem_prunes 缓存内存不足 Qcache_queries_in_cache cache_total_size 缓存中块的数量
MySQL查询性能优化

MySQL查询性能优化⼀、MySQL查询执⾏基础1. MySQL查询执⾏流程原理<1> 客户端发送⼀条查询给服务器。
<2> 服务器先检查查询缓存,如果命中了缓存,则⽴刻返回存储在缓存中的结果。
否则进⼊下⼀阶段。
<3> 服务器进⾏SQL解析、预处理,再由优化器⽣成对应的执⾏计划。
<4> MySQL根据优化器⽣成的执⾏计划,调⽤存储引擎的API来执⾏查询。
<5> MySQL将结果返回给客户端,同时保存⼀份到查询缓存中。
2. MySQL客户端/服务器通信协议<1> 协议类型:半双⼯。
<2> Mysql通常需要等所有的数据都已经发送给客户端才能释放这条查询所占⽤的资源。
<3> 在PHP函数中,mysql_query()会将整个查询的结果集缓存到内存中,⽽mysql_unbuffered_query()则不会缓存结果,直接从mysql服务器获取结果。
当结果集很⼤时,使⽤后者能减少内存的消耗,但服务器的资源会被这个查询占⽤⽐较长的时间。
3. 查询状态 可以使⽤命令来查询mysql当前查询的状态:show full processlist。
返回结果中的“State”键对应的值就表⽰查询的状态,主要有以下⼏种:<1> Sleep:线程正在等待客户端发送新的请求。
<2> Query:线程正在执⾏查询或正在将结果发送给客户端。
<3> Locked:在MySQL服务器层,该线程正在等待表锁。
(在没⾏锁的引擎出现)<4> Analyzing and statistics:线程正在收集存储引擎的统计信息,并⽣成查询的执⾏计划。
<5> Copying to tmp [on disk]:线程正在执⾏查询,并且将其结果集都复制到⼀个临时表中,这种状态要么是在做group by操作,要么是⽂件排序操作,或者是union操作。
MySQL中的参数配置及调优方法

MySQL中的参数配置及调优方法MySQL是当前最流行的开源关系型数据库管理系统之一。
它的广泛应用和可灵活配置的特点使得它成为许多企业和个人的首选。
然而,未经优化的MySQL可能会面临性能下降、资源浪费等问题,因此正确配置和调优MySQL参数是至关重要的。
本文将介绍MySQL中的参数配置及调优方法,帮助读者解决数据库性能问题。
一、参数配置在MySQL中,有许多参数可以配置,以满足不同应用的需求。
以下是一些重要参数的简要介绍:1. 缓冲区参数- innodb_buffer_pool_size:InnoDB存储引擎使用的缓冲池大小。
增大该值可以提高读写性能,但会占用更多内存。
- key_buffer_size:MyISAM存储引擎使用的键缓冲区大小。
同样,增大该值可以提高性能,但会占用更多内存。
2. 连接参数- max_connections:允许的最大连接数。
该值应根据应用的并发连接数进行适当调整,以避免资源浪费和连接超时问题。
- wait_timeout:连接空闲后等待关闭的时间。
默认值为28800秒,可以根据具体需求进行调整。
3. 查询缓存参数- query_cache_type:查询缓存类型。
0表示禁用查询缓存,1表示启用,2表示只缓存SQL_NO_CACHE标记的查询结果。
- query_cache_size:查询缓存大小。
指定用于存储查询缓存的内存大小。
二、调优方法在配置参数之前,我们需要先了解数据库当前的性能瓶颈。
可以通过以下几种方式进行分析:1. 使用MySQL自带的性能监控工具MySQL提供了一系列的性能监控工具,如:MySQL Performance Schema、MySQL Enterprise Monitor等。
通过这些工具,可以实时监控MySQL的运行状态,获得性能数据。
2. 使用开源的性能监控工具除了MySQL自带的工具,还有一些开源的性能监控工具可以用于MySQL性能分析。
MySQL性能优化之参数配置
MySQL性能优化之参数配置1、⽬的:通过根据服务器⽬前状况,修改Mysql的系统参数,达到合理利⽤服务器现有资源,最⼤合理的提⾼MySQL性能。
2、服务器参数:32G内存、4个CPU,每个CPU 8核。
3、MySQL⽬前安装状况。
MySQL⽬前安装,⽤的是MySQL默认的最⼤⽀持配置。
拷贝的是f.编码已修改为UTF-8.具体修改及安装MySQL,可以参考<<Linux系统上安装MySQL 5.5>>帮助⽂档。
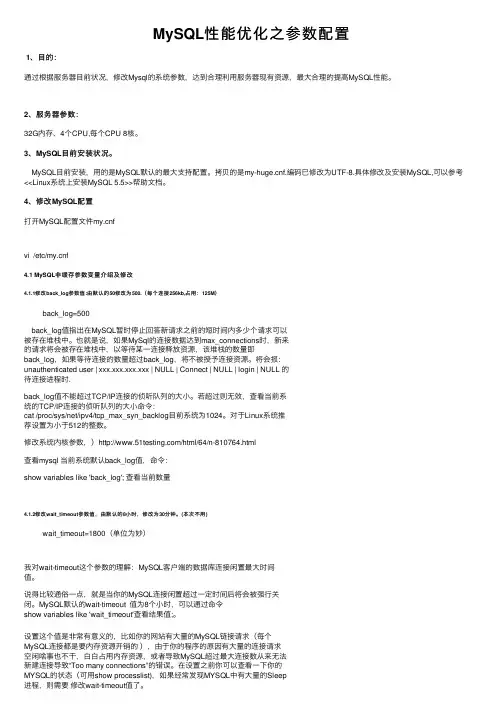
4、修改MySQL配置打开MySQL配置⽂件fvi /etc/f4.1 MySQL⾮缓存参数变量介绍及修改4.1.1修改back_log参数值:由默认的50修改为500.(每个连接256kb,占⽤:125M)back_log=500back_log值指出在MySQL暂时停⽌回答新请求之前的短时间内多少个请求可以被存在堆栈中。
也就是说,如果MySql的连接数据达到max_connections时,新来的请求将会被存在堆栈中,以等待某⼀连接释放资源,该堆栈的数量即back_log,如果等待连接的数量超过back_log,将不被授予连接资源。
将会报:unauthenticated user | xxx.xxx.xxx.xxx | NULL | Connect | NULL | login | NULL 的待连接进程时.back_log值不能超过TCP/IP连接的侦听队列的⼤⼩。
若超过则⽆效,查看当前系统的TCP/IP连接的侦听队列的⼤⼩命令:cat /proc/sys/net/ipv4/tcp_max_syn_backlog⽬前系统为1024。
对于Linux系统推荐设置为⼩于512的整数。
修改系统内核参数,)/html/64/n-810764.html查看mysql 当前系统默认back_log值,命令:show variables like 'back_log'; 查看当前数量4.1.2修改wait_timeout参数值,由默认的8⼩时,修改为30分钟。
MySql(十):MySQL性能调优——MySQLServer性能优化
MySql(⼗):MySQL性能调优——MySQLServer性能优化本章主要通过针对MySQL Server( mysqld)相关实现机制的分析,得到⼀些相应的优化建议。
主要涉及MySQL的安装以及相关参数设置的优化,但不包括mysqld之外的⽐如存储引擎相关的参数优化,存储引擎的相关参数设置建议将主要在下⼀章“ 常⽤存储引擎的优化” 中进⾏说明。
⼀、MySQL安装和优化1.选择合适的发⾏版本a.⼆进制发⾏版(包括RPM 等包装好的特定⼆进制版本)由于MySQL 开源的特性,不仅仅MySQL AB 提供了多个平台上⾯的多种⼆进制发⾏版本可以供⼤家选择,还有不少第三⽅公司(或者个⼈)也给我们提供了不少选择。
使⽤MySQL AB 提供的⼆进制发⾏版本我们可以得到哪些好处?a) 通过⾮常简单的安装⽅式快速完成MySQL 的部署;b) 安装版本是经过⽐较完善的功能和性能测试的编译版本;c) 所使⽤的编译参数更具通⽤性的,且⽐较稳定;d) 如果购买了MySQL 的服务,将能最⼤程度的得到MySQL 的技术⽀持;b.第三⽅提供的MySQL 发⾏版本⼤多是在MySQL AB 官⽅提供的源代码⽅⾯做了或多或少的针对性改动,然后再编译⽽成。
这些改动有些是在某些功能上⾯的改进,也有些是在某写操作的性能⽅⾯的改进。
还有些由各OS ⼚商所提供的发⾏版本,则可能是在有些代码⽅⾯针对⾃⼰的OS 做了⼀些相应的底层调⽤的调整,以使MySQL 与⾃⼰的OS 能够更完美的结合。
当然,也有⼀些第三⽅发⾏版本并没有动过MySQL ⼀⾏代码,仅仅只是在编译参数⽅⾯做了⼀些相关的调整,⽽让MySQL 在某些特定场景下表现更优秀。
这样⼀说,听起来好像第三⽅发⾏的MySQL ⼆进制版本要⽐MySQL AB 官⽅提供的⼆进制发⾏版有更⼤的吸引⼒,那么我们是否就应该选⽤第三⽅提供的⼆进制发⾏版呢?需要进⼀步分析⼀下第三⽅发⾏版本可能存在哪些问题?⾸先,由于第三⽅发⾏版本对MySQL 所做的改动,很多都是为了应对发⾏者⾃⼰所处的特定场景⽽做出来的。
MySQL数据库中写入性能优化的方法与技巧

MySQL数据库中写入性能优化的方法与技巧一、简介MySQL是一种常用的关系型数据库管理系统,被广泛应用于各种大型应用中。
而对于很多应用程序来说,数据库的写入性能至关重要。
本文将介绍一些优化MySQL数据库写入性能的方法与技巧。
二、选择合适的存储引擎MySQL提供了多个存储引擎,如InnoDB、MyISAM等。
每个存储引擎都有其特点和适用场景。
在写入密集型的场景下,InnoDB存储引擎通常表现更好。
因为它支持行级锁和事务,可以提供更好的并发性能和数据的一致性。
而对于读多写少的场景,MyISAM存储引擎可能会更适合。
三、使用批量操作在插入大量数据时,采用批量操作比逐条插入更高效。
可以使用LOAD DATA INFILE语句导入CSV或TXT格式的文件,或者使用多值插入语法INSERT INTO table (column1, column2) VALUES (value1, value2), (value1, value2)等。
这样可以减少网络开销和连接开销,提升写入性能。
四、合理设计表结构良好的表结构设计也能提升MySQL数据库的写入性能。
避免使用过多的索引和约束,因为这会增加写入操作的时间。
可以根据具体需求,选择合适的数据类型和字段大小。
此外,将常用的查询字段放在一起,可以减少硬盘I/O,提高查询效率。
五、调整缓存大小MySQL使用了多级缓存来加速查询和写入操作。
其中,InnoDB存储引擎的主要缓存是缓冲池。
通过适当地设置innodb_buffer_pool_size参数,可以调整缓冲池的大小,提升写入性能。
但是也不能设置得过大,因为这会导致内存不足,引发其他性能问题。
六、合理配置日志刷新机制MySQL使用了日志刷新来保证数据的持久性。
但是频繁的日志刷新操作会降低写入性能。
可以通过修改innodb_flush_log_at_trx_commit参数的值,将其设置为合适的数值,来平衡数据安全性和写入性能。
mysql性能优化精品PPT课件
目录索引
MySQL优化方式 MySQL技巧分享 MySQL函数
MySQL优化方式
MySQL优化方式
系统优化:硬件、架构 服务优化 应用优化
系统优化
使用好的硬件,更快的硬盘、大内存、多核CPU,专业的存 储服务器(NAS、SAN)
设计合理架构,如果 MySQL 访问频繁,考虑 Master/Slave 读写分离;数据库分表、数据库切片(分布式),也考虑使 用相应缓存服务帮助 MySQL 缓解访问压力
选项
max_connections query_cache_size sort_buffer_size
record_buffer table_cache
缺省值
100 0 (不打开)M 16M
16M 512
说明
MySQL服务器同时处理的数据库连接的最大数量
查询缓存区的最大长度,按照当前需求,一倍一倍 增加,本选项比较重要
每个线程的排序缓存大小,一般按照内存可以设置 为2M以上,推荐是16M,该选项对排序order by, group by起作用
每个进行一个顺序扫描的线程为其扫描的每张表分 配这个大小的一个缓冲区,可以设置为2M以上
为所有线程打开表的数量。增加该值能增加mysqld 要求的文件描述符的数量。MySQL对每个唯一打开 的表需要2个文件描述符。
8M
128M 0 256M
innodb_log_buffer_size
128K
8M
说明
InnoDB使用一个缓冲池来保存索引和原始数据, 这 里你设置越大,你在存取表里面数据时所需要的磁盘 I/O越少,一般是内存的一半,不超过2G,否则系 统会崩溃,这个参数非常重要
InnoDB用来保存 metadata 信息, 如果内存是4G, 最好本值超过200M
MySQL数据表的性能优化与规划
MySQL数据表的性能优化与规划章节1:引言MySQL是一个流行的关系型数据库管理系统。
它可以用于存储和管理各种类型的数据。
MySQL具有良好的可扩展性和灵活性,使其成为许多网站和应用程序的首选数据库。
然而,数据表在MySQL中的性能和规划方面是关键问题。
MySQL的性能优化和规划可以帮助提高应用程序的响应时间,减少请求延迟,并促进数据库的可靠性。
在本文中,我们将探讨MySQL数据表的性能优化和规划。
章节2:表的设计规划数据表设计是数据库管理的核心任务之一。
在MySQL中,表的性能优化和规划必须始于表的设计和规划。
下面是一些表的设计规划原则:2.1.规范表的命名命名约定是表设计中的重要元素。
命名必须为英文单词或者短语,明确表达表的意图。
同时也要注意表名大小写的一致性和字符集的统一。
建议在表名中使用下划线“_”来分隔单词。
2.2.确定表的字段表的字段是建立数据库的基础。
为了使表的性能达到最佳状态,确定表中的正确的字段非常重要。
为表的每个字段选择正确的数据类型,以便最大限度地减少存储空间和提高性能。
例如,选择INT data-type而不是VARCHAR data-type来存储小数值。
2.3.优化索引索引在数据库性能方面起着非常重要的作用。
如果正确地优化索引,可以大大减少查询时间和响应时间。
MySQL支持各种类型的索引,包括B-Tree索引、哈希索引和全文索引。
2.4.规划表的大小和宽度MySQL表的大小对查询性能有很大影响。
规划表的大小和宽度是重要的优化因素。
建议在一个表中最多包含200万行。
如果您需要存储更多的数据,则应将其分解为多个表。
2.5.使用分区表分区表是MySQL提供的一个高级功能,用于把一张大表(1000万行以上)分成较小的表块,以实现更快的查询速度和更好的数据管理。
章节3:表的性能优化优化表是MySQL管理的核心任务之一。
通过优化表,可以提高查询性能,快速响应客户请求,减少数据库中的负载并有效地管理数据。
MySQL中的数据导入和导出的性能优化
MySQL中的数据导入和导出的性能优化MySQL 是目前最流行的数据库管理系统之一,在各行各业的应用中都有广泛的应用。
在日常的数据处理和分析中,数据的导入和导出是非常常见的操作。
然而,由于数据量的增大和复杂性的提高,导入和导出的性能问题也逐渐凸显出来。
本文将探讨 MySQL 中的数据导入和导出的性能优化方法,以帮助读者更好地处理大规模数据的导入和导出任务。
一、概述数据导入和导出是数据库管理中的重要环节,尤其在数据迁移、备份与恢复、分析研究等场景下。
而数据量的增加和复杂性的提高使得导入和导出的性能变得尤为重要。
在日常工作中,我们可能会遇到以下一些情况:1. 导入大量数据到 MySQL 数据库中,如从其他数据库迁移数据或从文件中导入数据。
2. 导出 MySQL 数据库中的数据,如备份、迁移或分析需求。
3. 数据库之间的迁移,如从线上环境到测试环境。
4. 数据库备份和恢复,如定期备份以及在发生故障时的快速恢复。
在以上场景中,优化数据的导入和导出性能对我们提高生产力、缩短操作时间具有重要意义。
下面将介绍一些优化方法供参考。
二、导入性能优化1. 使用 LOAD DATA INFILELOAD DATA INFILE 是 MySQL 提供的快速导入数据的方法。
相比较传统的INSERT 语句逐条插入数据,LOAD DATA INFILE 允许直接从文件中读取数据,并将其加载到数据库中。
它能够显著提高导入数据的速度,特别是在处理大量数据时。
使用 LOAD DATA INFILE 时需要注意以下几点:(1) 确保文件的格式正确,与表的结构保持一致。
(2) 将文件放在数据库服务器上的本地文件系统上,避免网络传输的延迟。
(3) 禁用索引,等待数据导入完成后再重新建索引。
2. 增大 max_allowed_packet 和 innodb_log_file_sizemax_allowed_packet 是指一次性发送给服务器的最大数据包大小。
MySQL中的内存调优和IO优化方法
MySQL中的内存调优和IO优化方法随着数据量的增加,数据库的性能优化变得越来越重要。
在MySQL中,内存和IO是两个关键的性能瓶颈。
本文将介绍MySQL中的内存调优和IO优化方法,帮助您更好地优化数据库性能。
一、MySQL中的内存调优1. 设定合理的缓冲池大小MySQL的缓冲池使用在InnoDB存储引擎中,用于存放数据和索引的页面。
缓冲池的大小决定了可以缓存的数据量,从而影响查询的性能。
一般来说,缓冲池大小应该设置为系统内存的70-80%。
可以通过修改配置文件(f)中的参数innodb_buffer_pool_size来调整缓冲池大小。
2. 调整查询缓存查询缓存是MySQL中用于缓存查询结果的功能。
尽管查询缓存可以提高一些相同查询的性能,但在高并发的情况下,查询缓存的效果可能不佳。
可以通过修改配置文件中的参数query_cache_size和query_cache_type来调整查询缓存的大小和使用策略,以适应不同的应用场景。
3. 优化临时表的内存使用当执行查询或排序操作时,MySQL可能会在内存中创建临时表,临时表的内存使用对性能有很大影响。
可以通过修改配置文件中的参数tmp_table_size和max_heap_table_size来调整临时表的内存使用。
尽量将临时表的操作放到内存中,避免使用磁盘临时表。
二、MySQL中的IO优化1. 提高磁盘性能磁盘是数据库中最慢的组件之一,提高磁盘性能可以显著提升数据库的响应速度。
以下是一些提高磁盘性能的方法:- 使用RAID技术:RAID可以通过将数据分布在多个磁盘上来提高读写性能和数据冗余能力。
可以选择适合的RAID级别来满足性能和容错要求。
- 使用高速硬盘:使用SSD(固态硬盘)或高转速的SAS硬盘可以显著提升磁盘性能。
- 分区和格式化硬盘:合理分区和格式化硬盘可以提高磁盘的读写性能。
2. 使用合适的存储引擎MySQL支持多种存储引擎,每种引擎都有其特点和适用场景。
Mysql数据库性能优化培训
通用SQL优化(举例)
通用SQL优化(举例)
通用SQL优化(举例)
通用SQL优化(进一步讨论)
• 使用MySQL时,为了得到合理的执行计划, 需要使用hint。这使得本该对应用程序屏蔽 的执行计划暴露给了执行计划。
• 当数据分布变化时,需要更改SQL语句。 这是一个硬伤。
• 其它先进的数据库如何解决这个问题(data distribution is skewed)
• 验证连接(用户是否有登陆权限) • 解析Query语句 • 权限匹配 • 哈希后检查Query Cache • 生成执行计划 • 执行上一步的计划,得到结果集 • 返回结果集给客户
基本查询举例
• 全表扫描
性能决定于表的大小,类似的扫描性能决定于取 回数据的多少
| table_name | table_rows | avg_row_length | data_length | index_length |
1 row in set (46.29 sec)
基本查询举例
• 全表扫描
+--------------+-------------+--------------+ | table_name | data_length | index_length | +--------------+-------------+--------------+ | comment_star | 531921 | 39936 | +--------------+-------------+--------------+ 1 row in set (0.01 sec) mySQL> select avg(upcount) from comment_star; +--------------+ | avg(upcount) | +--------------+ | 0.0000 | +--------------+ 1 row in set (0.03 sec)