
利用正则表达式进行查找 _ 换替
中文符号正则表达式

中文符号正则表达式一、校验数字的表达式数字:^[0-9]*$n位的数字:^\d{n}$至少n位的数字:^\d{n,}$m-n位的数字:^\d{m,n}$零和非零开头的数字:^(0|[1-9][0-9]*)$非零开头的最多带两位小数的数字:^([1-9][0-9]*)+(.[0-9]{1,2})?$带1-2位小数的正数或负数:^(\-)?\d+(\.\d{1,2})?$正数、负数、和小数:^(\-|\+)?\d+(\.\d+)?$有两位小数的正实数:^[0-9]+(.[0-9]{2})?$有1~3位小数的正实数:^[0-9]+(.[0-9]{1,3})?$非零的正整数:^[1-9]\d*$ 或^([1-9][0-9]*){1,3}$ 或^\+?[1-9][0-9]*$非零的负整数:^\-[1-9][]0-9"*$ 或^-[1-9]\d*$非负整数:^\d+$ 或^[1-9]\d*|0$非正整数:^-[1-9]\d*|0$ 或^((-\d+)|(0+))$非负浮点数:^\d+(\.\d+)?$ 或^[1-9]\d*\.\d*|0\.\d*[1-9]\d*|0?\.0+|0$非正浮点数:^((-\d+(\.\d+)?)|(0+(\.0+)?))$ 或^(-([1-9]\d*\.\d*|0\.\d*[1-9]\d*))|0?\.0+|0$正浮点数:^[1-9]\d*\.\d*|0\.\d*[1-9]\d*$ 或^(([0-9]+\.[0-9]*[1-9][0-9]*)|([0-9]*[1-9][0-9]*\.[0-9]+)|([0-9]*[ 1-9][0-9]*))$负浮点数:^-([1-9]\d*\.\d*|0\.\d*[1-9]\d*)$ 或^(-(([0-9]+\.[0-9]*[1-9][0-9]*)|([0-9]*[1-9][0-9]*\.[0-9]+)|([0-9] *[1-9][0-9]*)))$浮点数:^(-?\d+)(\.\d+)?$ 或^-?([1-9]\d*\.\d*|0\.\d*[1-9]\d*|0?\.0+|0)$二、校验字符的表达式汉字:^[\u4e00-\u9fa5]{0,}$英文和数字:^[A-Za-z0-9]+$ 或^[A-Za-z0-9]{4,40}$长度为3-20的所有字符:^.{3,20}$由26个英文字母组成的字符串:^[A-Za-z]+$由26个大写英文字母组成的字符串:^[A-Z]+$由26个小写英文字母组成的字符串:^[a-z]+$由数字和26个英文字母组成的字符串:^[A-Za-z0-9]+$由数字、26个英文字母或者下划线组成的字符串:^\w+$ 或^\w{3,20}中文、英文、数字包括下划线:^[\u4E00-\u9FA5A-Za-z0-9_]+$中文、英文、数字但不包括下划线等符号:^[\u4E00-\u9FA5A-Za-z0-9]+$ 或^[\u4E00-\u9FA5A-Za-z0-9]{2,20}$可以输入含有^%&',;=?$\"等字符:[^%&',;=?$\x22]+禁止输入含有~的字符[^~\x22]+其它:.*匹配除 \n 以外的任何字符。
R语言中正则表达式的规则
R语言中正则表达式的规则正则表达式表通常被用来检索、替换那些符合某个模式(规则)的文本。
在我看来,正则表达式的主要用途有两种:①查找特定的信息②查找并编辑特定的信息,也就是我们经常用的替换。
比如我们要在Word,记事本等里面使用快捷键Ctrl+F,进行查找一个特定的字符,或者替换一个字符,这就使用了正则表达式。
正则表达式的功能非常强大,尤其是在文本数据进行处理中显得更加突出。
R中的grep、grepl、sub、gsub、regexpr、gregexpr 等函数都使用正则表达式的规则进行匹配。
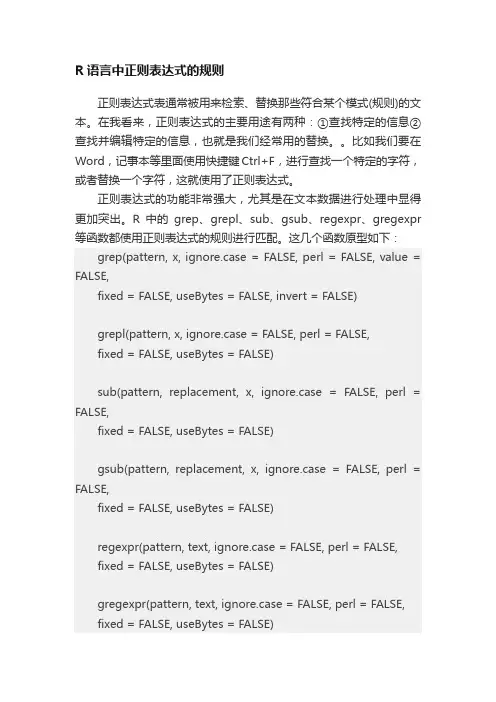
这几个函数原型如下:grep(pattern, x, ignore.case = FALSE, perl = FALSE, value = FALSE,fixed = FALSE, useBytes = FALSE, invert = FALSE)grepl(pattern, x, ignore.case = FALSE, perl = FALSE,fixed = FALSE, useBytes = FALSE)sub(pattern, replacement, x, ignore.case = FALSE, perl = FALSE,fixed = FALSE, useBytes = FALSE)gsub(pattern, replacement, x, ignore.case = FALSE, perl = FALSE,fixed = FALSE, useBytes = FALSE)regexpr(pattern, text, ignore.case = FALSE, perl = FALSE,fixed = FALSE, useBytes = FALSE)gregexpr(pattern, text, ignore.case = FALSE, perl = FALSE,fixed = FALSE, useBytes = FALSE)regexec(pattern, text, ignore.case = FALSE, perl = FALSE, fixed = FALSE, useBytes = FALSE)这里是对参数进行一个解释说明。
re.sub正则表达式 -回复

re.sub正则表达式-回复正则表达式是一种强大的文本处理工具,用于匹配、查找和替换字符串中的特定模式。
re.sub函数是Python中re模块提供的一个方法,用于在字符串中根据正则表达式进行替换操作。
在本文中,我们将以中括号内的内容为主题,一步一步解释re.sub函数的使用方法和注意事项。
正则表达式是一种用于描述、匹配和操作文本的语言。
它由一系列字符和控制符组成,可以表示一定规则的模式。
在正则表达式中,方括号([])用来表示可选字符集合,被括号括起来的字符表示一个字符范围。
re.sub函数是Python中用于替换字符串的方法。
它的语法为:re.sub(pattern, repl, string, count=0),其中pattern是要匹配的正则表达式,repl是要替换的字符串,string是要被匹配和替换的原始字符串,count是替换次数(可选参数,默认替换所有匹配到的字符串)。
首先,我们需要导入re模块,然后定义一个原始字符串,用于测试re.sub 函数的使用。
假设我们要将字符串中的某些字符替换成其他字符,我们可以使用re.sub函数来完成这个任务。
接下来,我们需要定义一个正则表达式,用于匹配我们想要替换的字符串模式。
正则表达式可以是一个简单的字符串,也可以是一个更复杂的模式。
然后,我们需要定义一个替换字符串,用于替换匹配到的字符串。
替换字符串可以是一个固定的字符串,也可以是一个函数,根据匹配到的字符串动态生成替换字符串。
最后,我们调用re.sub函数,传入正则表达式、替换字符串和原始字符串,即可完成字符串的替换操作。
根据需要,我们还可以传入count参数,限制替换的次数。
在使用re.sub函数时,我们需要注意一些事项。
首先,正则表达式应该正确匹配到要替换的字符串。
如果正则表达式不正确,将无法匹配到要替换的字符串,导致替换操作失败。
其次,替换字符串应根据需要进行调整。
如果替换字符串不正确,可能会导致替换结果出错。
Emeditor正则表达式语法

Emeditor正则表达式语法Emeditor正则表达式语法(Regular expression, 简写Regexes 或Regex)1 普通字符普通字符是指除了 ".", "*", "?", "+", "(", ")", "{", "}", "[", "]", "^", "$" 和 "\" 这些特殊字符之外的所有其他字符。
而这些特殊字符也可以通过前面加上"\"前缀而变为普通字符。
比如, 搜索"CCF"即为在文本中匹配所有的"CCF"字符串, 搜索"\[CCF\]"则是在文本中匹配所有的"[CCF]"字符串,简而言之, 普通字符即为只匹配自身的字符。
2 元字符2.1 特殊字符. 匹配除换行符 \n 之外的任何单个字符。
( ) 分组捕获(子表达式)的开始和结束。
可以捕获子表达式以供以后使用。
[ ] 中括号表达式的开始。
中括号表达式是在方括号内包含一个或多个字符构成的列表的表达式。
普通字符在中括号内表示本身,大多数特殊字符在中括号表达式内出现时失去它们的意义。
除了转义字符''\'', (要包含''\'', 需要使用''\\'') 如: 正则表达式 No [1234] 匹配 No 1, No 2, No 3 和 No 4。
如果想在中括号中使用一个范围作为列表来匹配字符,可以用连字符 ''-'' 将范围中的开始字徒崾址挚ジ鲎址淖址等范ǚ段诘南喽运承颉H? 正则表达式 No [1-4] = No [1234]。
连续逗号 正则表达式

连续逗号 正则表达式 正则表达式(Regular Expression)是计算机科学中一种基本的文本处理工具。它可以用于匹配、搜索、替换、提取文本等操作,是诸如文本编辑器、编程语言、各种软件应用中不可或缺的核心组成部分。 在正则表达式中,连续逗号在匹配文本或字符串中出现的情况是一种常见的问题。本文将详细介绍连续逗号在正则表达式中的用法和匹配规则。 一、连续逗号的含义 在正则表达式中,逗号(,)代表一个字符或一个字符集合之间的分隔符。当出现连续逗号的时候,其含义会因不同的语言实现而有所不同。在某些实现中,连续逗号经常用于表示空字符或空白符;在某些实现中,连续逗号则代表多个分隔符的组合。 二、连续逗号在正则表达式中的使用 1.匹配多个逗号 当我们需要匹配多个逗号时,可以使用一个或多个逗号字符,加上量词符号(如*、+和?)来匹配。例如,在以下示例中,使用逗号加上星号量词(,*)来匹配连续逗号: /,,*/ 此正则表达式表示匹配任意数量的逗号,包括连续的逗号。 2.匹配逗号和其他字符的组合 有时,我们需要匹配逗号和其他字符的组合。这时,我们可以使用括号(())将逗号和其他字符结合在一起进行匹配。例如,在以下示例中,使用括号将逗号和字母“a”进行匹配: /(,a)+/ 此正则表达式表示匹配一个逗号后面跟着一个字母“a”,然后重复多次(包括连续的情况)。注意,上述正则表达式中加号(+)表示匹配一个或多个括号中的字符(逗号和字母“a”)。 3.匹配使用逗号分隔的数字列表 在实际应用中,我们可以使用逗号作为数字列表中的分隔符。如果希望匹配这样的数字列表,我们可以使用类似于以下示例的正则表达式: /\d+(,\d+)*/ 此正则表达式表示匹配至少一个数字(\d+),后面跟着逗号和一个或多个数字((,\d+)*)。 注意,在这种情况下,如果列表中有一个或多个连续的逗号,也将被匹配。因此,这个正则表达式并不能过滤掉列表中的空项。 三、避免连续逗号的注意事项 在实际应用中,连续逗号可能会出现,但有时也希望能够避免这种情况。以下是一些有用的提示: 1.使用分隔符分割列表 为了避免连续逗号,我们可以使用其他分隔符来替代逗号。例如,可以在数字列表中使用分号(;)或冒号(:)。 2.添加限制条件 在匹配逗号时,我们可以加上限制条件,确保逗号不会出现在字符串的开头或结尾。例如,在以下示例中,加上开头和结尾的限定条件来避免连续逗号: /\d+(,\d+)+$/ 此正则表达式表示匹配以至少一个数字开头,后面跟着一个逗号和一个或多个数字,以及一个结尾的字符串。 3.对连续逗号进行特殊处理 当连续逗号不可避免时,可以创建一个专用的正则表达式来处理这种情况。例如,在此示例中,可以使用以下正则表达式来匹配连续逗号: /(,)+/ 此正则表达式表示匹配至少两个逗号,在这之间可以有任意数量的空格或其他字符。 四、总结 在正则表达式中,逗号是一个常用的字符分隔符之一。当出现连续逗号的时候,其含义和匹配规则会因不同的语言实现而有所不同。 为了避免连续逗号,我们可以改用其他分隔符,或者通过添加限制条件或特殊处理来解决这个问题。 总之,理解连续逗号在正则表达式中的用法和注意事项,对于提高文本处理的效率和精度非常重要。
gvim正则表达式查找字符串
gvim正则表达式查找字符串摘要:1.Gvim 简介2.正则表达式的概念和用途3.在gvim 中使用正则表达式查找字符串的方法4.常用正则表达式元字符和示例5.小结正文:一、Gvim 简介Gvim 是一个功能强大的文本编辑器,它是Vim 编辑器的一个图形界面版本。
Gvim 具有高度可定制性,支持多种编程语言,并提供了一系列强大的功能,如查找、替换、剪切、复制等。
对于文本处理工作来说,Gvim 是一个非常实用的工具。
二、正则表达式的概念和用途正则表达式(Regular Expression,简称regex)是一种强大的文本搜索和匹配工具。
它可以用来查找特定的文本模式、验证输入的数据格式等。
在Gvim 中,正则表达式常用于查找和替换文本内容,从而提高文本处理的效率。
三、在gvim 中使用正则表达式查找字符串的方法在Gvim 中,可以使用正则表达式来进行查找操作。
以下是具体步骤:1.打开Gvim,载入需要查找的文本文件。
2.按下“/”键,打开查找对话框。
3.在查找对话框中,将光标移动到“查找内容”输入框,输入需要查找的正则表达式。
4.如果需要全局查找,勾选“全局”选项。
5.点击“查找下一个”按钮,Gvim 将会在文档中查找与正则表达式匹配的内容。
四、常用正则表达式元字符和示例正则表达式包含了一些特殊的元字符,它们可以帮助我们构建更复杂的匹配模式。
以下是一些常用的正则表达式元字符及其示例:1.“.”:匹配任意字符2.“*”:匹配前面的字符0 次或多次3.“+”:匹配前面的字符1 次或多次4.“{n}”:匹配前面的字符n 次5.“{n,}”:匹配前面的字符n 次或多次6.“{n,m}”:匹配前面的字符n 到m 次7.“[^abc]”:匹配除方括号内字符以外的任意字符8.“[a-zA-Z]”:匹配所有英文字母9.“d”:匹配数字10.“D”:匹配非数字11.“s”:匹配空白字符(空格、制表符、换行符等)12.“S”:匹配非空白字符13.“w”:匹配单词字符(字母、数字、下划线)14.“W”:匹配非单词字符五、小结Gvim 作为一款强大的文本编辑器,支持使用正则表达式进行查找操作,可以有效地提高文本处理的效率。
shell脚本——字符串操作(长度,查找,替换)
shell脚本——字符串操作(长度,查找,替换)表达式 含义${var} 变量var的值, 与$var相同${var-DEFAULT} 如果var没有被声明, 那么就以$DEFAULT作为其值 *${var:-DEFAULT} 如果var没有被声明, 或者其值为空, 那么就以$DEFAULT作为其值 *${var=DEFAULT} 如果var没有被声明, 那么就以$DEFAULT作为其值 *${var:=DEFAULT} 如果var没有被声明, 或者其值为空, 那么就以$DEFAULT作为其值 *${var+OTHER} 如果var声明了, 那么其值就是$OTHER, 否则就为null字符串${var:+OTHER} 如果var被设置了, 那么其值就是$OTHER, 否则就为null字符串${var?ERR_MSG} 如果var没被声明, 那么就打印$ERR_MSG *${var:?ERR_MSG} 如果var没被设置, 那么就打印$ERR_MSG *${!varprefix*} 匹配之前所有以varprefix开头进⾏声明的变量${!varprefix@} 匹配之前所有以varprefix开头进⾏声明的变量在做shell批处理程序时候,经常会涉及到字符串相关操作。
有很多命令语句,如:awk,sed都可以做字符串各种操作。
其实shell内置⼀系列操作符号,可以达到类似效果,⼤家知道,使⽤内部操作符会省略启动外部程序等时间,因此速度会⾮常的快。
⼀、判断读取字符串值加⼊了“*” 不是意思是:当然, 如果变量var已经被设置的话, 那么其值就是$var.[chengmo@localhost ~]$ echo ${abc-'ok'}ok[chengmo@localhost ~]$ echo $abc[chengmo@localhost ~]$ echo ${abc='ok'}ok[chengmo@localhost ~]$ echo $abcok如果abc 没有声明“=" 还会给abc赋值。
s_itr指令的原理
s_itr指令的原理s_itr指令是一条用于执行搜索操作的命令,主要用于在程序中进行字符串搜索和更替的功能。
本文将详细介绍s_itr指令的原理,并逐步解释其功能和使用方法。
1. s_itr指令的概述:s_itr指令是一种在编程语言中用于字符串搜索和更替的指令。
它接受一个字符串作为参数,并返回该字符串中所有满足条件的搜索结果。
s_itr指令通常用在循环结构中,以便对字符串进行遍历和处理。
2. 参数说明:s_itr指令的参数包括两部分,即搜索模式和待查找的字符串。
搜索模式是一个正则表达式,用于指定要搜索的字符串的规则。
待查找的字符串是要进行搜索和替换的字符串。
3. 正则表达式:正则表达式是一种通用的字符串匹配模式,用于描述搜索规则。
正则表达式由一系列字符和元字符组成,可以精确地匹配不同规则的字符串。
s_itr指令使用正则表达式作为搜索模式,从而实现高灵活性的字符串搜索功能。
4. 搜索过程:s_itr指令的搜索过程主要包括以下几个步骤:4.1. 接收参数:程序接收s_itr指令并解析出正则表达式和待查找的字符串。
4.2. 遍历字符串:程序根据正则表达式,逐一比对字符串的每一个字符。
4.3. 查找匹配:在遍历字符串的过程中,程序通过模式匹配,找到满足正则表达式的子串。
4.4. 返回结果:程序将每个匹配到的子串返回,并进行记录、打印或其他处理。
5. 示例用法:下面是一个示例用法,展示了s_itr指令的基本功能和语法:cppstring text = "This is a sample text.";regex pattern("sample");s_itr(pattern, text); 搜索字符串并返回所有匹配结果在上述示例中,s_itr指令接受一个正则表达式(`"sample"`)和一个待查找的字符串(`"This is a sample text."`)作为参数,然后搜索字符串并返回所有匹配结果。
java正则表达式
java正则表达式⼀、校验数字的表达式1 数字:^[0-9]*$2 n位的数字:^\d{n}$3 ⾄少n位的数字:^\d{n,}$4 m-n位的数字:^\d{m,n}$5 零和⾮零开头的数字:^(0|[1-9][0-9]*)$6 ⾮零开头的最多带两位⼩数的数字:^([1-9][0-9]*)+(.[0-9]{1,2})?$7 带1-2位⼩数的正数或负数:^(\-)?\d+(\.\d{1,2})?$8 正数、负数、和⼩数:^(\-|\+)?\d+(\.\d+)?$9 有两位⼩数的正实数:^[0-9]+(.[0-9]{2})?$10 有1~3位⼩数的正实数:^[0-9]+(.[0-9]{1,3})?$11 ⾮零的正整数:^[1-9]\d*$ 或 ^([1-9][0-9]*){1,3}$ 或 ^\+?[1-9][0-9]*$12 ⾮零的负整数:^\-[1-9][]0-9"*$ 或 ^-[1-9]\d*$13 ⾮负整数:^\d+$ 或 ^[1-9]\d*|0$14 ⾮正整数:^-[1-9]\d*|0$ 或 ^((-\d+)|(0+))$15 ⾮负浮点数:^\d+(\.\d+)?$ 或 ^[1-9]\d*\.\d*|0\.\d*[1-9]\d*|0?\.0+|0$16 ⾮正浮点数:^((-\d+(\.\d+)?)|(0+(\.0+)?))$ 或 ^(-([1-9]\d*\.\d*|0\.\d*[1-9]\d*))|0?\.0+|0$17 正浮点数:^[1-9]\d*\.\d*|0\.\d*[1-9]\d*$ 或 ^(([0-9]+\.[0-9]*[1-9][0-9]*)|([0-9]*[1-9][0-9]*\.[0-9]+)|([0-9]*[1-9][0-9]*))$18 负浮点数:^-([1-9]\d*\.\d*|0\.\d*[1-9]\d*)$ 或 ^(-(([0-9]+\.[0-9]*[1-9][0-9]*)|([0-9]*[1-9][0-9]*\.[0-9]+)|([0-9]*[1-9][0-9]*)))$19 浮点数:^(-?\d+)(\.\d+)?$ 或 ^-?([1-9]\d*\.\d*|0\.\d*[1-9]\d*|0?\.0+|0)$⼆、校验字符的表达式1 汉字:^[\u4e00-\u9fa5]{0,}$2 英⽂和数字:^[A-Za-z0-9]+$ 或 ^[A-Za-z0-9]{4,40}$3 长度为3-20的所有字符:^.{3,20}$4 由26个英⽂字母组成的字符串:^[A-Za-z]+$5 由26个⼤写英⽂字母组成的字符串:^[A-Z]+$6 由26个⼩写英⽂字母组成的字符串:^[a-z]+$7 由数字和26个英⽂字母组成的字符串:^[A-Za-z0-9]+$8 由数字、26个英⽂字母或者下划线组成的字符串:^\w+$ 或 ^\w{3,20}$9 中⽂、英⽂、数字包括下划线:^[\u4E00-\u9FA5A-Za-z0-9_]+$10 中⽂、英⽂、数字但不包括下划线等符号:^[\u4E00-\u9FA5A-Za-z0-9]+$ 或 ^[\u4E00-\u9FA5A-Za-z0-9]{2,20}$11 可以输⼊含有^%&',;=?$\"等字符:[^%&',;=?$\x22]+12 禁⽌输⼊含有~的字符:[^~\x22]+三、特殊需求表达式1 Email地址:^\w+([-+.]\w+)*@\w+([-.]\w+)*\.\w+([-.]\w+)*$2 域名:[a-zA-Z0-9][-a-zA-Z0-9]{0,62}(/.[a-zA-Z0-9][-a-zA-Z0-9]{0,62})+/.?4 ⼿机号码:^(13[0-9]|14[5|7]|15[0|1|2|3|5|6|7|8|9]|18[0|1|2|3|5|6|7|8|9])\d{8}$5 电话号码("XXX-XXXXXXX"、"XXXX-XXXXXXXX"、"XXX-XXXXXXX"、"XXX-XXXXXXXX"、"XXXXXXX"和"XXXXXXXX):^(\(\d{3,4}-)|\d{3.4}-)?\d{7,8}$6 国内电话号码(0511-*******、021-********):\d{3}-\d{8}|\d{4}-\d{7}7 ⾝份证号(15位、18位数字):^\d{15}|\d{18}$8 短⾝份证号码(数字、字母x结尾):^([0-9]){7,18}(x|X)?$ 或 ^\d{8,18}|[0-9x]{8,18}|[0-9X]{8,18}?$9 帐号是否合法(字母开头,允许5-16字节,允许字母数字下划线):^[a-zA-Z][a-zA-Z0-9_]{4,15}$10 密码(以字母开头,长度在6~18之间,只能包含字母、数字和下划线):^[a-zA-Z]\w{5,17}$11 强密码(必须包含⼤⼩写字母和数字的组合,不能使⽤特殊字符,长度在8-10之间):^(?=.*\d)(?=.*[a-z])(?=.*[A-Z]).{8,10}$12 ⽇期格式:^\d{4}-\d{1,2}-\d{1,2}13 ⼀年的12个⽉(01~09和1~12):^(0?[1-9]|1[0-2])$14 ⼀个⽉的31天(01~09和1~31):^((0?[1-9])|((1|2)[0-9])|30|31)$15 钱的输⼊格式:16 1.有四种钱的表⽰形式我们可以接受:"10000.00" 和 "10,000.00", 和没有 "分" 的 "10000" 和 "10,000":^[1-9][0-9]*$17 2.这表⽰任意⼀个不以0开头的数字,但是,这也意味着⼀个字符"0"不通过,所以我们采⽤下⾯的形式:^(0|[1-9][0-9]*)$18 3.⼀个0或者⼀个不以0开头的数字.我们还可以允许开头有⼀个负号:^(0|-?[1-9][0-9]*)$19 4.这表⽰⼀个0或者⼀个可能为负的开头不为0的数字.让⽤户以0开头好了.把负号的也去掉,因为钱总不能是负的吧.下⾯我们要加的是说明可能的⼩数部分:^[0-9]+(.[0-9]+)?$20 5.必须说明的是,⼩数点后⾯⾄少应该有1位数,所以"10."是不通过的,但是 "10" 和 "10.2" 是通过的:^[0-9]+(.[0-9]{2})?$21 6.这样我们规定⼩数点后⾯必须有两位,如果你认为太苛刻了,可以这样:^[0-9]+(.[0-9]{1,2})?$22 7.这样就允许⽤户只写⼀位⼩数.下⾯我们该考虑数字中的逗号了,我们可以这样:^[0-9]{1,3}(,[0-9]{3})*(.[0-9]{1,2})?$23 8.1到3个数字,后⾯跟着任意个逗号+3个数字,逗号成为可选,⽽不是必须:^([0-9]+|[0-9]{1,3}(,[0-9]{3})*)(.[0-9]{1,2})?$24 备注:这就是最终结果了,别忘了"+"可以⽤"*"替代如果你觉得空字符串也可以接受的话(奇怪,为什么?)最后,别忘了在⽤函数时去掉去掉那个反斜杠,⼀般的错误都在这⾥25 xml⽂件:^([a-zA-Z]+-?)+[a-zA-Z0-9]+\\.[x|X][m|M][l|L]$26 中⽂字符的正则表达式:[\u4e00-\u9fa5]27 双字节字符:[^\x00-\xff] (包括汉字在内,可以⽤来计算字符串的长度(⼀个双字节字符长度计2,ASCII字符计1))28 空⽩⾏的正则表达式:\n\s*\r (可以⽤来删除空⽩⾏)29 HTML标记的正则表达式:<(\S*?)[^>]*>.*?</\1>|<.*? /> (⽹上流传的版本太糟糕,上⾯这个也仅仅能部分,对于复杂的嵌套标记依旧⽆能为⼒)30 ⾸尾空⽩字符的正则表达式:^\s*|\s*$或(^\s*)|(\s*$) (可以⽤来删除⾏⾸⾏尾的空⽩字符(包括空格、制表符、换页符等等),⾮常有⽤的表达式)31 腾讯QQ号:[1-9][0-9]{4,} (腾讯QQ号从10000开始)32 中国邮政编码:[1-9]\d{5}(?!\d) (中国邮政编码为6位数字) 33 IP地址:\d+\.\d+\.\d+\.\d+ (提取IP地址时有⽤) 34 IP地址:((?:(?:25[0-5]|2[0-4]\\d|[01]?\\d?\\d)\\.){3}(?:25[0-5]|2[0-4]\\d|[01]?\\d?\\d))20个正则表达式必知(能让你少写1,000⾏代码)正则表达式(regular expression)描述了⼀种字符串匹配的模式,可以⽤来检查⼀个串是否含有某种⼦串、将匹配的⼦串做替换或者从某个串中取出符合某个条件的⼦串等。
【前端学习】字符串replace使用
【前端学习】字符串replace使⽤String对象的replace⽅法包含两个参数,第⼀个参数表⽰执⾏匹配的正则表达式,也可以传递字符串,第⼆个参数表⽰代替匹配的⼦字符串。
var b = s.replace("str1","str2");与search和match⽅法不同,replace⽅法不会吧字符串转换为正则表达式对象,⽽是以字符串直接量的⽂本模式尽⼼匹配。
第⼆个参数可以是替换⽂本,或者是⽣成替换⽂本的函数,将返回值作为替换⽂本。
replace⽅法同时执⾏查找和替换两个操作。
该⽅法将在字符串中查找与正则表达式相匹配的⼦字符串,然后调⽤第⼆个参数替换这些⼦字符串。
(js中正则表达式的使⽤⽅式有两种,⼀种是正则表达式对象的⽅法,⼀种是字符串对象的⽅法,前者有exec(str)、test(str)两个⽅法,后者有match(regexp)、replace(regexp)、search(regexp)、split(search)四个⽅法。
)如果正则表达式具有全局性质,那么将替换所有匹配的⼦字符串,否则只替换第⼀个匹配⼦字符串。
var b = '1231231234' ; console.log(b.replace('123','321')) // 3211231234 console.log(b.replace(/123/,'321')) //3211231234⾮全局正则 console.log(b.replace(/123/g,'321')) //3213213214全局正则在replace⽅法中约定了⼀个特殊的字符“$”,如果加了⼀个序号,就表⽰引⽤正则表达式中匹配的⼦表达式存储的字符串。
例如: var s = "javascript"; var b = s.replace(/(java)(script)/,''$2-$1"); console.log(b) // script-java$1,$2...$99;与正则表达式中的第1~99个⼦表达式相匹配的⽂本。