
数据》sqoop--数据仓库工具箱 数据挖掘
1. 了解Sqoop的来历
2. Sqoop的原理和底层实现
3. Sqoop的配置安装
4. Sqoop导入
- Sqoop的简介
- Sqoop的底层原理
- Sqoop的环境配置
- Sqoop和HDFS导入导出
- Sqoop和Hive的导入导出
- Sqoop和Hbase的导出
基于传统关系型数据库的稳定性,还是有很多企业将数据存储在关系型数据库中;早期由于工具的缺乏,
Hadoop与传统数据库之间的数据传输非常困难。基于前两个方面的考虑,需要一个在传统关系型数据库和Hadoop之间进行数据传输的项目,Sqoop应运而生。 一. 课前提示
1. 今日任务
2. 今日目标
2.1 了解和熟悉部分
2.2 掌握部分
二. 正课内容
1. Sqoop简介以及使用
1.1 产生背景
1.2 Sqoop是什么
Sqoop是一个用于Hadoop和结构化数据存储(如关系型数据库)之间进行高效传输大批量数据的
工具。它包括以下两个方面:
可以使用Sqoop将数据从关系型数据库管理系统(如MySQL)导入到Hadoop系统(如HDFS、Hive、
HBase)中
将数据从Hadoop系统中抽取并导出到关系型数据库(如MySQL)
常见数据库开源工具:
1. sqoop
2. datax
3. kettle
4. cannal 1.3 底层实现原理
Sqoop的核心设计思想是利用MapReduce加快数据传输速度。也就是说Sqoop的导入和导出功能是通过基于Map Task(只有map)的MapReduce作业实现的。所以它是一种批处理方式进行数据传输,难以实现实时的数据进行导入和导出。
官网介绍:
Apache Sqoop(TM) is a tool designed for efficiently transferring bulk
data between Apache Hadoop and structured datastores such as relational databases.
Sqoop结构图:
1.4 特点
优点:它可以将跨平台的数据进行整合。缺点:它不是很灵活。
主要执行操作 tar
-zxvf
/opt/soft/sqoop...
-C
/opt/app/sqoop... vi /etc/profile
mv ./conf/sqoop-env-template.sh ./conf/sqoop-env.sh
vi ./conf/sqoop-env.sh
export HADOOP_COMMON_HOME=/usr/local/hadoop-2.7.1/
export HADOOP_MAPRED_HOME=/usr/local/hadoop-2.7.1/
export HIVE_HOME=/usr/local/hive-1.2.1/
export ZOOCFGDIR=/usr/local/zookeeper-3.4.7/
cp /home/mysql-connector-java-5.1.18.jar ./lib/
sqoop的重要的几个关键词
==import== : 从关系型数据库到hadoop
==export== : 从hadoop到关系型数据库。
2 Sqoop的安装
注意:在安装sqoop之前要配置好本机的Java环境和Hadoop环境
2.1 、解压配置环境变量
2.2 、新建配置文件
2.3 、修改配置文件
配置文件:
2.4 、拷贝mysql驱动
Mysql HDFS Hive
import
import
import
export
export
Mysql HDFS Hive HBase HBase #查看sqoop的版本sqoop version
#常见sqoop参数sqoop help
codegen Generate code to interact with database records
create-hive-table Import a table definition into Hive
eval Evaluate a SQL statement and display the results
export Export an HDFS directory to a database table #导出help List available commands
import Import a table from a database to HDFS #导入import-all-tables Import tables from a database to HDFS
import-mainframe Import mainframe datasets to HDFS
list-databases List available databases on a server
list-tables List available tables in a database
version Display version information
# #通过参数用下面查看数据库
sqoop list-databases --connect jdbc:mysql://localhost:3306 --username root --
password 123123;
list-databases
--connect
jdbc:mysql://localhost:3306
--username
root
--password
123123
bin/sqoop --options-file config.conf 2.5 、验证安装:
3. Sqoop命令执行
3.1 常见命令执行参数
通过sqoop加不同参数可以执行导入导出,通过 sqoop help 可以查看常见的命令行
3.2 通过文件传递参数(脚本)
在执行sqoop命令时,如果每次执行的命令都相似,那么把相同的参数可以抽取出来,放在一个文本文件
中,把执行时的参数加入到这个文本文件为参数即可. 这个文本文件可以用--options-file 来指定,平时可以用定时任务来执行这个脚本,避免每次手工操作.
上面命令中的jdbc连接的参数一般是不变的,可以把它抽取出来放在一个文件中/.../sqoop/config.conf ,如下:
那么上面的执行的命令就可以变为:
为了让配置文件config.txt的可读性更强,可以加入空行和注释,不会影响文件内容的读取,如下: sqoop import --connect jdbc:mysql:///employees
#指定连接的服务器地址是 ,要连接的数据库是employees
#指定用户名和密码来连接数据库
sqoop import --connect jdbc:mysql://localhost:3306/mysql --username root --
password 123123;
3.3 Import 详解
import是从关系数据库导入到Hadoop,下面是一些通用参数介绍:
3.3.1 通用参数
如下:
Argument Description
==--connect== 指定JDBC连接字符串
--connection-manager 指定连接管理类
--driver 指定连接的驱动程序
-P 从控制台读入密码(可以防止密码显示中控制台)
==--password== 指定访问数据库的密码
==--username== 指定访问数据库的用户名
3.3.1.1 连接数据库
sqoop的设计就是把数据库数据导入HDFS,所以必须指定连接字符串才能访问数据库,这个连接字符串
类似于URL,这个连接字符串通过 --connect 参数指定,它描述了连接的数据库地址和具体的连接数据库,
譬如:
上面连接命令只是指定数据库,默认情况下数据库都是需要用户名和参数的,在这里可以用--username
和--password 来指定,譬如:
3.3.1.2 查看数据库 # 指令: 列出mysql中的所有数据库
list-databases
# 指定连接字符串
--connect
jdbc:mysql://localhost:3306
--username
root
--password
123123 # 列出所有数据库
bin/sqoop list-databases --connect jdbc:mysql://localhost:3306 --username root -
-password 123123;
# 列出数据库中所有表
bin/sqoop list-tables --connect jdbc:mysql://localhost:3306/mysql --username
root --password 123123; 在Sqoop中,可以通过list-databases 参数来查看mysql的数据库,这样在导入之前可以得到所有的数据库的名字,具体案例如下:
3.3.1.3 查看所有表
在得到所有数据库的名字后,也可以查看当前数据库中的所有表,可以使用 list-tables 参数来进行查看,
查看的时候在url连接中一定要指定数据库的名字.
3.3.2 Import的控制参数
常见Import的控制参数有如下几个:
Argument Description
--append 通过追加的方式导入到HDFS
--as-avrodatafile 导入为 Avro Data 文件格式
--as-sequencefile 导入为 SequenceFiles文件格式
--as-textfile 导入为文本格式 (默认值)
--as-parquetfile 导入为 Parquet 文件格式
--columns 指定要导入的列
--delete-target-dir 如果目标文件夹存在,则删除
--fetch-size 一次从数据库读取的数量大小
-m,--num-mappers n 用来指定map tasks的数量,用来做并行导入
-e,--query 指定要查询的SQL语句
--split-by 用来指定分片的列
--table 需要导入的表名
--target-dir HDFS 的目标文件夹
--where 用来指定导入数据的where条件
-z,--compress 是否要压缩
--compression-codec 使用Hadoop压缩 (默认是 gzip)
3.3.2.1 指定表导入
大数据处理常用技术有哪些
大数据处理常用技术有哪些 ?
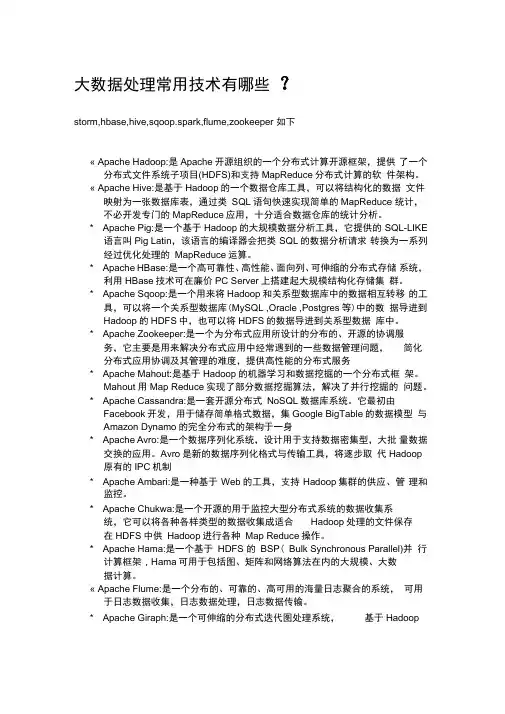
storm,hbase,hive,sqoop.spark,flume,zookeeper 如下
« Apache Hadoop:是Apache开源组织的一个分布式计算开源框架,提供 了一个分布式文件系统子项目(HDFS)和支持MapReduce分布式计算的软 件架构。
« Apache Hive:是基于Hadoop的一个数据仓库工具,可以将结构化的数据 文件映射为一张数据库表,通过类 SQL语句快速实现简单的MapReduce 统计,不必开发专门的MapReduce应用,十分适合数据仓库的统计分析。
* Apache Pig:是一个基于Hadoop的大规模数据分析工具,它提供的 SQL-LIKE语言叫Pig Latin,该语言的编译器会把类 SQL的数据分析请求 转换为一系列经过优化处理的 MapReduce运算。
* Apache HBase:是一个高可靠性、高性能、面向列、可伸缩的分布式存储 系统,利用HBase技术可在廉价PC Server上搭建起大规模结构化存储集 群。
* Apache Sqoop:是一个用来将Hadoop和关系型数据库中的数据相互转移 的工具,可以将一个关系型数据库(MySQL ,Oracle ,Postgres等)中的数 据导进到Hadoop的HDFS中,也可以将HDFS的数据导进到关系型数据 库中。
* Apache Zookeeper:是一个为分布式应用所设计的分布的、开源的协调服
务,它主要是用来解决分布式应用中经常遇到的一些数据管理问题, 简化
分布式应用协调及其管理的难度,提供高性能的分布式服务
* Apache Mahout:是基于Hadoop的机器学习和数据挖掘的一个分布式框 架。Mahout用Map Reduce实现了部分数据挖掘算法,解决了并行挖掘的 问题。
* Apache Cassandra:是一套开源分布式 NoSQL数据库系统。它最初由
数据仓库分层中的ODS、DWD、DWS
数据仓库分层中的ODS、DWD、DWS
1.数据仓库DW
1.1简介
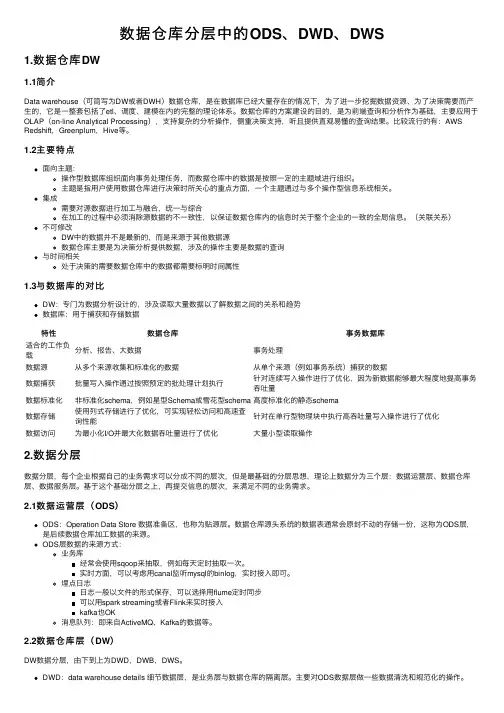
Data warehouse(可简写为DW或者DWH)数据仓库,是在数据库已经⼤量存在的情况下,为了进⼀步挖掘数据资源、为了决策需要⽽产
⽣的,它是⼀整套包括了etl、调度、建模在内的完整的理论体系。数据仓库的⽅案建设的⽬的,是为前端查询和分析作为基础,主要应⽤于OLAP(on-line Analytical Processing),⽀持复杂的分析操作,侧重决策⽀持,听且提供直观易懂的查询结果。⽐较流⾏的有:AWS
Redshift,Greenplum,Hive等。
1.2主要特点⾯向主题:操作型数据库组织⾯向事务处理任务,⽽数据仓库中的数据是按照⼀定的主题域进⾏组织。主题是指⽤户使⽤数据仓库进⾏决策时所关⼼的重点⽅⾯,⼀个主题通过与多个操作型信息系统相关。集成需要对源数据进⾏加⼯与融合,统⼀与综合在加⼯的过程中必须消除源数据的不⼀致性,以保证数据仓库内的信息时关于整个企业的⼀致的全局信息。(关联关系)不可修改DW中的数据并不是最新的,⽽是来源于其他数据源数据仓库主要是为决策分析提供数据,涉及的操作主要是数据的查询与时间相关
处于决策的需要数据仓库中的数据都需要标明时间属性
1.3与数据库的对⽐
DW:专门为数据分析设计的,涉及读取⼤量数据以了解数据之间的关系和趋势
数据库:⽤于捕获和存储数据
特性数据仓库事务数据库
适合的⼯作负
载分析、报告、⼤数据事务处理
数据源从多个来源收集和标准化的数据从单个来源(例如事务系统)捕获的数据
数据捕获批量写⼊操作通过按照预定的批处理计划执⾏针对连续写⼊操作进⾏了优化,因为新数据能够最⼤程度地提⾼事务
吞吐量
数据标准化⾮标准化schema,例如星型Schema或雪花型schema⾼度标准化的静态schema
数据存储使⽤列式存储进⾏了优化,可实现轻松访问和⾼速查
询性能针对在单⾏型物理块中执⾏⾼吞吐量写⼊操作进⾏了优化
数据访问为最⼩化I/O并最⼤化数据吞吐量进⾏了优化⼤量⼩型读取操作
大数据处理技术的学习路径与进阶指南
大数据处理技术的学习路径与进阶指南
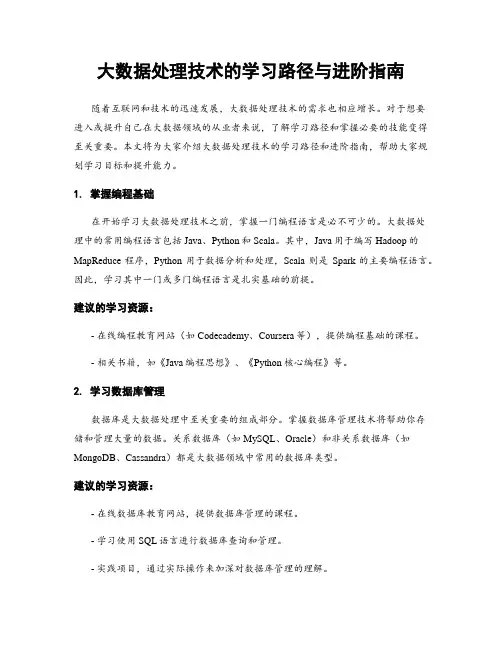
随着互联网和技术的迅速发展,大数据处理技术的需求也相应增长。对于想要进入或提升自己在大数据领域的从业者来说,了解学习路径和掌握必要的技能变得至关重要。本文将为大家介绍大数据处理技术的学习路径和进阶指南,帮助大家规划学习目标和提升能力。
1. 掌握编程基础
在开始学习大数据处理技术之前,掌握一门编程语言是必不可少的。大数据处理中的常用编程语言包括Java、Python和Scala。其中,Java用于编写Hadoop的MapReduce程序,Python用于数据分析和处理,Scala则是Spark的主要编程语言。因此,学习其中一门或多门编程语言是扎实基础的前提。
建议的学习资源:
- 在线编程教育网站(如Codecademy、Coursera等),提供编程基础的课程。
- 相关书籍,如《Java编程思想》、《Python核心编程》等。
2. 学习数据库管理
数据库是大数据处理中至关重要的组成部分。掌握数据库管理技术将帮助你存储和管理大量的数据。关系数据库(如MySQL、Oracle)和非关系数据库(如MongoDB、Cassandra)都是大数据领域中常用的数据库类型。
建议的学习资源:
- 在线数据库教育网站,提供数据库管理的课程。
- 学习使用SQL语言进行数据库查询和管理。
- 实践项目,通过实际操作来加深对数据库管理的理解。 3. 熟悉大数据处理框架
大数据处理中广泛使用的框架有Hadoop和Spark。Hadoop是一个用于分布式存储和处理大规模数据的框架,而Spark是一个快速的通用型大数据处理引擎。掌握这些框架的使用方法和原理是非常重要的。
建议的学习资源:
- 学习Hadoop和Spark的基本概念和原理。
- 编写Hadoop的MapReduce程序,处理和分析数据。
- 学习使用Spark进行数据处理和分析。
4. 掌握数据处理和分析工具
在大数据处理中,有一些常用的工具可以帮助你更有效地处理和分析数据,如Pig、Hive和Sqoop。这些工具提供了高级的查询和分析功能。
Sqoop1工具import和export使用详解
Sqoop工具import和export使用详解
问题导读:
1、Sqoop如何在异构平台之间进行数据迁移 ?
2、Sqoop是怎样保证高可靠性的 ?
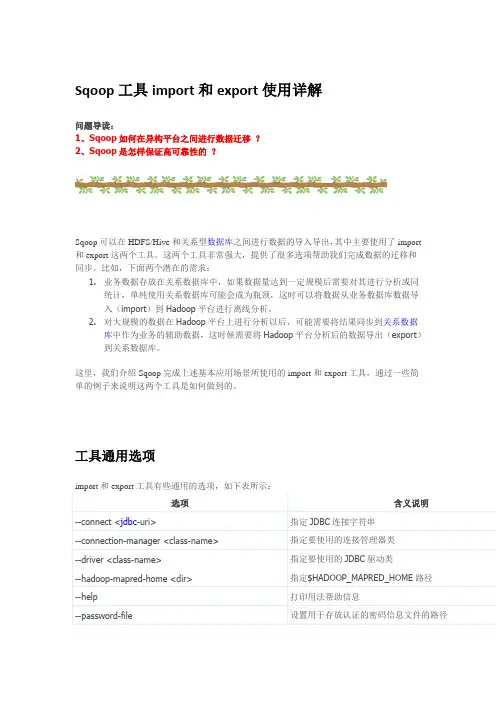
Sqoop可以在HDFS/Hive和关系型数据库之间进行数据的导入导出,其中主要使用了import和export这两个工具。这两个工具非常强大,提供了很多选项帮助我们完成数据的迁移和同步。比如,下面两个潜在的需求:
1. 业务数据存放在关系数据库中,如果数据量达到一定规模后需要对其进行分析或同统计,单纯使用关系数据库可能会成为瓶颈,这时可以将数据从业务数据库数据导入(import)到Hadoop平台进行离线分析。
2. 对大规模的数据在Hadoop平台上进行分析以后,可能需要将结果同步到关系数据库中作为业务的辅助数据,这时候需要将Hadoop平台分析后的数据导出(export)到关系数据库。
这里,我们介绍Sqoop完成上述基本应用场景所使用的import和export工具,通过一些简单的例子来说明这两个工具是如何做到的。
工具通用选项
import和export工具有些通用的选项,如下表所示:
选项 含义说明
--connect 指定JDBC连接字符串
--connection-manager 指定要使用的连接管理器类
--driver 指定要使用的JDBC驱动类
--hadoop-mapred-home
--help 打印用法帮助信息
--password-file 设置用于存放认证的密码信息文件的路径 -P 从控制台读取输入的密码
--password 设置认证密码
--username 设置认证用户名
--verbose 打印详细的运行信息
--connection-param-file 可选,指定存储数据库连接参数的属性文件
数据导入工具import
import工具,是将HDFS平台外部的结构化存储系统中的数据导入到Hadoop平台,便于后续分析。我们先看一下import工具的基本选项及其含义,如下表所示:
sqoop知识点

第 1 页 共 3 页 sqoop知识点
(实用版)
目录
1.Sqoop 简介
2.Sqoop 的核心概念
3.Sqoop 的安装与配置
4.Sqoop 的基本操作
5.Sqoop 的高级特性
6.Sqoop 的优缺点
7.Sqoop 的应用场景
正文
1.Sqoop 简介
Sqoop 是一个用于在 Hadoop(Hive)与关系型数据库之间传输数据的工具。它可以将一个关系型数据库中的数据导出到 Hadoop 分布式文件系统(HDFS)上,也可以将 HDFS 上的数据导入到关系型数据库中。Sqoop
旨在实现大数据处理与传统数据库之间的数据交互,降低了数据迁移的难度。
2.Sqoop 的核心概念
Sqoop 主要包括以下几个核心概念:
- 数据源(Data Source):数据源定义了要从中导入或导出数据的数据库。
- 目标(Target):目标定义了要将数据导入到哪个 Hadoop 数据存储系统(如 HDFS、Hive 等)。
- 映射(Mapping):映射定义了如何将数据源中的记录映射到目标中 第 2 页 共 3 页 的记录。
3.Sqoop 的安装与配置
Sqoop 是 Apache Hadoop 的一个子项目,可以通过 Maven 或直接下载源代码进行安装。配置方面,主要需要配置数据源、目标以及映射等相关参数。
4.Sqoop 的基本操作
Sqoop 的基本操作包括导入和导出数据。其中,导入数据可以使用`sqoop import`命令,导出数据可以使用`sqoop export`命令。通过命令行参数可以指定数据源、目标、映射等具体参数。
5.Sqoop 的高级特性
Sqoop 还支持许多高级特性,如:
- 数据分片:可以将大量数据分成多个小块并行导入或导出,提高数据处理效率。
- 增量导入:可以只导入源数据库中自上次导入以来发生变化的数据,避免重复导入。
sqoop原理

- 1 - sqoop原理
随着大数据时代的到来,数据的处理和分析变得越来越重要。在数据分析过程中,数据的获取是关键的一步。Sqoop是一款用于在Hadoop和关系型数据库之间传输数据的工具,它可以帮助用户快速、方便地将数据从关系型数据库中导入到Hadoop中,或者将Hadoop中的数据导出到关系型数据库中进行分析和处理。本文将介绍Sqoop的基本原理和使用方法。
一、Sqoop的基本原理
Sqoop是一个基于Java的工具,它通过JDBC连接到关系型数据库,然后将数据导入到Hadoop中。Sqoop的工作原理可以分为以下几个步骤:
1. 连接数据库
Sqoop通过JDBC连接到关系型数据库,获取数据库的元数据信息,包括表结构、数据类型等。
2. 生成MapReduce作业
Sqoop根据用户的配置信息生成MapReduce作业,用于将数据从关系型数据库导入到Hadoop中。根据数据量的大小和复杂度,Sqoop会生成不同的MapReduce作业,以保证数据的高效导入。
3. 分配任务
Sqoop将生成的MapReduce作业提交给Hadoop集群,由YARN进行任务的分配和调度。
4. 数据导入 - 2 - MapReduce作业从关系型数据库中读取数据,将数据切分为若干个片段,然后将数据导入到Hadoop中。在导入数据的过程中,Sqoop会根据用户的配置信息进行数据类型的转换和格式化,以保证数据的正确性和一致性。
5. 数据清洗和处理
在数据导入到Hadoop中之后,用户可以使用Hadoop生态系统中的其他工具对数据进行清洗和处理,例如使用Hive进行数据分析和查询,使用Pig进行数据转换和处理,使用Spark进行数据挖掘和机器学习等。
6. 数据导出
当数据处理完成之后,用户可以使用Sqoop将数据导出到关系型数据库中进行分析和处理。Sqoop会根据用户的配置信息生成MapReduce作业,用于将数据从Hadoop中导出到关系型数据库中。
Python的数据仓库和数据挖掘
Python的数据仓库和数据挖掘
数据仓库(Data Warehouse)和数据挖掘(Data Mining)是Python中重要的数据分析工具和技术。本文将介绍Python的数据仓库和数据挖掘的概念、应用以及相关的工具和库。
一、数据仓库
数据仓库是指用于长期存储、管理和分析企业或组织大规模数据的系统。它用于帮助企业做出更明智的决策,识别市场趋势、客户行为和业务机会等。Python提供了多种数据仓库相关的工具和库,例如:
1. Apache Hadoop: Hadoop是一个开源的分布式存储和计算框架,可以处理大规模数据集。Python通过Hadoop Streaming提供了与Hadoop的集成。
2. Apache Hive: Hive是建立在Hadoop之上的数据仓库基础设施,通过类SQL语言HiveQL查询数据。Python提供了PyHive库,可以方便地使用Hive。
3. Apache Spark: Spark是一个快速而通用的大数据处理引擎,也可以作为数据仓库使用。Python提供了PySpark库,可以使用Spark的机器学习和数据处理功能。
4. Pandas: Pandas是一个强大的数据分析工具,可以用于数据清洗、转换、合并和分析。它提供了灵活的数据结构和高效的数据处理功能,是Python数据仓库和数据挖掘中的重要组件。 二、数据挖掘
数据挖掘是从大量数据中发现有用信息和模式的过程。它可以应用于市场营销、金融风险评估、客户关系管理等多个领域。Python提供了多种数据挖掘相关的工具和库,例如:
1. Scikit-learn: Scikit-learn是一个简单而有效的机器学习库,包含了各种分类、回归、聚类和降维算法。它提供了丰富的功能和易于使用的API,适合初学者和专业人士使用。
2. TensorFlow: TensorFlow是一个开源的机器学习框架,广泛应用于深度学习领域。Python提供了TensorFlow库,可以进行神经网络和深度学习模型的训练和推理。
sqoop与hive的使用
sqoop与hive的使用
Sqoop和Hive是大数据领域中常用的工具,用于数据的导入和查询。Sqoop用于将关系型数据库中的数据导入到Hadoop集群中的HDFS或Hive中,而Hive则是一个数据仓库基础设施工具,可以使用类SQL的语法对大数据进行查询和分析。
首先,我们来了解一下Sqoop的使用。
Sqoop的概述和使用
Sqoop是Apache软件基金会下的一个开源项目,它提供了在Hadoop集群和关系型数据库之间高效传输数据的功能。Sqoop支持各种关系型数据库,如MySQL、Oracle、SQL Server等。
Sqoop的一般工作流程如下:
1. 连接到关系型数据库:首先,需要使用Sqoop连接到关系型数据库,并指定要导入的数据表的名称。
2. 选择导入方式:Sqoop支持两种导入方式,一种是将数据直接导入到HDFS中,另一种是将数据导入到Hive表中。
3. 指定导入规则:根据需要,可以使用Sqoop提供的参数来指定导入的规则,例如要导入的数据的条件、分割键等。
4. 执行导入命令:执行Sqoop的导入命令,Sqoop会自动将数据从关系型数据库导入到指定的目标位置。
下面是一个使用Sqoop导入MySQL数据库中的数据到Hive表的例子:
``` --connect jdbc:mysql://localhost/mydb \
--username root \
--password password \
--table mytable \
--hive-import \
--hive-table myhive
```
在这个例子中,我们使用Sqoop连接到名为mydb的MySQL数据库,在执行导入操作时,将数据导入到Hive中的名为myhive的表中。
接下来,我们将详细介绍Hive的使用。
Hive的概述和使用
Hive是一个基于Hadoop的数据仓库基础设施工具,它提供了类SQL的查询语言HQL(Hive Query Language)来对大数据进行查询和分析。Hive将查询语句转化为MapReduce作业,然后在Hadoop集群上进行运行,从而实现了高效的分布式查询。
sqoop的使用场景
Apache Sqoop是一个用于在Apache Hadoop和结构化数据存储(如关系型数据库)之间传输大规模数据的工具。以下是Sqoop的一些典型使用场景:
数据迁移:Sqoop常常被用于迁移大规模数据,尤其是在从关系型数据库到Hadoop(如HDFS、Hive、HBase)之间。例如,你可能需要将一个大型企业的数据从传统的关系型数据库迁移到Hadoop,以进行数据分析和机器学习。
数据集成:对于那些需要同时访问关系型数据库和Hadoop数据的企业,Sqoop提供了一个高效的方式来集成这两种数据源。
ETL(提取、转换、加载)任务:Sqoop可以用于ETL流程,特别是那些涉及从关系型数据库提取数据,在Hadoop中处理,然后加载到Hive、HBase或其他Hadoop存储中的任务。
数据备份和恢复:Sqoop可以用来备份关系型数据库中的数据,并将这些数据存储在Hadoop中。同样,它也可以用于从Hadoop中恢复数据到关系型数据库。
报表生成:对于那些需要从关系型数据库获取数据,然后在Hadoop中进行报表生成的任务,Sqoop提供了一种高效的方法。
大数据应用开发与测试:在开发或测试新的大数据应用时,Sqoop可以帮助开发者快速地加载数据到Hadoop环境中。
数据仓库扩展:对于那些需要将大量数据从关系型数据库导入到数据仓库的情况,Sqoop提供了一种扩展现有数据仓库能力的解决方案。
然而,Sqoop并不适合所有情况。例如,它不适合处理事件驱动型数据或流式数据。对于这些情况,更适合使用如Apache Flume等工具。同时,如果源系统不能承受Sqoop job执行时的较大压力,或者批处理任务中的数据量特别大,可能会给源系统带来更大的压力,这种情况下也不适合使用Sqoop。
总的来说,Sqoop是一个强大的工具,适用于在关系型数据库和Hadoop之间迁移大规模的结构化数据。但是,在使用它时,需要考虑到其限制和最佳使用场景。
数据》sqoop--数据仓库工具箱 数据挖掘
1. 了解Sqoop的来历
2. Sqoop的原理和底层实现
3. Sqoop的配置安装
4. Sqoop导入
- Sqoop的简介
- Sqoop的底层原理
- Sqoop的环境配置
- Sqoop和HDFS导入导出
- Sqoop和Hive的导入导出
- Sqoop和Hbase的导出
基于传统关系型数据库的稳定性,还是有很多企业将数据存储在关系型数据库中;早期由于工具的缺乏,
Hadoop与传统数据库之间的数据传输非常困难。基于前两个方面的考虑,需要一个在传统关系型数据库和Hadoop之间进行数据传输的项目,Sqoop应运而生。 一. 课前提示
1. 今日任务
2. 今日目标
2.1 了解和熟悉部分
2.2 掌握部分
二. 正课内容
1. Sqoop简介以及使用
1.1 产生背景
1.2 Sqoop是什么
Sqoop是一个用于Hadoop和结构化数据存储(如关系型数据库)之间进行高效传输大批量数据的
工具。它包括以下两个方面:
可以使用Sqoop将数据从关系型数据库管理系统(如MySQL)导入到Hadoop系统(如HDFS、Hive、
HBase)中
将数据从Hadoop系统中抽取并导出到关系型数据库(如MySQL)
常见数据库开源工具:
1. sqoop
2. datax
3. kettle
4. cannal 1.3 底层实现原理
Sqoop的核心设计思想是利用MapReduce加快数据传输速度。也就是说Sqoop的导入和导出功能是通过基于Map Task(只有map)的MapReduce作业实现的。所以它是一种批处理方式进行数据传输,难以实现实时的数据进行导入和导出。
官网介绍:
Apache Sqoop(TM) is a tool designed for efficiently transferring bulk
data between Apache Hadoop and structured datastores such as relational databases.