
网页文字提取方法
八爪鱼·云采集网络爬虫软件
网页文字提取方法
互联网上有很多有价值的信息,我们需要将他们提取出来,为我们所用。是否有好用的软件推荐呢?今天就给大家介绍一款免费网页文字抓取器抓取本文介绍使用八爪鱼采集新浪博客文章的方法。
采集网站:
/s/articlelist_1406314195_0_1.html
采集的内容包括:博客文章正文,标题,标签,分类,日期。
步骤1:创建新浪博客文章采集任务
1)进入主界面,选择“自定义采集”
八爪鱼·云采集网络爬虫软件
2)将要采集的网址URL复制粘贴到网站输入框中,点击“保存网址”
八爪鱼·云采集网络爬虫软件
步骤2:创建翻页循环
1)打开网页之后,打开右上角的流程按钮,使制作的流程可见状态。点击页面下方的“下一页”,如图,选择“循环点击单个链接”,翻页循环创建完成。(可在左上角流程中手动点击“循环翻页”和“点击翻页”几次,测试是否正常翻页。)
八爪鱼·云采集网络爬虫软件
2)由于进入详情页时网页加载很慢,网址一直在转圈状态,无法立即执行下一个步骤,因此在“循环翻页”的高级选项里设置“ajax加载数据”,超时时间设置为5秒,点击“确定”。
八爪鱼·云采集网络爬虫软件
步骤3:创建列表循环
1)鼠标点击列表目录中第一个博文,选择操作提示框中的“选中全部”。
八爪鱼·云采集网络爬虫软件
2)鼠标点击“循环点击每个链接”,列表循环就创建完成,并进入到第一个循环项的详情页面。
八爪鱼·云采集网络爬虫软件
由于进入详情页时网页加载很慢,网址一直在转圈状态,无法立即执行下一个步骤,因此在“点击元素”的高级选项里设置“ajax加载数据”,AJAX超时设置为3秒,点击“确定”。
八爪鱼·云采集网络爬虫软件
3)数据提取,接下来采集具体字段,分别选中页面标题、标签、分类、时间,点击“采集该元素的文本”,并在上方流程中修改字段名称。
八爪鱼·云采集网络爬虫软件
鼠标点击正文所在的地方,点击提示框中的右下角图标,扩大选项范围,直至包括全部正文内容。(笔者测试点击2下就全部包括在内了)
八爪鱼·云采集网络爬虫软件
同样选择“采集该元素的文本”,修改字段名称,数据提取完毕。
八爪鱼·云采集网络爬虫软件
4)由于该网站网页加载速度非常慢,所以可在流程各个步骤的高级选项里设置“执行前等待”几秒时间,也可避免访问页面较快出现防采集问题。设置后点击“确定”。
八爪鱼·云采集网络爬虫软件
步骤4:新浪博客数据采集及导出
1)点击左上角的“保存”,然后点击“开始采集”。
八爪鱼·云采集网络爬虫软件
选择“启动本地采集
八爪鱼·云采集网络爬虫软件
2)采集完成后,会跳出提示,选择“导出数据”,选择“合适的导出方式”,将采集好的数据导出, 这里我们选择excel作为导出为格式,这个时候新浪博客数据就导出来了,数据导出后如下图
八爪鱼·云采集网络爬虫软件
相关采集教程:
xpath抓取网页文字
/tutorial/gnd/xpath
提取网页文字数据
/tutorial/gnd/tiqushuju
网页数据爬取教程
/tutorial/hottutorial
网页邮箱采集
/tutorial/hottutorial/qita/youxiang
网页抓取工具新手入门
/tutorial/xsksrm
循环翻页爬取网页数据
/tutorial/gnd/xunhuan
ajax网页数据抓取 /tutorial/gnd/ajaxlabel
八爪鱼——90万用户选择的网页数据采集器。
八爪鱼·云采集网络爬虫软件
1、操作简单,任何人都可以用:无需技术背景,会上网就能采集。完全可视化流程,点击鼠标完成操作,2分钟即可快速入门。
2、功能强大,任何网站都可以采:对于点击、登陆、翻页、识别验证码、瀑布流、Ajax脚本异步加载数据的网页,均可经过简单设置进行采集。
3、云采集,关机也可以。配置好采集任务后可关机,任务可在云端执行。庞大云采集集群24*7不间断运行,不用担心IP被封,网络中断。
4、功能免费+增值服务,可按需选择。免费版具备所有功能,能够满足用户的基本采集需求。同时设置了一些增值服务(如私有云),满足高端付费企业用户的需要。
网站抓字软件如何使用

八爪鱼·云采集服务平台
网站抓字软件如何使用
网站上有海量的文字信息,有时我们想提取采集下来。有没有可以让工作简单的网站抓字软件供大家使用呢? 下面给大家教一款软件是如何实现这个功能的。
八爪鱼是一款通用的网页数据采集器,可采集互联网上的公开数据。用户可以设置从哪个网站爬取数据,爬取那些数据,爬取什么范围的数据,什么时候去爬取数据,爬取的数据如何保存等等。
言归正传,本文将以搜狗微信的文章正文采集为例,讲解使用八爪鱼采集网页文章正文的方法。文章正文采集,主要有两大类情况:一、采集文章正文中的文本,不含图片;二、采集文章正文中的文本和图片URL。
示例网站:/
使用功能点:
Xpath /search?query=XPath
判断条件 /tutorialdetail-1/judge.html
分页列表信息采集 /tutorial/fylb-70.aspx?t=1
AJAX滚动教程 /tutorialdetail-1/ajgd_7.html
AJAX点击和翻页/tutorialdetail-1/ajaxdjfy_7.html
八爪鱼·云采集服务平台
一、采集文章正文中的文本,不含图片
具体步骤:
步骤1:创建采集任务
1)进入主界面,选择“自定义模式”
网站抓字软件使用步骤1
2)将要采集的网址URL复制粘贴到网站输入框中,点击“保存网址”
八爪鱼·云采集服务平台
网站抓字软件使用步骤2
步骤2:创建翻页循环
1)在页面右上角,打开“流程”,以展现出“流程设计器”和“定制当前操作”两个板块。网页打开后,默认显示“热门”文章。下拉页面,找到并点击“加载更多内容”按钮,在操作提示框中,选择“更多操作”
八爪鱼·云采集服务平台
利用电脑提取资源的方法
如何利用电脑提取资源
作者:侯金平 厚朴教育来源:《软件报》 点击数:860 更新时间:2008-6-7
做电脑课件时,有很多我们需要的资源,比如文本、比如图片、声音、视频,这些东西如何才能据为己有呢并运用到课件当中呢?本文将分门别类地介绍。
一、提取文本
1.从文本中提取
对于那些在文本中文件,通常只要选中后复制、粘贴即可,这里不再饶舌。
2.从不可复制的网页或图片等中复制文字
常见exe、chm、pdf等格式的电子书,通常只可以看,但是其中的内容却不能进行复制。因为它就像一幅图片一样。如果我们需要使用这些资料中的文本内容的话,是不是就一定要重新输入一遍呢?当然不用这么麻烦。下面就为大家介绍将这些内容从资料中提取出来的方法。
第一种方法:用SnagIt工具进行文字提取。
首先使用SnagIt的文字捕捉功能将文字提取出来。启动SnagIt,选择菜单“输入/区域”,选择菜单“工具/文字捕获”,然后我们打开要捕捉的文件窗口,按下捕捉快捷键,选定捕捉区域即可捕捉到文字。
接着用相应工具重排文字。此时我们发现提取的文字可能会有很多空格或段落错乱等现象,而且字号、字体等不合自己的心意。这时我们可以用熟悉的WPS或Word软件进行重新编排。我们以WPSOffice2003为例看看如何对付提取后文章的编排。
用WPSOffice2003打开提取文章;然后选择“工具”菜单下的“文字”/“段落重排”,这时你会看到提取文章重新进行排版;接下来选择“工具”菜单下的“文字”/“删除段首空格”命令,使得文章的每段参差不齐的行首空格被删除;再选择“工具”菜单下的“文字”/“增加段首空格”,文章变为正常的书写格式;提取文章一般都留有空段,为删除这些空段,继续选择“工具”菜单下的“文字”/“删除空段”命令,这时文章完全变为我们所要的形式;用你熟悉的界面任意编辑文章吧。
方法二:利用ORC汉字识别功能抓取图片上的文字
如何利用电脑提取资源

如何利用电脑提取资源
做电脑课件时,有很多我们需要的资源,比如文本、比如图片、声音、视频,这些东西如何才能据为己有呢并运用到课件当中呢?本文将分门别类地介绍。
一、提取文本
1.从文本中提取
对于那些在文本中文件,通常只要选中后复制、粘贴即可,这里不再饶舌。
2.从不可复制的网页或图片等中复制文字
常见exe、chm、pdf等格式的电子书,通常只可以看,但是其中的内容却不能进行复制。因为它就像一幅图片一样。如果我们需要使用这些资料中的文本内容的话,是不是就一定要重新输入一遍呢?当然不用这么麻烦。下面就为大家介绍将这些内容从资料中提取出来的方法。
方法一:用SnagIt工具进行文字提取。
首先使用SnagIt的文字捕捉功能将文字提取出来。启动SnagIt,选择菜单“输入/区域”,选择菜单“工具/文字捕获”,然后我们打开要捕捉的文件窗口,按下捕捉快捷键,选定捕捉区域即可捕捉到文字。
接着用相应工具重排文字。此时我们发现提取的文字可能会有很多空格或段落错乱等现象,而且字号、字体等不合自己的心意。这时我们可以用熟悉的WPS或Word软件进行重新编排。我们以WPSOffice2003为例看看如何对付提取后文章的编排。
用WPSOffice2003打开提取文章;然后选择“工具”菜单下的“文字”/“段落重排”,这时你会看到提取文章重新进行排版;接下来选择“工具”菜单下的“文字”/“删除段首空格”命令,使得文章的每段参差不齐的行首空格被删除;再选择“工具”菜单下的“文字”/“增加段首空格”,文章变为正常的书写格式;提取文章一般都留有空段,为删除这些空段,继续选择“工具”菜单下的“文字”/“删除空段”命令,这时文章完全变为我们所要的形式;用你熟悉的界面任意编辑文章吧。
方法二:利用ORC汉字识别功能抓取图片上的文字
首先用SnagIt抓取一张图片,保存为.bmp格式,然后再打开OCR程序,尚书6号或汉王OCR系统都可以,通过OCR识别后可以获得图片上的文字。
网页内容不能复制怎么办

网页内容不能复制怎么办
巧妙解除限制!让网页文字轻松复制
现在越来越多的网站都对鼠标右键进行了限制,目的就是保护自己网站的创作内容,但这也一定程度上违背了创作共享的原则,因此笔者在此就让大家避过这道坎,轻松复制网页文字。
上网时看到一段精彩的文字,总会想把它保存下来,通常用户会将要保存的文字用鼠标拖拽选中,点击右键选择“复制”,再打开任一文本编辑器(如Word),右键选择“粘贴”,这样大家就可以把这段文字保存到本机了。
但对于有些网页,大家根本无法选中网页上的文字,甚至鼠标右键也失去了作用,这是因为某些网站对复制文字作了限制,使浏览者无法复制网页上的文字。怎么办?
如果用户安装了Word,这个问题就不难解决:进入控制面板,双击打开“Internet 选项”(如图1)。
图1 打开控制面板中Internet 选项
然后切换到“程序”选项卡,在“HTML编辑器”下拉列表框里选中“Microsoft Office Word” (如图2)。
图2 选择Microsoft Office Word为HTML编辑器
点击确定。用IE打开受限制的网页,在菜单上依次点击“文件——使用Microsoft Office Word 编辑”(如图3)。
图3 使用Microsoft Office Word 编辑
或者点击IE工具栏上的“使用Microsoft Office Word 编辑”(如图4)。
图4 使用IE工具栏上的快捷按钮
这样,受限制的网页就以Word文档的形式显示在Word中了,而且可以进行选中、复制操作了!
相关教程集锦
教程一:
很多网友在浏览技术资料性的网页时,碰到自己喜欢的、或者有研究价值的文章内容,都想保存下来,以便以后浏览使用,但是很多资料性的网络文章,往往在网页禁止使用“复制”、“粘贴”命令。以下是本人总结的一些网页内容复制技巧,希望对大家有所帮助!
免软件 提取在线图片中的文字
龙源期刊网
免软件 提取在线图片中的文字
作者:老万
来源:《电脑爱好者》2017年第18期
现在很多单位都开始推行无纸化办公,这样很多时候就需要将文字信息转换为数字信息,而在转换的过程中必须要使用到OCR这类的软件,可是通常情况下这类软件不但需要收费,而且有的时候操作起来也比较麻烦。如果临时急用,在不用安装软件的情况下,我们也能进行图片文字的提取。
在线分析快捷简单
通过浏览器打开“ Free Online OCR ”这个云服务网站(https://www. /),这项云服务的操作非常的简单,用户只需要根据页面中的向导一步步进行操作就可以了。首先点击网页中的“Select File”按钮,在弹出的对话框里面选择需要扫描的文件。这款云服务支持的文件类型非常丰富,不但可以对图片信息进行扫描,而且也可以对PDF文件进行扫描。
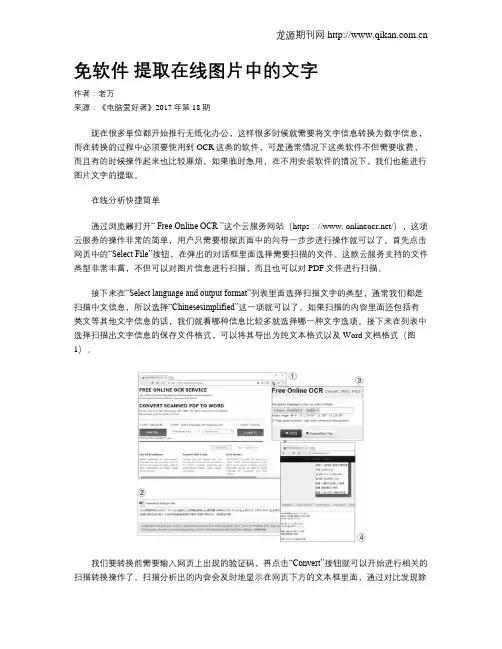
接下来在“Select language and output format”列表里面选择扫描文字的类型,通常我们都是扫描中文信息,所以选择“Chinesesimplified”这一项就可以了。如果扫描的内容里面还包括有英文等其他文字信息的话,我们就看哪种信息比较多就选择哪一种文字选项。接下来在列表中选择扫描出文字信息的保存文件格式,可以将其导出为纯文本格式以及Word文档格式(图1)。
我们要转换前需要输入网页上出现的验证码,再点击“Convert”按钮就可以开始进行相关的扫描转换操作了。扫描分析出的内容会及时地显示在网页下方的文本框里面,通过对比发现除龙源期刊网
了少数英文字母的内容出现错误以外,中文信息都完整地被识别出来了。最后点击“Download
Output File”按钮就可以将其保存,再对这些内容重新进行编辑排版即可(图2)。
多语言支持更准确
虽然云服务的操作非常方便,但是由于可能会遇到服务器宕机或升级等问题,所以我们还是最好选择一个其他的在线云服务进行备份。而另外一款同样名为“Free Online OCR”的云服务也非常的不错。现在访问它的网站链接http:///,点击网页中的“选择文件”按钮后,选择需要分析扫描的文件。接下来在“Recognition language(s)”列表中,点击选择要扫描文字的类型。这个云服务和前一个最大的不同之处在于,它可以同时选择多种文字类型,比如同时选择中文和英文等等(图3)。
网页数据如何简单导出excel

八爪鱼·云采集服务平台
网页数据如何简单导出excel
在浏览网页时,遇到我们需要的网页数据时,如文字、图片等,如何能简单的导出到Excel中,方便在本地电脑中查看和编辑呢?当然是有办法的啦!下面就为大家介绍几种简单快速的将网页数据导出到Excel的方法,大家可以灵活运用。
一、通过浏览器导出网页数据
具体操作:打开某网页后,右键点击网页空白处,在下拉列表中选择“另存为”,然后在弹出的保存窗口中选择保存类型为“网页 全部”。选择保存位置后确定,保存后就会自动保存两个文件,一个是网址,另一个是保存网页内容元素。
如何导出网页数据,以赶集网采集为例图1
八爪鱼·云采集服务平台
二、通过网页数据采集器导出网页数据
先通过网页数据采集器,将网页数据采集下来,然后再导出为需要的格式即可。本文使用的是操作简单、功能强大的八爪鱼采集器。以下是一个八爪鱼采集并导出网页数据的完整示例。示例中采集的是赶集网上房产-商铺-深圳-南山分类下的所有商铺信息。
示例网站:/fang6/nanshan/
步骤1:创建采集任务
1)进入主界面,选择“自定义模式”
如何导出网页数据,以赶集网采集为例图2
2)将要采集的网址URL,复制粘贴到网址输入框中,点击“保存网址”
八爪鱼·云采集服务平台
如何导出网页数据,以赶集网采集为例图3
步骤2:创建翻页循环
1)在页面右上角,打开“流程”,以展现出“流程设计器”和“定制当前操作”两个板块。将页面下拉到底部,点击“下一页”按钮,在右侧的操作提示框中,选择“循环点击下一页”
八爪鱼·云采集服务平台
如何导出网页数据,以赶集网采集为例图4
步骤3:创建列表循环
1)移动鼠标,选中页面里的第一个商铺链接。选中后,系统会自动识别页面里的其他相似链接。在右侧操作提示框中,选择“选中全部”
易语言爬取网页内容方法
易语⾔爬取⽹页内容⽅法写个辅助⼯具的时候需要提取⽹页⾥⾯的某些内容,我这⾥便把⽅法告诉⼤家,希望对⼤家有所帮助,记得投票给我哦!
1、在新建的windos窗⼝程序中画:
两个编辑框、⼀个按钮。
再添加模块如图中三步!
我们来实现,在⼀个编辑框中输⼊⽹址后,点击按钮,然后取到指定内容到编辑框2中。
2、⽐如我们来取百度某贴吧⼀个帖⼦内的内容!如下图中的“跑遍数码城,XXXXX”。
我们在该页⾯上右键---->查看⽹页源码(或查看源⽂件)。
3、在打开的源⽂件内容中按CTRL+F组合键查找“跑遍数码城”,我们只要⼀个开⽂中⼀部分就⾏了!找到对应的⽂字后,我们找到和⽹页中完全对应的那部分代码。PS:可能会出现⼏个被找到的内容,但是只要找到你需要取的那段全部对应部分就⾏。
4、复制正⽂中的前⾯的部分代码,不要复制太多的内容,待会我们⽤正⽂前的内容找到中间的内容。
然后在易语⾔中新建⼀个⽂本常量,把复制到的内容粘贴到“常量值”⾥⾯去。
5、然后我们去复制正⽂后⾯的⼀⼩段代码,同样新建⼀个⽂本常量,然后粘贴到常量值⾥⾯去。
6、此时我们回到编程程序中,点击按钮,在⽣成的“_按钮1_被单击”⼦程序下⾯新建⼀个⽂本型变量“得到的内容”,然后输⼊以下代码:
得到的内容 = ⽹页_访问s (编辑框1.内容)编辑框2.内容 = ⽂本_取出中间⽂本 (得到的内容, #常量1, #常量2)PS:第⼀⾏是把把编辑框中的⽹址打开后得到的⽹页源码赋值给“得到的内容”这个⽂本变量。
第⼆⾏则是对“得到的⽂本”进⾏取中间⽂本操作,⽂本_取出中间⽂本()是⼀个程序!它能取出中间内容的程序!
7、最后我们把程序调试运⾏⼀下,点击按钮“取内容”,是不是成功了呢?打开其他帖⼦取也是有效的,只要你取前后代码是正确的!
如果你是需要⽹页的源码,只要使⽤程序“ ⽹页_访问s()”,就然后把它赋值输出就OK了。当然!括号⾥⾯要有⽹页地址!
基于RTTI的特殊网页文本提取技术研究
第27卷第9期
2010年9月 计算机应用与软件
Computer Applications and Software Vo1.27 No.9
Sep.2010
基于RTTI的特殊网页文本提取技术研究
刘典型 欧阳柳波
(湖南大学软件学院湖南长沙410082)
(湖南公安高等专科学校计算机系 湖南长沙4101 38)
摘要 在分析与总结对网页中的文字的提取方法研究的基础上,针对采用脚本限制提取文字的特殊网页,作了深入的研究和分
析,提出R I-rI运行期类型信息解除限制和过滤干扰码的文字提取方法,使特殊网页文本的提取成为可能,为公安机关进行网络监察
取证提供了技术支持。
关键词 特殊网页 信息提取RTI'I干扰码 脚本
RESEARCH oN RTTI-BASED TEXT EXTRACTIoN TECHNIQUES
FRoM EXCEPTIoNAL WEBPAGES
Liu Dianxing ・ Ouyang Liubo
(School of Software,Hunan University,Changsha 410082,Hunan,China) (Department of Computer,Hunan Public Secur竹College,Changsha 410138,Hunan,China)
Abstract Based on the analysis and conclusion of researches on text extraction techniques from webpages,after thorough studies on exeep・
tional webpages which have been manually scripted to prevent text extraction,the authors put forward the R rrI(Run—Time Type Information) prevention elimination and interferential code filtration text extraction techniques to make it possible for text extraction from exceptional web—
在线识别文字的方法介绍,在线识别文字这样很快捷
在线识别文字的方法介绍,在线识别文字这样很快捷
如果你的领导给你发来一大堆的图片,让你将图片中的文字信息转移到word中,你会怎么办?你会傻傻的自己去码字,一个字一个字的打出来吗?今天,就让小欣来为你分享一个实用的在线识别文字的方法吧!这样识别,真的很快捷!
一、当你识别的图片文件低于50M时
现如今的图片都很高清,一张几M,几十M都是很常见的,所以我们在识别之前,就得查询一下,看看图片到底有多大,如果很幸运,图片的大小低于50M的话,那么你就可以直接通过在线网页来进行操作了。例如迅捷PDF转换器在线网页版,我们打开网页,看到接下来的这个画面。
将鼠标移动到上方的“图片文字识别”这里,然后在新出现的菜单中,找到图片文字识别,单击一下。
之后你会看到下面的这个界面,单击中间的“单击选择文件”,然后将需要识别的图片添加进来,注意看,在“开始识别”的旁边有一个继续添加的按钮,也就是说,在网页上提取图片文字也是可以批量操作的。
之后,我们可以在下方设置一下转换格式和识别效果,完成之后,点击开始识别。
二、当你识别的图片大于50M时
这个时候,你就需要使用软件来执行操作了,接下来,是小欣想为你安利的迅捷OCR文字识别软件的操作方法。
打开软件,可以看到如下的这个画面,右侧分别有批量识别和单张快速识别的选项,我们根据自己的需求进行选择,进去之后,点击上传图片,将需要识别的图片添加进来,之后,在下方的导出格式这里设置一下文档的格式,最后点击右下角的开始识别就行了。
上述便是在线识别文字的方法介绍了,一共两种方法,大家可以根据实际情况作出选择,不知道尝试过后,你更喜欢哪种方法呢?
selenium text方法
selenium text方法
Selenium的text方法是用于提取网页元素文本内容的功能。通过该方法,我们可以从网页中获取特定元素的文字描述,从而进行进一步的处理或验证。
在使用text方法之前,首先需要使用Selenium进行网页元素的定位。一般情况下,我们可以使用元素的标签名、类名、ID、XPath等等来定位元素。定位到需要获取文本内容的元素后,我们可以通过text方法获取其文本信息。
text方法的使用比较简单,只需要将定位到的元素作为参数传递给text方法即可。例如,假设我们通过XPath定位到一个按钮元素,可以使用如下代码获取该按钮的文本内容:
```python
button = driver.find_element_by_xpath("//button[@class='btn']")
button_text = button.text
print(button_text)
```
在上述代码中,我们首先使用find_element_by_xpath方法通过XPath定位到一个按钮元素,并将其赋值给变量button。然后,我们使用button的text方法获取按钮的文本内容,并将其赋值给变量button_text。最后,我们通过print语句将其打印出来。
通过使用text方法,我们可以获取到网页元素的文本内容,进而可以进行相关的验证或处理。例如,我们可以判断特定文本是否存在于网页元素中,或者使用文本内容进行进一步的数据分析。 总而言之,Selenium的text方法是一个方便的工具,可以帮助我们提取网页元素的文本信息。通过合理使用该方法,我们能够更好地进行网页自动化测试、数据分析或其他相关工作。