
正则表达式太有用了(查找替换)!
正则表达式
12大dAdd在3456[a-z]
12大dAdd在3457[^a-z]
a23d\d
a23d大[^\d]
HD68BkDDkc\H\D
HD68BkDDkc[H,D]
d12f459***566afgfgsfsdf-a[0-5]
d12f459***567afgfgsfsdf-a[6-9]
H11H23J75H8\d\d
122-123456\d{2}-\d{5}
122-123456^\d{2}-\d{5}
aaasabaaaaaa$
aaasabaaa^aaa
ahdd1hd*
hd*hd*12\*
123
456\n
uh u 12\s
uuuhu 12\Sjhgjgjg^\w
112233aabbb(.)\1
hhdfdh|d
大大is you do你好hdfd大d1\W
223dfs7\D
YOU 45 IS 88 GO 123\s
大大,is you do你好hdfd大d[!-~]
h1d,hgd,h12dh.d
h1d,hgd,h12dh..d
第一章,第二章,第八章第[一二]章
第一章,第二章,第八章第[^一二]章
a-sd-bAB[^-a-z]
a-sAd-Db[^a-z-]
a-sAd-Db大在[!--]
a-sAd-Db大在[-]
a-sAd-Db大23在[^A-Za-z0-9]
第1章,大斗,你好味第18章第[1-9][0-9]*章
第1章,大斗,你好味第18章第[1-9][0-9]{0,2}章
aaahdchdcc\Bhd
hdaaahdccchd\bhd
hdaaahdccchdhd\b
hd dfdfs hjj,dfdhd dfdhjj\bhd\b.*\hjj\b
010-585452 5,hd 210-4545\d+
010-585452 5,hd 210-4545\d*
dfdfd8887779fd 123456,ddd\b\w{6}\bdfdfd888大在7779fd 123456\w
dfas.dfsdf?sfas![.?!]
and you and ^\w+
saf/455df\D
112,2323,23,212385422323[1-4]\d
decdding,3434,dfing\b\w+(?=ing\b)注解结果
去掉小写字母12大A在3456
留小写字母ddd
去掉数字ad
留数字23
去掉头个HD68BkDDkc
去掉全部H和DHD68BkDDkc
去掉0-5这些数df966afgfgsfsdf-a
保留0-5这些数d12f455afgfgsfsdf-a
去掉两个连数HHJH8
去掉XX-XXXXX样式16
留下XX-XXXXX(不成功)122-123456
要后尾的aaaaaasab
要开头的aaasabaaa
h和d都去掉a1
去掉"*"号hdhd12
去掉换行符123456
去掉空格uhu12
去掉非空白
去掉下划线hgjgjg
去掉两个连续相同的字符b
去掉h和df
非单词字符(去中文)isyoudohdfdd123
留数字2237
去空格YOU45IS88GO123
留汉字大大 你好大
去掉任意hxd,,h12d
去掉任意hxxdh1d,hgd,
去掉第一二章,,第八章
留第一二章第一章,第二章,
留小写字母和-a-sd-b
留小写字母和-(效果和上面一样)a-sd-b
去掉-asAdDb大在
去掉---
配大小字母和数字asAdDb23
去掉“第x章”,*表示配之前的多次,大斗,你好味,,
去掉三个章,大斗,你好味,,第2866章
只配中间的hdaaaccc
配前头的hdaaahdccchd
配尾部的hdhdaaahdccc
去掉hd..hjj,"."任意字符,"*"任意数量,1234
配1或多个连续数字- ,hd -
配0或多个连续数字- ,hd -
配6个字母或数字,\w配字母,数字dfdfd8887779fd ,ddddddaaa,留中文,等于[a-z0-9A-Z]大在 ,,
去掉.?!符号dfasdfsdfsfas
去头一个单词 and
去掉非数字af/455df
2,,,85
去掉ing前的字ing,3434,ing
sublimetext正则表达式,替换每行末尾指定字符后的文本

sublimetext正则表达式,替换每行末尾指定字符后的文本
在Sublime Text中,你可以使用正则表达式来替换每行末尾指定字符后的文本。以下是一个步骤说明:
1. 打开你想要进行替换的文件。
2. 在菜单栏上,选择“Find” > “Find in Files” (或使用快捷键Ctrl+Shift+F),这将打开一个搜索框。
3. 在搜索框中,输入你想要匹配的正则表达式。例如,如果你想要替换每行末尾的逗号,你可以输入 ,。
4. 在“Replace with”字段中,输入你想要替换的文本。例如,如果你想要替换为分号,你可以输入 ;。
5. 确保“Regular Expression”选项被选中(在搜索框的左侧)。
6. 点击“Find All”按钮,Sublime Text将会高亮显示所有匹配的文本。
7. 如果你满意高亮显示的匹配项,你可以按“Replace All”按钮来一次性替换所有匹配的文本。
注意:正则表达式中的特殊字符可能需要转义,例如 \. 来匹配实际的点字符(.)。
使用正则表达式优化代码处理效率

使用正则表达式优化代码处理效率
正则表达式是一种用于匹配和处理文本的强大工具。在编写代码时,使用正则表达式可以大大简化复杂的文本处理逻辑,并提高代码的执行效率。
1.提高代码简洁性:使用正则表达式可以将复杂的字符串匹配和替换操作转化为简洁的几行代码,使代码更易于读写和维护。例如,使用正则表达式可以轻松地提取HTML标签中的内容,而不需要手动解析整个HTML文档。
2.加速字符串匹配:正则表达式引擎在内部使用高度优化的算法来加速字符串匹配操作。相对于手动编写循环和条件判断的方式,使用正则表达式可以提供更高效的字符串搜索和匹配功能。
3.优化字符串替换:正则表达式提供了强大的字符串替换功能。通过使用正则表达式,可以将多个替换操作合并为一个操作,从而提高代码的执行效率。此外,正则表达式还支持使用回调函数进行替换,进一步扩展了代码处理能力。 4.灵活处理复杂模式:正则表达式支持使用元字符和特殊语法来表示复杂的匹配模式。这使得我们可以灵活地处理各种复杂的需求,例如匹配邮箱地址、URL、日期等。通过适当选择和组合元字符,我们可以轻松地满足多种不同的需求。
尽管正则表达式提供了这么多的优势,但是也存在一些需要注意的问题:
1.性能问题:虽然正则表达式引擎在内部进行了优化,但复杂的正则表达式仍可能导致性能问题。当正则表达式包含大量的字符和分组时,匹配速度可能会变慢。因此,在编写正则表达式时需要注意避免使用过于复杂的模式。
2.可读性:由于正则表达式的语法较为复杂,使用复杂的正则表达式可能会降低代码的可读性。为了提高代码的可维护性,应尽量避免过于复杂的正则表达式,或者使用注释和说明来解释其含义。
3.错误处理:由于正则表达式本身具有一定的复杂性,编写错误的正则表达式可能导致代码的执行出错。因此,在使用正则表达式时需要仔细检查其语法和逻辑,避免潜在的错误。 综上所述,正则表达式是一种强大的工具,可以用于优化代码的处理效率。然而,尽管正则表达式提供了很多优势,但仍需要注意性能、可读性和错误处理等问题。在实际应用中,我们应根据具体的需求和场景选择合适的正则表达式,并进行优化和调试,以获得最佳的代码执行效率。
ultraedit正则表达式

UltraEdit是一款功能强大的文本编辑器,它支持正则表达式的使用。以下是一些常用的UltraEdit正则表达式的示例:
查找和替换:
查找匹配的字符串:在查找框中输入正则表达式,例如 \d+ 可以匹配一个或多个数字。
替换文本:在替换框中使用正则表达式来匹配和替换文本。
行操作:
删除空白行:使用正则表达式 \s*^$\s* 来匹配空白行,并删除它们。
去除行尾空格:使用正则表达式 \s+$ 来匹配行尾的空格,并替换为空。
提取信息:
提取邮箱地址:使用正则表达式 [A-Za-z0-9._%+-]+@[A-Za-z0-9.-]+\.[A-Za-z]{2,} 可以匹配并提取邮箱地址。
提取电话号码:使用正则表达式 (\+\d{1,2}\s?)?(\(\d{1,3}\)\s?)?(\d{1,4}[-\.\s]?)+\d{1,9} 可以匹配并提取电话号码。
文件操作:
批量重命名文件:使用正则表达式来匹配和替换文件名中的特定部分,例如将所有文件名中的空格替换为下划线。
文件搜索:在UltraEdit中使用正则表达式来进行高级文件搜索,可以更灵活地定位目标文件。
regexp使用方法
regexp使用方法
正则表达式(regular expression)是一种用来匹配和处理文本的强大工具。它可以用来查找、提取、替换和验证文本中的特定模式。无论是在编程语言中,还是在文本编辑器中,正则表达式都被广泛使用。本文将介绍如何使用正则表达式进行文本匹配、提取和替换。
一、正则表达式的基本概念
正则表达式由字符和元字符组成。字符可以是任何字母、数字或特殊字符,而元字符则具有特殊的含义。一些常见的元字符包括:
.(点号):匹配任意字符,除了换行符。
*(星号):匹配前一个字符的零个或多个实例。
+(加号):匹配前一个字符的一个或多个实例。
(问号):匹配前一个字符的零个或一个实例。
\(反斜杠):转义字符,用于匹配特殊字符。
[ ](方括号):匹配括号内的任意一个字符。
^(脱字符):匹配行的开头。
$(美元符号):匹配行的结尾。
二、正则表达式的语法规则
正则表达式的语法规则包括元字符和限定符的组合。元字符用于匹配特定的字符,而限定符则用于指定匹配字符出现的次数。一些常见的限定符包括:
{n}:匹配前一个字符的n个实例。 {n,}:匹配前一个字符的至少n个实例。
{n,m}:匹配前一个字符的至少n个、最多m个实例。
三、使用正则表达式进行文本匹配
在编程语言中,可以使用正则表达式的库函数或方法来进行文本匹配。以下是一个示例:
```python
import re
text = "Hello, World!"
pattern = r"Hello"
result = re.match(pattern, text)
if result:
print("匹配成功")
else:
print("匹配失败")
```
在上述示例中,使用re模块的match方法进行文本匹配。如果匹配成功,则返回匹配对象;否则返回None。
四、使用正则表达式进行文本提取
正则表达式不仅可以用来匹配文本,还可以用来提取文本中的特定部分。以下是一个示例:
正则表达式介绍

正则表达式介绍
正则表达式是一种强大的文本处理工具,它用于匹配、查找和替换文本中的模式。它是一种特殊的语法,可以用于描述字符串的结构和内容。
在日常工作中,我们经常需要处理各种各样的文本数据,比如文本文件、数据库中的数据、网页中的内容等。而正则表达式正是将这些文本数据进行有效处理的利器。
正则表达式的语法非常丰富,包含了大量的元字符和语法规则。下面我们就来介绍一些常见的元字符和语法规则。
元字符
元字符是正则表达式中的基本单位,它用于表示某种特殊的文本字符或字符集。下面是一些常见的元字符:
1. . :用于匹配任意一个字符,除了换行符(\n)。
2. ^ :用于匹配字符串的开头。
3. $ :用于匹配字符串的结尾。
4. * :用于匹配前面的字符出现0次或多次。
5. + :用于匹配前面的字符出现1次或多次。
6. ? :用于匹配前面的字符出现0次或1次。
7. | :用于表示或者的关系。
语法规则
除了元字符之外,正则表达式还包含了许多语法规则。下面是一些常见的语法规则:
1. 字符集:方括号([])内表示要匹配的字符集,可以使用连字符(-)表示范围。比如[0-9]表示匹配0到9之间的任意数字。
2. 分组:用小括号()来把多个元字符组合起来,形成一个整体。比如(ab)+表示匹配一个或多个连续的"ab"。
3. 反向引用:用反斜杠(\)加数字来引用前面的分组。比如(\w)\1表示匹配出现两次的任意单词字符。
4. 贪婪/非贪婪:在元字符后面加上问号(?)可以实现非贪婪模式。比如.*?表示匹配尽可能少的任意字符。
5. 零宽度断言:用于限定匹配的位置,但不会消耗任何字符。比如正向预查(?=)表示必须跟着某个模式,但不包含该模式;负向预查(?!)表示必须不跟着某个模式。
应用实例
下面我们通过一些实例来演示正则表达式的应用:
1. 匹配手机号码:^(13\d|14[579]|15[^4\D]|17[^49\D]|18\d)\d{8}$
oracle正则表达式替换
oracle正则表达式替换
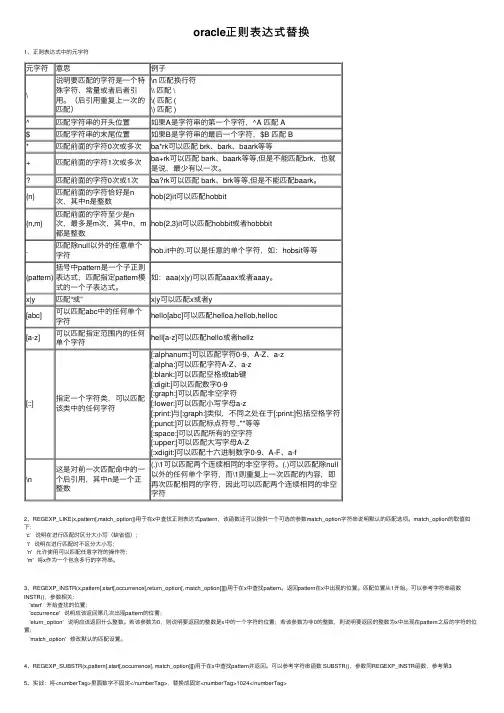
1、正则表达式中的元字符元字符意思例⼦
\说明要匹配的字符是⼀个特殊字符、常量或者后者引⽤。(后引⽤重复上⼀次的匹配)\n 匹配换⾏符\\ 匹配 \\( 匹配 (\) 匹配 )^匹配字符串的开头位置如果A是字符串的第⼀个字符,^A 匹配 A$匹配字符串的末尾位置如果B是字符串的最后⼀个字符,$B 匹配 B*匹配前⾯的字符0次或多次ba*rk可以匹配 brk、bark、baark等等+匹配前⾯的字符1次或多次ba+rk可以匹配 bark、baark等等,但是不能匹配brk,也就是说,最少有以⼀次。匹配前⾯的字符0次或1次ba?rk可以匹配 bark、brk等等,但是不能匹配baark。{n}匹配前⾯的字符恰好是n次,其中n是整数hob{2}it可以匹配hobbit
{n,m}匹配前⾯的字符⾄少是n次,最多是m次,其中n,m都是整数hob{2,3}it可以匹配hobbit或者hobbbit
.匹配除null以外的任意单个字符hob.it中的.可以是任意的单个字符,如:hobsit等等
(pattern)括号中pattern是⼀个⼦正则表达式,匹配指定pattern模式的⼀个⼦表达式。如:aaa(x|y)可以匹配aaax或者aaay。x|y匹配“或”x|y可以匹配x或者y[abc]可以匹配abc中的任何单个字符hello[abc]可以匹配helloa,hellob,helloc
[a-z]可以匹配指定范围内的任何单个字符hell[a-z]可以匹配hello或者hellz
[::]指定⼀个字符类,可以匹配该类中的任何字符[:alphanum:]可以匹配字符0-9、A-Z、a-z[:alpha:]可以匹配字符A-Z、a-z[:blank:]可以匹配空格或tab键[:digit:]可以匹配数字0-9[:graph:]可以匹配⾮空字符[:lower:]可以匹配⼩写字母a-z[:print:]与[:graph:]类似,不同之处在于[:print:]包括空格字符[:punct:]可以匹配标点符号.,""等等[:space:]可以匹配所有的空字符[:upper:]可以匹配⼤写字母A-Z[:xdigit:]可以匹配⼗六进制数字0-9、A-F、a-f
正则表达式使用工具教程
八爪鱼·云采集网络爬虫软件
正则表达式使用工具教程
正则表达式-教程
正则表达式是烦琐的,但是它是强大的,在八爪鱼中,学会正则表达式的应用能让你的数据展示更加规范化,所提取数据字段表达更加精准。合理的运用正则,除了提升你的数据展示规范、字段表达精准之外,还会给你带来绝对的成就感。只要认真阅读本教程,结合八爪鱼正则表达式工具实战应用,掌握正则表达式是非常容易的。
内容列表:
11.1正则表达式-简介
11.2正则表达式-简单示例
11.3-正则表达式-八爪鱼正则工具
11.4正则表达式-语法
11.5正则表达式-正则表达式及简单应用
11.1正则表达式-简介
正则表达式(Regular Expression),按英文直译是“规范化表达”,其作用是将复杂模糊的源数据通过正则表达式转化为简单直观的目标数据。例如:
“150ABCD”
“一百五ABCD”
“One hundred and fiftyABCD”
分析思考过程:
以上字符串中,我们的源文本数据分别为:““150ABCD”、“一百五ABCD”、“One hundred
and fiftyABCD”
假设我们要提取目标数据为:字符串中以数字开头的数据
那么我们约束条件为:只取字符串中以数字开头的源数据
将此约束条件转化为正则表达式为:[0-9](.+)\b
其中,[0-9]的语义为开头1位为0-9开头,中间间隔以通配符“.”代替,(.+)语义为字符串长度不做限定,\b的语义为,匹配一个边界。
正则后的目标数据:“150ABCD”
通过这个简单例子,我们大致了解到了为什么要用正则与正则所能实现的效果,讲通俗点就是,正则只是将我们的意愿(提取字符串中以数字开头的数据)以表达式的形式展现出来([0-9](.+)\b),并最终通过表达式匹配到所需要的目标数据(“150ABCD”),所以灵活运
regex 用法
regex 用法
正则表达式(regex)是一种用于匹配和操作文本的强大工具。在计算机中,正则表达式被广泛应用于搜索引擎、文本编辑器、程序设计、数据库管理等方面。 它可以帮助您快速搜索和操作文本,让我们举几个例子来应用正则表达式。
1. 替换字符串
假设您要在一段长文本中将“颜色”替换为“colour”,可以使用正则表达式。例如,在文本编辑器中,您可以使用以下正则表达式:
s/颜色/colour/g
其中“s”表示替换字符串的命令,“/g”表示全局替换。该表达式将在全文中替换所有出现的“颜色”为“colour”。
2. 匹配邮箱地址
您可以使用正则表达式匹配电子邮件地址。例如,以下正则表达式可以匹配以“@”符号为止的电子邮件地址:
^[^\s@]+@[^\s@]+\.[^\s@]+$
这个正则表达式利用了多个特殊字符,如“^”表示行的开头,“$”表示行的结尾,“+”表示前面的字符可以重复多次,“\.”表示一个点。如果你使用这个正则表达式,你可以快速过滤一个文件中所有的邮箱地址。
3. 搜索电话号码
\b(1-)?\d{3}-\d{3}-\d{4}\b
其中“\b”表示单词分界,即匹配单个数字,而“\d{n}”表示匹配n个数字。如果你在文本编辑器中搜索这个正则表达式,你就能快速找到这种格式的电话号码。
4. 找出URL
在互联网的时代里,URL成了必不可少的内容。正则表达式也可以快速找到所有的URL地址。例如,以下正则表达式可以匹配所有的URL地址:
(https?://)?([a-z0-9.-]*)\.([a-z]{2,3})(:[0-9]{1,5})?(/.*)?
该表达式解释如下:在“https://”和“http://”之前可能有一个可选的协议,“([a-z0-9.-]*)”匹配域名,这是任意数字、字母、短划线或点的组合,“([a-z]{2,3})”匹配顶级域名,如“.com”的两到三个字母,“:[0-9]{1,5}”匹配可选的端口号,“(/.*)?”匹配URL中的路径。
正则表达式用法详解
正则表达式⽤法详解
正则表达式之基本概念
在我们写页⾯时,往往需要对表单的数据⽐如账号、⾝份证号等进⾏验证,⽽最有效的、⽤的最多的便是使⽤正则表达式来验证。那什么是正则表达式呢?
正则表达式(Regular Expression)是⽤于描述⼀组字符串特征的模式,⽤来匹配特定的字符串。 它的应⽤⾮常⼴泛,特别是在字符串处理⽅⾯。其常见的应⽤如下:
验证字符串,即验证给定的字符串或⼦字符串是否符合指定的特征,例如,验证是否是合法的邮件地址、验证是否是合法的HTTP地址等等。查找字符串,从给定的⽂本当中查找符合指定特征的字符串,这样⽐查找固定字符串更加灵活。替换字符串,即查找到符合某特征的字符串之后将之替换。
提取字符串,即从给定的字符串中提取符合指定特征的⼦字符串。
第⼀部分:正则表达式之⼯具
正所谓⼯欲善其事必先利其器! 所以我们需要知道下⾯⼏个主要的⼯具:
第⼆部分:正则表达式之元字符
正则表达式中元字符恐怕是我们听得最多的了。元字符(Metacharacter)是⼀类⾮常特殊的字符,它能够匹配⼀个位置或者字符集合中的⼀个字符。 如.、\w等都是元字符。
刚刚说到,元字符既可以匹配位置,也可以匹配字符,那么我们就可以通过此来将元字符分为匹配位置的元字符和匹配字符的元字符。
A匹配位置的元字符---^、$、\b
即匹配位置的元字符只有^(脱字符号)、$(美元符号)和\b这三个字符。分别匹配⾏的开始、⾏的结尾以及单词的开始或结尾。它们匹配的都只是位置。
1.^匹配⾏的开始位置
如^zzw匹配的是以"zzw"为⾏开头的"zzw"(注意:我这⾥想要表达的是:尽管加了⼀个^,它匹配的仍是字符串,⽽不是⼀整⾏!),如果zzw不是作为⾏开头的字符串,则它不会被匹配。
2.$匹配⾏的结尾位置
如zzw$匹配的是以"zzw"为⾏结尾的"zzw"(同样,这⾥$只是匹配的⼀个位置,那个位置是零宽度,⽽不是⼀整⾏),如果zzw不是作为⾏的结尾,那么它不会被匹配。
PostgreSQL正则表达式替换-使用变量方式
PostgreSQL正则表达式替换-使⽤变量⽅式
###不定期更新
把AAAA替换为A-A-A-A-
javascript
alert('AAAA'.replace(/([A]{1})/g,"$1-"));
()中的内容⽤变量$1 $2 $n代替
PostgreSQL
select regexp_replace('AAAAAAAAAAAAAAAAAAAAAA','([A-Z]{1})','\1-','g')
()中的内容⽤变量\1 \2 \n代替
获取⼤括号中的内容
select f1[1] from regexp_matches('asdfadfadsf{_id}','[\{]{1}(.*?)[\}]{1}') as f1
字符串去重
-- \1表⽰只匹配第⼀个⼦串
select regexp_replace('adsfjjbkk中中','(.)(\1)+','\1','g')
select regexp_replace('adaaasfjjjbkk','(.).*(\1)+','\1','g')
去除字符串最后两位
select substring('abc123d4' from '^(.*?)..$');
-output abc123
擦除所有空格
select * from regexp_matches(' abc123d 4测试 ','[^ ]+','g');
select * from regexp_matches(' abc123d4测试 ','[^ ]+','g');
-output abc123
擦除左右两边的空格
select regexp_replace(' abc123d4 测试 ','^[ ]?(.*?)[ ]?$','\1','g');
从html中提取字符串
select f1 from regexp_split_to_table('
取开头4个字符和最后4个字符
with cte as(
select '实际⽉份少⼀个⽉a1.' as f limit 1