
基于近场波束形成的麦克风阵列语音增强方法
《2024年基于麦克风阵列的语音增强研究》范文

《基于麦克风阵列的语音增强研究》篇一
一、引言
随着人们对音频质量要求的不断提高,语音增强技术逐渐成为音频处理领域的研究热点。麦克风阵列技术作为一种有效的语音增强手段,通过多个麦克风的协同作用,可以实现对声源的定位、语音信号的分离以及语音增强的功能。本文旨在研究基于麦克风阵列的语音增强技术,以期在复杂环境中实现高保真的语音识别与通讯。
二、麦克风阵列基本原理
麦克风阵列是由多个麦克风按照一定规则排列而成的阵列系统。其基本原理是通过不同麦克风接收到的信号之间的相位差和幅度差,结合阵列几何结构,实现对声源的定位和信号的分离。麦克风阵列技术广泛应用于语音识别、语音增强、声源定位等领域。
三、基于麦克风阵列的语音增强方法
基于麦克风阵列的语音增强方法主要包括声源定位、信号分离和后处理三个步骤。
1. 声源定位:通过多个麦克风的信号到达时间差和幅度差等信息,估计出声源的方向和距离。声源定位是后续信号分离的基础。 2. 信号分离:在确定了声源位置后,采用适当的信号处理算法,如盲源分离、基于高阶统计的分离方法等,从混合信号中提取出目标语音信号。这一步骤中,针对噪声环境和不同背景下的分离效果尤为关键。
3. 后处理:通过语音增益调整、噪声抑制等后处理技术,进一步提高语音信号的质量。后处理环节可以有效消除背景噪声、回声等干扰因素,使语音信号更加清晰。
四、研究现状与挑战
目前,基于麦克风阵列的语音增强技术在理论研究和实际应用方面都取得了显著的成果。然而,在实际应用中仍面临诸多挑战。如:如何提高声源定位的准确性、如何有效分离混合信号中的目标语音、如何处理不同环境下的噪声干扰等。此外,随着人工智能和深度学习技术的发展,如何将先进的算法应用于麦克风阵列技术,提高语音增强的效果和效率,也是当前研究的重点。
五、研究方法与实验结果
为了解决上述问题,本文采用深度学习算法与麦克风阵列技术相结合的方法进行语音增强研究。首先,通过构建神经网络模型,实现对声源的精准定位和混合信号的有效分离;其次,利用深度学习算法对后处理环节进行优化,进一步提高语音质量;最后,通过实验验证了该方法的可行性和有效性。实验结果表明,该方法在复杂环境下具有良好的语音增强效果,提高了语音识别的准确率。
基于麦克风阵列的语音增强算法概述

2011年第3期 (总第139期) 大众科技 DAZHoNG KE J No.3,2011 (Cumulatively No.1 39)
基于麦克风阵列的语音增强算法概述
丁 猛
(海军医学研究所,上海200433)
【摘要】麦克风阵列语音增强技术是将阵列信号处理与语音信号处理相结合,利用语音信号的空间相位信息对语音信号 进行增强的一种技术。文章介绍了各种基于麦克风阵列的语音增强基本算法,概述了各算法的基本原理,并总结了各算法的特 点及其所适用的声学环境特性。 【关键词】麦克风阵列;阵列信号处理;语音增强 【中图分类号】TN911.7 【文献标识码】A 【文章编号】1008—1151(2011)03—0029—02
(一)引言
在日常生活和工作中,语音通信是人与人之间互相传递
信息沟通不可缺少的方式。近年来,虽然数据通信得到了迅
速发展,但是语音通信仍然是现阶段的主流,并在通信行业
中占主导地位。在语音通信中,语音信号不可避免地会受到
来自周围环境和传输媒介的外部噪声、通信设备的内部噪声
及其他讲话者的干扰。这些干扰共同作用,最终使听者获得
的语音不是纯净的原始语音,而是被噪声污染过的带噪声语
音,严重影响了双方之间的交流。
应用阵列信号处理技术的麦克风阵列能够充分利用语音
信号的空时信息,具有灵活的波束控制、较高的空间分辨率、 高的信号增益与较强的抗干扰能力等特点,逐渐成为强噪声
环境中语音增强的研究热点。美国、德国、法国、意大利、
日本、香港等国家和地区许多科学家都在开展这方面的研究
工作,并且已经应用到一些实际的麦克风阵列系统中,这些
应用包括视频会议、语音识别、车载声控系统、大型场所的
记录会议和助听装置等。
文章将介绍各种麦克风阵列语音增强算法的基本原理,
并总结各个算法的特点及存在的局限性。 (二)常见麦克风阵列语音增强方法
1.基于固定波束形成的麦克风阵列语音增强
固定波束形成技术是最简单最成熟的一种波束形成技
【CN110010147A】一种麦克风阵列语音增强的方法和系统【专利】

(19)中华人民共和国国家知识产权局(12)发明专利申请(10)申请公布号 (43)申请公布日 (21)申请号 201910199908.2(22)申请日 2019.03.15(71)申请人 厦门大学地址 361000 福建省厦门市思明南路422号(72)发明人 王宇芳 童峰 黄惠详 郭秋涵 (74)专利代理机构 厦门福贝知识产权代理事务所(普通合伙) 35235代理人 郝学江(51)Int.Cl.G10L 21/0216(2013.01)G01S 3/802(2006.01)
(54)发明名称一种麦克风阵列语音增强的方法和系统(57)摘要公开了一种麦克风阵列语音增强的方法和系统,其包括利用麦克风阵列进行多通道的语音信号的采集,接收能量收集器获得的语音能量,获取声源方位信息,利用声源方位信息的几何关系计算麦克风阵列信号各通道的时延补偿值,根据麦克风阵列信号各通道的时延补偿值进行波束成形处理,实现语音信息的增强。本发明充分利用圆锥结构本身的信号反射聚焦特性进行对应角度范围内的语音能量收集,可实时获取方位信息,无需采用复杂的方位估计算法,系统实现
简单方便。
权利要求书2页 说明书6页 附图4页CN 110010147 A2019.07.12
CN 110010147
A1.一种麦克风阵列语音增强的方法,其特征在于,包括以下步骤:S1:利用麦克风阵列进行多通道的语音信号的采集;S2:接收能量收集器获得的语音能量,获取声源方位信息;S3:利用所述声源方位信息的几何关系计算所述麦克风阵列中各个麦克风阵列信号各通道的时延补偿值;S4:根据所述麦克风阵列信号各通道的时延补偿值进行波束成形处理。2.根据权利要求1所述的一种麦克风阵列语音增强的方法,其特征在于,所述能量收集器包括多个圆锥形反射器件,所述多个圆锥形反射器件相互贴紧且顶部相交于一点,所述多个圆锥形反射器件的中心线在同一平面上,所述多个圆锥形反射器件的开口部构成的收集范围覆盖所述声源的活动区域,所述圆锥形反射器件顶点设置有第一麦克风。3.根据权利要求1所述的一种麦克风阵列语音增强的方法,其特征在于,所述步骤S2中所述声源方位信息的获取和所述步骤S3中所述时延补偿值的计算同时进行。4.根据权利要求2所述的一种麦克风阵列语音增强的方法,其特征在于,所述步骤S2中所述声源方位信息的计算公式为:其中,j为所述能量收集器的通道编号,energy(j)为接收所述能量收集器获得的语音能量,θΔ为所述圆锥形反射器件的相邻角度。5.根据权利要求2所述的一种麦克风阵列语音增强的方法,其特征在于,所述麦克风阵列包括5个等间距排列的第二麦克风组成的5元麦克风线阵,所述5元麦克风阵列包括所述第二麦克风、前置放大电路和处理器。6.根据权利要求5所述的一种麦克风阵列语音增强的方法,其特征在于,所述第一麦克风和所述第二麦克风共用所述前置放大电路和所述处理器,所述第一麦克风和所述第二麦克风通过所述处理器进行切换。7.根据权利要求1所述的一种麦克风阵列语音增强的方法,其特征在于,所述步骤S3中所述麦克风阵列中各个通道麦克风接收的语音信号si(k)的时延补偿值的计算公式为:s′i(k)=si(k′)
基于麦克风阵列的语音增强方法研究的开题报告

基于麦克风阵列的语音增强方法研究的开题报告
一、研究背景
语音通信在现代社会中越来越普遍,但其受到的环境干扰与噪声也越来越严重,从而降低了语音通信质量。因此,语音增强技术成为了一个备受关注的热点领域。语音增强旨在通过降噪、增益和声源定位等方法来提升语音信号的质量,从而改善人们的通信体验。
目前,许多语音增强方法利用麦克风阵列技术来实现。麦克风阵列系统是由多个麦克风组成的系统,可以有效地抑制噪声、增强有用信号并准确地定位声源。因此,基于麦克风阵列的语音增强方法在语音增强领域具有广泛应用。
二、研究目的
本研究旨在探索基于麦克风阵列技术的语音增强方法,以提高语音通信的质量。具体目标包括:
1. 分析目前麦克风阵列技术在语音增强方面的应用现状和存在的问题。
2. 探究基于麦克风阵列技术的语音增强算法原理和实现方法。
3. 提出改进现有基于麦克风阵列的语音增强算法的思路和方法,并开展实验验证。
三、研究内容
1. 研究麦克风阵列技术在语音增强方面的应用现状和问题
本研究将分析目前麦克风阵列技术在语音增强方面的应用现状和存在的问题。具体研究内容包括麦克风阵列的结构、定位方法、音频信号处理等方面的技术现状及其限制。
2. 探究基于麦克风阵列技术的语音增强算法原理和实现方法 本研究将深入探究基于麦克风阵列技术的语音增强算法的原理和实现方法。其中包括降噪、增益和声源定位等方面的信息处理技术。
3. 提出改进现有基于麦克风阵列的语音增强算法的思路和方法,并开展实验验证
基于前两个阶段的研究结果,本研究将提出改进现有基于麦克风阵列的语音增强算法的思路和方法,以进一步提高语音增强效果。本研究还将进行实验验证,评估改进算法的有效性和可行性。
四、研究意义
本研究将有助于改进麦克风阵列技术在语音增强方面的应用,提升语音通信的质量和用户体验。同时,本研究的研究结果和算法也将为语音增强技术的进一步发展和应用提供参考。
五、预期研究结果
基于麦克风阵列的语音增强研究
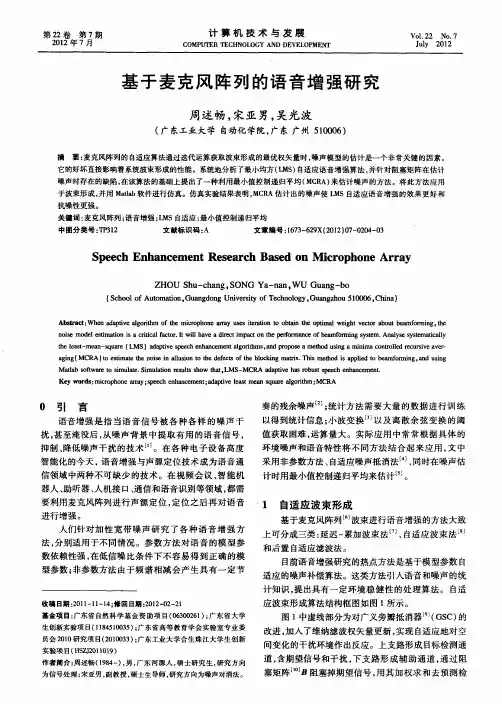
第22卷第7期 2012年7月 计算机技术与发展 COMPl 7 I'ER IECHNOLOGY AND DEVELOPMENT Vo1.22 No.7 July 2012 基于麦克风阵列的语音增强研究 周述畅,宋亚男,吴光波 (广东工业大学自动化学院,广东广州510006) 摘要:麦克风阵列的自适应算法通过迭代运算获取波束形成的最优权矢量时,噪声模型的估计是一个非常关键的因素。 它的好坏直接影响着系统波束形成的性能。系统地分析了最小均方(LMS)自适应语音增强算法,并针对阻塞矩阵在估计 噪声时存在的缺陷,在该算法的基础上提出了一种利用最小值控制递归平均(MCRA)来估计噪声的方法。将此方法应用 于波束形成,并用Matlab软件进行仿真。仿真实验结果表明,MCRA估计出的噪声使LMS自适应语音增强的效果更好和 抗噪性更强。 关键词:麦克风阵列;语音增强;LMS自适应;最小值控制递归平均 中图分类号:TP312 文献标识码:A 文章编号:1673—629X(2012)07—0204—03 Speech Enhancement Research Based on Microphone Array ZHOU Shu-chang,SONG Ya—nan-WU Guang-bo (School of Automation。Guangdong University of Technology。Guangzhou 510006lChina) Abstract:When adaptive algorithm of the microphone array uses iteration tO obtain the optimal weight vector about beamforming-the noise model estimation is a critical factor.It will have a direct impact on the performance of beanaforming system.Analyse systematically the least—mean—square(LMS)adaptive speech enhancement algorithms-and propose a method using a minima controlled recursive aver- aging【MCRA)to estimate the noise in allusion to the defects of the blocking matrix.This method is applied to beamforming.and using Manab software to simulate.Simulation results show that。LMS—MCRA adaptive has robust speech enhancement. Key words:microphone array;speech enhancement;adaptive least mean square algorithm;MCRA O 引 言 语音增强是指当语音信号被各种各样的噪声干 扰,甚至淹没后,从噪声背景中提取有用的语音信号, 抑制、降低噪声干扰的技术…。在各种电子设备高度 智能化的今天,语音增强与声源定位技术成为语音通 信领域中两种不可缺少的技术。在视频会议、智能机 器人、助听器、人机接口、通信和语音识别等领域,都需 要利用麦克风阵列进行声源定位,定位之后再对语音 进行增强。 人们针对加性宽带噪声研究了各种语音增强方 法,分别适用于不同情况。参数方法对语音的模型参 数依赖性强,在低信噪比条件下不容易得到正确的模 型参数;非参数方法由于频谱相减会产生具有一定节 收稿日期:201l一1l一14:修回日期:2012—02—21 基金项目:广东省自然科学基金资助项目(06300261);广东省大学 生创新实验项目(1184510035);广东省高等教育学会实验室专业委 员会2010研究项目(2010033);广东工业大学合生珠江大学生创新 实验项目(HSZJ2011019) 作者简介:周述畅(1984一),男,广东河源人,硕士研究生,研究方向 为信号处理;宋亚男,副教授,硕士生导师,研究方向为噪声对消法。 奏的残余噪声 ;统计方法需要大量的数据进行训练 以得到统计信息;小波变换 以及离散余弦变换的阈 值获取困难,运算量大。实际应用中常常根据具体的 环境噪声和语音特性将不同方法结合起来应用,文中 采用非参数方法、自适应噪声抵消法 ,同时在噪声估 计时用最小值控制递归平均来估计 。 1自适应波束形成 基于麦克风阵列 波束进行语音增强的方法大致 上可分成三类:延迟一累加波束法 、自适应波束法 和后置自适应滤波法。 目前语音增强研究的热点方法是基于模型参数自 适应的噪声补偿算法。这类方法引入语音和噪声的统 计知识,提出具有一定环境稳健性的处理算法。自适 应波束形成算法结构框图如图1所示。 图1中虚线部分为对广义旁瓣抵消器 (GSC)的 改进,加入了维纳滤波权矢量更新,实现自适应地对空 间变化的干扰环境作出反应。上支路形成目标检测通 道,含期望信号和干扰,下支路形成辅助通道,通过阻 塞矩阵¨。。
《麦克风阵列近场波束形成典型方法的比较研究》范文
《麦克风阵列近场波束形成典型方法的比较研究》篇一
一、引言
随着音频处理技术的不断发展,麦克风阵列技术逐渐成为音频信号处理领域的重要研究方向。近场波束形成作为麦克风阵列处理的关键技术之一,在音频定位、语音识别、声源追踪等领域有着广泛的应用。本文旨在比较研究麦克风阵列近场波束形成的典型方法,分析其性能差异及优缺点,为相关应用提供理论支持。
二、近场波束形成的基本原理
近场波束形成是利用多个麦克风接收到的声波信号,通过加权、延时和求和等操作,使得在特定方向上的声波信号得到加强,从而提高声源定位的准确性和语音识别的性能。其基本原理包括信号预处理、波束形成算法和后处理等步骤。
三、典型近场波束形成方法
1. 延迟求和法
延迟求和法是最简单的波束形成方法之一。该方法通过调整不同麦克风接收到的信号的延时,使得声源方向上的信号在求和时得到加强。该方法实现简单,但受到麦克风阵列形状、声源方向等因素的影响较大。
2. 最小均方误差法
最小均方误差法是一种基于统计的波束形成方法。该方法通过最小化期望信号与实际输出信号之间的均方误差来调整权值,从而实现声源方向的定位。该方法具有较高的定位精度,但计算复杂度较高。
3. 最大信噪比法
最大信噪比法是一种基于信号处理理论的波束形成方法。该方法通过调整权值使得输出信号的信噪比达到最大,从而实现声源方向的定位。该方法在噪声环境下具有较好的性能,但需要已知声源的方向信息。
四、典型方法比较分析
1. 性能比较
延迟求和法实现简单,但在复杂环境下的性能较差;最小均方误差法具有较高的定位精度,但计算复杂度较高;最大信噪比法在噪声环境下具有较好的性能,但需要已知声源的方向信息。因此,在实际应用中需根据具体需求选择合适的波束形成方法。
2. 优缺点分析
(1)延迟求和法:优点是实现简单,计算复杂度低;缺点是性能受麦克风阵列形状、声源方向等因素影响较大。
(2)最小均方误差法:优点是定位精度高;缺点是计算复杂度高,实时性较差。
采用可调波束形成器的GSC麦克风阵列语音增强方法
采用可调波束形成器的GSC麦克风阵列语音增强方法
李芳兰;周跃海;童峰;洪青阳
【期刊名称】《厦门大学学报(自然科学版)》
【年(卷),期】2013(052)002
【摘 要】基于广义旁瓣抵消器(generalized sidelobe canceller,GSC)算法的麦克风阵列语音增强技术已得到广泛研究,但由于其通常需传统的声源定位方法提供声源方位,语音信号信噪比(SNR)低时声源定位精度将明显下降并影响到语音增强效果.提出了一种新的麦克风阵列语音增强方法,该方法在GSC中引入可调波束形成器估计声源方位以抑制背景噪声影响.不同类型背景噪声下的实验室语音增强结果表明了该方法的有效性.%Generalized sidelobe canceller (GSC) has been widely
investigated in microphone array speech enhancement. However,the
traditional source localization methods are usually adopted to obtain the
direction of source, which is needed for the GSC algorithm. Under
relatively low signal noise ratio (SNR) the performance of the GSC will
degrade due to the decreasing precision of the source localization. This
paper presents a new method for the GSC based microphone array speech
enhancement, which uses an adjustable beamformer (ABF) to estimating
《麦克风阵列近场波束形成典型方法的比较研究》范文 2
《麦克风阵列近场波束形成典型方法的比较研究》篇一
一、引言
随着音频处理技术的不断发展,麦克风阵列技术已成为音频信号处理领域的一个重要方向。近场波束形成是麦克风阵列技术中的一项关键技术,它可以通过对多个麦克风的信号进行加权求和,从而形成指向性波束,提高目标声音的信噪比。本文将对麦克风阵列近场波束形成典型方法进行比较研究,为相关领域的研究和应用提供参考。
二、麦克风阵列近场波束形成的基本原理
麦克风阵列近场波束形成是通过多个麦克风的信号进行加权求和,从而形成指向性波束。其基本原理包括信号的采集、预处理、波束形成和后处理等步骤。在近场条件下,由于声波的传播距离较短,麦克风阵列中各麦克风接收到的信号具有明显的相位差和幅度差异,因此需要根据实际场景和需求进行加权处理。
三、典型近场波束形成方法
1. 延迟求和法
延迟求和法是一种简单的近场波束形成方法。该方法通过估计声源到达各麦克风的传播时间延迟,对各麦克风的信号进行时间对齐后求和,从而形成指向性波束。该方法具有计算复杂度低、实时性好的优点,但波束指向性较差,容易受到环境噪声的影响。
2. 最小均方误差法 最小均方误差法是一种基于统计优化的近场波束形成方法。该方法通过最小化期望信号与实际输出信号之间的均方误差,求解最优的加权系数。该方法具有较高的指向性和抗干扰能力,但计算复杂度较高,实时性相对较差。
3. 基于频域的波束形成方法
基于频域的波束形成方法是将信号从时域转换到频域进行处理的方法。该方法通过估计声源的频率和到达角度信息,对各麦克风的频域信号进行加权求和。该方法具有较高的指向性和抗干扰能力,同时可以有效地抑制空间混响和噪声。但需要注意的是,在处理过程中需要考虑到频率分辨率和混响时间等因素的影响。
四、典型方法的比较分析
针对上述三种典型的近场波束形成方法,本文从计算复杂度、指向性、抗干扰能力、实时性等方面进行比较分析。延迟求和法计算复杂度低、实时性好,但指向性较差;最小均方误差法具有较高的指向性和抗干扰能力,但计算复杂度较高;基于频域的波束形成方法在指向性和抗干扰能力方面具有较好的性能,但需要考虑频率分辨率和混响时间等因素的影响。因此,在实际应用中需要根据具体场景和需求选择合适的近场波束形成方法。
基于麦克风阵列的语音增强算法
2020年4月 计算机工程与设计
Apr. 2020
第 41 卷 第 4 期 COMPUTER ENGINEERING AND DESIGN Vol. 41 No. 4
基于麦克风阵列的语音增强算法
闵新宇,王清理,冉云飞
(中国航天科工集团第二研究院706
所,北京100854
)
摘 要
:为解决现有语音增强算法需要麦克风数量较多和受估计误差影响较大的问题!
提出一种改进的声源定位和波束形
成方法。在现有声源定位算法利用时间延迟的基础上!引入能量衰减参数!
实现利用双麦克风进行声源定位的目标;在波
束形成算法中引入加载系数,在出现协方差矩阵统计失配时仍可对期望方向聚焦!提高波束形成算法的鲁棒性。仿真结果
表明!改进后的算法与传统算法相比具有更强的鲁棒性。
关键词:语音增强;麦克风
阵列;声源定位;波束形成;时延估计
中图法分类号
:TN912. 35 文献标识号:A 文章编号:1000-7024 (2020) 04-1074-06
doi
: 10. 16208/j. issnl000-7024. 2020. 04. 029
Speech enhancement algorithm based on microphone array
MIN Xin-yu
, WANG Qing-li
? RAN Yun-fei
(Institute 706, Second Academy of China Aerospace Science and Industry Corporation, Beijing 100854, China)
Abstract:
To solve the problem that the existing speech enhancement algorithms need a large number of microphones and they
aregreatlyafectedbytheestimationerror,animprovedsoundsourcelocalizationandbeamformingmethodwasproposed\Based
《麦克风阵列近场波束形成典型方法的比较研究》范文 3
《麦克风阵列近场波束形成典型方法的比较研究》篇一
摘要:
随着智能音频技术的发展,麦克风阵列在近场通信、声源定位和语音增强等场景中的应用日益广泛。其中,近场波束形成技术作为麦克风阵列的核心技术之一,其性能的优劣直接影响到语音识别的准确性和声音质量的清晰度。本文旨在比较研究麦克风阵列近场波束形成的典型方法,分析其优缺点,为实际应用提供参考依据。
一、引言
麦克风阵列是一种由多个麦克风组成的系统,通过信号处理技术对阵列中各麦克风的信号进行加权和合并,以实现声源定位和语音增强的目的。近场波束形成是麦克风阵列中重要的信号处理技术之一,其通过调整各麦克风的权重系数,形成指向特定方向的波束,从而提高语音识别的准确性和声音质量的清晰度。本文将比较研究几种典型的近场波束形成方法,并分析其性能。
二、近场波束形成典型方法
1. 延迟求和波束形成法
延迟求和波束形成法是一种最基本的波束形成方法。该方法通过对阵列中各麦克风信号进行时间延迟补偿,使所有信号对齐于同一声源的同一时间点上,然后将各麦克风的信号加权相加形成波束。此方法的优点是简单易行,但在复杂环境下对噪声和干扰信号的抑制能力较弱。
2. 最小均方误差波束形成法
最小均方误差波束形成法是一种基于最小均方误差准则的优化方法。该方法通过计算各麦克风信号的权系数,使得输出信号与期望信号之间的均方误差最小化。此方法能够较好地抑制噪声和干扰信号,提高语音识别的准确性,但计算复杂度较高。
3. 空间协方差矩阵波束形成法
空间协方差矩阵波束形成法是一种基于空间协方差矩阵的波束形成方法。该方法通过计算各麦克风信号之间的协方差矩阵,得到空间协方差矩阵的逆矩阵或特征值分解后的空间滤波器系数,从而实现对声源的定位和波束的形成。此方法具有较高的抗干扰能力和噪声抑制能力,但计算量较大。
三、方法比较分析
1. 性能比较
延迟求和波束形成法在简单环境下性能较好,但在复杂环境下易受噪声和干扰信号的影响。最小均方误差波束形成法具有较好的噪声抑制能力和声源定位精度,但计算复杂度较高。空间协方差矩阵波束形成法在复杂环境下具有较高的抗干扰能力和噪声抑制能力,但计算量较大。综合来看,三种方法各有优缺点,应根据具体应用场景选择合适的波束形成方法。