
深度学习项目实战视频课程-人脸检测
人脸检测项目实战
目的:检测到人脸框
(1):数据
数据获取:
1. Benchmark是一个行业的基准(数据库,论文,源码,结果)。
2. 优秀论文,通常实验阶段都会介绍它所使用的数据集,公开数据集可以下载。申请数据集的时候,最好使用学校的邮箱。
3. 论坛或者交流社区,比如thinkface
4. 数据的规模 越大越好 今天的数据量4W多
二分类数据,第一类人脸,第二类非人脸
人脸数据:路径/xxx.jpg 60,80,280,320 非人脸数据:只要不是人脸都是可以的
对于正样本:裁剪的操作,根据标注的坐标把人脸裁剪出来。可以opencv这个工具,来完成制作人脸数据。要检查一下,看一看数据有没有问题。
对于负样本:
进行一个随机的裁剪,IOU这个比例(重叠的比例)在原始的数据当中,IOU<0.3认为是一个负样本,最好是拿没有人脸数据的当作负样本。
制作LMDB数据源(其实它就是caffe支持的非常常用的分类的数据源)
写两个txt文档文件
Train.txt
0/xxx.jpg 0
1/xxx.jpg 1
Val.txt
xxx.jpg 0
xxx.jpg 1
制作LMDB数据源,用caffe提供的脚本文件
前几行改成自己的安装目录 要进行一个resize操作,比如ALEXNET或者VGG通常都是给它resize 227*227.
Sh LMDB脚本文件。文件是很大的
(2)训练ALEXNET网络
把最后一层全连接改成你要分类的类别个数(人脸检测来说就是2)
Solver文件
Test_iter:咱们一次测试,要测试多少个batch
最好让test_iter*batch_size = 测试集中样本总个数
Base_lr 基础的学习率,太重要了,不能太大
网络训练的速度跟什么最相关?
1. 网络的模型大小,网络越大速度越慢。
2. 数据输入的大小,227*227 和 32*32的,可能要慢几百倍。输入越大,网络越慢。
人脸代码:
多尺度的人脸检测
(1) model转换成全卷积
(2) 多个scale
(3) 前向传播,得到特征图,概率值矩阵
(4) 反变换,映射到原图上的坐标值
(5) NMS非极大值抑制
问题:速度太慢了,因为咱们做了多个scale,每个scale都要进行一次前向传播。
解决:采取级联的网络,再加上矫正网络。
使用Deeplearning4j进行人脸识别

使用Deeplearning4j进行人脸识别
人脸识别技术在当今的社会中得到了广泛的应用,例如手机解锁、人脸支付等。而Deeplearning4j作为一个强大的深度学习框架,可以用于实现人脸识别。本文将介绍如何使用Deeplearning4j进行人脸识别,并探讨其在实际应用中的潜力。
一、人脸识别简介
人脸识别是一种通过计算机对人脸进行识别和验证的技术。它通过采集、预处理、特征提取和匹配等步骤,将人脸与数据库中的已知人脸进行比对,从而实现身份认证或者身份识别。目前,人脸识别技术已经取得了长足的进步,成为了计算机视觉领域的研究热点。
二、Deeplearning4j简介
Deeplearning4j是一种基于Java语言的深度学习框架,它支持分布式的深度学习训练,并且能够在多种硬件和操作系统上执行。Deeplearning4j具有良好的可扩展性和灵活性,可以用于各种深度学习任务,包括图像识别、语音识别和自然语言处理等。
三、使用Deeplearning4j进行人脸识别的步骤
1. 数据集准备
在进行人脸识别之前,需要准备一个人脸图像的数据集。数据集应包含已知人脸的图像,以及对应的标签信息。可以使用已有的公开数据集,也可以自行采集和标注数据集。 2. 数据预处理
在进行人脸识别之前,需要对数据进行预处理。预处理包括图像的尺寸调整、灰度化、直方图均衡化等。这些步骤可以提高人脸识别的准确性和鲁棒性。
3. 特征提取
特征提取是人脸识别的关键步骤,它将人脸图像转换为向量表示。Deeplearning4j提供了多种深度学习模型,可以用于提取人脸图像的特征。常用的模型包括卷积神经网络和自编码器等。
4. 模型训练
在特征提取之后,需要使用已知人脸的特征向量来训练一个分类器或者回归器。Deeplearning4j支持多种机器学习模型的训练,例如支持向量机、随机森林和深度神经网络等。选择合适的模型和算法,并使用训练数据进行模型训练。
基于深度学习的人脸检测

基于深度学习的人脸检测
摘要
基于现实场景,本文提出了一种改进的YOLO-v3人脸检测算法,以检测出现实中的人脸。随着CNN(卷积神经网络)和IoT(物联网)技术的发展,基于深度学习的目标检测算法已成为主流,出现了SSD[1](单镜头检测)和YOLO[2]系列等典型算法。然而,这些基于深度学习的算法都不是完美的,在检测精度、计算速度和多目标检测能力方面还有改进的空间。在本文中,通过引入EfficientNet骨架和CBAM注意力机制,获得改进的YOLO-v3网络。设计了一种轻量级,实时性的人脸识别系统。本文经过在数据集上进行训练与测试,实验结果表明,识别目标人脸的平均精度超过90%,验证了所提出方法的有效性。
1 引言
人脸识别是人工智能和计算机视觉领域最重要的应用之一,是当前模式识别和人工智能领域的一个研究热点。其在公安罪犯识别、安全验证系统,信用卡验证,医学档案管理,视频会议,人机交互系统等方面的巨大应用前景,受到了研究人员的广泛关注,而人脸检测是进行人脸识别的基础,研究高效实用的人脸检测算法具有重要的意义。
目前,关于人脸检测方法的研究可以分为基于传统方法和基于深度学习方法两个方向。传统的人脸检测方法有很多,Adaboost人脸检测方法通过无数次迭代来寻求最优分类器检测人脸[3]。 SVM通过构造有效的学习机器来解决人脸的检测问题[4]。传统的人脸检测方法提取的特征单一,鲁棒性较差。随着深度学习的不断发展,人脸检测的性能有了很大的提高。目前经常使用的基于深度学习的目标检测方法分为两种:一种是基于候选区域的目标检测算法[5],需要首先生成候选区域,然后对候选区域进行分类和回归操作,以Faster R-CNN为代表;另一个是YOLO算法,仅使用一个卷积神经网络直接预测不同目标的类别和位置。与Faster R-CNN算法相比,YOLO可以实现了实时检测速度,但精度较低。为了提高YOLO算法的精度,Redmon等人提出YOLOv2[6]和YOLOv3[7]。YOLOv3在保持速度的同时提高了预测精度。为了进一步提升YOLOv3网络的检测性能,本文设计了一种高效实时的人脸识别系统,首先将YOLOv3的骨架网络替换成EfficientNet网络,其次在YOLOv3的三个输出头之前添加CBAM注意力机制,通过这些改进,本文使YOLOv3网络的性能得到了提升。
ng-深度学习-课程笔记-14:人脸识别和风格迁移(Week4)
ng-深度学习-课程笔记-14:⼈脸识别和风格迁移(Week4)
1 什么是⼈脸识别( what is face recognition )
在相关⽂献中经常会提到⼈脸验证(verification)和⼈脸识别(recognition)。verification就是输⼊图像,名字或id,判断是不是。⽽⼈脸识别是输⼊图像,输出这个⼈的名字或id。
我们先构造⼀个准确率⾼的verification,然后再把它应⽤到⼈脸识别中。
2 ⼀次学习( One-shot learning )
假设现在要做⼀个⼈脸识别,但是你的数据库对于每个⼈只有⼀张照⽚,要怎么做?
这个时候可能会觉得怎么可能只有⼀张照⽚,你要做⼈脸识别肯定要有⾜够的数据啊,没数据就去收集啊。
那现在数据库中对于每个⼈都有充⾜的样本数据,你构建了⼀个卷积神经⽹络,最后⽤softmax输出来判断这个⼈是数据库的哪个⼈,或者都不是。
那么,如果你的数据库加⼊了新的⼈呢,⽐如说公司⼊职⼀批新员⼯,这要怎么做呢?再收集⼀波,然后加⼀批输出单元然后重新训练⽹络吗?这似乎不是个好办法。
在⼈脸识别中,有⼀个挑战就是,你有时只能通过⼀个样本学习到是不是这个⼈,这就是⼀次学习。
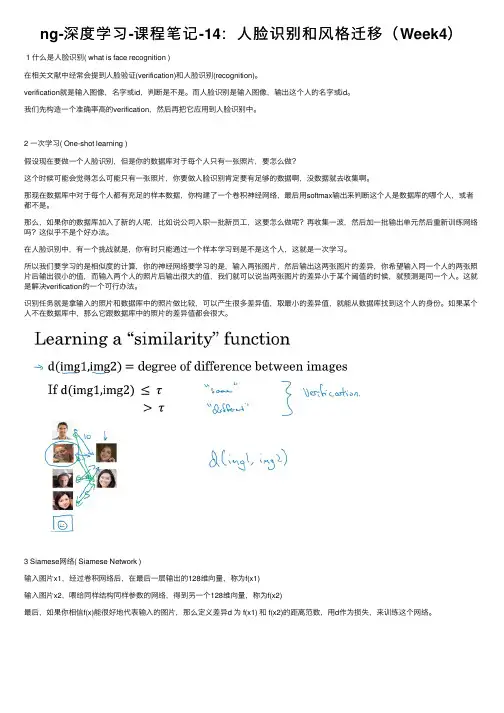
所以我们要学习的是相似度的计算,你的神经⽹络要学习的是,输⼊两张图⽚,然后输出这两张图⽚的差异,你希望输⼊同⼀个⼈的两张照⽚后输出很⼩的值,⽽输⼊两个⼈的照⽚后输出很⼤的值,我们就可以说当两张图⽚的差异⼩于某个阈值的时候,就预测是同⼀个⼈。这就是解决verification的⼀个可⾏办法。
识别任务就是拿输⼊的照⽚和数据库中的照⽚做⽐较,可以产⽣很多差异值,取最⼩的差异值,就能从数据库找到这个⼈的⾝份。如果某个⼈不在数据库中,那么它跟数据库中的照⽚的差异值都会很⼤。
3 Siamese⽹络( Siamese Network )
输⼊图⽚x1,经过卷积⽹络后,在最后⼀层输出的128维向量,称为f(x1)
输⼊图⽚x2,喂给同样结构同样参数的⽹络,得到另⼀个128维向量,称为f(x2)
人脸识别实训课程学习总结应用深度学习算法进行人脸识别的实际操作指南

人脸识别实训课程学习总结应用深度学习算法进行人脸识别的实际操作指南
人脸识别实训课程学习总结:
应用深度学习算法进行人脸识别的实际操作指南
随着科技的不断发展,人脸识别技术越来越受到广泛关注和应用。人脸识别技术通过分析和识别人脸的独特特征来辨认和识别个人身份。在现实生活中,人脸识别技术已经成功应用于安防、社交娱乐等诸多领域。而要学习人脸识别技术,掌握深度学习算法的实际操作指南是至关重要的。本文将从学习总结的角度,分享人脸识别实训课程中应用深度学习算法进行人脸识别的实际操作指南。
一、实操环境准备
在进行人脸识别实践之前,我们首先需要准备良好的实操环境。这包括硬件和软件两个方面的准备。在硬件方面,我们需要一台配置良好的计算机或服务器,以保证算法的运行效率和稳定性。在软件方面,我们需要安装适合的深度学习框架,如TensorFlow或PyTorch,并配置相关依赖库和环境。除此之外,我们还需要准备人脸数据库,以供训练和测试使用。
二、人脸数据集的准备
人脸数据集的质量对于训练一个有效的人脸识别模型来说至关重要。为了提高识别的准确度和鲁棒性,我们需要尽可能多地收集带有不同表情、姿态、光照和遮挡的人脸图像。可以从公开的人脸数据集中获取样本数据,如LFW、CelebA等。同时,也可以结合实际场景,使用摄像头采集现场人脸数据,以增加模型的适应性。
三、学习深度学习算法
在进行人脸识别实际操作前,我们需要对深度学习算法有一定的了解和掌握。深度学习算法是实现人脸识别的关键,其原理和实现方法,如卷积神经网络(CNN)、人脸特征提取算法等,都需要我们通过学习和实践来掌握。可以参考相关的教材、论文以及网络上的教程、博客等资料,并结合实际情况加以实践,逐步提升自己的算法实战能力。
四、数据预处理与特征提取
在进行人脸识别实际操作前,我们还需要对原始数据进行一些预处理以及特征提取。预处理的任务包括数据清洗、人脸检测和对齐、数据增强等。特征提取则是通过深度学习算法提取人脸图像中的信息,形成用于识别的特征向量。流行的人脸特征提取算法有基于深度学习的FaceNet、ArcFace等。选择适合自己需求的预处理和特征提取方法,有助于提高识别准确度和效率。
基于深度学习的视频人脸表情识别与情绪分析系统设计
基于深度学习的视频人脸表情识别与情绪分析系统设计
近年来,随着深度学习技术的发展和应用,视频人脸表情识别与情绪分析系统正逐渐成为研究和应用的热点。人脸是人与人之间进行情感沟通的重要媒介,在很多应用领域有着广泛的应用,如人机交互、心理研究等。本文将基于深度学习技术,探讨视频人脸表情识别与情绪分析系统的设计与实现。
首先,视频人脸表情识别与情绪分析系统的设计需要从数据采集、数据预处理、特征提取和分类识别四个方面进行考虑。
在数据采集方面,系统需要获取包含不同人脸表情的视频数据集。这些数据集应涵盖不同人的多种表情和情绪状态,以保证模型的鲁棒性和泛化能力。数据采集时应注意多样性和均衡性,尽可能覆盖不同种族、性别和年龄段的人脸,以提高识别的准确性。
数据预处理是构建识别模型的重要步骤。因为视频数据通常包含大量的冗余信息,如背景、光照变化等,需要通过预处理方法去除这些干扰因素,提高模型的训练效果。常见的预处理方法包括帧间差分法、直方图均衡化和降噪等。
特征提取是视频人脸表情识别的关键环节。传统的表情识别方法通常采用手工设计的特征,如LBP(Local Binary Patterns)和HOG(Histogram of Oriented Gradients)等。然而,随着深度学习的兴起,基于卷积神经网络(CNN)的特征提取方法已经成为主流。通过预训练的深度学习模型(如VGGNet、ResNet等),可以提取到更加丰富、高层次的特征表达,显著提高了表情识别的性能。
最后,分类识别是视频人脸表情识别与情绪分析系统的核心任务。通过深度学习模型对提取到的特征进行分类识别,可以实现对视频中人脸表情的自动识别和情绪状态的分析。在训练阶段,可以采用一些经典的深度学习模型,如卷积神经网络(CNN)、循环神经网络(RNN)和长短时记忆网络(LSTM)等,通过大规模的训练数据进行端到端的模型训练。在测试阶段,对输入的视频序列进行特征提取,再通过预训练好的分类器进行表情识别和情绪分析。
基于深度学习的视频人脸识别技术研究与优化

基于深度学习的视频人脸识别技术研究与优化
随着技术的发展,深度学习已经逐渐成为了人工智能领域中最热门的话题之一。人脸识别技术是深度学习应用的重要领域之一,它能从人脸图像中识别、识别并标识出个体,进行个体分类、人脸检索等一系列操作。
人脸识别技术的原理
在传统的人脸识别技术中,一般采用的是人脸特征分析技术,标准是就在人脸上选取最具代表性的区域作为特征点,一般的方法是基于旋转不变、大小不变,通过多关键点匹配,最后特征码匹配得到结果。但这种技术缺点明显,特征太明显,相似度对照单一,无法完整考虑复杂情况,同时人脸还有分辨率、角度、光线等多种因素影响。
随着深度学习的发展,人脸识别领域也迎来了新的机遇。深度学习的模型能够自动将每个人的聚类分析出来,进而将人脸识别的任务转化为对特征建模。它能够自动学习每个人的特征,找到最适合每个人的特征值,这就是深度学习的模型。
具体来说,深度学习的人脸识别原理是:首先将人脸图像输入到一个卷积神经网络中,完成低级特征提取,然后输入到一个完全连接的神经网络中,完成高级特征提取。最后,将这个高级特征值输入到一个分类器中,完成分类任务。
即,深度学习利用神经网络结构表征,训练过程中将大量的数据经过学习,选取人脸图像中的高维度特征作为数据的最佳表示,从而对人脸图像进行分类等一系列任务。
基于深度学习的视频人脸识别技术研究 视频人脸识别技术是深度学习在人脸识别领域中的最新应用之一,目的是在满足高效准确的前提下,通过对视频中的多帧人脸图像进行分析,达到超越单张图片的效果。
具体来说,视频人脸识别主要包括以下几个步骤:
1. 数据采集和清洗:视频人脸识别技术需要采集一些样本数据,包括人脸属性等信息。采集到的数据需要进行处理和清洗,以提高恰当数据的可靠性。
2. 图像处理:在数据采集和清洗之后,就要对采集到的数据进行处理。对于视频中的每个帧,需要进行人脸检测和人脸识别,从而找到图像中的所有人脸并提取出人脸的相关信息。
人脸识别技术课程设计
人脸识别技术课程设计
一、课程目标
知识目标:
1. 学生能够理解人脸识别技术的基本概念和原理;
2. 学生能够掌握人脸检测、特征提取和识别等关键技术;
3. 学生能够了解人脸识别技术在生活中的应用及其优势。
技能目标:
1. 学生能够运用所学知识,使用相关软件或编程语言实现简单的人脸识别程序;
2. 学生能够通过实践操作,提高问题解决能力和团队协作能力;
3. 学生能够运用数据分析方法,评估人脸识别技术的性能。
情感态度价值观目标:
1. 学生能够认识到人工智能技术在生活中的重要性,增强对科技的兴趣和好奇心;
2. 学生能够关注人脸识别技术在社会中的伦理道德问题,培养负责任的科技使用态度;
3. 学生能够通过课程学习,提高自己的信息素养,树立正确的价值观。
本课程针对高年级学生,结合信息技术学科特点,注重理论与实践相结合。课程旨在帮助学生掌握人脸识别技术的基本知识和技能,培养他们运用科技解决问题的能力,同时引导他们关注科技发展对社会的影响,树立正确的价值观。通过具体的学习成果分解,为教学设计和评估提供明确依据。 二、教学内容
1. 人脸识别技术概述
- 引入人脸识别的基本概念、发展历程及应用领域;
- 分析人脸识别技术的优势和挑战。
2. 人脸识别关键技术
- 人脸检测:讲解人脸检测算法,如Haar级联分类器、深度学习等;
- 特征提取:介绍特征提取方法,如LBP、HOG、深度特征等;
- 识别算法:探讨人脸识别算法,如支持向量机、深度学习等。
3. 人脸识别应用案例
- 分析生活中的人脸识别应用,如手机解锁、安防监控等;
- 探讨人脸识别技术在其他领域的应用,如社交、医疗等。
4. 实践操作与案例分析
- 使用人脸识别开发工具或编程语言,实现简单的人脸识别程序;
- 分析人脸识别技术在实际应用中的性能和问题,提出解决方案。
5. 伦理道德与信息安全
- 讨论人脸识别技术在使用过程中可能涉及的伦理道德问题;
基于深度学习的人脸检测和识别系统设计与实现
基于深度学习的人脸检测和识别系统设计与实现
人脸检测和识别技术是深度学习在计算机视觉领域的一个重要应用。通过对输入图像进行处理和分析,该技术能够准确地检测和识别图像中的人脸,为人脸识别、人脸验证、人脸聚类等应用提供支持。本文将重点介绍基于深度学习的人脸检测和识别系统的设计与实现方法。
一、人脸检测技术的设计与实现
1. 数据集准备
在设计人脸检测系统之前,需要准备一个包含人脸和非人脸图像的数据集。为了获得准确的检测结果,应该尽量选择具有不同姿态、表情和光照条件的人脸图像,并加入一定数量的非人脸图像作为负样本。
2. 深度学习模型选择
当前,深度学习在人脸检测领域表现出色。常用的深度学习模型包括卷积神经网络(Convolutional Neural Network,简称CNN)和目标检测模型,如Faster R-CNN、YOLO等。根据实际需求,选择适合的深度学习模型进行人脸检测器的设计。
3. 数据预处理
在输入图像进行模型训练之前,需要进行数据预处理。常见的预处理方法包括图像缩放、图像增强、数据增强等。通过这些预处理方法可以提高模型的泛化能力和鲁棒性。
4. 模型训练与优化
在准备好数据集并完成预处理后,可以开始模型的训练与优化。训练过程中需要选择合适的损失函数和优化算法,并进行迭代优化,使模型在训练集上达到较好的效果。
5. 模型评估与部署
在模型训练完成后,需要对其进行评估。评估指标主要包括准确率、召回率、精确率等。通过评估结果可以对模型的性能进行分析,并进行进一步优化。最后,将训练好的模型部署到实际应用中,完成人脸检测系统的设计与实现。
二、人脸识别技术的设计与实现 1. 数据集准备
在设计人脸识别系统之前,同样需要准备一个包含不同人脸图像的数据集。为了提高识别准确度,建议选择具有多种表情、光照条件和遮挡情况的人脸图像,并在数据库中为每张人脸图像提供相应的标签。
2. 人脸特征提取
人脸识别的关键是提取人脸图像中的特征信息,常用的特征提取方法包括局部二值模式(Local Binary Patterns,简称LBP)、主成分分析(Principal Component
《深度学习与计算机视觉实战》教学大纲
《深度学习与计算机视觉实战》教学大纲
课程名称:深度学习与计算机视觉实战
课程类别:必修
适用专业:大数据技术类相关专业
总学时:64学时(其中理论40学时,实验24学时)
总学分:4.0学分
一、 课程的性质
随着人工智能的发展,计算机视觉作为人工智能的一个重要分支,已经被成功应用到人脸识别、目标检测、道路场景分割、图像超分辨率等领域,被大多数人熟知和应用。深度学习在计算机视觉的应用效果一骑绝尘,频频刷新传统图像处理方法在计算机视觉领域创造的记录。能够熟练应用深度学习技术且具有实践经验的计算机视觉人才已经成为了各企业争夺的热门。为了推动我国大数据,云计算,人工智能行业的发展,满足日益增长的计算机视觉人才需求,特开设深度学习与计算机视觉实战课程。
二、 课程的任务
通过本课程的学习,使学生学会使用Python进行图像处理基本操作和处理深度学习视觉基础任务,并详细拆解学习人脸识别、目标检测、道路场景分割、图像超分辨率等案例,将理论与实践相结合,为将来从事计算机视觉研究、工作奠定基础。
三、 课程学时分配
序号 教学内容 理论学时 实验学时 其它
1 第1章 概述 2 1
2 第2章 图像处理基本操作 6 2
3 第3章 深度学习视觉基础任务 8 4
4 第4章 基于CNN人脸识别实战 6 4
5 第5章 基于Faster R-CNN的目标检测实战 6 4
6 第6章 基于U-Net的城市道路场景分割实战 6 4
7 第7章 基于SRGAN的图像超分辨率技术实战 6 4
总计 40 24
四、 教学内容及学时安排
1. 理论教学
序号 章节名称 主要内容 教学目标 学时
1 概述 1. 计算机视觉的发展历程
2. 深度学习的发展历程
3. 计算机视觉常见的应用领域
4. 常见的深度学习框架
5. 常用的图像处理库 1. 了解计算机视觉的发展历程
2. 了解深度学习的发展历程
初学者的AI技术使用指南
初学者的AI技术使用指南
AI技术发展迅猛,已经渗透到了我们生活的各个领域。而随着越来越多的人对AI技术感兴趣,那些初学者们可能会感到一时无从下手。本篇文章将给初学者提供一份AI技术使用指南,帮助他们更好地了解和使用这些先进的技术。
一、什么是AI技术?
人工智能(Artificial Intelligence,简称为AI)是指计算机模拟并实现人类智力的能力。其核心在于让计算机具备学习、理解和思考的能力。AI可以分为弱人工智能和强人工智能两种类型,前者用于完成特定任务(如图像识别、语音识别),后者则具备完全的人类智能。
二、常见的AI技术
1. 机器学习
机器学习(Machine Learning)是最常见也是最重要的AI技术之一。它通过训练计算机模型来使其自动进行决策或预测。有监督学习、无监督学习和增强学习是常用的机器学习方法。
2. 深度学习
深度学习(Deep Learning)是一种基于神经网络架构的机器学习方法。它模仿人脑神经系统的运作方式,可以通过大量数据和逐层学习提供准确的预测和判断。深度学习在图像识别、语音处理等领域取得了重大突破。
3. 自然语言处理
自然语言处理(Natural Language Processing,简称为NLP)是指让计算机与人类自然语言进行交互和理解的一种技术。它使得计算机能够理解文本、分析情感和生成自然语言。 4. 计算机视觉
计算机视觉(Computer Vision)是指让计算机获取、分析和理解图像与视频的能力。计算机视觉可以实现物体检测、人脸识别、图像搜索等功能,在智能监控、无人驾驶等领域有广泛应用。
5. 强化学习
强化学习(Reinforcement Learning)是一种通过试错来训练智能体做出决策的技术。在强化学习中,智能体通过与环境进行互动来获得奖励或惩罚,并根据这些反馈不断优化自身策略。
三、如何入门AI技术?
1. 学习基础数学知识