
区域经济中长期预测的支持向量回归方法
2006年4月系统工程理论与实践第4期
文章编号:1000.6788(2006)04.0097—07区域经济中长期预测的支持向量回归方法肖健华1’2,林健3,刘晋3
(1.五邑大学智能技术与系统研究所,广东江门529020;2.北京航空航天大学经济管理学院,北京100083;3.五邑大学管理学院,广东江f-i529020)
摘要:分析了区域经济发展特性以及中长期经济预测的特点,对当前经济预测方法存在的不足进行了阐述,指出:由于区域经济系统中存在高度的非线性、耦合性和时变性,使得现有的经济预测方法难以胜任.介绍了支持向量回归算法,并在此基础上,提出了基于支持向量回归的方法对区域经济进行中长期预测的思路,并建立了相应的数学模型.以广东省江门市作为应用对象,说明了该模型的有效性.关键词:支持向量回归;统计学习理论;区域经济;中长期预测中图分类号:TPl81文献标识码:A
ASVR--basedModelforRegionalEconomyMedium--termand
Long・termForecast
XIAOJian—hual”,LINJian3,LIUJin3
(1.InstituteofIntelligentTechnologyandSystems,WuyiUniversity,Jiangmen529020,China;2.SchoolofEconomicsand
Management,
BeihangUniversity,Beijing100083,China;3.SchoolofManagement,wuyiUniversity,Jiangmen529020,China)
Abstract:Basedontheanalysisofcharacteristicsofregionaleconomyandforecastingmethodsformedium-termandlong-termeconomicdevelopment,drawbacksofcurrentforecastingmethodswereexplainedasthatthosemethodsare
notsuitableforforecastingmedium-termandlong—termeconomicdevelopmentduetoitsnonlinearity,coupling
and
dynamicity.Asupportvectorregressionalgorithmwasbeenintroduced,andthenanideaofforecastingmedium—termandlong-termregionaleconomybasedonthealgorithmwasexplainedandamathematicmodelbasedontheideawas
proposed.Atlast,anexperimentwasconductedtoverifytheproposedmodelontheeconomicdatasetofJiangmen,
Guangdong.Keywords:supportvectorregression(SVR);statisticlearningtheory(SLT);regionaleconomy;medium-term;
long—termfomeast
1引言经济发展的中长期预测,一般是指五年以上经济发展趋势的预测,旨在为一个国家或一个区域的中远景规划提供科学的依据.就经济发展预测而言,与国家宏观经济发展规律相比,区域经济的发展存在自身的特点.首先是波动性大,而且所研究的区域越小波动性越大,有时甚至一个企业的兴衰、降雨量的多少等都可能对一个区域的经济发展产生很大的影响;其次是系统的相对独立性和开放流动性,单个区域的独立性相对较小,各个区域各有侧重,某个区域经济必然与其它的区域经济形成互补.当然,区域经济的发展预测也具备一般经济系统预测的共同特性…:非线性,区域经济系统是众多确定性因素和非确定性因素交互作用下的非线性系统;强耦合性,反映经济发展的各种指标、构成经济系统的各行业、各部门等无不密切关联,每一个指标或行业的变化都会导致其它指标或行业的变化;时变性,经
收稿13期:2004—10.10资助项目:国家自然科学基金(70471074);中国博士后科学基金(2005038042)作者简介:肖健华(1970一),男,汉族,江西永新人,博士后,副教授,主要研究方向:智能信息处理,复杂经济系统建模,E.mail:jianhuaxiao@tom.com;林健(1958一),男,汉族,福建福州人,博士生导师,五邑大学校长,主要研究方向为复杂系统建模与仿真;刘晋(1956一),女,湖北孝感人,博士,教授,主要研究方向为管理决策支持系统.
万方数据98系统工程理论与实践2006年4月济系统是一个动态的开放系统,反映其运行规律的数学模型始终在不断的变化中.在对区域经济的发展进行预测时,必须充分考虑上述各种因素,尤其是蕴含在指标数据上的非线性、时变性和不确定性作用关系.建立在计量经济学理论基础上的各种经济预测模型,大部分属于线性模型.线性模型在发挥巨大作用的同时,也逐渐显露出它的缺点,即很难把握经济系统中的非线性现象,最终必然造成预测结果的较大误差.为弥补这一缺陷,经济领域的一些研究工作者对线性模型进行了修正,如建立分段线性模型和变参数线性模型等,但结果往往不理想瞳].以神经网络为代表的非线性建模方法,一度给经济预测带来了希望,理论上也证明了在选择适当的隐层数及相应的神经元数目下,前馈神经网络能以任意精度逼近任意非线性函数.然而在实际应用中,由于神经网络存在的一些缺陷,使得神经网络应用到实际经济系统的发展预测中还存在一定问题.这些缺陷包括:网络结构不能保证最优化;训练算法存在局限,收敛速度得不到保障,且容易陷入局部最优;对训练样本的数量与质量要求较高;基于经验风险最小化的优化目标,不能保证泛化性能‘3|.由Vapnik提出的统计学习理论(StatisticLearningTheory,SLT)Ho发展而来的核方法(KernelMethod,
KM)b],实现了数据空间与特征空间之间的非线性映射,可以有效地将数据空间中的各种非线性操作演变为特征空间中相应的线性操作,进而大大地提高了非线性处理能力.作为核方法的一种,支持向量回归(SupportVectorRegression,SVR)在非线性回归中具备非常优秀的性能№J.更为难能可贵的是,SVR建立在结构风险最小化的优化目标上,很大程度上改善了神经网络在非线性拟合上存在的不足.本文首先介绍SVR算法,进而对广东省江门市的经济发展历史数据进行了分析,在此基础上提出基于SVR的区域经济中长期预测方法,并建立了相应的数学模型.
2支持向量回归算法考虑给定的n个学习样本(Xi,Y;),XiER。,YiER,i=1,2,…,n,线性回归的目标就是求回归函数.厂(X)=(W・X)+b.(1)式中:WER。,bER,(W・X)为形与x的内积.在以往的学习算法中,优化目标是使经验风险即样本损失函数L(Xi)L(Xi)=g(Y;一f(X。)).(2)的累积R。。(,)最小化,如最dx-"乘法,所求的(W,b)应满足
minR。。。(,)=∑(Yi一-厂(X;))2.(3)
然而,统计学习理论指出,经验风险最小并不能保证期望风险最小¨].在结构风险最小化的优化目标下,线性回归方程式(1)中的参数(W,b)应满足
minQ(W,b)=寺II形||2+衄。。,(,).(4)
上式中的||形lI2/2反映了回归函数.厂(x)的泛化能力,C为惩罚因子.式(4)表明,结构风险最小化能够折
中考虑回归函数的经验风险和泛化能力,因此,回归函数具有更好的性能.式(2)中常用的损失函数L(五)包括二次函数、Huber函数、Laplace函数和e一不敏感函数等.其中e一不敏感函数能够忽略e范围内的回归误差
£。,’,一,。五,—,:;二二{主;:季:.c5,£c(’2iI,,i一,(五)I—s,l≥i一>(≤)I;£。(5’
比较适合于经济数据处理.如果,IY;一(W・Xi)一bI<e(i=1,2,…,凡)成立,对应图1中外面两条直线所围区域内的样本点,即
所有样本的损失函数都为0,因此有R。。(f)=0,式(4)可改写为:
万方数据第4期区域经济中长期预测的支持向量回归方法rainQ(形,b)=百1
lI形Il
2,
s.t.扎一(形・置)一b≤e,(肜・Xi)+6一儿≤e.显然,约束条件式(7)和式(8)并不总能得到满足,此时则必须弓松弛因子£I>0和车jI>0,如图1所示,在£一不敏感损失函数下(4)的优化问题变为阳’71
minQ(形,6)=告Il训2+C∑(£+e?),一i=1
s.t.Y‘一(形・Xi)一6≤e+毫,(IV・xi)+6一),f≤e+车?,£,车?≥0.
(10)图1不敏感函数下的线性回归示意图
(11)(12)引入参数ai,口?,砩,叩?≥o,构造Lagrange函数对上述优化问题进行求解
£:=百1lI形II2+C∑(毛+s:)一∑a;(e+£一y;+(形・置)+6)一
∑a:(e+拿:+Yi一(形・Xi)“)一∑("qi£i;+叩蔫).(13)
考虑到上式关于IV,6,£,手?取极小,因此对L关于形,6,£,}?求偏导,并令它们等于0筹=o一塞∽q)=o,(14)
券=o一形=塞㈠一口?)Xi,…)
筹=o—c叫哪-0,(16)
暑=o—c_“_0.(17)
将式(14)~式(17)代入式(13),得到对偶优化问题maxQ(%a?)=一告∑(口;一口?)(d,一a?)(置,葺)一e∑(口i+口j)+∑y;(口i一口?),(18)
s.t.∑(口i一口:)=0,(19)0≤口;,a:≤C.(20)由上述优化方程,可求出口;和a7.实际上只有一部分口;一口?≠o‘4【,与之对应的样本(Xi,,,i)称为支持向量(SupportVector,SV).进一步由式(1)和式(15)得到回归方程,
,(x)=∑(ai—O/i+)(x;・x)+6.(21)根据KKT条件,任选一支持向量,上式中6依下式计算f62,,;一(形‘置)_e,ai∈(o,㈣.(22)
【6=Y;一(形・Xi)+£,d?∈(0,C)
将式(15)代入七式得
・Xi)一£,口i∈(0,C)・置)+£,口:∈(0,C)(23)巧
瓦口
口一一a口。∑川。∑川一一yy== 万方数据
基于 SVM 的“弹性系数-投入产出”电力需求预测分析模型

基于 SVM 的“弹性系数-投入产出”电力需求预测分析模型董力通;谭显东;刘伟国;刘海波【摘要】Based on the fact that the demand of electricity must be reasonably forecast, which is an important basis to ensure the power grid planning and industrial development, in order to optimize industrial structure and promote energy conservation and emission reduction, there are many uncertain factors to change the medium and long-term electricity demand, considering the effects of multiple factors on the elastic coefficient of the electric power economic development, according to the input-output model, a forecasting model was constructed using the algorithm of support vector machine(SVM). Using electricity demand and GDP, taking the industrial structure of data in 2000-2009 as samples, the total electricity demand in 2010 was forecast. The results show that compared with elastic coefficient regression forecasting and ordinary common SVM forecasting method, the forecasting accuracy of the total electricity demand increases by 8.90% and 3.98%, respectively.%基于合理预测电力需求,是保证电网规划与产业发展合理性的重要依据,在我国优化产业结构、推进节能减排的环境下,电力中长期需求的变化面临更多不确定因素,考虑多个因素对电力经济发展弹性系数的影响,按照投入产出模型,运用支持向量机算法构建预测模型.以2000- 2009年我国电力需求及GDP,产业结构的数据为样本,预测2010年的电力需求总量.通过与普通弹性系数回归预测、普通支持向量机预测方法对比,电力需求总量预测精度分别提高8.90%和3.98%.【期刊名称】《中南大学学报(自然科学版)》【年(卷),期】2012(043)006【总页数】4页(P2441-2444)【关键词】电力需求;弹性系数;投入产出;支持向量机【作者】董力通;谭显东;刘伟国;刘海波【作者单位】华北电力大学经济与管理学院,北京,102206;国网北京经济技术研究院,北京,100052;国网能源研究院,北京,100052;国家电网公司,北京,100031;华北电力大学经济与管理学院,北京,102206;国网北京经济技术研究院,北京,100052【正文语种】中文【中图分类】F426合理预测电力需求对于制定电力规划、电力建设具有重要意义。
空间数据挖掘算法及预测模型

空间数据挖掘算法及预测模型一、引言空间数据挖掘算法及预测模型是地理信息系统(GIS)领域的重要研究方向。
随着遥感技术的发展和传感器网络的普及,获取了大量的空间数据,如地理位置信息、气象数据、人口统计数据等。
这些数据在城市规划、环境监测、交通管理等方面起着重要的作用。
本文将介绍空间数据挖掘算法及预测模型的基本概念、常见方法和应用案例。
二、空间数据挖掘算法1. 空间数据挖掘概述空间数据挖掘是从空间数据库中发现特定模式和关系的过程。
它可以帮助我们理解地理空间中的变化和关联性。
空间数据挖掘算法可以分为聚类、分类、关联规则挖掘等多个方面。
2. 空间数据聚类算法空间数据聚类是将相似的空间对象归类到同一组或簇中的过程。
常见的聚类算法有基于密度的聚类算法(如DBSCAN)、基于网格的聚类算法(如STING)、基于层次的聚类算法等。
这些算法可以帮助快速识别出地理空间中的热点区域、异常值等。
3. 空间数据分类算法空间数据分类是根据不同的属性和特征将地理空间对象进行分类的过程。
常用的分类算法有决策树、支持向量机(SVM)、人工神经网络等。
通过使用这些算法,可以对地理空间对象进行自动分类和识别,如土地利用类型、植被覆盖类型等。
4. 空间数据关联规则挖掘算法空间数据关联规则挖掘是在地理空间中发现不同空间对象之间的相关性和关联关系。
常见的关联规则挖掘算法有Apriori、FP-growth等。
这些算法可以帮助我们发现地理空间中的相关性模式,如犯罪与社会经济因素之间的关系。
三、空间数据预测模型1. 空间数据模型概述空间数据模型是对地理空间对象进行描述和建模的一种方法。
常见的空间数据模型有基于图的数据模型、基于栅格的数据模型、基于矢量的数据模型等。
这些模型可以帮助我们对地理空间中的实体和属性进行建模和分析。
2. 空间数据预测模型空间数据预测模型是基于历史数据和现有数据对未来空间情况进行预测的一种方法。
常见的空间数据预测模型有回归分析、时间序列分析、人工神经网络等。
基于支持向量机的股市时间序列预测算法

只能进行一步预测。多步预测是指 , 如果样本数量
为 Ⅳ, 在不能得到新的数据点时, 除了可以预测第 』 v
摘 要
针对股市时间序列预测 的特点 , 出 了 于 S M 的股 市 时间序 列预测算 法。设 计 了 S M 的在 线训练 算法 , 提 基 V V 并设计
了遗传算法 自动调整 S M 的核 参数, V 实现 了基于 S M 的股市 时间序 列预测算 法在线调整 的完全智 能化。通过 实证分析 , V 以 及 同B P神经网络方 法的比较 , 结果证 明该算法具有预测精度高 、 参数调整智能化等优点。
统 演化 的 动力 学 行 为 可 由此 空 问 中点 的演 化 轨 迹 无歧 义 地 表 达 出 来 。这 个 由 观 测 值 及 其 延 时值 所 构 成 的空 问称 为 重构 相 空 间 , 种 由一维 数 据 构 造 这 系 统等 价 相 空 间 的 方 法 就 叫做 相 空 间 重 构 技 术 。
思想 , 采用 以结 构风 险最小化 为准则 的支持 向量 机 (V 为核心算法 , S M) 提出基于 S M 的股市 时问 V
序 列预 测 算 法 。首 先 分 析 了股 市 时 间 序 列 预 测 的
具体特点 , 出了解决 股市时 间序列 预测 的不适 提
定 性 的方 法 和 对 股 市 预 测 期 限进 行 度 量 的方 法 。 然 后 运用 动 力 学 重 建 思 想 , 重 构 的 股 市 数 据 输 将 入 S M, 过 机 器 自学 习 挖 掘 出 股 市 规 律 。考 虑 V 通 到 股市 的在 线 预 测 问题 , 文 设 计 了 S M 的在 线 本 V 训 练算 法 。考虑 到 S M 的模 型 参 数 ( 函数 的参 V 核
基于Kriging模型的自适应多阶段并行代理优化算法

第27卷第11期2021年11月计算机集成制造系统Vol.27No.11 Computer Integrated Manufacturing Systems Nov.2021DOI:10.13196/j.cims.2021.11.016基于Kriging模型的自适应多阶段并行代理优化算法乐春宇,马义中+(南京理工大学经济管理学院,江苏南京210094)摘要:为了充分利用计算资源,减少迭代次数,提出一种可以批量加点的代理优化算法。
该算法分别采用期望改进准则和WB2(Watson and Barnes)准则探索存在的最优解并开发已存在最优解的区域,利用可行性概率和多目标优化框架刻画约束边界。
在探索和开发阶段,设计了两种对应的多点填充算法,并根据新样本点和已知样本点的距离关系,设计了两个阶段的自适应切换策略。
通过3个不同类型算例和一个工程实例验证算法性能,结果表明,该算法收敛更快,其结果具有较好的精确性和稳健性。
关键词:Kriging模型;代理优化;加点准则;可行性概率;多点填充中图分类号:O212.6文献标识码:AParallel surrogate-based optimization algorithm based on Kriging model usingadaptive multi-phases strategyYUE Chunyu,MA Yizhong+(School o£Economics and Management,Nanjing University of Science and Technology,Nanjing210094,China) Abstract:To make full use of computing resources and reduce the number of iterations,a surrogate-based optimization algorithm which could add batch points was proposed.To explore the optimum solution and to exploit its area, the expected improvement and the WB2criterion were used correspondingly.The constraint boundary was characterized by using the probability of feasibility and the multi-objective optimization framework.Two corresponding multi-points infilling algorithms were designed in the exploration and exploitation phases and an adaptive switching strategy for this two phases was designed according to the distance between new sample points and known sample points.The performance of the algorithm was verified by three different types of numerical and one engineering benchmarks.The results showed that the proposed algorithm was more efficient in convergence and the solution was more precise and robust.Keywords:Kriging model;surrogate-based optimization;infill sampling criteria;probabil让y of feasibility;multipoints infill0引言现代工程优化设计中,常采用高精度仿真模型获取数据,如有限元分析和流体动力学等E,如何在优化过程中尽可能少地调用高精度仿真模型,以提高优化效率,显得尤为重要。
基于粗糙集理论和最小二乘支持向量机的中长期负荷预测
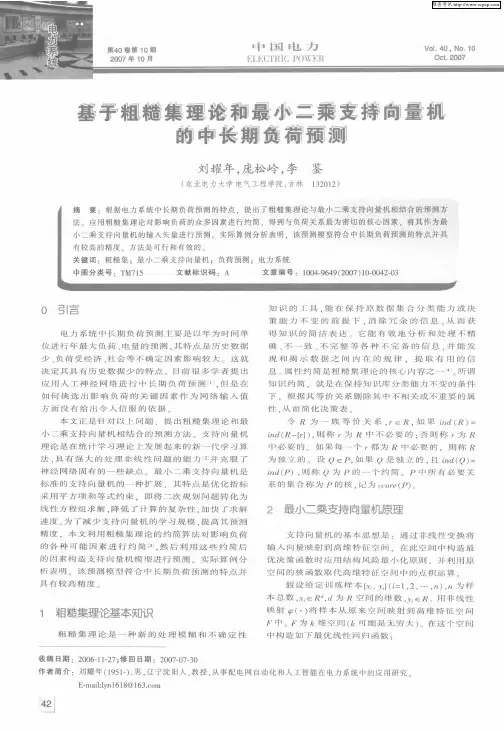
3 基于粗糙集理论和支持向量机 的预测方法
首 先 应 用 粗 糙 集 理 论 的 等 价 关 系 对 影 响 负 荷 的 可 能 的 因 素 进 行 属 性 约 简 分 析 . 去 除 冗 余 属 性 得 到 影 响 负 荷 的 决 定 性 因 素 .然 后 对 这 些 因 素 构 造 支 持 向 量 机 模 型 进 行 负 荷 预 测 。采 用 粗 糙 集 理 论 中 的 等 距 离 散 化 方 法 进 行 数 据 离 散 化 处 理 . 再 利 用 支 持 向 量 机 进 行 预 测 , 函 数 和 参 数 的 选 取 非 常 重 要 本 文 核 所 采 用 的 核 函 数 为 RBF 函 数 :
sIii ・(- 占 L xY f )≤
y- ( i≤ 占 i X) f
‘2, ,n …’
式 中 : 为 函数 拟 和 精 度 , 占 占≥ 0; 、 为 松 弛 因 子 , 均 大 于 等 于 0: C为 惩 罚 参 数 , > 控 制 对 超 出 误 差 c 0,
占的 样 本 的 惩 罚 程 度 。
年 人,k( I, 荷 份 ¨(.. I….k …万h值”- … 历 历 用 I 、W 元) uW产 端 电人 八 量 一 : 负 :, )
年份 X  ̄ GP D
兀
/
/
I
最 小 二 乘 支 持 向 量 机 优 化 目 标 采 用 : 平 方 的
项 . 优 化 问题 为: 故
维普资讯
维普资讯
_ ) , =
( + ) 6
( ) 1
为 样 本 数 据 . 对 该 地 区 2 0 - 2 0 年 的 负 荷 及 电 04 05
量进 行 预测 。
式 中 : 为 权 向 量 , ∈R ; 为 常 数 , b b∈R 。
区域物流需求建模与预测仿真
向量机提高 了区域物流需求 的预测精度 , 区域需要预测 中具有广泛的应用前景 。 在
关键词 : 支持 向量机 ; 蚁群算法 ; 影响 因子 ; 区域需求
中 图分 类 号 : 13 F 8 文 献标 识 码 : B
Re i na g s i s De a o ln n Fo e a tSi u a i n g o lLo itc m nd M de i g a d r c s m l to
AB T AC S R T:S d eo t i t npolm fe oa lg t s e n rcs h ae u f w r alg — t yt pi z i rbe so g n lo s c dmadf eat ep pr t o a i u h m ao ri i i o .T p r d os
求预测 的准确 性 , 具有 十分 现实的意义 。
果 的准确性难 以满足实 际需 的要求 J 世纪 8 年代 。上 0
以来 , 非线性 、 自组织和 自学 习的神 经 网络算 法不断 成熟 , 可
以任意非线性 函数进行逼近 和拟合非 线性 系统 , 为区域物 流 需求的预测研究开拓 了新 的空间 , 而神 经 网络 是基于经 验 然
目前 , 国内外 学 者对 区域物 流 需求 预 测 进行 了大 量研
风险最小化原则和大数定理 的机器 学习方 法 , 求数据样 本 要
收稿 日期 :0 1— 7— 3 修回 日期 :0 2— 3— 9 21 0 2 21 0 0
大 , 区域经 济发展 刚起步 , 得历史 数据 属 于典型 小样 本 但 获
领 域 。
束优化 问题 转变为无 约束对偶空间优化 问题 , : 即
L , , =1 + ∑ ∑ () (6 了 w , ) ÷c + ( X 一 i
基于支持向量机的中长期电力负荷组合预测
2 Na c o g P we u p y Co a y,Na c o g 6 7 0 ,Ch n ) . n h n o rS p l mp n n h n 3 0 0 ia
Ab t a t s r c :A fe t d by m a a t r fc e ny f c o s,t i l he m d—ong t m o d f e a tn l n a ife fonl i l er l a or c s i g wil otbe s ts id i y a sng e met od s d t d. Com biato f r c s i g h i a op e n in o e a tn mod lc n e us d o s l e he r blm , bu i s i ie b e a b e t o v t p o e t t i lm t d y
XI AO a — o g ,GE Ja ,HE De s e g Xin y n i —h n
( . c oo fEl c rc lEn n e i nd I or a i n ,S c 1 S h lo e t ia gi e rng a nf m to ihua n v r iy, n U i e st Che du 6 0 5,Ch na; ng 1 06 i
7 9 , 有 良好 的可 行 性 和有 效 性 。 1 具
关键 词 :中长 期 负 荷 ;组 合预 测 ;结构 风 险 最 小 化 ; 小 二乘 支持 向量 机 ; 测 风 险 最 预
中 图分 类 号 : M7 5 T 1 文献标志码: A 文 章 编 号 : 0 3 8 3 ( 0 8 0 - 0 4 0 1 0 — 9 0 2 0 ) 10 8 — 5
基于遗传算法参数优化的最小二乘支持向量机财务困境预测
基于遗传算法参数优化的最小二乘支持向量机财务困境预测作者:赵冠华李玥赵娟来源:《科学与管理》2011年第05期摘要:传统支持向量机应用于财务困境预测时,需要求解复杂的二次规划问题,求解难度大。
而最小二乘支持向量机模型可以将二次规划问题变成一个线性方程组来求解,有效降低了模型求解的难度。
尤其是将遗传算法应用于最小二乘支持向量机模型参数和核参数的优化时,显著提高了模型预测的正确率。
本文从沪深两市随机抽取了2002年-2007年252家A股上市公司作为研究样本,并把研究样本分为两组,对这两组样本数据分别进行了短期及中长期预测。
实证结果表明,基于遗传算法的最小二乘支持向量机模型的预测效果不但好于传统统计类Logit模型,也优于传统支持向量机模型。
短期预测效果显著优于中长期预测效果,训练样本数直接影响到模型的预测效果,二者呈正相关关系。
关键词:遗传算法;最小二乘支持向量机;参数优化;短期预测;中长期预测1、引言随着我国市场经济体制改革的进一步深化和全球经济一体化的加快,尤其是全球金融危机带来的巨大冲击,加之我国经济发展中存在的诸多矛盾,使得我国企业面临着巨大的财务风险。
在这种激烈的竞争环境中,如何协助企业及时、有效地规避和分散财务风险,就成了理论界和实务界探讨的热点问题。
为了能对企业未来的财务状况及时做出预测,各国学者运用不同的预测变量、采用各种数学工具和方法,建立了大量的财务预警模型。
早期的财务困境预测模型主要是传统统计类预测模型,代表性成果主要有:Fitzpatrick[1]、Beaver[2]的一元判别分析模型;Altman[3]的多元判别分析模型;Ohlson[4]的Logit回归模型;Theodossiou[5]的累积求和模型。
近年来,随着计算机技术和人工智能的发展,出现了一些新兴的人工智能型财务预警模型,代表性成果主要有:Odom[6]、Coats & Fant[7]、Charalambous etc.[8]以及国内学者杨淑娥[9]的人工神经网络模型;Varetto Franco[10]、Shin & Lee[11]的遗传算法模型;Franeis EH[12]、Dimitras AI[13]的粗集理论模型。
基于机器学习算法的时间序列预测研究
基于机器学习算法的时间序列预测研究随着人们对数据的需求不断增加,机器学习技术受到了越来越多的关注。
其中,基于机器学习算法的时间序列预测也成为了十分热门的研究方向。
本文将对其进行一定的探讨和阐述。
一、时间序列预测的背景与意义时间序列是指按时间顺序排列的一组观测值,它们之间存在着某种依赖或相关性。
时间序列分析与预测是一种常见的统计分析方法,它可以将历史数据作为依据,预测未来的数据变化趋势。
时间序列预测技术可以应用于经济、自然科学、社会科学等领域,能够帮助人们更好地了解事物的发展规律和趋势。
此外,在商业决策、市场营销和金融投资等领域,时间序列预测也具有重要的作用。
二、基于机器学习算法的时间序列预测研究方法传统的时间序列预测方法通常采用的是统计模型或者模拟模型,比如ARIMA、VAR、GARCH等。
虽然这些方法具有较高的精度和可解释性,但是它们往往需要对数据分布和参数设定进行假设,而这些假设未必与真实数据完全一致。
并且,在数据处理方面也面临着挑战,因为时间序列数据往往包含着噪声与季节性,存在不可预见的波动。
相比而言,基于机器学习算法的时间序列预测方法则不需要对数据分布和参数做明确的假设,随着数据量的增加,它们可以不断学习和优化预测模型。
因此,机器学习算法的时间序列预测方法具有更灵活的性能,能够更好地处理时间序列数据中的噪声和波动。
常见的基于机器学习算法的时间序列预测方法包括:回归分析、神经网络、支持向量机、决策树等。
下面将介绍其中几种具有代表性的方法。
1.回归分析回归分析是一种常用的机器学习算法,它通过分析历史数据的相关关系,来建立预测模型。
时间序列预测中的回归分析通常采用线性回归、多元回归等方法。
这些方法可以对变量之间的线性关系进行建模,并且可以通过回归系数来衡量变量之间的影响程度。
不过,在时间序列预测中,回归分析可能会出现过拟合和欠拟合的情况,需要进行适当的优化。
2.神经网络神经网络是一种模仿大脑神经元连接方式的计算模型。
基于机器学习的金融数据分析研究
基于机器学习的金融数据分析研究摘要:随着互联网技术和信息技术的迅速发展,在互联网金融的大背景下,金融数据处理问题已经不仅仅局限于传统的数理统计方法,而更多的与机器学习领域的各种信息处理方法相结合,并取得了一些有重要意义的研究成果。
本文将主要研究机器学习中的支持向量回归算法和时间序列模型用于建立预测模型的绩效问题,也就是针对金融数据分析和预测准确度的问题。
关键词:机器学习;支持向量机;金融数据项目简介:2015 年保定市科技局研究项目“基于机器学习的金融数据分析研究” ,课题编号:15ZG026、金融数据分析的背景及意义长期以来专家学者们都希望能够找到使误差更接近零的分析预测方法,以使投资目标函数在利益尽量大的时候风险尽量最小。
所以,人们不得不努力的研究更新、更有效、泛化能力更强的数据分析预测模型。
当前的金融市场业务繁多,和业务形成正比关系的各类信息系统众多,这些管理系统也产生海量的各类金融数据,如何对金融市场进行有效地、及时地预测与分析,则成为企业、银行和现代投资者所追求的目标。
现代投资者不再仅仅关注于股票的基本面信息,而是更多的需要深层次的挖掘大规模金融数据内在的联系,从而获取更多的信息。
在现实的金融市场中,普通的投资者很难掌握市场的全部有效信息,所以他们迫切的需要从可以得到的各类相关数据中挖掘出金融市场潜在的信息。
然而现行的大量分析方法并不能对已有的数据进行大规模的开发和利用,所以并不能满足金融市场投资者的需求。
投资者的这种迫切的需要将金融数据与机器学习的方法紧密联系在起。
金融市场由于其所包含的不可测因素非常多,所以我们可以将其看作是一个非线性的、非结构化的复杂系统。
而机器学习方法作为智能信息处理的重要组成部分,在其他领域已经被证明可以有效地解决这种非线性问题。
二、最小二乘支持向量回归算法最小二乘支持向量算法 (LSSVM )是将标准支持向量算法中的不等式约束化成等式约束而得到的。
对于线性回归,设样本为n 维向量,某区域的l 个样本及其值表示为:对于非线性回归,同样使用一个映射$把数据映射到高维特征空间,再在高维特征空间进行线性回归,关键是选取适当的核函数k (x, y),使得对于AR(n)模型来说,Xt仅仅与Xt-1, Xt-2, , Xt-n,有n阶动态性,因此拟合AR (n)模型的过程就是使相关序列独立化的过程。