
基于R的群落学多元统计分析
《多元统计分析及R语言》第2章多元数据的数学表达
5 - 16
饼图: 分析单变量分布特征 pie(table(结果))
5 - 17
(2)两因素分析
条形图:分析单变量分布特征 data=read.table("clipboard",header=T) table(年龄,性别) #二维列联表 barplot(table(年龄,性别),beside=T, col=1:7)
所在包 base base base base base base base base base
base
base
base base base base
2.4 数据的R语言表示-数据框
数据框:是一种矩阵形式的数据,但数据框中各列可 以是不同类型的数据。
地区 A A A B B A D
性别(X1) 教育程度(X2) 观点(X3)
t diag solve
eigen
chol
svd qr kronecker dim
用途 向量生成函数 向量长度函数 对象类型函数 行合并函数 列合并函数 矩阵生成函数 矩阵转置函数 对角阵生成函数 逆矩阵计算函数
矩阵的特征值与特征向量函数
进行Choleskey分解
进行奇异值分解 进行QR分解 kronecker积计算函数 矩阵维数
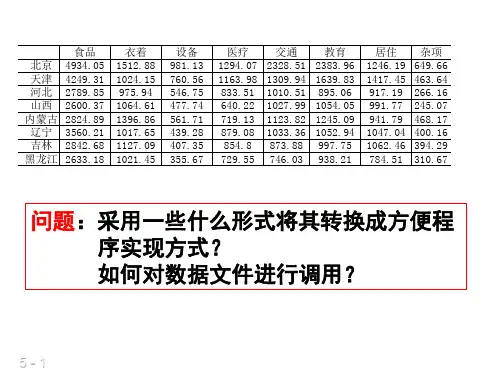
设备 981.13 760.56 546.75 477.74 561.71 439.28 407.35 355.67
医疗 1294.07 1163.98 833.51 640.22 719.13 879.08
854.8 729.55
交通 2328.51 1309.94 1010.51 1027.99 1123.82 1033.36 873.88 746.03
R-多元统计分析上机讲义

应用多元统计分析R实验上机讲义应用多元统计分析 (4)Applied Multivariate Statistical Analysis (4)第一章绪论 (4)第二章矩阵 (4)2.1矩阵的建立 (4)2.2矩阵的下标(index)与子集(元素)的提取 (6)2.3 矩阵四则运算 (7)2.3.1 矩阵的加减运算 (7)2.3.2 矩阵的相乘 (8)2.3.3 矩阵的求逆 (8)2.4矩阵的其他一些代数运算 (8)2.4.1 求转置矩阵 (8)2.4.2 提取对角元素 (8)2.4.3矩阵的合并与拉直 (8)2.4.4方阵的行列式 (9)2.4.5 矩阵的特征根和特征向量 (9)2.4.6 其它函数 (9)2.5 矩阵的统计运算 (11)2.5.1 求均值 (11)2.5.2 标准化 (11)2.5.3 减去中位数 (11)第三章多元正态分布及参数的估计 (12)3.1 绘制二元正态密度函数及其相应等高线图 (12)3.2 多元正态分布的参数估计 (14)3.2.1 多元正态总体的相关量 (14)3.2.2 极大似然估计 (14)第四章多元正态总体参数的假设检验 (15)4.1 几个重要统计量的分布 (15)4.2 单总体均值向量的检验及置信域 (16)4.2.1均值向量的检验 (16)4.2.2样本协方差阵的特征值和特征向量 (17)4.3多总体均值向量的检验 (17)4.3.1 两正态总体均值向量的检验 (17)4.3.2 多个正态总体均值向量的检验-多元方差分析 (19)4.4协方差阵的检验 (20)4.4.2 多总体协方差阵的检验 (20)4.5独立性检验 (20)4.6正态性检验 (21)第五章判别分析 (22)5.1距离判别 (22)5.1.1 马氏距离 (22)5.1.2 两总体的距离判别 (22)5.1.3 多个总体的距离判别 (26)5.2贝叶斯判别法及广义平方距离判别法 (26)5.2.1 先验概率(先知知识) (26)5.2.2 广义平方距离 (26)5.2.3 后验概率(条件概率) (27)5.2.4 贝叶斯判别准则 (27)5.3费希尔(Fisher)判别 (29)第六章聚类分析 (30)6.2距离和相似系数 (30)6.2.1距离 (31)6.2.2数据中心化与标准化变换 (31)6.2.3相似系数 (31)6.3 系统聚类法 (31)6.4类个数的确定 (34)6.5动态聚类法 (36)6.7变量聚类方法 (36)第七章主成分分析 (37)7.2 样本的主成分 (38)7.3 主成分分析的应用 (39)第八章因子分析 (42)8.3 参数估计方法 (42)8.4 方差最大的正交旋转 (45)8.5 因子得分 (45)第九章对应分析方法 (46)第十章典型相关分析 (48)应用多元统计分析Applied Multivariate Statistical Analysis第一章绪论在实际问题中,很多随机现象涉及到的变量不是一个,而是经常是多个变量,并且这些变量间又存在一定的联系。
【原创】R语言 多元统计分析介绍数据分析数据挖掘案例报告(附代码

#第十章多元统计分析介绍#10.1 主成分分析与因子分析#10.1.1 主成分的简要定义与计算#10.1.2 主成分R 通用程序student<-data.frame(X1=c(148, 139, 160, 149, 159, 142, 153, 150, 151, 139, 140, 161, 158, 140, 137, 152, 149, 145, 160, 156,151, 147, 157, 147, 157, 151, 144, 141, 139, 148),X2=c(41, 34, 49, 36, 45, 31, 43, 43, 42, 31,29, 47, 49, 33, 31, 35, 47, 35, 47, 44,42, 38, 39, 30, 48, 36, 36, 30, 32, 38),X3=c(72, 71, 77, 67, 80, 66, 76, 77, 77, 68,64, 78, 78, 67, 66, 73, 82, 70, 74, 78,73, 73, 68, 65, 80, 74, 68, 67, 68, 70),X4=c(78, 76, 86, 79, 86, 76, 83, 79, 80, 74,74, 84, 83, 77, 73, 79, 79, 77, 87, 85,82, 78, 80, 75, 88, 80, 76, 76, 73, 78))student.pr<-princomp(student, cor=TRUE)summary(student.pr,loadings=TRUE)#10.1.3 因子分析的简要定义与计算#10.1.4 因子分析R 通用程序student<-read.table("e:/data/student.txt")names(student)=c("math", "phi", "chem", "lit", "his", "eng") fa<-factanal(student, factors=2)fa#10.2 判别分析#10.2.1 距离判别#10.2.2 Fisher 判别法#10.2.3 R 通用程序library(MASS)data(iris)attach(iris)names(iris)library(MASS)iris.lda <- lda(Species ~ Sepal.Length + Sepal.Width+ Petal.Length + Petal.Width)【原创】定制代写开发r/python/spss/matlab/WEKA/sas/sql/C++/stata/eviews数据挖掘和统计分析可视化调研报告程序等服务(附代码数据),咨询:3025393450@有问题到淘宝找“大数据部落”就可以了iris.ldairis.pred=predict(iris.lda) $ classtable(iris.pred, Species)detach(iris)w <- read.table("e:/data/disc.txt")names(w)=c("group", "x1", "x2", "x3", "x4")library(MASS)z <- lda(group~x1+x2+x3+x4, data=w, prior=c(1, 1)/2) newdata<-rbind(c(8.85, 3.38, 5.17, 26.10), c(28.60, 2.40, 1.20, 127.0),c(20.70, 6.70, 7.60, 30.20), c(7.90, 2.40, 4.30, 33.20),c(3.19, 3.20, 1.43, 9.90), c(12.40, 5.10, 4.43, 24.60),c(16.80, 3.40, 2.31, 31.30), c(15.00, 2.70, 5.02, 64.00)) dimnames(newdata)<-list(NULL, c("x1", "x2", "x3", "x4")) newdata<-data.frame(newdata)predict(z, newdata=newdata)#10.3 聚类分析#10.3.1 基本思想#10.3.2 R通用程序x<-c(1, 2, 4.5, 6, 8)dim(x)<-c(5, 1)d<-dist(x)hc1<-hclust(d, "single")hc2<-hclust(d, "complete")hc3<-hclust(d, "median")hc4<-hclust(d, "ward")opar<-par(mfrow=c(2, 2))plot(hc1, hang=-1);plot(hc2, hang=-1)plot(hc3, hang=-1);plot(hc4, hang=-1)par(opar)data(iris);attach(iris)iris.hc<-hclust(dist(iris[,1:4]))plot(iris.hc, hang = -1)plclust(iris.hc,labels = FALSE, hang=-1)re<-rect.hclust(iris.hc,k=3)iris.id <- cutree(iris.hc,3)table(iris.id,Species)#10.4 典型相关分析#10.4.1 基本思想#10.4.2 R通用程序invest=read.table("e:/data/invest.txt")names(invest)=c("x1", "x2", "x3", "x4", "x5", "x6", "y1", "y2", "y3", "y4", "y5")ca<-cancor(invest[, 1:6], invest[, 7:11])ca#x10.5 对应分析#10.5.1 基本思想#10.5.2 R通用程序x.df=data.frame(HighlyFor=c(2, 6, 41, 72, 24), For =c(17, 65, 220, 224, 61),Against=c(17, 79, 327, 503, 300), HighlyAgainst=c(5, 6, 48, 47, 41))rownames(x.df)<-c("BelowPrimary", "Primary", "Secondary", "HighSchool","College")library(MASS)biplot(corresp(x.df, nf=2))。
多元统计分析及R语言建模课件13综合评价方法及R使用
3 多元数据直观表示及R使用
几乎所有的综合性活动都可以进行综合评价,而且不能只
说 明
考虑被评价对象的某一个方面,而必须全面地从整体的角度对
与 被评价对象进行评价。
举
例
【例 3-1】为了研究广东省21地区专利发展情况进行综
合分析。
3 多元数据直观表示及R使用
➢系统全面性原则 ➢稳定可比性原则 ➢简明科学性原则 ➢灵活可操作性原则
3 多元数据直观表示及R使用
CI_CR(B1) #一致性检验
计算综合得分
S_rank(B1_z,B1_W) #按B1得到综合得分及 排名
3 多元数据直观表示及R使用
3 多元数据直观表示及R使用
对 每 个 判 断 矩 阵 分 别 调 用 CI_CR 函 数 ,
可以检验其一致性和得到各个指标的权 完
3 多元数据直观表示及R使用
评 价 指 标 体 系 的 选 取
广 东 省 专 利 综 合 评 价 指 标 体 系
3 多元数据直观表示及R使用
➢ 有量纲指标评价方法 选择评价指标 确定评价标准和记分方法 综合评判结果
3 多元数据直观表示及R使用
➢ 无量纲指标评价方法
标准化变换方法 规格化变换方法 功效系数变换方法 指数化变换方法
3 多元数据直观表示及R使用
Si=apply(B1_z,1,mean) #按行求均值 cbind(B1_z,Si)
cbind(Si=Si,ri=rank(-Si)) #按Si值高低排 名
3 多元数据直观表示及R使用专利申来自与授权量的判断矩阵程序如下
$B1=c(1,4,5,3,6,7,1/4,1,2,1/2,3,4,1/5,1/ 2,1,1/3,2,3,1/3,2,3,1,4,5,1/6,1/3,1/2,1/4 ,1,2,1/7,1/4,1/3,1/5,1/2,1) #构造B1的判 断矩阵 B1_W=weight(B1) #B1的权重 B1_W
R语言版应用多元统计分析判别分析

应用多元统计分析第4章 判别分析- 1-•判别分析是用于判断样品所属类型的一种统计方法。
•判别分析方法处理的问题看起来与聚类分析方法有些类似,似乎都是要将观察值进行分类,但是它们的使用前提是不同的。
•判别分析是根据某些指标的已有数据(或称为训练样本)对所研究的对象建立判别函数,并进行分类的一种多变量分析方法,也称之为“有监督的分类方法”。
•进行判别归类时,由假设前提、判别依据及处理手法的不同可采用不同的判别方法。
如距离判别、贝叶斯(Bayes)判别、费希尔(Fisher)判别等。
概念和方法l判别分析概念l判别分析方法是在已知的分类之下,对新的样品,利用某判别准则,来判定其属于哪个类。
判别分析(Discriminat Analysis)是多元分析中用于判别样品所属类型的一种统计分析方法。
主要内容判别分析的目的和意义几种判别分析方法和性质包括:距离判别法、Bayes判别法、Fisher判别法R语言程序中有关判别分析的算法4•定义4.1设 是从均值向量为 ,协方差阵为 的总体G 中抽取的两个样品,则 与 之间的马氏距离定义为•样品 与总体G 之间的马氏距离为•两总体的距离判别•设总体 和 的均值向量分别为 和 ,协方差阵分别为 和 ,x 是一个新样品,现在要判断x 来自哪一个总体。
可计算x 到两个总体的马氏距离的平方 和 ,并按照下列进行判别• 当两个总体的方差相等,即 时,该判别准则可以进行简化。
• 1. 当 时的线性判别•此时•其中 是两个总体均值的平均值。
令••其中 ,则 。
因此判别准则可简化为:其中称 为判别函数,由于它是 的线性函数,故又称它为线性判别函数。
•在实际中,总体的均值向量 和协方差阵 一般都是未知的,此时可用样本均值向量 和样本协方差阵 来代替。
设 是来自总体 的样品, 是来自总体 的样品,则样品均值向量和样品离差阵为• 的由两个总体样品构成的无偏估计为• 2. 当 时的非线性判别•此时判别函数为 与 之差,即•由于这个 是x 的二次函数,故又称它为二次判别函数或非线性判别函数。
基于R的统计分析与数据挖掘ppt课件

向量转换为因子:因子是一种特殊形式的向 量。由于一个向量可视为一个变量,如果该 变量的计量类型为分类型,则将对应的向量 转换为因子,这样更利于后续的数据分析。 基本书写格式为: as.factor(向量名)
精品课件
示例:
数据合并
精品课件
数据排序
数据排序不仅便于数据浏览,更有助于快速 找到数据中可能存在的错误数据、异常数据 等。可按单个变量取值的升序或降序排序数 据,称为单变量排序。也可依据多个变量进 行多重排序。实现数据排序的函数是order 函数,基本书写格式为: order(向量名列表, st = TRUE/FALSE/NA, decreasing =TRUE/ FALSE)
精品课件
从文本文件读数据
可利用scan函数将文本数据读入到向量中, 基本书写格式为: scan(file=”文件名”,skip=行数 ,what=存储类型转换函数())
可利用read.table函数将文本数据读入到数 据框中,基本书写格式为: read.table(file="文件名", header = TRUE/FALSE, sep="数据分隔符")
精品课件
如何获得的R帮助文档
help.start()
精品课件
函数和包的拓展使用
若要调用尚未加载的包中的函数,需按照 “先加载,后浏览,再调用”的步骤实现
先加载:首先,将未加载的包加载到R的工 作空间,调用的函数为:library(“包名称 ”)
后浏览:然后,浏览包中提供的函数,调用 的函数为:library(help=”包名称”)
R语言中的多元统计之判别分析报告
前言判别分析(discriminant analysis)是多元统计分析中较为成熟的一种分类方法,它的核心思想是“分类与判断”,即根据已知类别的样本所提供的信息,总结出分类的规律性,并建立好判别公式和判别准则,在此基础上,新的样本点将按照此准则判断其所属类型。
例如,根据一年甚至更长时间的每天的湿度差及压差,我们可以建立一个用于判别是否会下雨的模型,当我们获取到某一天(建立模型以外的数据)的湿度差及压差后,使用已建立好的模型,就可以得出这一天是否会下雨的判断。
根据判别的组数来区分,判别分析可以分为两组判别和多组判别。
接下来,我们将学习三种常见的判别分析方法,分别是:•距离判别•Bayes判别•Fisher判别一、距离判别基本理论假设存在两个总体和,另有为一个维的样本值,计算得到该样本到两个总体的距离和,如果大于,则认为样本属于总体,反之样本则属于总体;若等于,则该样本待判。
这就是距离判别法的基本思想。
在距离判别法中,最核心的问题在于距离的计算,一般情况下我们最常用的是欧式距离,但由于该方法在计算多个总体之间的距离时并不考虑方差的影响,而马氏距离不受指标量纲及指标间相关性的影响,弥补了欧式距离在这方面的缺点,其计算公式如下:,为总体之间的协方差矩阵二、距离判别的R实现(训练样本)首先我们导入数据# 读取SAS数据> library(sas7bdat)> data1 <- read.sas7bdat('disl01.sas7bdat')# 截取所需列数据,用于计算马氏距离> testdata <- data1[2:5]> head(testdata,3)X1 X2 X3 X41 -0.45 -0.41 1.09 0.452 -0.56 -0.31 1.51 0.163 0.06 0.02 1.01 0.40# 计算列均值> colM <- colMeans(testdata)> colMX1 X2 X3 X4 0.096304348 -0.006956522 2.033478261 0.431739130 # 计算矩阵的协方差> cov_test <- cov(testdata)> cov_testX1 X2 X3 X4 X1 0.068183816 0.027767053 0.14996870 -0.002566763 X2 0.027767053 0.015363865 0.05878251 0.001252367X3 0.149968696 0.058782512 1.01309874 0.028607150X4 -0.002566763 0.001252367 0.02860715 0.033912464# 样本的马氏距离计算> distance <- mahalanobis(testdata,colM,cov_test)> head(distance,5)[1] 12.726465 11.224681 1.692702 1.347885 2.369820这样,我们得到了距离判别中最关键的马氏距离值,在此基础上就可以进行进一步的判别分析了。
R语言版应用多元统计分析对应分析
应用多元统计分析第8章 对应分析- 1-对应分析(Correspondence Analysis)是在因子分析的基础上发展起来的一种视觉化的数据分析方法,目的是通过定位点图直观地揭示样品和变量之间的内在联系。
R型因子分析是对变量(指标)进行因子分析,研究的是变量之间的相互关系;Q型因子分析是对样品作因子分析,研究的是样品之间的相互关系。
但无论是R型或Q型分析都不能很好地揭示变量和样品之间的双重关系。
而在许多领域错综复杂的多维数据分析中,经常需要同时考虑三种关系,即变量之间的关系、样品之间的关系以及变量与样品之间的交互关系。
法国学者苯参次(J.P.Benzecri)于1970年提出了对应分析方法,这个方法对原始数据采用适当的标度化处理,把R型和Q型分析结合起来,通过R型因子分析直接得到Q型因子分析的结果,同时把变量和样品反映到同一因子平面上,从而揭示所研究的样品和变量之间的内在联系。
在因子分析中,R型因子分析和Q型因子分析都是从分析观测数据矩阵出发的,它们是反映一个整体的不同侧面,因而它们之间一定存在内在联系。
对应分析就是通过某种特定的标准化变换后得到的对应变换矩阵Z将两者有机地结合起来。
具体地,就是首先给出变量的R型因子分析的协方差阵 和样品的Q型因子分析的协方差阵 。
由于矩阵 和 有相同的非零特征值,记为 ,如果 的对应于特征值 的标准化特征向量为 ,则容易证明, 的对应于同一特征值的标准化特征向量为当样本容量n很大时,直接计算矩阵 的特征向量会占用相当大的容量,也会大大降低计算速度。
利用上面关系式,很容易从 的特征向量得到 的特征向量。
并且由 的特征值和特征向量即可得到R 型因子分析的因子载荷阵A和Q型因子分析的因子载荷阵B,即有由于 和 具有相同的非零特征值,而这些特征值又是各个公因子的方差,因此设有p个变量的n个样品观测矩阵 ,这里要求所有元素 ,否则对所有数据同时加上一个适当的正数,以使它们满足以上要求。
多元统计方法的R语言实现
主成分分析的psych包函数
(1)fa.parallel(x, fa=“pc”, main=“”) ####作碎石图以确定主成分个数 (2)principal(x, nfactors= , scores= ) (3)factor.plot(pr)
结语多元统计分析方法在各行各业的应用非常之多大家可以课后搜集一些资源多看看各行各业的报告文章等看看我们课堂学到的理论知识在现实世界中具体是如何用的这样既能加深对理论的理解又能增强我们的实战能力
兰州大学 王定
1、判别分析 2、聚类分析
3、主成分分析 4、因子分析
对样本进行分类
通过提取公共部分 对变量进行降维
####主成分分析(默认相关阵)
####变量数据关于主成分散点图
4、因子分析
简要介绍: 因子分析是主成分分 析的推广和发展。它研究 相关阵或者协方差阵的内 部依赖关系,将多个变量 综合为少数几个因子,以 再现原始变量与因子之间 的相关关系。
实现方法: (1)R自带函数 (2)psych包 (3)编程(略)
分析两组变量之 间的相互关系
5、典型相关分析
目录
1、判别分析
简要介绍: 已知有多少类,且在 各类均有训练样本的前提 下,利用训练样本得到判 别函数以及判别规则,对 待测样本进行分类。 本课程只讲述距离判 别,有兴趣的朋友可以课 后研究一下其他判别方法 的R实现。
实现方法: (1)利用MASS包 里的lda( ) 函数可完 成判别分析(略) (2)利用R软件进 行编程
有关K均值聚类动态展示的包与函数
(1) amap,R2SWF,animation 画的包 ####进行K均值聚类及制作动
R语言版应用多元统计分析多元正态抽样分布
应用多元统计分析第2章 多元正态抽样分布- 1-第2章 多元正态抽样分布•在多元统计分析中,多元正态分布占有相当重要的地位。
这是因为,许多实际问题涉及到的随机向量服从正态分布或近似服从正态分布;当样本量很大时,许多统计量的极限分布往往和正态分布有关。
此外,对多元正态分布,理论与实践都比较成熟,已有一整套行之有效的统计推断方法。
•基于这些理由,我们在介绍多元统计分析的种种具体方法之前,首先介绍多元正态分布的定义、性质及多元正态分布中参数的估计问题。
多元统计分析讨论的是多变量总体。
以p个随机变量作为分量构成的向量称为p维随机向量。
如果我们同时对p个变量作一次观测,得到观测值 ,它是一个样品。
如果我们观察n次得到n 个样品品 ,而n个样品就构成一个样本。
常把n个样品排成一个n×p矩阵,称为样本数据矩阵(或样本资料阵),记为在多元统计分析理论中涉及到的向量一般都是随机向量,或是由多个随机向量构成的随机矩阵。
均值向量和协方差阵设 是一个随机向量。
称向量为随机向量X 的均值向量。
称矩阵为随机向量X 的协方差矩阵,其中 。
均值向量和协方差阵设 是另一个随机向量。
称矩阵为随机向量X 与Y 的协方差矩阵,其中均值向量和协方差阵若 为X 的协方差阵,则 称为X 的相关阵,其中若记 ,则有或均值向量和协方差阵的性质性质1.设X 和Y 是适当维数的随机向量,A和B是适当阶数的常数矩阵,则有均值向量和协方差阵的性质性质2.若X 与Y 相互独立,则 ;反之则不一定成立。
性质3.随机向量X 的协方差阵 是对称非负定矩阵。
性质4. ,其中L 为非负定矩阵,称为 的平方根矩阵,记为 ,即 。
证明 由于 ,利用实对称非负定矩阵的对角化原理,存在正交矩阵 ,使得均值向量和协方差阵的性质其中 这里 为 的特征值, 为 的与 对应的单位正交特征向量。
2.1 随机向量均值向量和协方差阵的性质性质5. ,其中A为列满秩矩阵,若 则A为非退化矩阵。