
多层神经网络MLP快速入门
a
1
目录
CONTENTE
1 神经元模型 2 感知机与多层神经网络 3 应用一:MLP分类器 4 应用二:MLP的3D可视化
a
2
神经元模型
人工神经网络(ann)是一种计算模型,启发自人类大脑处理信息的生物神 经网络。人工神经网络在语音识别、计算机视觉和自然语言理领域取得了一 系列突破,让机器学习研究和产业兴奋了起来。
然后我们看一个案例。
a
11
感知机与多层神经网络
我们通常在感知器的输出层中使用 Softmax 函数作为激活函数,以保证输出 的是概率并且相加等于 1。 Softmax 函数接收一个随机实值的分数向量,转化成多个介于 0 和 1 之间、 并且总和为1 的多个向量值。所以,在这个例子中:
概率(Pass)+概率(Fail)=1
3. 输出节点:输出节点总称为「输出层」,负责计算,并从网络向外部世界 传递信息。
在前馈网络中,信息只单向移动——从输入层开始前向移动,然后通过隐藏 层(如果有的话),再到输出层。在网络中没有循环或回路(前馈神经网络 的这个属性和递归神经网络不同,后者的节点连接构成循环)。
a
8
感知机与多层神经网络
此网络从一个 28 x 28 的手写数字图像接受 784 个数字像素值作为输入(在 输入层有对应的 784 个节点)。
后向传播:这些输出会和我们已知的、期望的输出进行比较,误差会「传播」
回上一层。该误差会被标注,权重也会被相应的「调整」。该流程重复,直
到输出误差低于制定的标准。
a
10
感知机与多层神经网络
上述算法结束后,我们就得到了一个学习过的人工神经网络,该网络被认为 是可以接受「新」输入的。 该人工神经网络可以说从几个样本(标注数据)和其错误(误差传播)中得 到了学习。
多层感知器(Multi Layer Perceptron,即 MLP)包括至少一个隐藏层(除 了一个输入层和一个输出层以外)。单层感知器只能学习线性函数,而多层 感知器也可以学习非线性函数。
a
9
感知机与多层神经网络
训练我们的多层感知器
BP算法(backpropagation),反向传播误差算法,是几种训练人工神经网 络的方法之一。这是一种监督学习方法,即通过标记的训练数据来学习(有 监督者来引导学习)。
a
7
感知机与多层神经网络
一个前馈神经网络可以包含三种节点:
1. 输入节点:输入节点从外部世界提供信息,总称为「输入层」。在输入节 点中,不进行任何的计算——仅向隐藏节点传递信息。
2. 隐藏节点:隐藏节点和外部世界没有直接联系(由此得名)。这些节点进 行计算,并将信息从输入节点传递到输出节点。隐藏节点总称为「隐藏层」。 尽管一个前馈神经网络只有一个输入层和一个输出层,但网络里可以没有也 可以有多个隐藏层。
a
3
神经元模型
还有配有权重 b(称为「偏置(bias)」或者「阈值(threshold)」) 的输入 1。
a
4
神经元模型
函数 f 是非线性的,叫做激活函数。激活函数的作用是将非线性引入神经元 的输出。因为大多数现实世界的数据都是非线性的,我们希望神经元能够 学习非线性的函数表示,所以这种应用至关重要。
每个(非线性)激活函数都接收一个数字,并进行特定、固定的数学计算 。 在实践中,可能会碰到几种激活函数: Sigmoid(S 型激活函数):输入一个实值,输出一个 0 至 1 间的值 σ(x) = 1 / (1 + exp(−x)) tanh(双曲正切函数):输入一个实值,输出一个 [-1,1] 间的值 tanh(x) = 2σ(2x) − 1 ReLU:ReLU 代表修正线性单元。输出一个实值,并设定 0 的阈值(函数 会将负值变为零)f(x) =max(0, x)
a
5
神经元模型
将上述情形抽象,就是一直沿用至今的“M-P”神经元模型。在这个模型 中,神经元收到来自n个其他神经元传递来的输入信号,这些输入信号 通过带权重(w)连接进行传递,神经元接收到的输入值将与神经元的 阈值进行比较,然后通过“激活函数”得到神经元的输出。
a
6
感知机与多层神经网络
前馈神经网络是最先发明也是最简单的人工神经网络。它包含了安排在多个层 中的多个神经元(节点)。相邻层的节点有连接或者边(edge)。所有的连接 都配有权重。
a
14
应用一:MLP分类器
a
15
应用一:MLP分类器
a
16
应用一:MLP分类器
a
17
应用一:MLP分类器
a
18
应用一:MLP分类器
a
19
应用一:MLP分类器aFra bibliotek20应用一:MLP分类器
a
21
应用一:MLP分类器
a
22
应用一:MLP分类器
a
23
应用二:MLP的3D可视化
Adam Harley 创造了一个多层感知器的 3D 可视化 (http://scs.ryerson.ca/~aharley/vis/fc/),并已经开始使用 MNIST 数据库 手写的数字进行训练。
神经网络(neural networks)方面的研究很早就已经出现,今天“神经网络” 已是一个相当大的、多学科交叉的学科领域。
神经网络中最基本的成分是神经元(neuron)模型,一般称作「节点」 (node)或者「单元」(unit)。节点从其他节点接收输入,或者从外部源 接收输入,然后计算输出。每个输入都辅有「权重」(weight,即 w), 权重取决于其他输入的相对重要性。节点将函数 f(定义如下)应用到加权 后的输入总和,如图 1 所示:
由前向传播和后向传播构成。
简单说来,BackProp 就像「从错误中学习」。监督者在人工神经网络犯错 误时进行纠正。学习的目的是为分配正确的权重。通过输入向量,这些权重 可以决定输出向量。
前向传播:最初,所有的边权重(edge weight)都是随机分配的。对于所 有训练数据集中的输入,人工神经网络都被激活,并且观察其输出。
a
12
感知机与多层神经网络
a
13
感知机与多层神经网络
如果我们现在再次向网络输入同样的样本,网络应该比之前有更好的表现, 因为为了最小化误差,已经调整了权重。如图 7 所示,和之前的 [0.6, -0.4] 相比,输出节点的误差已经减少到了 [0.2, -0.2]。
这意味着我们的网络已经学习了如何正确对第一个训练样本进行分类。
多层感知器--MLP神经网络算法
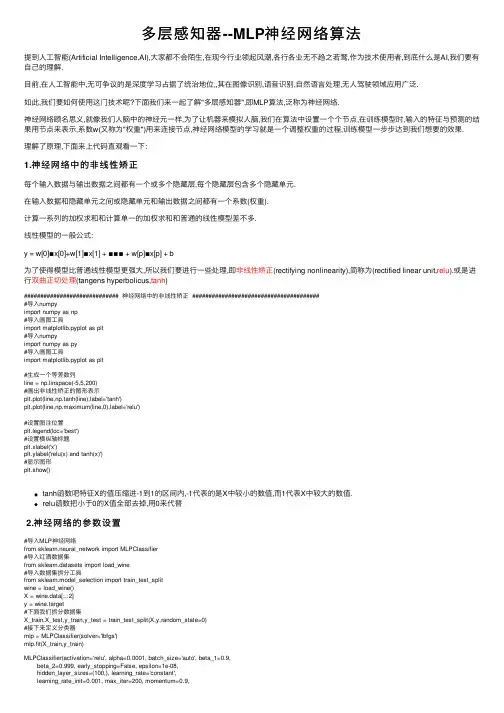
多层感知器--MLP神经⽹络算法提到⼈⼯智能(Artificial Intelligence,AI),⼤家都不会陌⽣,在现今⾏业领起风潮,各⾏各业⽆不趋之若鹜,作为技术使⽤者,到底什么是AI,我们要有⾃⼰的理解.⽬前,在⼈⼯智能中,⽆可争议的是深度学习占据了统治地位,,其在图像识别,语⾳识别,⾃然语⾔处理,⽆⼈驾驶领域应⽤⼴泛.如此,我们要如何使⽤这门技术呢?下⾯我们来⼀起了解"多层感知器",即MLP算法,泛称为神经⽹络.神经⽹络顾名思义,就像我们⼈脑中的神经元⼀样,为了让机器来模拟⼈脑,我们在算法中设置⼀个个节点,在训练模型时,输⼊的特征与预测的结果⽤节点来表⽰,系数w(⼜称为"权重")⽤来连接节点,神经⽹络模型的学习就是⼀个调整权重的过程,训练模型⼀步步达到我们想要的效果.理解了原理,下⾯来上代码直观看⼀下:1.神经⽹络中的⾮线性矫正每个输⼊数据与输出数据之间都有⼀个或多个隐藏层,每个隐藏层包含多个隐藏单元.在输⼊数据和隐藏单元之间或隐藏单元和输出数据之间都有⼀个系数(权重).计算⼀系列的加权求和和计算单⼀的加权求和和普通的线性模型差不多.线性模型的⼀般公式:y = w[0]▪x[0]+w[1]▪x[1] + ▪▪▪ + w[p]▪x[p] + b为了使得模型⽐普通线性模型更强⼤,所以我们要进⾏⼀些处理,即⾮线性矫正(rectifying nonlinearity),简称为(rectified linear unit,relu).或是进⾏双曲正切处理(tangens hyperbolicus,tanh)############################# 神经⽹络中的⾮线性矫正 ########################################导⼊numpyimport numpy as np#导⼊画图⼯具import matplotlib.pyplot as plt#导⼊numpyimport numpy as py#导⼊画图⼯具import matplotlib.pyplot as plt#⽣成⼀个等差数列line = np.linspace(-5,5,200)#画出⾮线性矫正的图形表⽰plt.plot(line,np.tanh(line),label='tanh')plt.plot(line,np.maximum(line,0),label='relu')#设置图注位置plt.legend(loc='best')#设置横纵轴标题plt.xlabel('x')plt.ylabel('relu(x) and tanh(x)')#显⽰图形plt.show()tanh函数吧特征X的值压缩进-1到1的区间内,-1代表的是X中较⼩的数值,⽽1代表X中较⼤的数值.relu函数把⼩于0的X值全部去掉,⽤0来代替2.神经⽹络的参数设置#导⼊MLP神经⽹络from sklearn.neural_network import MLPClassifier#导⼊红酒数据集from sklearn.datasets import load_wine#导⼊数据集拆分⼯具from sklearn.model_selection import train_test_splitwine = load_wine()X = wine.data[:,:2]y = wine.target#下⾯我们拆分数据集X_train,X_test,y_train,y_test = train_test_split(X,y,random_state=0)#接下来定义分类器mlp = MLPClassifier(solver='lbfgs')mlp.fit(X_train,y_train)MLPClassifier(activation='relu', alpha=0.0001, batch_size='auto', beta_1=0.9,beta_2=0.999, early_stopping=False, epsilon=1e-08,hidden_layer_sizes=(100,), learning_rate='constant',learning_rate_init=0.001, max_iter=200, momentum=0.9,n_iter_no_change=10, nesterovs_momentum=True, power_t=0.5,random_state=None, shuffle=True, solver='lbfgs', tol=0.0001,validation_fraction=0.1, verbose=False, warm_start=False)identity对样本特征不做处理,返回值是f(x) = xlogistic返回的结果会是f(x)=1/[1 + exp(-x)],其和tanh类似,但是经过处理后的特征值会在0和1之间#导⼊画图⼯具import matplotlib.pyplot as pltfrom matplotlib.colors import ListedColormap#定义图像中分区的颜⾊和散点的颜⾊cmap_light = ListedColormap(['#FFAAAA','#AAFFAA','#AAAAFF'])cmap_bold = ListedColormap(['#FF0000','#00FF00','#0000FF'])#分别⽤样本的两个特征值创建图像和横轴和纵轴x_min,x_max = X_train[:, 0].min() - 1,X_train[:, 0].max() + 1y_min,y_max = X_train[:, 1].min() - 1,X_train[:, 1].max() + 1xx,yy = np.meshgrid(np.arange(x_min,x_max, .02),np.arange(y_min,y_max, .02))Z = mlp.predict(np.c_[xx.ravel(),yy.ravel()])#给每个分类中的样本分配不同的颜⾊Z = Z.reshape(xx.shape)plt.figure()plt.pcolormesh(xx, yy, Z, cmap=cmap_light)#⽤散点图把样本表⽰出来plt.scatter(X[:, 0],X[:, 1],c=y,edgecolor='k',s=60)plt.xlim(xx.min(),xx.max())plt.ylim(yy.min(),yy.max())plt.title("MLPClassifier:solver=lbfgs")plt.show()(1)设置隐藏层中节点数为10#设置隐藏层中节点数为10mlp_20 = MLPClassifier(solver='lbfgs',hidden_layer_sizes=[10])mlp_20.fit(X_train,y_train)Z1 = mlp_20.predict(np.c_[xx.ravel(),yy.ravel()])#给每个分类中的样本分配不同的颜⾊Z1 = Z1.reshape(xx.shape)plt.figure()plt.pcolormesh(xx, yy, Z1, cmap=cmap_light)#⽤散点图把样本表⽰出来plt.scatter(X[:, 0],X[:, 1],c=y,edgecolor='k',s=60)plt.xlim(xx.min(),xx.max())plt.ylim(yy.min(),yy.max())plt.title("MLPClassifier:nodes=10")plt.show()(2)设置神经⽹络有两个节点数为10的隐藏层#设置神经⽹络2个节点数为10的隐藏层mlp_2L = MLPClassifier(solver='lbfgs',hidden_layer_sizes=[10,10])mlp_2L.fit(X_train,y_train)ZL = mlp_2L.predict(np.c_[xx.ravel(),yy.ravel()])#给每个分类中的样本分配不同的颜⾊ZL = ZL.reshape(xx.shape)plt.figure()plt.pcolormesh(xx, yy, ZL, cmap=cmap_light)#⽤散点图把样本表⽰出来plt.scatter(X[:, 0],X[:, 1],c=y,edgecolor='k',s=60)plt.xlim(xx.min(),xx.max())plt.ylim(yy.min(),yy.max())plt.title("MLPClassifier:2layers")plt.show()(3)设置激活函数为tanh#设置激活函数为tanhmlp_tanh = MLPClassifier(solver='lbfgs',hidden_layer_sizes=[10,10],activation='tanh')mlp_tanh.fit(X_train,y_train)Z2 = mlp_tanh.predict(np.c_[xx.ravel(),yy.ravel()])#给每个分类中的样本分配不同的颜⾊Z2 = Z2.reshape(xx.shape)plt.figure()plt.pcolormesh(xx, yy, Z2, cmap=cmap_light)#⽤散点图把样本表⽰出来plt.scatter(X[:, 0],X[:, 1],c=y,edgecolor='k',s=60)plt.xlim(xx.min(),xx.max())plt.ylim(yy.min(),yy.max())plt.title("MLPClassifier:2layers with tanh")plt.show()(4)修改模型的alpha参数#修改模型的alpha参数mlp_alpha = MLPClassifier(solver='lbfgs',hidden_layer_sizes=[10,10],activation='tanh',alpha=1)mlp_alpha.fit(X_train,y_train)Z3 = mlp_alpha.predict(np.c_[xx.ravel(),yy.ravel()])#给每个分类中的样本分配不同的颜⾊Z3 = Z3.reshape(xx.shape)plt.figure()plt.pcolormesh(xx, yy, Z3, cmap=cmap_light)#⽤散点图把样本表⽰出来plt.scatter(X[:, 0],X[:, 1],c=y,edgecolor='k',s=60)plt.xlim(xx.min(),xx.max())plt.ylim(yy.min(),yy.max())plt.title("MLPClassifier:alpha=1")plt.show()总结: 如此,我们有4种⽅法可以调节模型的复杂程度: 第⼀种,调整神经⽹络每⼀个隐藏层上的节点数 第⼆种,调节神经⽹络隐藏层的层数 第三种,调节activation的⽅式 第四种,通过调整alpha值来改变模型正则化的过程 对于特征类型⽐较单⼀的数据集来说,神经⽹络的表现还是不错的,但是如果数据集中的特征类型差异⽐较⼤的话,随机森林或梯度上升随机决策树等基于决策树的算法的表现会更好⼀点. 神经⽹络模型中的参数调节⾄关重要,尤其是隐藏层的数量和隐藏层中的节点数. 这⾥给出⼀个参考原则:神经⽹络中的隐藏层的节点数约等于训练数据集的特征数量,但⼀般不超过500. 如果想对庞⼤复杂⾼维的数据集做处理与分析,建议往深度学习发展,这⾥介绍两个流⾏的python深度学习库:keras,tensor-flow⽂章引⾃ : 《深⼊浅出python机器学习》。
多层神经网络MLP快速入门汇总

前向传播:最初,所有的边权重(edge weight)都是随机分配的。对于所 有训练数据集中的输入,人工神经网络都被激活,并且观察其输出。
后向传播:这些输出会和我们已知的、期望的输出进行比较,误差会「传播」 回上一层。该误差会被标注,权重也会被相应的「调整」。该流程重复,直 到输出误差低于制定的标准。
应用一:MLP分类器
应用一:MLP分类器
应用一:MLP分类器
应用一:MLP分类器
应用一:MLP分类器
应用一:MLP分类器
应用一:MLP分类器
应用一:MLP分类器
应用一:MLP分类器Leabharlann 应用二:MLP的3D可视化
Adam Harley 创造了一个多层感知器的 3D 可视化 (http://scs.ryerson.ca/~aharley/vis/fc/),并已经开始使用 MNIST 数据库 手写的数字进行训练。
神经网络(neural networks)方面的研究很早就已经出现,今天“神经网络” 已是一个相当大的、多学科交叉的学科领域。 神经网络中最基本的成分是神经元(neuron)模型,一般称作「节点」 (node)或者「单元」(unit)。节点从其他节点接收输入,或者从外部源 接收输入,然后计算输出。每个输入都辅有「权重」(weight,即 w), 权重取决于其他输入的相对重要性。节点将函数 f(定义如下)应用到加权 后的输入总和,如图 1 所示:
神经元模型
将上述情形抽象,就是一直沿用至今的“M-P”神经元模型。在这个模型 中,神经元收到来自n个其他神经元传递来的输入信号,这些输入信号 通过带权重(w)连接进行传递,神经元接收到的输入值将与神经元的 阈值进行比较,然后通过“激活函数”得到神经元的输出。
感知机与多层神经网络
多层感知机原理

多层感知机原理
多层感知机(Multi-layer Perceptron,MLP)是一种常见的人
工神经网络结构,由多个神经元层组成。
它基于前向传播算法,通过输入层接收外部数据,经过一系列隐藏层的计算,最终得到输出层输出结果的一种机器学习算法。
在多层感知机中,每个神经元接收若干个输入信号,分别进行加权和求和运算,再通过一定的激活函数将其转化为输出信号,通过不断的反向传播进行误差更新,训练模型的参数,使得模型能够更准确地拟合给定的训练数据。
在多层感知机中,每个神经元之间都有一条连接,称为权重。
通过不断地调整权重,模型可以不断地优化,以适应不同的任务需求。
常用的优化算法包括随机梯度下降和反向传播算法等。
与其他机器学习算法相比,多层感知机能够处理复杂的非线性问题,并在实际应用中得到广泛应用,例如图像分类、语音识别、自然语言处理等。
mlp的层数和节点数确定方法

mlp的层数和节点数确定方法
在机器学习中,多层感知器(MLP)是一种常见的神经网络模型。
确定MLP的层数和节点数是设计模型的关键部分,下面介绍几种确定方法。
1、经验法则:在实践中,我们可以根据经验法则来确定MLP的层数和节点数。
一般而言,对于简单的问题,我们可以使用一个或两个隐藏层,每个隐藏层的节点数可以根据训练数据的大小和复杂度进行调整。
2、交叉验证:交叉验证是一种常用的模型选择方法,可以通过交叉验证来确定MLP的层数和节点数。
将数据集划分为训练集和测试集,使用训练集训练不同层数和节点数的MLP模型,选择测试集上表现最好的模型。
根据测试集上的表现来确定最佳的层数和节点数。
3、网格搜索:网格搜索是一种寻找最佳超参数的方法,可以通过网格搜索来确定MLP的层数和节点数。
首先确定层数和节点数的范围,然后使用不同的参数组合训练不同的MLP模型,选择表现最好的模型。
根据表现最好的模型的层数和节点数来确定最佳的参数。
总之,在确定MLP的层数和节点数时,需要根据问题的复杂度和数据集的大小进行调整,并可以使用交叉验证和网格搜索等方法来寻找最佳的参数组合。
- 1 -。
mlp超参数设置指导
mlp超参数设置指导确定MLP(多层感知器)的超参数是一项重要的任务,因为它们直接影响着模型的性能和训练时间。
以下是一些指导原则来设置MLP的超参数:1. 隐藏层的数量和大小,隐藏层的数量和每个隐藏层中神经元的数量是影响模型性能的关键因素。
通常情况下,可以尝试不同数量和大小的隐藏层,然后使用交叉验证来确定最佳的组合。
一般来说,较多的隐藏层和神经元数量可以增加模型的容量,但也容易导致过拟合。
2. 激活函数的选择,常用的激活函数包括ReLU、Sigmoid和Tanh。
ReLU通常是一个不错的选择,因为它在训练过程中能够加速收敛,并且避免了梯度消失的问题。
3. 学习率,学习率决定了模型在每次迭代中更新权重的幅度。
通常情况下,可以从一个较小的学习率开始,然后逐渐增加。
过大的学习率可能导致模型不稳定,而过小的学习率可能导致训练时间过长。
4. 正则化,正则化项可以帮助防止过拟合。
常用的正则化方法包括L1正则化和L2正则化。
可以尝试不同的正则化强度,并使用验证集来选择最佳的正则化参数。
5. 批量大小,批量大小决定了在每次迭代中用于更新权重的样本数量。
通常情况下,较大的批量大小可以加快训练速度,但可能会导致模型陷入局部最优解。
较小的批量大小可能会增加噪声,但有助于模型更快地收敛。
6. 迭代次数,确定训练模型的迭代次数也是十分重要的。
可以使用早停法来避免过拟合,即在验证集上的性能不再提升时停止训练。
综上所述,确定MLP的超参数需要一定的经验和实验。
通过反复尝试不同的超参数组合,并使用交叉验证来评估模型的性能,最终选择最佳的超参数组合。
同时,也可以考虑使用自动调参的工具来帮助确定最佳的超参数组合。
mlp多层感知机 贝叶斯超参数
mlp多层感知机贝叶斯超参数
多层感知机(MLP)是一种基础的神经网络模型,它可以通过引入激活函数来实现非线性映射,从而解决更加复杂的预测问题。
在训练MLP时,超参数的选择对模型的性能有着重要影响。
贝叶斯方法可以用于优化这些超参数,提高模型的泛化能力。
具体来说,MLP的超参数包括但不限于:
1. 层数:MLP由输入层、隐藏层和输出层组成,隐藏层的层数会影响模型的复杂度。
2. 神经元数量:每一层中的神经元数量,也是决定模型复杂度的重要因素。
3. 激活函数:如sigmoid函数,它可以让MLP从线性模型变为非线性模型,增强模型的表达能力。
4. 学习率:影响模型训练过程中权重更新的速度。
5. 批次大小:决定每次训练时输入数据的量,影响模型的收敛速度和稳定性。
6. 迭代次数:模型训练的总轮数,与模型的训练时间和解的质量都有关系。
7. 正则化参数:用于控制模型的复杂度,防止过拟合。
贝叶斯方法在超参数优化中的应用主要包括:
1. 贝叶斯优化:通过构建目标函数的后验分布,不断迭代寻找最优超参数组合。
2. 概率模型:使用概率模型来描述超参数的不确定性,通过采样来探索超参数空间。
3. 自动化模型选择:结合贝叶斯方法和交叉验证,自动选择最佳的超参数组合。
总的来说,在实践中,贝叶斯方法可以帮助我们更有效地选择MLP的超参数,从而提高模型的性能和泛化能力。
通过贝叶斯优化,我们可以在超参数空间中寻找到最优解,减少手动调参的工作量,加快模型的开发周期。
《MLP神经网络》课件
性特性。
反向传播过程
01
02
03
04
误差计算
计算实际输出与目标输出之间 的误差。
权重调整
根据误差调整各层神经元的权 重。
梯度下降
按照梯度下降的方向更新权重 ,减小误差。
学习率
控制权重更新的步长,避免过 拟合或欠拟合。
参数更新过程
02
MLP神经网络的原理
前向传播过程
输入层
输入数据通过输入层进入神经 网络,每个神经元接收一个输
入信号。
隐藏层
隐藏层神经元接收来自输入层 神经元的输出信号,经过激活 函数处理后产生隐藏层的输出 信号。
输出层
输出层神经元接收来自隐藏层 神经元的输出信号,经过激活 函数处理后产生最终的输出结 果。
激活函数
感谢您的观看
THANKS
MLP神经网络的基本结构
总结词
多层感知器的组成
详细描述
MLP神经网络由输入层、隐藏层和输出层组成。输入层负责接收外部输入的数据 ,隐藏层通过非线性变换将输入转化为更有意义的高阶特征表示,输出层则根据 隐藏层的输出做出最终的决策或预测。
MLP神经网络的学习过程
总结词
多层感知器的学习过程
详细描述
MLP神经网络的学习过程包括前向传播和反向传播两个阶段。在前向传播阶段,输入数据通过各层传递,得到输 出结果;在反向传播阶段,根据输出结果与实际结果的误差,调整各层神经元的权重,以逐渐减小误差,提高模 型的准确率。
聚类问题
总结词
MLP神经网络在聚类问题中也有一定的应用,能够将相似的数据点聚集在一起,形成 不同的聚类。
神经网络中的感知器与多层感知器
神经网络中的感知器与多层感知器神经网络是一种模仿人类神经系统的信息处理系统,能够通过学习和自我适应来完成任务。
神经网络在图像识别、语音识别、自然语言处理等领域有着广泛的应用。
其中,感知器和多层感知器是神经网络中最基本的结构,本文将分别介绍它们的原理、应用和局限性。
一、感知器(Perceptron)感知器是神经网络的最基本单元,它基于线性分类模型,能够将输入数据进行分类。
感知器的构成由输入层、权值、偏移量、激活函数和输出层组成。
1、输入层:输入层是感知器的数据源,同时也是神经元的接收器,输入层的节点数决定了输入数据的维度。
2、权值:输入信号与感知器之间的连接是用权值来表示的,权值决定了输入节点的重要程度。
权值的调整也是感知器训练的核心。
3、偏移量:偏移量是一个常数,它与权值结合起来作为阈值判断的依据。
4、激活函数:激活函数是连接多个神经元之间的唯一方式,也是用于处理输入数据的函数,它将输入的信号进行处理后输出到输出层。
5、输出层:输出层的节点数决定了对数据进行分类的结果。
可以是二分类或多分类。
感知器的训练过程就是通过上面的结构来不停地调整每个输入节点的权值,从而不停地改进分类结果。
感知器的应用:感知器广泛应用于二元分类的问题中,例如数字识别和人脸识别。
感知器的局限性:但是,感知器有很大的局限性,例如无法处理非线性分类问题,只能进行两类问题的分类。
因此,需要使用多层感知器来解决这些问题。
二、多层感知器(Multi-Layer Perceptron, MLP)多层感知器是感知器的扩展,通过添加多个隐藏层使其可以处理非线性分类问题。
隐藏层的加入使得神经网络学习到了更加复杂的特征,并且可以解决分类问题。
多层感知器的结构与感知器相似,只是中间加入了隐藏层,隐藏层将原数据进行转换和处理,以得到更好的输入数据。
隐层和输出之间的连接仍然可以使用任何激活函数,例如Sigmoid函数。
多层感知器的训练过程和感知器类似,也是不断地调整权重来训练,但多层感知器的训练相较于单层感知器显得更加复杂,因为它需要在每个隐藏层之间做权值传导和梯度求导。
matlab多层感知器代码-概述说明以及解释
matlab多层感知器代码-概述说明以及解释1.引言1.1 概述概述部分主要介绍多层感知器(Multi-Layer Perceptron,简称MLP)的基本概念和作用,以及本文的研究目的。
多层感知器是一种经典的人工神经网络模型,它模拟了人脑神经元之间的连接和信息传递过程。
通过多层的神经元网络结构和具有自适应调整能力的权值,多层感知器能够完成复杂的非线性函数逼近和模式识别任务。
在现代科技的各个领域中,多层感知器已经广泛应用于图像识别、语音识别、自然语言处理等人工智能领域。
它的广泛应用和良好的性能成为了研究者关注和深入研究的热点之一。
本文的研究目的是通过MATLAB实现多层感知器的代码,并结合实验结果对其进行分析和评估。
通过这一研究,我们旨在探索多层感知器在实际问题中的应用潜力,以及它在模式识别和函数逼近等任务中的效果和局限性。
在下一部分,我们将详细介绍多层感知器的原理,并提供MATLAB 实现多层感知器的代码。
随后,在结论部分,将对实验结果进行分析和总结,并展望多层感知器在未来的应用前景。
通过本文的研究,我们希望能够为读者提供一个全面了解多层感知器及其在模式识别中的应用的知识框架,并为相关领域的研究者提供实现和优化多层感知器的参考。
1.2 文章结构本文分为三个主要部分:引言、正文和结论。
在引言部分,我们将对多层感知器进行概述,介绍其原理及其在机器学习领域的应用。
我们还会给出本文的目的,即通过MATLAB代码实现多层感知器,以帮助读者更好地理解和应用该算法。
在正文部分,我们将详细介绍多层感知器的原理,包括其基本思想、结构和训练过程。
我们将阐述多层感知器的前向传播和反向传播算法,并提供MATLAB代码实现。
通过实际的代码演示和解释,读者可以清晰地了解多层感知器的运行过程和关键步骤。
在结论部分,我们将对实验结果进行分析,并讨论多层感知器在实际应用中的前景。
我们将评估多层感知器的性能,并探讨其在模式分类、预测和识别等领域的潜在应用。
mlp神经网络_python机器学习:神经网络算法深度学习3篇
mlp神经网络_python机器学习:神经网络算法深度学习第一篇:MLP神经网络的基本概念在机器学习领域,神经网络(neural network)是一种极其受欢迎的算法,它被广泛应用于分类、识别等任务。
多层感知机(Multilayer perceptron,MLP)是最流行的神经网络模型之一。
在本文中,我们将探讨MLP神经网络的基本概念。
首先,让我们回顾一下机器学习中的基本术语。
机器学习任务可以分为两种类型:监督学习和无监督学习。
监督学习是指训练数据集中每个样本都有一个预定义的类别或标签信息。
在无监督学习中,没有预定义的类别标签。
相反,需要从数据中学习隐藏的结构或模式。
MLP神经网络是一种监督学习算法。
它由多层神经元(neurons)组成,这些神经元在连接到下一层前将输入数据加权,然后通过激活函数(activation function)转换为输出信号。
神经元是MLP的主要组成部分,它们模仿大脑中的神经元,并处理和传播信息。
在MLP中,每个神经元都对数据进行加权处理,每个层之间都有一个嵌套关系。
输入层接收原始数据,并将其传送到隐藏层。
隐藏层将原始数据转化为低级特征,在神经网络中进行多次处理,并在输出层产生最终的预测。
训练MLP神经网络的过程可以分为两个阶段:向前传递和反向传递。
在向前传递中,网络评估每个输入,计算并传递输出。
在反向传递中,神经网络根据计算出的误差信号调整权重,最小化误差,并提高预测准确性。
在机器学习中,数据的预处理非常重要。
在使用MLP神经网络之前,需要对数据进行一些预处理,例如特征缩放和标准化。
还可以使用其他技术,如特征提取和降维,从数据中提取更有用的信息。
基础的MLP神经网络通常用于二分类或多分类问题。
对于连续值预测问题,可以使用回归技术来训练神经网络。
第二篇: MLP神经网络的应用MLP神经网络是一种通用的分类器,很多领域都可以应用。
下面介绍几个常见的应用领域。
图像识别在计算机视觉领域,MLP神经网络是一个非常有用的工具。