
语义网与本体技术
语义网表示语言
语义网查询技术
语义网安全
7 April 2009
提要
1 2 3 4
为什么要使用语义网 什么是语义网 问题描述 怎么样使用语义网 应用于制造业信息化中的思考
7 April 2009
本体概念
共享概念模型的明确的形式化规范说明
概念模型
通过抽象出客观世界中一些现象的相关概念而得到的模型,概念模型 表现的含义独立于具体的环境状态 概念和概念的约束都有明确的和无歧义的定义 本体能通过本体语言编码,使得计算机可读,并可以被计算机处理 本体体现的是共同认可的知识,反映的是相关领域内公认的概念集
特征:
实现文档语义与文档结构的分离; 达到使文档具有机器可处理的语义。
7 April 2009
Web的局限性
Web信息无法被自动处理:
计算机只负责显示信息,而没有理解和处理Web信息的能力,在 Web上很难开发各种智能应用。 以最强大的搜索引擎Google来说,它目前能搜索80亿之多的Web页 面,但这仅仅占整个Web规模的25%-30%; 同时,无法精确识别Web上的内容,搜索结果的质量并不令人满意。 Web Service:UDDI、WSDL等技术标准,服务的查全率和查准率 仍然较低;服务集成需要人工干预; 跨平台互操作的中间件:CORBA、COM、EJB等应用,存在中间件 描述、检索和自动化集成等方面的问题; 描述信息的语义二义性导致机器无法自动的理解和处理它们。
实现了文档结构和文档表现形式的分离; 以Java script、VB script和XML等技术为标志; 数字图书馆、网上购物、网上办公自动化等等。
7 April 2009
Web的发展历史——第三代Web
Web的高速发展使得它很快成为一个庞大的知识 库,但同时带来很多问题:
忽略了计算机的处理作用; 大部分有用信息无法得到有效利用。
7 April 2009
一个例子
卡洛斯正在找一个至少45平方米、至少有两个卧 室的公寓。如果是在三楼或三楼以上,大楼必须 有电梯。而且可以养宠物。 卡洛斯愿意为市中心的45平方米大小的公寓付 300美元,为在市郊的类似公寓付250美元。并 且,他愿意为公寓超出45平方米的部分每平方米 支付5美元,为花园每平方米付2美元。 他的付款总额不会超过400美元。在给定的可选 项中,他将选择最便宜的,第二优先的是有花园 的,最后才是有额外空间的。
通过互联网浏览文档成为可能,实现了文档表现形式与文档存储格式 的分离; 以HTML语言、URL和HTTP等技术为标志,以静态页面的形式来展 现信息; 简单易用,但信息单调,维护困难。
7 April 2009
Web的发展历史——第二代Web
允许用户通过交互查询数据库来构建Web应用, 并将数据库中符合要求的结果动态的生成页面, 并展示给用户。 特征:
但是规则R2’的前提不在谓词逻辑的表达能力之内,于是,就需要一 种新的规则系统。注意规则R1和R2适用于掌握相关情形的完全信息 的情况,而非单调规则R2’则应用于信息不完全的情况。
7 April 2009
逻辑的分类
谓词逻辑 命题逻辑 描述逻辑 Horn逻辑 模态逻辑 直觉主义逻辑 多值逻辑 ……
7 April 2009
提要
1 2 3 4
为什么要使用语义网 什么是语义网 怎么样使用语义网 应用于制造业信息化中的思考
7 April 2009
语义网的架构
机器和软件代理可以用它来 唯一的验证某个信息是否由 特定的可信任的来源提供。 规则 信任 除了本体层定义的术语关系 和推理规则外,还需要有一 数据 证明 个功能强大的逻辑语言来实 RDF数据模型提供简单的语义, 数 数据 现推理。 RDF属性可以看作是资源的属性, 逻辑 提供一个明确形式化语言,以准确 字 同时又表达了资源之间的关系; 定义术语语义及术语间的关系。 自描述 签 RDF Schema定义被描述资源的类 XML提供文档结构化的语法,实现了文档结构与 本体 文档 ,并提供约束违例的检测机制。 文档表现形式的分离,根据不同的目的同一个文 名 档可以有不同的表现形式。XML名称空间是名称 一种新的+字符编码标准,它支持 RDF+RDF Schema 的一个集合,用于文档元素和属性名有效性的验 世界上所有的语言。无论在什么 唯一标识Web上的任一资源,其思 证。XML Schema是约束XML文档结构的语言。 平台上,无论在什么程序中,无 想是在需要的时候通过链接引用 XML+NS+XML Schema 名称空间 论使用什么语言,每个字符都对 资源,因此不需要对资源进行拷 应于一个唯一的Unicode编码值。 贝或集中管理。
r2,r3,r4,r5,r6>r1 r7: size(X,Y),Y>=45,garden(X,Z),central(X) => offer(X,300+2Z+5(Y-45)) r8: size(X,Y),Y>=45,garden(X,Z), ﹁ central(X) => offer(X,250+2Z+5(Y-45)) r9: offer(X,Y),price(X,Z),Y<Z => ﹁acceptable(X) r9>r1
citizenOf
implicatedIn
date location
Afghanistan
World Trade Center
2001-09-11
Washington, DC
Saudi Arabia
date 2001-09-11 location New York, NY
7 April 2009
本体谱
语义网理论与技术探讨
提要
1 2 3 4
为什么要使用语义网 什么是语义网 怎么样使用语义网 应用于制造业信息化中的思考
7 April 2009
提要
1 2 3 4
为什么要使用语义网 什么是语义网 怎么样使用语义网 应用于制造业信息化中的思考
7 April 2009
Web的发展历史——第一代Web
1989 日内瓦欧洲粒子物理实验室 Berners-Lee 特征:
Web信息无法被有效利用:
Web服务存在异构问题:
7 April 2009
语义网的思想
Berners-Lee:
对现有Web扩展; 语义网的目标是让Web上的信息能够被机器理解,从而实现Web 信息的自动处理,以适应Web资源的快速增长,更好的为人类服 务。
W3C:
将机器能理解的数据发布在Web上正成为很多组织最优先考虑的 工作,只有Web成为一个自动工具和人能够共享和处理数据的平 台,它的潜能才可能全部发挥; Web上的数据可以被机器自动处理、集成和重用。
7 April 2009
逻辑与推理——单调规则
A1,A2,……,An —> B 解释:
演绎规则(deductive rules):如果A1,A2,……,An已知为真,那么B也为真。 反应式规则(reactive rules):如果条件A1,A2,……,An为真,那么执行行动 B。
father(X,Y),mother(X,Y),male(X),female(X) father(X,Y) —> parent(X,Y), mother(X,Y) —> parent(X,Y) male(X),parent(P,X),parent(P,Y),notSame(X,Y) —> brother(X,Y) female(X),parent(P,X),parent(P,Y),notSame(X,Y) —> sister(X,Y) brother(X,P),parent(P,Y) —> uncle(X,Y) mother(X,P),parent(P,Y) —> grandmother(X,Y) parent(X,Y) —> ancestor(X,Y), ancestor(X,P),parent(P,Y) —> ancestor(X,Y)
这种解决方案在已经生日的情况下运转良好。但是,假设一个顾客因 为涉及隐私而拒绝提供他的生日。在这种情况下,就不能应用上面的 规则了,因为其前提是未知的。为了处理这种情况,需要写出如下的 规则:
R1:If birthday, then special discount. R2’:If birthday is not known, then not special discount.
本体是……
目录 (catalog)
术语表 (glossary)
分类的集合 (collection of taxonomies ) 辞典 (thesaurus)
通用逻辑约束的集合 (set of general logical constraints)
文本文件的集合 (set of text files)
“911”本体描述
Class Terrorist type hasLeader Osama bin Laden al Qaeda type
Class
Terrorist Organization type
Class
Terrorist Event
type
implicatedIn
Pentagon
residesIn
acceptable(x) offer(x,y)
7 April 2009
形式化描述——规则
r1: =>acceptable(X) r2: r3: r4: r5: r6: bedroom(X,Y),Y<2 => ﹁acceptable(X) size(X,Y),Y<45 => ﹁acceptable(X) ﹁pets(X) => ﹁acceptable(X) floor(X,Y),Y>2, ﹁lift(X) => ﹁acceptable(X) price(X,Y),Y>400 => ﹁acceptable(X)
基于语义网的本体整合技术研究

实现智能网络发展的目 标. 在此模式支持下 , 人类语
言能够得 到快速 处理 , 从 而实 现人 类 与计 算 机之 间
收 稿 日期 : 2 0 1 3— 0 9— 0 7
汤 敏 丽
( 凯 里 学 院教 务 处 , 贵州 凯里 5 5 6 0 1 1 )
摘
要: 当前 网络环 境暴 露 出诸 多 问题 , 如 网络 智 能化程 度低 、 网络 信 息资 源使 用效 率低 , 从 而难
以 满足 用户对 查询 信 息的最 佳 需求. 为解 决这 些 问题 , 从 领 域本 体 设 计 着 手 , 对 基 于语 义 网对 本
对 某些 概念 进行 形式 化 处理 , 能够 实现 个体 与 团体 之 间的转化 , 但 需 要 通 过 4层 含 义 来 实 现 . 本 体 能
够利 用概 念模 型进 行抽 象词 汇 的构建 , 这 能够 发挥 它 的共享 功 能 , 但 本 体 只 是 客 观展 现 问题 的实 质 ,
作者简介 : 汤敏丽( 1 9 8 2 一 ), 女, 贵州凯里 人, 凯里学 院教务处讲师 , 研究方 向: 数据库 、 网络
体整 合技 术进 行深入 研 究 , 进 而为本体 整合 技 术 的发 展提 供相 关理 论依 据 .
关键 词 : 语 义 网; 本 体 整合技 术 ; 本体 整合 设计 ; 本 体映射 技 术 论 文编码 : D o i : 1 0 . 3 9 6 9 / j . i s s n . 1 6 7 3— 9 3 2 9 . 2 0 1 3 . 0 6 .
语义网中的本体构建与推理研究
语义网中的本体构建与推理研究随着互联网技术的不断发展,人们在网络上获取信息变得越来越容易,然而,这些信息往往是海量的、杂乱无章的,并不便于机器自动处理。
因此,我们需要一种能够理解信息含义的方式,来帮助我们更好地处理这些信息。
这就是语义网的基本思想。
语义网(Semantic Web)的核心是充分地使用信息的语义,通过构建本体(Ontology)、推理等手段来实现Web资源的高效利用和共享。
本体是语义网的基石本体是语义网中的核心概念。
顾名思义,本体就是用于描述实体及其关联关系的模型。
它是对某一领域中实体、概念、属性和关系等的描述,以及这些描述之间的约束、规则等。
本体的目的是消除不同人、不同组织、不同机器对同一概念的不同解释,为不同使用者提供一个一致的、标准的基础。
因此,本体的构建关系到语义网的推广和应用。
本体构建的方法本体构建的方法可以大致分为三大类:手工构建法、半自动化构建和自动化构建。
手工构建是最早出现的一种本体构建方式。
其优点在于可以高度抽象地描述概念,缺点在于速度慢、成本高。
半自动化构建则是在手工构建的基础上,在人工干预的情况下涉及到自动化工具,优点在于缩短了构建时间。
自动化构建是一种基于机器学习的方法,具有时间成本低、可扩展性好等优点。
本体推理的方法本体推理是指通过基于本体知识的逻辑推断,从本体中出发,再结合外部实例数据,推导出新的知识或结论,从而完善和扩展本体的过程。
本体推理的方法可以大致分为逻辑推理和规则推理。
逻辑推理是利用逻辑形式化地表示本体知识,然后进行逻辑推理的过程。
逻辑推理需要对本体进行形式化表示,从而使推理结果是形式化规则所允许的。
规则推理是指利用基于规则或规则表示的推理方法,利用规则的强特定性来完成推理任务。
本体构建和推理的应用完善的本体和推理技术可以帮助我们更好地利用和共享网络信息。
下面分别介绍几个应用。
1. 语义搜索语义搜索可以从网络数据中精确提取用户所需信息。
在语义搜索中,可以利用本体中的概念间关系,由搜索关键词推断出更适合用户需求的结果,从而不必对搜索结果进行手工筛选。
黄智生博士谈语义网与Web 3.0

黄智生博士谈语义网与Web 3.0近两年来,“语义网(Semantic Web)”或“Web 3.0”越来越频繁地出现在IT报道中,这表明语义网技术经过近10年的研究与发展,已经走出实验室进入工程实践阶段。
PowerSet、Twine、SearchMonkey、Hakia等一批语义网产品的陆续推出,预示着语义网即将在现实世界中改变人们的生活与工作方式。
在Web 3.0时代即将揭开序幕之际,正确理解、掌握语义网的概念与技术,对IT人士与时俱进和增加优势是必不可少的。
为此,InfoQ中文站特地邀请到来自著名语义网研究机构荷兰阿姆斯特丹自由大学的黄智生博士,请他为我们谈一谈工业界人士感兴趣的语义网话题,包括什么是语义网、语义网与Web 3.0的关系以及语义网如何给商业公司带来效益等。
InfoQ中文站:您是语义网方面的权威专家,能否先请您为我们消除概念上的困惑。
现在有一个说法,即Web 3.0就是语义网。
但是除了W3C定义的语义网以外,关于Web 3.0还有许多种其他说法,您认为谁才真正代表了Web 3.0?为什么?黄智生博士(以下称黄博士):首先需要说明的是:我不认为自己是所谓的“权威”。
纵观万维网的发展,总是年轻人在创造历史,他们给人类社会带来了一次又一次的惊奇。
且不说万维网之父Tim Berners-Lee在1989年构想万维网的时候仅仅三十出头。
Web 1.0产生的雅虎和谷歌等国际大公司的创始人大多是年轻的博士生。
Web 2.0产生的Facebook等公司创始人的情况也大体如此。
Web 3.0的情况也可能如此。
我们甚至都不能完全指望通过现有的IT大公司的巨大投入来发展语义网。
这些大公司往往受着过去成功经验的束缚,而且新技术采用的是与以往完全不同的思路,从而会加深大公司对新技术的怀疑。
当然,这也为年轻人书写历史创造辉煌提供了发展空间。
由于Web 1.0和Web 2.0技术的成熟,Web 3.0的想法实际上表达了现在人们对下一代万维网技术的种种期待。
语义网概念及技术综述

语义网概念及技术综述语义网(Semantic Web)是一种由 W3C(World Wide Web Consortium)推广的,基于 XML(eXtensible Markup Language)和 RDF(Resource Description Framework)等技术的网络,它旨在增强网络信息的语义表达和机器可读性,从而使得计算机能够更好地理解和处理网络信息。
一、语义网的概念语义网是一种以“数据”为中心的网络,它通过使用 XML、RDF 等技术,将网络信息以机器可读的方式进行组织和表达。
与传统的 Web 相比,语义网更加强调信息的结构和含义,而不是简单的文本表现形式。
因此,语义网被认为是 Web 的一个重要发展阶段,是实现智能 Web 的关键步骤。
二、语义网的技术1.XMLXML 是构建语义网的基础技术之一,它是一种用于描述数据的标记语言。
XML 可以用来表示数据结构,并且可以很好地与 HTML、HTTP 等现有网络技术集成。
通过 XML,我们可以将数据以机器可读的方式进行组织和表达,从而使得计算机可以更好地处理和理解数据。
2.RDFRDF 是另一种构建语义网的关键技术,它是一种用于描述资源及其关系的模型。
RDF 将每个资源视为一个三元组,包括主体、属性和值三个部分。
通过这种方式,我们可以将网络信息以一种通用的、机器可读的方式进行描述和组织,从而实现数据的共享和重用。
3.RDFSRDFS 是 RDF 的扩展,它增加了一些新的概念和规则,例如类、子类关系、属性限制等。
这些概念和规则可以帮助我们更好地描述和组织数据,并且可以用于构建更加复杂的语义网应用。
4.OWLOWL 是另一种基于 RDF 的语言,它提供了更加丰富的概念和规则,例如类、属性、关系等。
OWL 提供了三种不同的表达层次,分别是 OWL Lite、OWL DL 和OWL Full,以满足不同应用场景的需求。
OWL 可以用于描述更加复杂的概念和关系,并且可以用于构建更加高级的语义网应用。
语义网信息组织
K
A
公共汽车 A 出租车公司 P
A
型号
A
本体的分类
通用本体:描述最一般化的概念,例如空间、时间、
时间、运动等,独立于特定的问题与领域,作为大 众沟通的工具,可以说是真实世界中的常识。
领域本体:定义或描述特殊领域的相关知识,领域
本体如同专家的专门知识,每一份专业知识都记载 该领域中的事物。
应用本体:使用属性、关系进行定义与描述真实世
系,电子分类法的表现形式无法满足其需求。
本体与元数据的互补
元数据方案不具有普遍适用性。无法克服特殊性与一
般性的矛盾,而形式化的知识本体可以提供一种在元 数据方案之间自动映射的机制,通过语义web服务的体 系架构进行实现。
元数据应用难以实现元数据方案本身的进化,而知识
本体可以提供信息系统的其他视图,只需要通过自动 或半自动的手段应用新的元数据方案。
本体
“本体”(Ontology)是一个从哲学中引入的词汇。
目前得到广泛共识的定义是:本体:是共享概念模 型的明确的形式化的规范说明。明确是指所使用的 概念及使用概念的条件都有明确的定义;形式化是 指本体是能被计算机处理的。
本体是对一个领域里的概念及其关系的清晰描述,
是人与人之间、人与计算机之间对领域知识达成共 同理解的桥梁。
与分类法相比,本体的构建不再是传统的关系数据
库或简单的逻辑语言所能完成的。
对ቤተ መጻሕፍቲ ባይዱ本体而言,其概念体系的完善,语义的充实,
对领域知识表达力的增强,很大程度上取决于本体 的描述语言和构建工具。 比起分类法,本体要求更强的知识表达能力。
本体与分类法的比较-形式化
在形式化方面,本体的形式化程度要高于分类法,
利用语义网技术实现铁路交通的地理语义查询(一)——C#中地理数据的网络获取和本体构建
、
个 体 的
关键 词 :语 义 网 ;W e b 3 . 0技 术 ;B a i d u Ma p A P I 编程 ;地 理数 据 获取 ;S QL i t e引擎 ;J e n a工具 ;地
理 本 体 ;本 体 构 建 ,I KV M. NE T 虚 拟 机
经过近 1 0多 年 的研 究 与 发 展 ,作 为 We b 3 . 0重 要组 成 部 分
利用语义网技术实现铁路交通的地理语义查询 ( 一)
— —
C #中地理数 据的网络获 取和本体构建
董 志
摘 要 :介 绍 了利 用 网络 地理 信 息服 务 获取 到有 关城 市特 定 区域 内有 关 火车站 的 P OI 点信息
,
并
根 据 这 些信 息 ,在 C≠ ≠ 环境 下 ,基 于J a v a虚拟 机 ,使 用J e n a A P I 设计 了本 体 的 类 、属 性 操 作 类 ,为铁 路 交通 中火车站 点 、线路及 所在 城 市的本 体 构建及 本 体推理 做 准备 。
生 了浩 瀚 的 网络信 息 和知 识 资源 ,寻找 人们 所 需要 的准确 信 息 常
常耗 费 大量 人 力精 力 。提 供 网络 信息 的语 义半 自动 化或 自动 化处 理 已迫在 眉睫 。这 就 使语 义 网是 成 为 We b 3 . 0最 有 希望 的基础 技
介绍在 C #中进 行 地 理数 据 的网 络获 取 、Байду номын сангаас Q L i t e 数 据 操作 类 和 本
中并 与 铁 路交 通数 据相 结合 ,利 用 运 行 于 I K V M. N E T上 的 J e n a
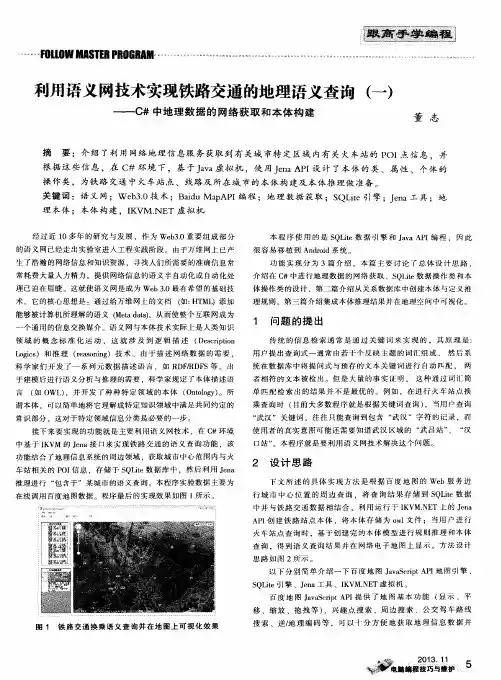
A P I 创 建 铁 路 站 点 本 体 ,将 本 体 存 储 为 o w l 文 件 ;当 用 户 进 行 火 车 站 点查 询 时 ,基 于 创 建 完 的本 体 模 型 进 行 规 则 推理 和本 体 查 询 ,得 到语 义查 询 结 果 并 在 网络 电子 地 图上 显 示 。方 法设 计
语义web中的本体学习OntologyLearningfortheSemanticWeb
2.3 数据的导入和处理技术
文档的收集、导入和处理步骤 使用一个以本体为中心的文档爬虫来搜集网上 的相关文档。 使用自然语言处理技术来进行文档的处理。 使用一个文档包装器将半结构化文档(如领域 字典)转换成本体学习框架可以识别的格式 (如RDF格式)。 将处理过的文档转换为本体学习算法可以识别 的格式。
抽取词条
分类关系的抽取:(1)使用层次聚类技术(2)
使用模式匹配技术(字典)
非分类关系的抽取:使用基于关联规则的挖掘
算法
2.4 本体学习算法
本体维护算法
本体的修剪(发现和删除无关的概念)
(1)基线修剪(2)相对修剪
本体的精练(对本体的精细调整和增量扩展)
主要思想是先找出未知的词条,然后从本体中 找出与其相似的概念并提交给用户,最后由用 户决定该未知词条的意义。
FCA-Merge(第 三步):从概念格 生成新本体
2.3 数据的导入和处理技术
合并 本体1中的Hotel 本体2中的Hotel 本 体 2中 的 Accommodation
合并 生成新概念或关系
合并
2.3 数据的导入和处理技术
FCA-Merge算法小结
输入:两个本体和一个自然语言文档集 输出:一个合并过的本体。 对输入数据有如下要求: 文档集应该和每个源本体都相关。 文档集应该包含源本体中的所有概念。 文档集应该能够很好的分离概念。
3.本体的评价
精度 学习生成的本体
手工生成的本体
precisionOL =
| CompRef | | Comp|
召回率
recallOL =
| CompRef | | Ref|
Hale Waihona Puke 其中,Ref是参照本体中元素的集合, Comp是比较本体中元素的集合。
基于本体和语义网技术的范例构建方法
则链 的不 同路 径 探 寻 问题 的解 . B C R对 问题 求解 不
是通过 链式推 理 产 生 , 是 根据 以前 解 决 相 似 问题 而 的经验 , 到新 问题 的解 决方 法 . 得 当新 出现 的问题 是 以前 处理过 的 问题 的简 单重 复 时 , B C R把 相 同 范例
摘 要 : 分析 范例表 示与推 理 的 重要 性基 础 上 , 在 通过 对 本体 表 示 范例 的优 越性 分 析 , 以及语 义 网对 本体特 有的 组织特 性 , 出 了一种 新 的范例 构建 方 法 . 方法 利 用本 体表 示 范例 , R F作 为 本体 提 该 以 D 范例描 述的 通用框 架 , 有效地 实现 了范例 的表 示 、 织和 索 引 . 组
的成 功解决 方法 直 接 用 于 求 解该 新 问题 ; 新 问题 若
bae n o tlg n y t e og n zto ris o e n i e b u n oo .T e meh d i o rp e e t sd o noo y a d b h r a iain tat fs ma t W b a o to tlg c y h to s t e r sn c s p n o tlg ,tk a e u o noo y a e RDF a e ea a ul i go tlg - a e,a d raieefciey te rp e e t — sag n r l meb i n noo y c s l f d n e l fe tv l h e rs n a z to in,o g n z t n a d id x o a e. ra ia i n n e fc s o Ke r s:n oo ;s ma t e y wo d o tlg y e n i W b;c s c a e;c s — a e e sn n a e b s d rau g.2 0 06
基于语义网的农业知识本体研究
基于语义网的农业知识本体研究摘要:随着农业信息技术的发展,“信息孤岛”成为了农业信息技术进一步发展的一个障碍,而资源的组织与描述是解决这一问题的前提。
基于语义网构建农业元数据和农业知识本体,从而实现农业信息资源的透明共享。
另外还根据面向服务的系统开发方法,研究分析了农业数据资源、农业软件资源和农业硬件资源的服务化方法。
关键词:语义网;农业信息资源;知识本体农业信息技术是农业科学和信息科学相互交叉渗透而产生的新的学科领域。
经过半个多世纪的发展,农业信息技术已产生了包括农业专家系统、精准农业、虚拟农业、管理信息系统、决策支持系统、信息化自动控制技术、农业信息网络、农业数据库系统等多个应用领域,这些成果在农业科研和农业生产中都取得了很大的经济效益和社会效益。
但是现有的系统都是独立的,同样的数据,需要这一数据的不同部门可能要分别去采集;同样的处理软件,每个系统都要开发自己的版本;许多昂贵的仪器设备,本单位并不经常使用,而需要的人却无法得到。
这就导致了不同领域之间、领域内部的各个系统之间资源是分散的、功能是独立的、结构是异构的,系统之间无法实现信息资源的共享,造成了大量的人力、物力和财力的浪费,这就使得解决农业信息资源共享问题成了当务之急。
要实现农业信息资源共享,首要难题是资源的组织与描述。
一、农业信息资源的组织农业信息资源来源复杂,类型异构,分布在不同的地理位置。
这些农业信息资源如果不能进行有效的组织,就很难保证资源之间的兼容性和互操作性,对资源的使用效率就很难达到应有的要求。
要实现资源的兼容性和互操作性,就必需达到三个基本的要求:资源的服务化、虚拟化和层次化。
(一)农业信息资源的服务化农业信息资源的服务化就是为了实现用户对农业信息资源的透明访问,由资源提供者事先将资源封装并以服务的形式发布,用户可以通过访问封装过的服务使用相关的农业资源。
(二)农业信息资源的虚拟化资源虚拟化将使分散在不同地理位置上的、异构的资源融合在一起,对用户提供透明服务。
语义网与本体
中 ,本 体『 2 】 是 其 不 可分 割 的 重 要 组 成 部 分 。 由于 本 体 在 语 义 网 中 扮 演 非 常 重 要 的 角 色 .因 此 开 展 对 本 体 的 应 用 研 究 在 语 义 网 实 现 中具 有 重 要 意 义 。应 用 于 计 算 机 领 域 的本 体 从 概 念 上 说 是 个 实 体 , 可 以 随意 将 现 实 世 界 存 在 的 事 物 进 行 肢 解 , 通
以随 意 改 变 文 档 的 结构 ,并 且 无 需 操 作 过 多 解 释 的 流 程 。 U R I 索引会确定 N S的命 名空 间 ,它 具 有 避 免 重 复 利 用 的优 点 .当
一
过 概 念 与 概 念 之 间 的关 系来 构 建 起 相 应 的 体 系 , 而 剖 析 其 本
电脑 编 程 技巧 与维 护
ห้องสมุดไป่ตู้
语义网与本体
邵 忻
( 天津外 国语 大学教育技术与信息学院 ,天津 3 0 0 2 0 4 )
摘 要 :深入 了解 了语 义 网的 由来 ,研 究语 义 网 的 结 构 ,通 过 对 U n i c o d e和 U R I 、X ML+N S +X ML S c h e m a 、R D F+ R D F S c h e m a 、O n t o l o g y v o c a b u l a r y 4个层 次 模 型 来 铸 造 稳 固的 结 构 。将 本 体 技 术 融入 到语 义 网运 行 过 程 中 . 实 现 知
1 引 言
现 今 的 网络 是 松 散 、开 放 的 资 源 集 合 ,最 大 的 弊端 是 智 能 化 程 度 低 、网 络 信 息 资 源 不 能 得 到 充 分 利 用 ,提 供 给 用 户 的