
语义网(一) 概述
趋势分析之语义网
趋势分析之语义网
近几年来,语义网越来越频繁地出现在IT报道中, PowerSet、Twine、 SearchMonkey、
Hakia等一批语义网产品也陆续推出。早在2010年,Google就已经收购了语义网公司
Metaweb。对于这次收购Google产品管理主管杰克·门泽尔(Jack Menzel)发文称,该公司可
以处理许多搜索请求,但Metaweb的信息可以使其处理更多搜索请求,“通过推出搜索答案
等功能,我们才刚刚开始将我们对互联网的理解用于改进搜索体验”,但对于部分搜索仍然
无能为力,“例如,‘美国西海岸地区学费低于3万美元的大学’或‘年龄超过40岁且获得过至
少一次奥斯卡奖的演员’,这些问题都很难回答。我们之所以收购Metaweb,是因为我们相
信,整合Metaweb的技术将使我们能提供更好的答案”。 这表明语义网技术经过近10年的
研究与发展,已经走出实验室进入工程实践阶段。
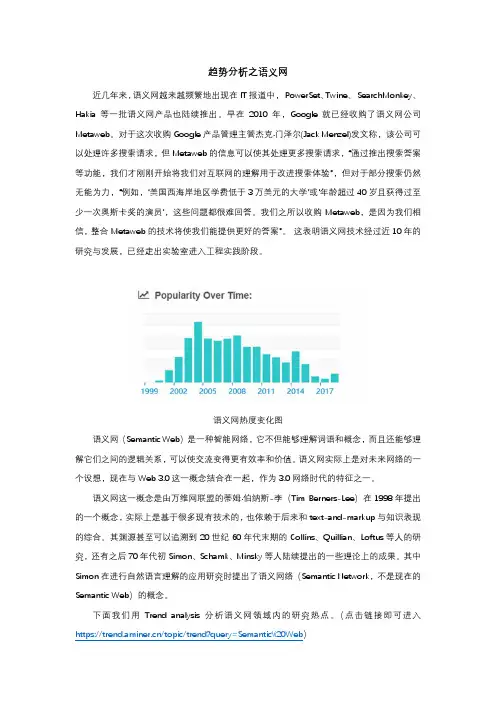
语义网热度变化图
语义网(Semantic Web)是一种智能网络,它不但能够理解词语和概念,而且还能够理
解它们之间的逻辑关系,可以使交流变得更有效率和价值。语义网实际上是对未来网络的一
个设想,现在与Web 3.0这一概念结合在一起,作为3.0网络时代的特征之一。
语义网这一概念是由万维网联盟的蒂姆·伯纳斯-李(Tim Berners-Lee)在1998年提出
的一个概念,实际上是基于很多现有技术的,也依赖于后来和text-and-markup与知识表现
的综合。其渊源甚至可以追溯到20世纪60年代末期的Collins、Quillian、Loftus等人的研
究,还有之后70年代初Simon、Schamk、Minsky等人陆续提出的一些理论上的成果。其中
Simon在进行自然语言理解的应用研究时提出了语义网络(Semantic Network,不是现在的
Semantic Web)的概念。
下面我们用Trend analysis分析语义网领域内的研究热点。(点击链接即可进入
语义网的技术及其应用

第22卷
收稿日期:2009-05-20基金项目:江苏省现代教育技术研究“十一五”规划2009年度滚动课题《图书馆电子资源综合评价系统研究》项目编号:2009-R-13778作者简介:孔为民(1971-),男,扬州大学图书馆编目部,馆员,现在南京农业大学信息技术学院脱产读图书馆学硕士,发表论文10余篇。当万维网早在19世纪90年代被开发出来时,它就创建了位于互联网基础网站的顶端的相互链接的文档网站。这些网站开始规则很少,几乎任何形式的文档都可以放在网站上供查询和索引。当然也存在这样的事实:就是关于对那些由非结构化数据构成的网站的项目我们能做和不能做的有严格的限制。语义网的目标是将万维网转化成一个数据网站,而不是一个文档网站。网络资源必须停止变成那些无区别的文本,而应成为能揭示文本内涵的资源。我们现在谈及的意义是机器可以拥有的意义。为了实现这个目标,语义网必须利用网络资源来建立理想和现实之间的交互和桥梁。早在1994年就首次提出了关于万维网的一种新概念,即2001年5月在《科技美国》杂志上发表的一篇文章使公众开始了解了语义网,该文章由网络之父TimBerners-Lee和其同事JamesHendler和OraLassila共同发表的。该文描述了一场网络革命,它是将主要的由人来使用的多数文档读给包含数据和信息文档再由计算机来进行复制利用。要强调的是语义网要求当前大部分网络数据未进行编码且未进行分类区分,它们是自然语言文本。任何进行过编程的人都会知道你只能用那些进行编码(“zipcode=20001”)的数据来写计算机程序,这样的数据具备一个程序可以利用的一定规则。简单的文本也许不会对人造成什么难题,但如果这个数据不以一种可预测的结构或格式存在的话,可能在如“这个文档的日期是什么?”的命令面前变得反应迟钝。1作为技术的语义学语义网的语义学对图书馆员来说不应该是完全陌生的。一个关于语义基本表述的例子是这样:“Her-manMelvillewrotethebookMobyDick”或者叫““MobyDick,byHermanMelville”。如果你希望计算机利用这个句子,你必须利用MARC21格式来创建以下格式的数据:100$aMelville,Herman245$aMobyDickorthisinDublinCore:Creator=HermanMelvilleTitle=MobyDick语义网的技术及其应用孔为民1,涂中群2(1.扬州大学图书馆,江苏扬州225009;2.南通大学现代教育技术中心,江苏南通226007)摘要:介绍了语义网及其技术的发展演变,提出实现网络环境下语义网信息检索与自动推理的技术框架,还论述了语义网和图书馆的关系。关键词:语义网;网络信息组织中图分类号:G254文献标识码:A文章编号:1002-1248(2010)01-0054-03SemanticWebTechnologyandItsApplicationKONGWei-min,TUZhongqun(Library,YangzhouUniversity,Yangzhou225009,China)Abstract:ThispaperhasintroducedthedevelopmentandevolutionofSemanticWebanditstechnology,putforwardthetech-nologicalstructuretoachieveinformationretrievalandautomaticreasoningofSemanticWebundernetworkenvironment,anddiscussedtherelationbetweentheSemanticWebandlibrary.Keywords:SemanticWeb;networkinformation;organization农业图书情报学刊第22卷第01期Vol.22,No.01JournalofLibraryandInformationSciencesinAgriculture2010年01月Jan.2010第1期显然还需要有更多的字段才能描述全面,但这么多的字段就已经可以足以区别有实际意义和无实际意义的数据了。带着这个编代码我们可以提这么个问题:“谁写的MobyDick?”也许答案会是这样:这不是一种机器的思维或某种智能,而仅仅是数据处理。语义网以机器行为方式通过把所有的概念表达成“三段式———主、谓、宾”的方法来管理语义。这种三段式像一个基本句子的结构,它的最简单的形式可以表示如下:subject(HermanMelville)predicate(isauthorof)object(MobyDick)语义网的实际表述要比他看起来复杂的多。它们使用RDF格式并常常用XML格式进行编码。它们广泛使用URL这种计算机的重要处理方式,而它对读者却是一种很友好的界面。下面是一个从Wikipedia上的关于“thepostalcodeforNewYorkisNY”的RDF表达式:这是一串计算机编码而不是供人读的数据。然而它说明概念经过这种技术处理可以被计算机所识别。我们必须考虑的是如果万维网上的许多文档中的信息可以以语义的方式被利用的话,我们该提供何种信息服务。2语义推理语义网的一个共同的观点是不可能对成数十亿的内容都进行语义性编码。这不是一个小问题。如果语义网的功能都依靠对所有的过去、现在和将来的数据进行人工编码来实现的话,它注定会失败。相反,我们可以利用一些数据模式的规则。此外,还可以从经编码数据与普通文本的相似性上来进行推论。将语义学加入文本中使用的模式已经体现在一些软件应用中了。例如MicrosoftOffice就有显示地址、数据、人名、地点名称的模式。如果需要在软件中查找一个姓名,软件可以提供查找姓名的电子邮箱地址或者开通一个空电子邮箱赋予那个姓名。可以通过基于网络的地名辞典来检测一个可能的地名,或者还可以通过地图、指南及可能提供的图片来检测。文本或局部部分的语义的自动分配可以通过经编码的词汇表或本体(结构化的词汇,如同义词表)来实现。然而,网络上存在一种机读词汇,它表述出“狗是哺乳动物的一个分支。”然后,软件可以推断出带有“狗”的词条可能与“哺乳动物”的查询结果有关。时光推移,当网络随着其资源数量增长而发展时,应该赋予资源更多的语义联系才能提升其质量和价值。3实现网络环境下语义网信息检索与自动推理的技术框架为了实现网络环境下基于语义的信息检索与自动推理,SemanticWeb具有如下的多层技术框架,包括:(1)Unicode和URI层。这是语义网的最底层。Unicode可以保证网络用户使用国际化、通用化的字符集。(2)XML+NS+XMLSchema层和RDF/RDF-Schema层。这两层建立了统一的语义数据交换格式和语义表达语言。RDF是资源描述框架,负责对语义进行描述,但其语义之间关系表达还不够丰富。(3)Ontology层。本体是一整套对某一领域里的知识进行表述的词和术语,编制者根据该知识领域的结构将这些词和术语组成等级类目,同时规定类目的特性及其之间的关系。其与叙词表的区别在于叙词表并不能表达概念之间丰富的联系。但本体可用相应的描述语言描述概念之间的关系,为实现推理功能建立基础。一个领域本体模型给出了某领域的准确描述,通常领域本体是由该领域的专家共同制定。把它抽象为概念、概念属性及概念间关系的集合。本体也可以被表示为一个非循环有向图。有向图中每个节点表示一个概念,概念之间各种带有方向的箭头描述了各个概念之间的关系,如is_a,kind_of,part_of,instance_of,interact_with等。该层是语义网体系里的核心层。本文下面所要描述的语义标引也是以建立领域本体为前提的。(4)顶层———Logic,Proof和Trus。这三层位于语义网体系结构的顶部,也是语义表达的高级要求,目前正处于研究阶段。其中,逻辑层提供了推理规则的描述手段,
语义网介绍及体系结构分析

声屏世界2015/12VOICE&SCREENWORLD学习与探索DSP内置200伊200的对讲矩阵袁在不用增加任何额外费用的情况下袁即可实现直播室尧导播室尧主控之间的全方位相互对讲通信遥五尧低耗电袁更环保遥DHD52系列的所有I/O模块尧DSP模块以及控制面的推子模块都是独立模块袁每个模块的耗电非常低袁大约在3W要15W左右不等袁一套16推子的调音台的耗电总计在100W左右袁而目前其他同类产品的耗电基本在200W左右遥DHD52系列数字调音台控制面还具备屏保功能袁即在一段时间内没有任何操作的情况下袁控制面上的所有指示灯自动进入半暗状态袁一旦有操作自动恢复常态袁既节能也可以延长硬件使用寿命遥六尧检测到故障后自动触发切换应急处理并报警遥DHD52系列的核心模块DSP内置多路电平和相位检测功能袁检测点可以自由设置在需要的输入通路和输出通路上袁检测电平门限和保持时间可以由用户设置遥一旦检测到故障可以在触摸屏上显示报警信息袁也可以触发音频报警并自动触发切换内置或外置应急处理通道遥七尧内置播出延时遥DHD52系列DSP具备内置的防亵渎播出延时功能袁调音台内部延时后的输出信号由系统内部直接输出至任何物理接口袁包括AES/EBU尧模拟和MA原DI以及GA光纤接口袁延时时间可以自由设置袁还可以通过GPIO与作为备份通路的外置延时器相互同步遥控袁简化了系统环节袁提高了系统的安全性遥八尧母线多袁最多可达32/48条立体声PGM母线遥母线的数量是衡量DSP处理能力的一个常规标准遥DHD有两种52/XC和52/XDDSP核心模块供选用遥通常电台直播调音台选用的52/XCDSP具备高达32条立体声PGM输出母线袁如果用52/XD可以获得48条立体声PGM输出母线遥九尧内置欧广联R128标准的响度表遥DHD52系列DSP内置R128标准的响度表显示功能遥该表显示在彩色触摸屏上袁显示方式和参考电平等参数都可以自由设置遥十尧具备多种IP基础的网络音频接口袁可以组成IP以太基础的网络系统袁在应用软件的支持下实现网络化的远程监控和管理以及应急切换遥DHD提供专为连接播出工作站音频I/O接口而设计的IPI/O模块袁可以直接将工作站PC主机普通网卡连接至该模块的网络接口袁获得16CH的音频输入和输出遥工作站无需再配置昂贵的音频接口卡袁不仅为电台节约了成本袁而且提高了输出和输出通道的数量
语义网的产生与发展

2012-07-19#############2012-07-19######2#0#12-07-19########
语义网的产生与发展
王祥瑞 李力东
(吉林建筑工程学院计算机科学与工程学院
,长春
130021)
摘要
:上过网的人都知道
,现在所使用的万维网的功能并不尽如人意
. 在发明万维网
10 年之后
,伯纳斯·李提出了
下一代万维网 ———“语义网”的理念
. 它不但能够理解人类的语言
,而且
,还可以使人与电脑之间的交流变得像人与
人之间交流一样轻松
.
关键词
:万维网
;语义网 (
Semantic Web)
;智能评估
中图分类号
: TP 309 文献标识码
: A 文章编号
:10092
1288 (
2007)
032
00662
03
目前的
Web 信息查找技术还不能很好地满足用户要求
,如何在大量的信息中查找到准确的资料
,以帮
助人们在网上方便地找到想要的准确信息是目前亟待解决的问题
.
语义网的产生
所谓“语义”就是文本的含义
. 语义网就是能够根据语义进行判断的网络
. Tim1
Ber ners - L ee 对语义万维
网做了如下描述
:语义万维网是对当前万维网的扩展
,语义万维网上的信息具有定义良好的含义
,使得计算
机之间以及人类能够更好地彼此合作[ 1 ]
.
11
1 万维网存在的问题及原因
万维网 (
Wo rld Wide Web ,简称
WWW 或
Web) 是互联网最重要 、最广泛地应用之一
,但是
,上过网的人
都知道
,万维网存在两个明显的不足
: ①计算机不能理解网页内容的语义
; ②网上有用信息难找
,查准率也
比较低
,夹杂了许多用户不需要的信息垃圾[ 2 ]
. 存在这些问题的原因在于万维网现在采用的超文本标记语
言 (
Hyper Test Mar kup L anguage ,简称
H TML )
,网页上的内容设计成专供人类浏览的
,而非供计算机理解和
基于语义网的信息分类与检索技术研究

基于语义网的信息分类与检索技术研究
随着互联网的快速发展,网络中的信息量呈现爆炸式增长,搜索引擎仅能以简单的关键词匹配,远远不能满足用户对信息的准确、全面和精准的需求。所以,基于语义网的信息分类与检索技术成为了研究的重点,并已经在各个领域得到了广泛的应用和发展。
一、什么是语义网
语义网(Semantic Web)是一种新型的、能够被计算机理解和处理的互联网形式,其核心就是将难以被计算机解析的文本转化为适合计算机理解和处理的语言。语义网通过建立一种结构化、标准化的语义框架、描述方式和语义关联机制,将信息按照一定的标准进行编码和存储,使得多种不同的应用程序和服务能够共享和利用这些信息,从而达到全局共享、智能应用的目的。
二、语义网的核心技术
语义网的核心技术主要包括本体论、RDF、OWL等多个方面。其中,本体论是语义网技术最为核心的一部分,它用于定义不同概念之间的关系、属性和类别,作为语义网建立的基础和桥梁。
除此之外,RDF(Resource Description Framework)用于描述互联网上的资源和他们之间的关系,是一种基于标准化的三元组(Subject-Predicate-Object)形式的表示方法。OWL(Web Ontology Language)则是一种更加复杂、具有更完整表达能力的本体描述语言,可以用来表达更为复杂的概念、属性及关系。
三、语义网在信息分类和检索中的应用
基于语义网的信息分类和检索技术,在当前数字化信息高速化发展的环境下,具有越来越广泛的应用前景。具体而言,其主要应用于以下几个方面:
1. 基于本体论的信息分类与管理 语义网技术的一个重要应用方向就是基于本体论的信息分类和管理。本体是语义网技术中的关键概念,因其可以将信息进行分类和描述,使搜索引擎和智能系统能够更为准确、快速地搜索和获取信息。在这一方面,一些国内外的企业,如百度、谷歌、IBM等,都在积极地推进本体论技术的应用研究和实现。
万维网的未来——语义网

万维网的未来——语义网
万维网的未来——语义网
在万维网日益普及的今天,人们充分体会到网络的巨大魅力。现在,我们可以与处于地球上遥远地方的人进行交流,浏览世界各地的信息,享受网上冲浪的乐趣。但是上过网的人都知道,现在所使用的万维网的功能并不尽如人意,如网页单调枯燥、搜索引擎智能化程度低等。但不管怎样,我们还是可以说,万维网是空前而不绝后的。那么,您是否想过万维网的未来又是什么样的呢?
目前的万维网其进化、扩大和完善的空间还很大,可以说万维网还没有走出婴儿期。为使万维网迈上一个新的台阶,从此摆脱幼稚,走向成熟和真正的智能化,10年前为我们发明因特网超文本系统的麻省理工学院万维网协会主席蒂姆·伯纳斯·李,现在又在致力于开发新一代的万维网(互联网),他为之取了一个直观的名称——“语义网”(the Semantic Web)。
1、什么是“语义网”?
所谓“语义”就是文本的含义。语义需要理解文本的意思和结构,而与显示方式无关。语义网就是能够根据语义进行判断的网络。
目前在万维网中,网页仅仅是一个单调的内容显示,电脑只负责将一个网页链接到另一个网页,网络不能按照用户的要求自动搜寻和检索网页,直至找到所需要的内容。而语义网则是希望计算机能“看懂”网页的内容,使计算机成为“智能”的导航工具。当然语义网还并不仅仅能完成这个功能,它比这还要“聪明”得多。
简单地说,语义网是一种能理解人类语言的智能网络,它不但能够理解人类的语言,而且还可以使人与电脑之间的交流变得像人与人之间交流一样轻松。
语义网就好比一个巨型的大脑,它由数据库智能化程度极高,协调能力非常强大的各个部分组成,可以解决各种难题。在语义网上连接的每一部电脑,都能分享人类历史上所有科学、商业和艺术等知识。它不但能够理解词语和概念,而且还能够理解它们之间的逻辑关系。
在语义网中,网络不仅能够连接各个文件,而且还能够识别文件里所传递的信息,也就是说,它是一种聪明的网络,可以干人所从事的工作。例如:它可以让计算机辨认和识别“head”这个单词的意思是“头脑”还是“领导”;在读者看新闻时,它能轻松地分辨出哪句是标题、哪句是导语。
语义网介绍及体系结构分析 2
语义网介绍及体系结构分析
作者:暂无
来源:《声屏世界》 2015年第13期
张海亮
随着网络的迅猛发展,网页上的信息成指数增长,网页已经成为最主要的信息交流渠道。由于HTML本身的局限性而导致网页上缺乏足够的语义信息,难以实现WEB信息的自动化处理,因此WWW、HTTP和HTML的创始人Tim Berners-Lee在一般万维网的基础上提出了语义网的概念,从而大大改进了人类思维和机器思维之间的差异,提高了机器自动处理网络上信息的能力。
语义网是对未来网络的一个设想,现在与WEB 3.0这一概念结合在一起,是3.0网络时代的特征之一。简单地说,语义网是一种智能网络,它不但能够理解词语和概念,而且还能够理解它们之间的逻辑关系,可以使交流变得更有效率和价值。语义网和人工智能中的语义网络是两个不同的概念,所以它采用的方法与自然语言处理不同。它对现有的WEB进行了语义扩展,从而使其上面的信息能够被计算机理解和处理,从功能上看它将是一个能够“理解”人类信息的智能网络。
在其体系结构中,第一层是Unicode(统一编码)和URI,它是整个语义网的基础。Unicode是处理资源的编码,URI负责标识资源;第二层是XML+名空间+XML模式,用于表示数据的内容和结构;第三层是RDF和RDF模式,用于描述资源及其类型;第四层是本体词汇,用于描述各种资源之间的联系;第五层是逻辑,在前面四层的基础上进行逻辑推理操作;第六层是验证,根据逻辑陈述进行验证以得出结论;第七层是信任,在用户间建立信任关系。其中,第二、三、四层是一个语义网的关键层,用于表示WEB信息的语义,也是现在语义网研究的热点所在。可扩展标记语言XML让每个人都能创建自己的信息标签,来对网页或页面的部分文字进行注释。资源描述框架RDF的基本结构是对象、属性和值所组成的三元组,也就相当于一个句子中的主语,动词和宾语。这些三元组可以用XML语法来表示。用这种结构描述并由机器处理大量数据,是非常自然的方法。RDF模式是一个描述RDF资源的属性(Property)和类(Class)的词汇表,提供了关于这些属性和类的层次结构的语义。
语义网知识表示综述
机械故障诊断专家系统中的语义网知识表示
一、 知识表示概述
知识表示就是知识的形式化和符号化的过程。知识表示就是为了计算机能够
识别客观知识而对客观世界知识所做的一组约定,是知识的符号化过程。知识表
示主要是选择合适的形式表达知识,寻找知识与知识表达之间的映射,其目的是
在利用计算机方便的表示、存储处理和利用人类的知识。简单地说,知识表示就
是应用程序对现实世界的建模;严格地说,知识表示的研究范围应该是知识表示
方法,研究什么样的描述方式最有利于程序的自动处理和自动推理。
知识表示是指将知识符号化并输入到计算机的过程和方法。知识表示是关于
各种数据结构及其解释过程的结合,知识表示方法研究各种数据结构的设计,以
及把一个问题领域的各种知识通过这些数据结构结合到计算机系统的程序设计
过程。对于同一种知识可以采用不同的表示方法。知识表示的目的不仅仅是要解
决知识在计算机中的存储问题,更重要的是要使这种表示能够方便地运用知识和
管理知识。知识表示的好坏,对知识处理的效率和应用范围,对知识的获取都有
直接的影响。
到目前为止,许多专家学者在把知识表示和知识运用结合起来研究的过程
中,提出了许多知识表示方法,如产生式规则表示法、框架表示法、一阶谓词逻
辑表示法、语义网络表示法、面向对象表示法等,这些表示法各适用于表示某种
类型的知识。由于各种知识表示方法的侧重点各不相同,在知识表示和知识运用
的过程中各有优缺点。
二、 语义网知识表示国内外研究现状
西蒙于1970年首先提出了语义网络概念,并于1972年把语义网络表示法应
用到语言理论系统中。语义网最早是为了解决web网页单调枯燥、搜索引擎智
能化低等问题而提出来的。最早把语义网络作为一种知识表示的工具是奎林
(J.R.Quilian),在其1968年的博士论文首次提出了语义网络知识表示方法。
语义网络实质上就是通过概念及其语义关系来表达知识的一种网络图。
语义网络的BNF描述:
::=|Merge(,…)
语义网及其应用
第28卷第5期 2011年10月 贵州大学学报(自然科学版) Journal of Guizhou University(Natural Sciences) Vol_28 No.5 0ct.201l
文章编号1000—5269(2011)05—0066—07
语义网及其应用
杨卓群 ,王以松
(贵州大学,贵州贵阳550025)
摘要:面对万维网信息化规模急剧膨胀、信息载体也趋于多元化等原因所带来的诸多困难,语
义网的提出为此提供了解决方案及技术支持,它利用对网络上的信息资源添加语义,达到不仅为 人们所理解,也可以使机器理解和处理的目的。本文首先介绍了语义网的背景、基本概念、技术
框架,然后阐述了语义网的结构框架以及各层次之间的协作关系与作用。结合一个实例,介绍了
基于Protrg6的本体创建和推理过程,以及对所建本体使用Jena和Pellet进行本体查询的方法。 最后,分析了语义网在信息检索、网络服务和医学领域的应用情况和研究意义,并提出了语义网
的一些发展方向。 关键词:语义网;本体;描述逻辑;Protrg6
中图分类号:TP181 文献标识码:A
万维网日益普及的使用使得社会信息化的程
度空前的提高,与此同时也极大地缩短了人与人之 间的距离,增进相互了解,另外也造成各个应用领
域所积累的信息量也在急速增长,整个万维网的规
模急剧膨胀。由于信息资源的载体多种多样,此外
所处的平台及其使用的语言和标准并不一致,这就 给各个领域信息资源的管理和使用带来诸多困难:
如何在海量异构的信息中有效地分类管理,使用户
可以准确迅速地找到所需要的信息;如何使应用程 序能够理解信息所蕴涵的语义,实现信息处理过程
的自动化;如何根据语义实现各种异构系统中的相
关信息的集成和协作等。 为了实现面向机器理解的Web,Tim Bemers-
Lee于2001年正式提出了语义万维网概念并给出 如下定义…:语义万维网是一个包含了文档和文
语义网基础教程
第一章概述
1.1万维网现状
万维网改变了人类彼此交流的方式和商业创作的方式。发达社会正在向知识经济和知识社会转型,而万维网处于这场革命的核心位置。
这种发展使得人们对计算机的看法也发生了变化。起初,计算机仅仅用作数值计算,而现在则主要用于信息处理,典型的应用包括数据库,文档处理和游戏等等。眼下,人们对计算机关注的焦点正在经历新的转变,将其视作信息高速公路的入口。
绝大部分现有的网络内容适合于人工处理。即使是从数据库自动生成的网络内容,通常也会丢弃原有的结构信息。目前万维网的典型应用方式是,人们在网上查找和使用信息、搜索和联系其他人、浏览网上商店的目录并且填表格订购商品等等。
现有软件工具没有很好的支持这些应用。除了建立文件间联系的链接之处,最优价值和必不可少的工具是搜索引擎。
基础关键词的搜索引擎,比如Alta Vista、Yahoo,Google等,是使用现有万维网的主要工具。毫无疑问,加入没有这些搜索引擎,万维网不会取得现在这么大的成功。然而,搜索引擎的使用也存在一些严重过的问题:
高匹配、低精度。即使搜到了主要相关页面,但它们与同时搜到的28758个低相关或不相关页面混在一起,检索的效果就很差。太多和太少一样令人不满意。
低匹配或无匹配。有时用户得不到任何搜索结果,或者漏掉了一些重要的相关页面。虽然对于现在的搜索引擎来说,这种情况发生的频率不高,但确实会出现。
检索结果对词汇高度敏感。使用最初填写的关键词往往不能得到想要的结果,因为祥光的文档里使用了与检索关键词不一样的术语。这当然令人不满意,因为语义相似的查询理应返回相似的结果。
检索结果是单一的网页。如果所需要的信息分布在不同的文档中,则用户必须给出多个查询来收集相关的页面,然后自己提取这些页面中的相关信息并组织成一个整体
有趣的是,尽管搜索引擎技术在发展,但主要的困难还是上述几条,技术的发展速度似乎落后于网上内容量的增长速度。