
统计学第七章、第八章课后题答案
.
精品 统计学复习笔记
第七章
参数估计
一、 思考题
1. 解释估计量和估计值
在参数估计中,用来估计总体参数的统计量称为估计量。估计量也是随机变量。如样本均值,样本比例、样本方差等。
根据一个具体的样本计算出来的估计量的数值称为估计值。
2. 简述评价估计量好坏的标准
(1)无偏性:是指估计量抽样分布的期望值等于被估计的总体参数。
(2)有效性:是指估计量的方差尽可能小。对同一总体参数的两个无偏估计量,有更小方差的估计量更有效。
(3)一致性:是指随着样本量的增大,点估计量的值越来越接近被估总体的参数。
3. 怎样理解置信区间
在区间估计中,由样本统计量所构造的总体参数的估计区间称为置信区间。置信区间的论述是由区间和置信度两部分组成。有些新闻媒体报道一些调查结果只给出百分比和误差(即置信区间),并不说明置信度,也不给出被调查的人数,这是不负责的表现。因为降低置信度可以使置信区间变窄(显得“精确”),有误导读者之嫌。在公布调查结果时给出被调查人数是负责任的表现。这样则可以由此推算出置信度(由后面给出的公式),反之亦然。
4. 解释95%的置信区间的含义是什么
置信区间95%仅仅描述用来构造该区间上下界的统计量(是随机的)覆盖总体参数的概率。也就是说,无穷次重复抽样所得到的所有区间中有95%(的区间)包含参数。
不要认为由某一样本数据得到总体参数的某一个95%置信区间,就以为该区间以0.95的概率覆盖总体参数。
5. 简述样本量与置信水平、总体方差、估计误差的关系。
1. 估计总体均值时样本量n为
2. 样本量n与置信水平1-α、总体方差、估计误差E之间的关系为 其中:
22222222)(EznnzE2.
精品 ▪ 与置信水平成正比,在其他条件不变的情况下,置信水平越大,所需要的样本量越大;
▪ 与总体方差成正比,总体的差异越大,所要求的样本量也越大;
▪ 与与总体方差成正比,样本量与估计误差的平方成反比,即可以接受的估计误差的平方越大,所需的样本量越小。
二、 练习题
1. 从一个标准差为5的总体中采用重复抽样方法抽出一个样本量为40的样本,样本均值为25。
1) 样本均值的抽样标准差xx等于多少?
2) 在95%的置信水平下,估计误差是多少?
解: 1) 已知σ = 5,n = 40, = 25
∵
∴ xx = 5 /√40 ≈ 0.79
2) 已知
∵
∴ 估计误差 E = 1.96×5÷√40 ≈ 1.55
2. 某快餐店想要估计每位顾客午餐的平均花费金额,在为期3周的时间里选取49名顾客组成了一个简单随机样本。
1) 假定总体标准差为15元,求样本均值的抽样标准误差。
2) 在95%的置信水平下,求估计误差。
3) 如果样本均值为120元,求总体均值µ的95%的置信区间。
解:1)已知σ = 15,n = 49
∵ xnxnx2nzE2nxnxnxnx.
精品 ∴ xx = 15÷√49 = 2.14
2)已知
∵
∴ 估计误差 E = 1.96×15÷√49 ≈ 4.2
3)已知 = 120
∵ 置信区间为 ±E
∴ 其置信区间 = 120±4.2
3. 从一个总体中随机抽取n =100的随机样本,得到 =104560,假定总体标准差σ = 85414,试构建总体均值µ的95%的置信区间。
解: 已知n =100, =104560,σ = 85414,1-a=95% ,
由于是正态总体,且总体标准差已知。总体均值m在1-a置信水平下的置信区间为
104560 ± 1.96×85414÷√100
= 104560 ±16741.144
4. 从总体中抽取一个n =100的简单随机样本,得到 =81,s=12。要求:
1) 构建µ的90%的置信区间。
2) 构建µ的95%的置信区间。
3) 构建µ的99%的置信区间。
解:由于是正态总体,但总体标准差未知。总体均值m在1-a置信水2nzE2xxxx228.109,44.10192.336.105251096.136.1052nzxx.
精品 平下的置信区间公式为
81±×12÷√100 = 81±×1.2
1)1-a=90%,1.65
其置信区间为 81 ± 1.98
2)1-a=95% ,
其置信区间为 81 ± 2.352
3) 1-a=99%,2.58
其置信区间为 81 ± 3.096
5. 利用下面的信息,构建总体均值的置信区间。
1) = 25,σ = 3.5,n =60,置信水平为95%
2) =119,s =23.89,n =75,置信水平为98%
3) =3.149,s =0.974,n =32,置信水平为90%
解:∵
∴ 1) 1-a=95% , 其置信区间为:25±1.96×3.5÷√60
= 25±0.885
2) 1-a=98% ,则a=0.02, a/2=0.01, 1-a/2=0.99,查标准正态分布表,可知: 2.33
其置信区间为: 119±2.33×23.89÷√75
= 119±6.345 xxx22未知)(22未知或nszxnzx.
精品 3) 1-a=90%,1.65
其置信区间为: 3.149±1.65×0.974÷√32
= 3.149±0.284
6. 利用下面的信息,构建总体均值µ的置信区间:
1) 总体服从正态分布,且已知σ = 500,n = 15, =8900,置信水平为95%。
解: N=15,为小样本正态分布,但σ已知。则1-a=95%,。其置信区间公式为
∴置信区间为:8900±1.96×500÷√15=(8646.7 , 9153.2)
2) 总体不服从正态分布,且已知σ = 500,n = 35, =8900,置信水平为95%。
解:为大样本总体非正态分布,但σ已知。则1-a=95%,。其置信区间公式为
∴置信区间为:8900±1.96×500÷√35=(8733.9 9066.1)
3) 总体不服从正态分布,σ未知,n = 35, =8900,s =500,置信水平为90%。
解:为大样本总体非正态分布,且σ未知,1-a=90%,1.65。
其置信区间为: 8900±1.65×500÷√35=(8761 9039)
4) 总体不服从正态分布,σ未知,n = 35, =8900,s =500,置信水平为99%。 228.109,44.10192.336.105251096.136.1052nzxxx228.109,44.10192.336.105251096.136.1052nzxxx.
精品 解:为大样本总体非正态分布,且σ未知,1-a=99%,2.58。
其置信区间为:8900±2.58×500÷√35=(8681.9
9118.1)
7. 某大学为了解学生每天上网的时间,在全校7500名学生中采取重复抽样方法随机抽取36人,调查他们每天上网的时间,得到下面的数据(单位:小时)(略)。求该校大学生平均上网时间的置信区间,置信水平分别为90%
解: 先求样本均值: = 3.32
再求样本标准差:
置信区间公式:
8. 从一个正态总体中随机抽取样本量为8的样本,各样本值分别为:10,8,12,15,6,13,5,11。求总体均值µ的95%置信区间。
解:本题为一个小样本正态分布,σ未知。
先求样本均值: = 80÷8=10
再求样本标准差:= √84/7 = 3.4641 .
精品 于是 , 的置信水平为 的置信区间是
,
已知 ,n = 8,则 ,α/2=0.025,查自由度为n-1 = 7的 分布表得临界值 2.45
所以,置信区间为: 10±2.45×3.4641÷√7
9. 某居民小区为研究职工上班从家里到单位的距离,抽取了由16个人组成的一个随机样本,他们到单位的距离分别是:10,3,14,8,6,9,12,11,7,5,10,15,9,16,13,2。假设总体服从正态分布,求职工上班从家里到单位平均距离的95%的置信区间。
解:小样本正态分布,σ未知。已知,n = 16,,则
, α/2=0.025,查自由度为n-1 = 15的 分布表得临界值
2.14
样本均值=150/16=9.375
再求样本标准差:= √253.75/15 ≈ 4.11
于是 , 的置信水平为 的置信区间是
, .
精品 9.375±2.14×4.11÷√16
10. 从一批零件是随机抽取36个,测得其平均长度是149.5,标准差是1.93。
1) 求确定该种零件平均长度的95%的置信区间。
2) 在上面估计中,你使用了统计中的哪一个重要定理?请解释。
解:1) 这是一个大样本分布。已知N=36, = 149.5,S =1.93,1-α=0.95,。
其置信区间为:149.5±1.96×1.93÷√36
2)中心极限定理论证:如果总体变量存在有限的平均数和方差,那么,不论这个总体的分布如何,随着样本容量 的增加,样本均值的分布便趋近正态分布。在现实生活中,一个随机变量服从正态分布未必很多,但是多个随机变量和的分布趋于正态分布则是普遍存在的。样本均值也是一种随机变量和的分布,因此在样本容量 充分大的条件下,样本均值也趋近于正态分布,这为抽样误差的概率估计理论提供了理论基础。
11. 某企业生产的袋装食品采用自动打包机包装,每袋标准重量为100克,现从某天生产的一批产品中按重复抽样随机抽取50包进行检查,测得每包重量如下:(略)
已知食品包重服从正态分布,要求:
1) 确定该种食品平均重量的95%的置信区间。
2) 如果规定食品重量低于100克属于不合格,确定该批食x
统计学概论课后答案第8章统计指数习题解答.
167
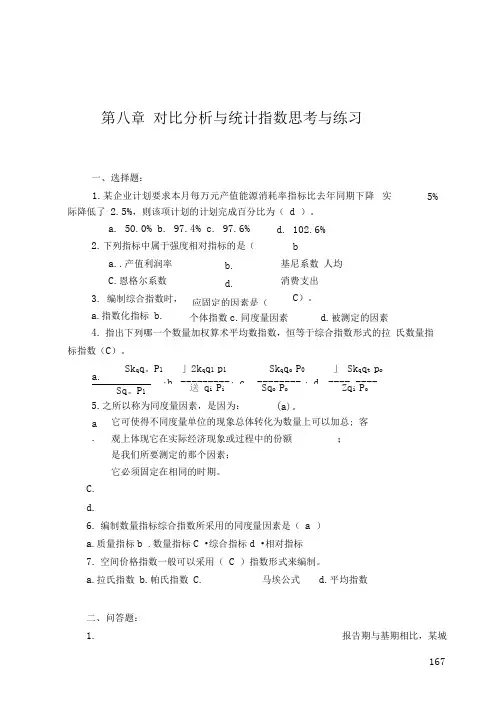
第八章 对比分析与统计指数思考与练习
4. 指出下列哪一个数量加权算术平均数指数,恒等于综合指数形式的拉 氏数量指标指数(C)。
C.
d.
6. 编制数量指标综合指数所采用的同度量因素是( a )
a.质量指标b .数量指标C •综合指标d •相对指标
7. 空间价格指数一般可以采用( C )指数形式来编制。
a.拉氏指数 b.帕氏指数 C. 马埃公式 d.平均指数
二、问答题:
1. 报告期与基期相比,某城一、选择题:
1.某企业计划要求本月每万元产值能源消耗率指标比去年同期下降 实际降低了 2.5%,则该项计划的计划完成百分比为( d )。
d. 102.6% 5%
a. 50.0% b. 97.4% c. 97.6%
2. 下列指标中属于强度相对指标的是(
a..产值利润率
C.恩格尔系数
3. 编制综合指数时,
a.指数化指标 b. b.
d.
应固定的因素是( b
基尼系数 人均消费支出
C)。
个体指数c.同度量因素 d.被测定的因素
Skqq。P1 」2kqq1 p1 Skqqo P0 」 Skqqt po
;b. --------- ; c. -------- ; d. ---- ---- a.
Sq。P1 送 qi Pi Sqo Po Zqi Po
5.之所以称为同度量因素,是因为:
它可使得不同度量单位的现象总体转化为数量上可以加总; 客观上体现它在实际经济现象或过程中的份额 ;
是我们所要测定的那个因素;
它必须固定在相同的时期。 (a)。
a. 168
市居民消费价格指数为 110%,居民可支配
收入增加了 20 %,试问居民的实际收入水平提高了多少?
解:(1+20% /110%-100%=109.10%-100%=9.10%
2. 某公司报告期能源消耗总额为 28.8万元,与去年同期相比,所耗能
源的价格平均上升了 20%那么按去年同期的能源价格计算,该公司报告期
统计学原理 第七章课后习题及答案
第七章 相关和回归
一、单项选择题
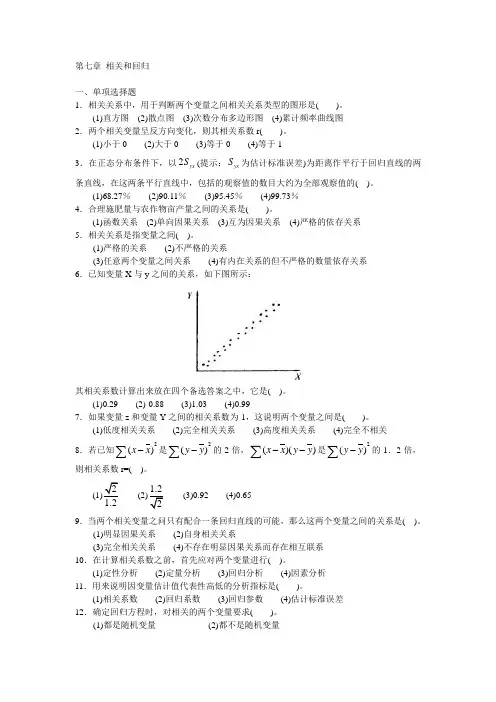
1.相关关系中,用于判断两个变量之间相关关系类型的图形是( )。
(1)直方图 (2)散点图 (3)次数分布多边形图 (4)累计频率曲线图
2.两个相关变量呈反方向变化,则其相关系数r( )。
(1)小于0 (2)大于0 (3)等于0 (4)等于1
3.在正态分布条件下,以2yxS(提示:yxS为估计标准误差)为距离作平行于回归直线的两条直线,在这两条平行直线中,包括的观察值的数目大约为全部观察值的( )。
(1)68.27% (2)90.11% (3)95.45% (4)99.73%
4.合理施肥量与农作物亩产量之间的关系是( )。
(1)函数关系 (2)单向因果关系 (3)互为因果关系 (4)严格的依存关系
5.相关关系是指变量之间( )。
(1)严格的关系 (2)不严格的关系
(3)任意两个变量之间关系 (4)有内在关系的但不严格的数量依存关系
6.已知变量X与y之间的关系,如下图所示:
其相关系数计算出来放在四个备选答案之中,它是( )。
(1)0.29 (2)-0.88 (3)1.03 (4)0.99
7.如果变量z和变量Y之间的相关系数为-1,这说明两个变量之间是( )。
(1)低度相关关系 (2)完全相关关系 (3)高度相关关系 (4)完全不相关
8.若已知2()xx是2()yy的2倍,()()xxyy是2()yy的1.2倍,则相关系数r=( )。
(1)21.2 (2)1.22 (3)0.92 (4)0.65
9.当两个相关变量之问只有配合一条回归直线的可能,那么这两个变量之间的关系是( )。
(1)明显因果关系 (2)自身相关关系
医学统计学第七版课后答案及解析
__________________________________________________
__________________________________________________ 医学统计学第七版课后答案
第一章 绪 论
一、单项选择题
答案1. D 2. E 3. D 4. B 5. A 6. D 7. A
8. C 9. E 10. D
二、简答题
1答由样本数据获得的结果,需要对其进行统计描述和统计推断,统计描述可以使数据更容易理解,统计推断则可以使用概率的方式给出结论,两者的重要作用在于能够透过偶然现象来探测具有变异性的医学规律,使研究结论具有科学性。
2答医学统计学的基本内容包括统计设计、数据整理、统计描述和统计推断。统计设计能够提高研究效率,并使结果更加准确和可靠,数据整理主要是对数据进行归类,检查数据质量,以及是否符合特定的统计分析方法要求等。统计描述用来描述及总结数据的重要特征,统计推断指由样本数据的特征推断总体特征的方法,包括参数估计和假设检验。
3答统计描述结果的表达方式主要是通过统计指标、统计表和统计图,统计推断主要是计算参数估计的可信区间、假设检验的P 值得出相互比较是否有差别的结论。 __________________________________________________ __________________________________________________ 4答统计量是描述样本特征的指标,由样本数据计算得到,参数是描述总体分布特征的指标可由“全体”数据算出。
5答系统误差、随机测量误差、抽样误差。系统误差由一些固定因素产生,随机测量误差是生物体的自然变异和各种不可预知因素产生的误差,抽样误差是由于抽样而引起的样本统计量与总体参数间的差异。
6答三个总体一是“心肌梗死患者”所属的总体二是接受尿激酶原治疗患者所属的总体三是接受瑞替普酶治疗患者所在的总体。
大学统计学第八章课后题答案
第八章 相关与回归分析
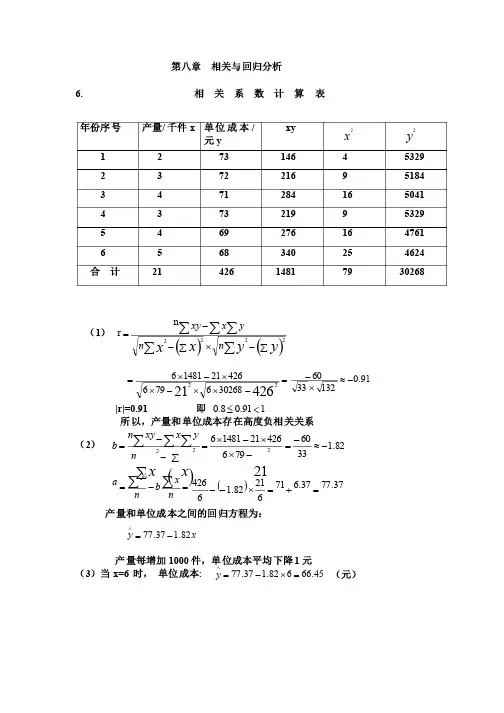
6. 相 关 系 数 计 算 表
(1)
()()
ååååå
å-´
å--
=
yyx
x
nnyxxy
222
2n
r
91.0
1323360
3026867964262114816
4262122-»
´-
=
-´´-´´-´
=
|r|=0.91 即 191.08.0
<£
所以,产量和单位成本存在高度负相关关系
(2)
()82.1
3360
7964262114816
2122
2-»-
=
-´´-´
=
å--
=
åååå
xxnyxxyn
b
=-=åå
nx
b
ny
a
()
37.7737.671
621
82.1
6426
=+=´--
产量和单位成本之间的回归方程为:
xy82.137.77
-=Ù
产量每增加1000件,单位成本平均下降1元
(3)当x=6 时, 单位成本: 45.66682.137.77
=´-=Ù
y
(元)
年份序号 产量/千件x 单位成本/
元y xy
x2
y2
1 2 73 146 4 5329
2 3 72 216 9 5184
3 4 71 284 16 5041
4 3 73 219 9 5329
5 4 69 276 16 4761
6 5 68 340 25 4624
合 计 21 426 1481 79 30268
7. 相 关 系 数 计 算 表
序号 汽车使用年
限/年x 年维修费用
/元y xy
x2 y
2
1 2 400 800 4 160000
2 2 540 1080 4 291600
3 3 520 1560 9 270400
4 4 640 2560 16 409600
5 4 740 2960 16 547600
6 5 600 3000 25 360000
7 5 800 4000 25 640000
8 6 700 4200 36 490000
9 6 760 4560 36 577600
10 6 900 5400 36 810000
统计学课后习题答案(全章节)剖析

第二章、练习题及解答
2.为了确定灯泡的使用寿命(小时),在一批灯泡中随机抽取100只进行测试,所得结果如下:
700 716 728 719 685 709 691 684 705 718
706 715 712 722 691 708 690 692 707 701
708 729 694 681 695 685 706 661 735 665
668 710 693 697 674 658 698 666 696 698
706 692 691 747 699 682 698 700 710 722
694 690 736 689 696 651 673 749 708 727
688 689 683 685 702 741 698 713 676 702
701 671 718 707 683 717 733 712 683 692
693 697 664 681 721 720 677 679 695 691
713 699 725 726 704 729 703 696 717
688
要求:
(2)以组距为10进行等距分组,生成频数分布表,并绘制直方图。
灯泡的使用寿命频数分布表
分组 频数(只) 频率(%)
650-660 2 2
660-670 5 5
670-680 6
6
680-690 14 14
690-700 26 26
700-710 18 18
710-720 13 13
720-730
10 10
730-740 3 3
740-750 3 3
合计 100 100
3.某公司下属40个销售点2012年的商品销售收入数据如下: 单位:万元
152 124 129 116 100 103 92 95 127 104
105 119 114 115 87 103 118 142 135 125
117 108 105 110 107 137 120 136 117 108
统计学第七章、第八章汇总

1 1 统计学复习笔记
第七章 参数估计
一、 思考题
1. 解释估计量和估计值
在参数估计中,用来估计总体参数的统计量称为估计量。估计量也是随机变量。如样本均值,样本比例、样本方差等。
根据一个具体的样本计算出来的估计量的数值称为估计值。
2. 简述评价估计量好坏的标准
(1)无偏性:是指估计量抽样分布的期望值等于被估计的总体参数。
(2)有效性:是指估计量的方差尽可能小。对同一总体参数的两个无偏估计量,有更小方差的估计量更有效。
(3)一致性:是指随着样本量的增大,点估计量的值越来越接近被估总体的参数。
3. 怎样理解置信区间
在区间估计中,由样本统计量所构造的总体参数的估计区间称为置信区间。置信区间的论述是由区间和置信度两部分组成。有些新闻媒体报道一些调查结果只给出百分比和误差(即置信区间),并不说明置信度,也不给出被调查的人数,这是不负责的表现。因为降低置信度可以使置信区间变窄(显得“精确”),有误导读者之嫌。在公布调查结果时给出被调查人数是负责任的表现。这样则可以由此推算出置信度(由后面给出的公式),反之亦然。
4. 解释95%的置信区间的含义是什么
置信区间95%仅仅描述用来构造该区间上下界的统计量(是随机的)覆盖总体参数的概率。也就是说,无穷次重复抽样所得到的所有区间中有95%(的区间)包含参数。
不要认为由某一样本数据得到总体参数的某一个95%置信区间,就以为该区间以0.95的概率覆盖总体参数。
5. 简述样本量与置信水平、总体方差、估计误差的关系。
1. 估计总体均值时样本量n为
2. 样本量n与置信水平1-α、总体方差、估计误差E之间的关系为 其中: 2222)(EznnzE22 2 与置信水平成正比,在其他条件不变的情况下,置信水平越大,所需要的样本量越大;
与总体方差成正比,总体的差异越大,所要求的样本量也越大;
与与总体方差成正比,样本量与估计误差的平方成反比,即可以接受的估计误差的平方越大,所需的样本量越小。
统计学课后习题答案第七章相关分析与回归分析
统计学课后习题答案第七章相关分析与回归分析
第七章相关分析与回归分析
⼀、单项选择题1、相关分析就是研究变量之间得
A、数量关系
B、变动关系
C、因果关系
D、相互关系得密切程度
2、在相关分析中要求相关得两个变量
A、都就是随机变量
B、⾃变量就是随机变量
C、都不就是随机变量
D、因变量就是随机变量
3、下列现象之间得关系哪⼀个属于相关关系?
A、播种量与粮⾷收获量之间关系
B、圆半径与圆周长之间关系
C、圆半径与圆⾯积之间关系
D、单位产品成本与总成本之间关系
4、正相关得特点就是
A、两个变量之间得变化⽅向相反
B、两个变量⼀增⼀减
C、两个变量之间得变化⽅向⼀致
D、两个变量⼀减⼀增
5、相关关系得主要特点就是两个变量之间
A、存在着确定得依存关系
B、存在着不完全确定得关系
C、存在着严重得依存关系
D、存在着严格得对应关系
6、当⾃变量变化时, 因变量也相应地随之等量变化,则两个变量
之间存在着A、直线相关关系
B、负相关关系
C、曲线相关关系
D、正相关关系
7、当变量X值增加时,变量Y值都随之下降,则变量X与Y之间存在着A、正相关关系
B、直线相关关系
C、负相关关系
D、曲线相关关系
8、当变量X值增加时,变量Y值都随之增加,则变量X与Y之间存
在着A、直线相关关系
B、负相关关系
C、曲线相关关系
D、正相关关系
9、判定现象之间相关关系密切程度得最主要⽅法就是
A.对现象进⾏定性分析 B、计算相关系数
C、编制相关表
D、绘制相关图
10、相关分析对资料得要求就是
A.⾃变量不就是随机得,因变量就是随机得
B、两个变量均不就是随机得
C、⾃变量就是随机得,因变量不就是随机得
D、两个变量均为随机得
11、相关系数
A、既适⽤于直线相关,⼜适⽤于曲线相关
B、只适⽤于直线相关
C、既不适⽤于直线相关,⼜不适⽤于曲线相关
D、只适⽤于曲线相关
12、两个变量之间得相关关系称为
A、单相关
B、复相关
C、不相关
D、负相关
13、相关系数得取值范围就是
A、-1≤r≤1
B、-1≤r≤0
C、0≤r≤1
贾俊平统计学第7版 第八章例题课后习题
第8章假设检验
例题
8.1
由统计资料得知,1989 年某地新生儿的平均体重为3190克,现从1990年的新生儿中国机抽取100个,测得其平均体重为3210克,问1990年的新生儿与1989年相比,体重有无显著差异?
★解:从调查结果看,1990 年新生儿的平均体重为3210克,比1989年新生儿的平均体重3190克增加了20克,但这20克的差异可能源于不同的情况。_种情况是,1990 年新生儿的体重与1989年相比没有什么差别,20克的差异是由于抽样的随机性造成的;另一种情况是,抽样的随机性不可能造成20克这样大的差异,1990年新生儿的体重与1989年新生儿的体重相比确实有所增加。
上述问题的关键点是,20克的差异说明了什么?这个差异能不能用抽样的随机性来解释?为了回答这个问题,我们可以采取假设的方法。假设1989年和1990年新生儿的体重没有显著差异,如果用μo表示1989年新生儿的平均体重,μ表示1990年新生儿的平均体重,我们的假设可以表示为μ=μ或μ心=0,现要利用1990年新生儿体重的样本信息检验上述假设是否成立。如果成立,说明这两年新生儿的体重没有显著差异;如果不成立,说明1990年新生儿的体重有了明显增加。在这里,问题是以假设的形式提出的,问题的解决方案是检验提出的假设是否成立。所以假设检验的实质是检验我们关心的参数一1990 年的新生儿总体平均体重是否等于某个我们感兴趣的数值。
例8.2
某批发商欲从厂家购进一批灯泡,根据合同规定灯泡的使用寿命平均不能低于1 000小时,已知灯泡燃烧寿命服从正态分布,标准差为200小时。在总体中随机抽取了100个灯泡,得知样本均值为960小时,批发商是否应该购买这批灯泡?
★解:这是一个单侧检验问题。显然,如果灯泡的燃烧寿命超过了1 000小时,批发商是欢迎的,因为他用已定的价格(灯泡寿命为1 000小时的价格)购进了更高质量的产品。因此,如果样本均值超过1000小时,他会购进这批灯泡。问题在于样本均值为960小时他是否应当购进。因为即便总体均值为1000小时,由于抽样的随机性,样本均值略小于1000小时的情况也会经常出现。在这种场合下,批发商更为关注可以容忍的下限,即当灯泡寿命低于什么水平时拒绝。于是检验的形式为:
统计学课后练答案
第七章 参数估计
(1) xn540=
(2) 2xzn=51.9640=
某快餐店想要估计每位顾客午餐的平均花费金额。在为期3周的时间里选取49名顾客组成了一个简单随机样本。
(1)假定总体标准差为15元,求样本均值的抽样标准误差。xn1549=
(2)在95%的置信水平下,求估计误差。
xxt,由于是大样本抽样,因此样本均值服从正态分布,因此概率度t=2z
因此,xxt2xz0.025xz=×=
(3)如果样本均值为120元,求总体均值 的95%的置信区间。
置信区间为:22,xzxznn=1204.2,1204.2=(,)
22,xzxznn=854141045601.96100=(,)
从总体中抽取一个n=100的简单随机样本,得到x=81,s=12。
要求:
大样本,样本均值服从正态分布:2,xNn:或2,sxNn:
置信区间为:22,ssxzxznn,sn=12100=
(1)构建的90%的置信区间。
2z=0.05z=,置信区间为:811.6451.2,811.6451.2=(,)
(2)构建的95%的置信区间。
2z=0.025z=,置信区间为:811.961.2,811.961.2=(,)
(3)构建的99%的置信区间。
2z=0.005z=,置信区间为:812.5761.2,812.5761.2=(,)
(1)2xzn=3.5251.9660=(,)
(2)2sxzn=23.89119.62.32675=(,)
(3)2sxzn=0.9743.4191.64532=(,)
(1)2xzn=50089001.9615=(,)
贾俊平统计学第7版第八章例题课后习题
贾俊平统计学第7版第⼋章例题课后习题
第8章假设检验
例题
8.1
由统计资料得知,1989 年某地新⽣⼉的平均体重为3190克,现从1990年的新⽣⼉中国机抽取100个,测得其平均体重为3210
克,问1990年的新⽣⼉与1989年相⽐,体重有⽆显著差异?
★解:从调查结果看,1990 年新⽣⼉的平均体重为3210克,⽐1989年新⽣⼉的平均体重3190克增加了20克,但这20克的差异
可能源于不同的情况。_种情况是,1990 年新⽣⼉的体重与1989年相⽐没有什么差别,20克的差异是由于抽样的随机性造成
的;另⼀种情况是,抽样的随机性不可能造成20克这样⼤的差异,1990年新⽣⼉的体重与1989年新⽣⼉的体重相⽐确实有所增
加。
上述问题的关键点是,20克的差异说明了什么?这个差异能不能⽤抽样的随机性来解释?为了回答这个问题,我们可以采取假设
的⽅法。假设1989年和1990年新⽣⼉的体重没有显著差异,如果⽤µo表⽰1989年新⽣⼉的平均体重,µ表⽰1990年新⽣⼉的
平均体重,我们的假设可以表⽰为µ=µ或µ⼼=0,现要利⽤1990年新⽣⼉体重的样本信息检验上述假设是否成⽴。如果成⽴,
说明这两年新⽣⼉的体重没有显著差异;如果不成⽴,说明1990年新⽣⼉的体重有了明显增加。在这⾥,问题是以假设的形式
提出的,问题的解决⽅案是检验提出的假设是否成⽴。所以假设检验的实质是检验我们关⼼的参数⼀1990 年的新⽣⼉总体平
均体重是否等于某个我们感兴趣的数值。
例8.2
某批发商欲从⼚家购进⼀批灯泡,根据合同规定灯泡的使⽤寿命平均不能低于1 000⼩时,已知灯泡燃烧寿命服从正态分布,
标准差为200⼩时。在总体中随机抽取了100个灯泡,得知样本均值为960⼩时,批发商是否应该购买这批灯泡?
★解:这是⼀个单侧检验问题。显然,如果灯泡的燃烧寿命超过了1 000⼩时,批发商是欢迎的,因为他⽤已定的价格(灯泡寿命
为1 000⼩时的价格)购进了更⾼质量的产品。因此,如果样本均值超过1000⼩时,他会购进这批灯泡。问题在于样本均值为960⼩时他是否应当购进。因为即便总体均值为1000⼩时,由于抽样的随机性,样本均值略⼩于1000⼩时的情况也会经常出