
【CN110188785A】一种基于遗传算法的数据聚类分析方法【专利】
(19)中华人民共和国国家知识产权局(12)发明专利申请(10)申请公布号 (43)申请公布日 (21)申请号 201910242200.0(22)申请日 2019.03.28(71)申请人 山东浪潮云信息技术有限公司地址 250100 山东省济南市高新区浪潮路1036号浪潮科技园S06号楼(72)发明人 王利鑫 (74)专利代理机构 济南信达专利事务所有限公司 37100代理人 姜明(51)Int.Cl.G06K 9/62(2006.01)G06N 3/12(2006.01)
(54)发明名称一种基于遗传算法的数据聚类分析方法(57)摘要本发明特别涉及一种基于遗传算法的数据聚类分析方法。该基于遗传算法的数据聚类分析方法,首先从要聚类的样本集选出初始种群;对选出的初始种群执行遗传算法;对执行完遗传算法后产生的新种群执行K-means操作;步骤(A)-步骤(C)反复循环,直到寻找出聚类问题的最优解。该基于遗传算法的数据聚类分析方法,将K-means算法的局部寻优与遗传算法的全局寻优相结合,通过多次选择、交叉、变异的遗传操作,最终得到最优的聚类数和初始质心集,克服了传统K-means算法的局部性和对初始聚类中心的敏感性,
实现了对数据的有效分类。
权利要求书2页 说明书6页CN 110188785 A2019.08.30
CN 110188785
A1.一种基于遗传算法的数据聚类分析方法,其特征在于,包括以下步骤:(A)首先从要聚类的样本集选出初始种群;(B)对选出的初始种群执行遗传算法;(C)对执行完遗传算法后产生的新种群执行K-means操作;(D)步骤(A)-步骤(C)反复循环,直到寻找出聚类问题的最优解。2.根据权利要求1所述的基于遗传算法的数据聚类分析方法,其特征在于:所述步骤(A)中,初始群体随机生成,具体步骤如下:(1)首先从样本空间中随机选出k个个体,每个个体表示一个初始聚类中心;(2)然后根据所采用的编码方式将这组随机选出的初始聚类中心编码成一条染色体;(3)重复进行m次染色体初始化,直到生成初始种群,所述m为种群大小。3.根据权利要求2所述的基于遗传算法的数据聚类分析方法,其特征在于:所述步骤(2)中,染色体编码采用基于聚类中心的浮点数编码方法。4.根据权利要求1所述的基于遗传算法的数据聚类分析方法,其特征在于:所述步骤(B)中,对选出的初始种群执行遗传算法,包括以下步骤:(1)采用锦标赛选择法进行选择操作,随机地从种群中挑选一定数目的个体,然后从中选出适应度最大的个体作为父个体,重复迭代该步骤直到父个体的总数达到种群规模;(2)采用适合浮点数编码的算术交叉算子对两个相互配对的染色体进行交叉操作,形成两个新的个体;(3)采用均匀变异算子对交叉操作得到的新个体染色体编码串进行变异操作,从而形成一个新的个体。5.根据权利要求4所述的基于遗传算法的数据聚类分析方法,其特征在于:所述步骤(1)中,适应度是用来评价个体的适应度,区别群体中个体优劣的标准;个体的适应度越高,其存活的概率就越大;由于聚类准则函数J越小说明聚类划分的质量越好,聚类准则函数J越大说明聚类划分的质量越差,因此适应度函数表示为:
其中,聚类准则函数J公式为:
其中,k为聚类类别数,Sj为第j个类别的样本集合,x为样本对象,zj为Sj集合的聚类中心。6.根据权利要求4所述的基于遗传算法的数据聚类分析方法,其特征在于:所述步骤(2)中,交叉操作是指对两个相互配对的染色体按某种方式相互交换部分基因,从而形成两个新的个体;算术交叉是指由两个个体的线性组合而产生出两个新的个体;当在两个个体x1和x2之间进行算术交叉时,交叉操作后产生的新个体为:
其中,α是交叉参数,在均匀算术交叉中α
是一个常数。权 利 要 求 书1/2页
2CN 110188785 A
【CN110009039A】一种非独立同分布下聚类分析方法及系统【专利】
(19)中华人民共和国国家知识产权局(12)发明专利申请(10)申请公布号 (43)申请公布日 (21)申请号 201910271924.8(22)申请日 2019.04.04(71)申请人 齐鲁工业大学地址 250353 山东省济南市长清区大学路3501号(72)发明人 姜合 吕奕锟 (74)专利代理机构 济南圣达知识产权代理有限公司 37221代理人 杨晓冰(51)Int.Cl.G06K 9/62(2006.01)
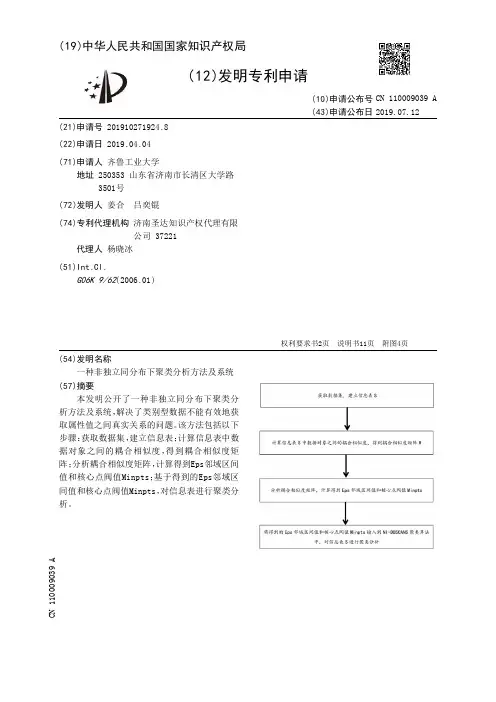
(54)发明名称一种非独立同分布下聚类分析方法及系统(57)摘要本发明公开了一种非独立同分布下聚类分析方法及系统,解决了类别型数据不能有效地获取属性值之间真实关系的问题。该方法包括以下步骤:获取数据集,建立信息表;计算信息表中数据对象之间的耦合相似度,得到耦合相似度矩阵;分析耦合相似度矩阵,计算得到Eps邻域区间值和核心点阀值Minpts;基于得到的Eps邻域区间值和核心点阀值Minpts,对信息表进行聚类分
析。
权利要求书2页 说明书11页 附图4页CN 110009039 A2019.07.12
CN 110009039
A1.一种非独立同分布下聚类分析方法,其特征是,包括以下步骤:获取数据集,建立信息表;计算信息表中数据对象之间的耦合相似度,得到耦合相似度矩阵;分析耦合相似度矩阵,计算得到E邻域区间值和核心点阀值;基于得到的E邻域区间值和核心点阀值,对信息表进行聚类分析。2.根据权利要求1所述的非独立同分布下聚类分析方法,其特征是,所述获取数据集,建立信息表的步骤包括:获取数据集,所述数据集包括若干个数据对象和多个属性;对数据集进行数据集成以及数据清洗处理;将预处理后的数据集形成信息表,所述信息表中行表示属性特征,列表示数据对象,行对应的列表示属性值。3.根据权利要求1所述的非独立同分布下聚类分析方法,其特征是,所述计算信息表中数据对象之间的耦合相似度的步骤包括:利用信息表中各数据对象在相应特征上的属性值等于任意两个属性值的数据对象集合,计算信息表中各数据对象的内部耦合属性值相似度;利用信息表中特征的权重与任意两个数据对象的属性值分布情况,计算任意两个数据对象之间耦合属性值相似度;将各数据对象内部耦合属性值相似度与任意两个数据对象之间耦合属性值相似度相乘,得到信息表中任意两个数据对象之间的耦合相似度;基于信息表中任意两个数据对象之间的耦合相似度和各数据对象内部耦合属性值相似度,建立耦合相似度矩阵。4.根据权利要求1所述的非独立同分布下聚类分析方法,其特征是,所述分析耦合相似度矩阵,计算得到E邻域区间值和核心点阀值的步骤包括:任意选取耦合相似度矩阵中的多行元素,绘制散点图,将数据的分界点的值作为Ε邻域区间的下限值;选取耦合相似度矩阵中各行大于Ε邻域区间的下限值的数据值,并对其进行升序排列,得到K-近邻矩阵;设定核心点阀值,选取K-近邻矩阵中第k列中最大值作为Ε邻域区间值的上限值,其中,k的取值等于核心点阀值。5.根据权利要求1所述的非独立同分布下聚类分析方法,其特征是,所述对信息表进行聚类分析的步骤包括:从信息表中随机取出一个未被处理的数据对象p,扫描信息表,查找数据对象p的邻域数据的个数,判断数据对象p是否为核心数据对象;若数据对象p为核心数据对象,则对信息表中其他数据对象进行密度可达和密度相连处理,并标记类标签;如果p不为核心数据对象,标记已处理过,不标记类标签,等待其他数据进行密度可达或者密度相连时处理,若始终未被标记类标签,则标记为噪声点;重复上述步骤,直到信息表中所有数据对象都被标记为已处理,对于没有类标记的数据对象作为噪声处理,
一种新的基于遗传算法的动态聚类算法
一种新的基于遗传算法的动态聚类算法
陆林花
【期刊名称】《计算机仿真》
【年(卷),期】2009(0)7
【摘 要】为了在聚类数不明确的情况下实现聚类分析,提出一种新的结合最近邻聚类和遗传算法的动态聚类算法.新算法包括两个阶段:第一阶段用最近邻聚类算法根据最近邻方法把最相似的实例分到同一个簇中并根据一些相似性或相异性度量过滤掉噪声数据从而得到初始聚类集,第二阶段是遗传优化阶段,利用动态聚类评估函数,动态地合并初始聚类集,从而获得接近最优的解.最后对算法进行了实验仿真,实验结果表明方法在事先不知道聚类数的情况下能够有效地进行聚类.
【总页数】5页(P122-125,158)
【作 者】陆林花
【作者单位】福州大学阳光学院,福建福州,350015
【正文语种】中 文
【中图分类】TP301.6
【相关文献】
1.一种改进的基于遗传算法的K均值聚类算法 [J], 唐朝霞
2.一种基于遗传算法改进的蚁群聚类算法 [J], 秦福高
3.基于遗传算法的一种改进的K-均值聚类算法 [J], 张春凯;王丽君
4.一种基于改进遗传算法的 WSN 负载均衡聚类算法 [J], 杨建;刘述木;黎远松
5.一种基于遗传算法的K-means聚类算法 [J], 王娟 因版权原因,仅展示原文概要,查看原文内容请购买
【CN110135156A】一种基于沙盒动态行为识别可疑攻击代码的方法【专利】
(19)中华人民共和国国家知识产权局(12)发明专利申请(10)申请公布号 (43)申请公布日 (21)申请号 201910264929.8(22)申请日 2019.04.03(71)申请人 浙江工业大学地址 310014 浙江省杭州市下城区潮王路18号(72)发明人 赵澄 倪闻清 陈君新 (74)专利代理机构 杭州天正专利事务所有限公司 33201代理人 王兵 黄美娟(51)Int.Cl.G06F 21/56(2013.01)
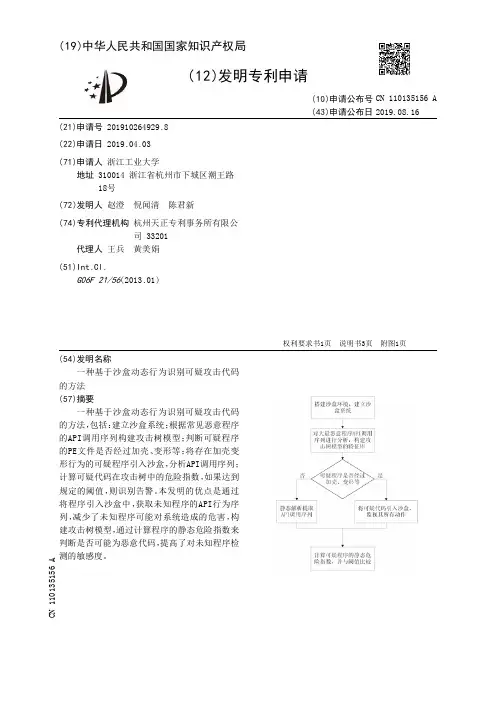
(54)发明名称一种基于沙盒动态行为识别可疑攻击代码的方法(57)摘要一种基于沙盒动态行为识别可疑攻击代码的方法,包括:建立沙盒系统;根据常见恶意程序的API调用序列构建攻击树模型;判断可疑程序的PE文件是否经过加壳、变形等;将存在加壳变形行为的可疑程序引入沙盒,分析API调用序列;计算可疑代码在攻击树中的危险指数,如果达到规定的阈值,则识别告警。本发明的优点是通过将程序引入沙盒中,获取未知程序的API行为序列,减少了未知程序可能对系统造成的危害,构建攻击树模型,通过计算程序的静态危险指数来判断是否可能为恶意代码,提高了对未知程序检
测的敏感度。
权利要求书1页 说明书3页 附图1页CN 110135156 A2019.08.16
CN 110135156
A1.一种基于沙盒动态行为识别可疑攻击代码的方法,包括以下步骤:1)、建立沙盒,沙盒系统包括沙盒子系统,行为获取系统,行为分析系统,系统界面;2)、构建攻击树模型,对大量恶意代码行为进行分析,根据恶意代码最常用的API序列构建攻击树模型的特征库;具体包括:以传统攻击树为基础,对每个节点加入了权值集合,于是攻击树T可表示为一个三元组:T=(V,E,Weight),其中T为以节点为集合元素的非空有限集合;E为树中边的集合;Weight为节点权值集合;根据恶意程序中常见的API行为序列及序列间的关系,构建攻击树,并作为匹配依据。每一个未知程序都对应一个静态危险指数,记作danger(T),通过对程序的计算得出,此值可以量化未知程序与恶意程序的相似程度,值越高代表危险系数越大,越接近恶意程序,节点静态危险指数的计算公式为:
一种基于遗传算法的聚类新方法

一种基于遗传算法的聚类新方法
张伟;廖晓峰;吴中福
【期刊名称】《计算机科学》
【年(卷),期】2002(029)006
【摘 要】@@ 1引言rn数据挖掘是从大量的、不完全的、有噪声的、模糊的、随机的数据中,提取隐含在其中的、人们事先不知道的、但又是潜在有用的信息和知识的过程.数据挖掘更广义的说法是[1]:数据挖掘意味着在一些事实或观察数据的集合中寻找模式的决策支持过程.人们把原始数据看作是形成知识的源泉,就像从矿石中采矿一样.
【总页数】3页(P114-116)
【作 者】张伟;廖晓峰;吴中福
【作者单位】重庆大学计算机科学与工程学院,重庆,400044;重庆教育学院计算机与现代教育技术系,重庆,400067;重庆大学计算机科学与工程学院,重庆,400044;重庆大学计算机科学与工程学院,重庆,400044
【正文语种】中 文
【中图分类】TP18
【相关文献】
1.一种基于动态遗传算法的聚类新方法 [J], 何宏;谭永红
2.一种基于小生境遗传算法的中文文本聚类新方法 [J], 赵亚琴;周献中
3.一种MapReduce架构下基于遗传算法的K-Medoids聚类 [J], 赖向阳;宫秀军;韩来明
4.一种基于遗传算法的聚类分析方法在DNA序列比较中的应用 [J], 冯杰;张弘
5.一种基于分组遗传算法的聚类新方法 [J], 曹永春;邵亚斌;田双亮;蔡正琦
因版权原因,仅展示原文概要,查看原文内容请购买
基于遗传算法与密度及距离计算的聚类方法

基于遗传算法与密度及距离计算的聚类方法
王泽;张宏军;张睿;贺邓超
【摘 要】为解决聚类中心选择困难和数据点密度计算泛化能力弱的问题,提出一种基于遗传算法与密度及距离计算的聚类方法.该算法通过指数方法计算数据点密度,降低参数对算法性能的影响;用遗传算法搜索最优密度和距离阈值,同时引入惩罚因子,克服算法搜索域偏移从而提高收敛速度,寻找最优聚类中心,并用归属方法完成聚类.通过4组人工数据集和4组UCI数据集实验证明,该方法在RI指数、聚类精度、聚类纯度、召回率等4个聚类评价指标上都达到与K-means算法、快速搜索聚类算法和Max_Min_SD算法相当或更好的效果,算法是有效的.
【期刊名称】《计算机应用》
【年(卷),期】2015(035)011
【总页数】5页(P3243-3246,3251)
【关键词】遗传算法;聚类;密度;距离
【作 者】王泽;张宏军;张睿;贺邓超
【作者单位】解放军理工大学指挥信息系统学院,南京210007;解放军理工大学指挥信息系统学院,南京210007;解放军理工大学指挥信息系统学院,南京210007;解放军理工大学指挥信息系统学院,南京210007
【正文语种】中 文
【中图分类】TP391.4
0 引言
在机器学习与模式识别领域,聚类是一种搜索数据簇的无监督学习技术,目标在于将数据集分成不同的类簇,并要求同一类簇的实体相似,不同类簇的实体相似度尽可能小[1-2]。目前常用的聚类方法有K-means聚类算法[3]、具有噪声的基于密度的聚类(Density-Based Spatial Clustering of Applications with
Noise,DBSCAN)算法[4]、基于近邻传播聚类算法(Affinity Propagation,AP)[5]等。K-means算法一般使用随机方法生成初始聚类中心集,之后经过多次迭代得到最佳聚类中心生成聚类结果;DBSCAN聚类算法产生的思想是一个聚类可以由其中的任何核心对象唯一确定,算法的第一个步骤便是找到一个聚类中心点。随机生成的聚类中心集往往达不到好的聚类效果,为了得到更好的聚类质量,一些算法迭代的次数大量增加,算法效率低下。因此,聚类中心的选择是决定聚类质量的关键,也是许多聚类算法中的一个难点。
一种动态流式数据的聚类方法

一种动态流式数据的聚类方法
(19)中华人民共和国国家知识产权局
(12)发明专利申请
(10)申请公布号
CN107273930A
(43)申请公布日 2017.10.20(21)申请号CN201710454380.X
(22)申请日2017.06.14
(71)申请人成都四方伟业软件股份有限公司
地址610041 四川省成都市高新区科园三路4号1栋2层
(72)发明人蓝科;王纯斌;王勇;覃进学
(74)专利代理机构成都金英专利代理事务所(普通合伙)
代理人袁英
(51)Int.CI
权利要求说明书说明书幅图
(54)发明名称
一种动态流式数据的聚类方法
(57)摘要
本发明公开了一种动态流式数据的聚类方
法,该方法包括以下步骤:将结构化数据转化为
时间字段流数据,随之时间字段排序后得到时间
片求出并集;构建训练模型,对缺失数据构建
HMM预测;检查数据有效性,对重复数据点新增
时间片;剔除异常数据,根据全部时间片,检查
是否存在波动异常的数据;质心数据聚类。本发
明针对数据的特性进行了专项优化、针对缺失数
据,使用HMM进行预测、针对同时间片中同一标
基于遗传算法与密度及距离计算的聚类方法 2
Journal of Computer Applications 计算机应用,2015,35(11):3243—3246,3251 ISSN 1001.9081 CODEN JYIIDU 2015—11—10 http://www.joca.an
文章编号:1001.9081(2015)11.3243.04 doi:10.11772/j.issn.1001—9081.2015.11.3243
基于遗传算法与密度及距离计算的聚类方法
王泽‘,张宏军,张睿,贺邓超
(解放军理工大学指挥信息系统学院,南京210007) (}通信作者电子邮箱Luxtre@163.com)
摘要:为解决聚类中心选择困难和数据点密度计算泛化能力弱的问题,提出一种基于遗传算法与密度及距离
计算的聚类方法。该算法通过指数方法计算数据点密度,降低参数对算法性能的影响;用遗传算法搜索最优密度和
距离阈值,同时引入惩罚因子,克服算法搜索域偏移从而提高收敛速度,寻找最优聚类中・22,并用归属方法完成聚类。
通过4组人工数据集和4组UCI数据集实验证明,该方法在RI指数、聚类精度、聚类纯度、召回率等4个聚类评价指
标上都达到与K-means算法、快速搜索聚类算法和Max—Min—SD算法相当或更好的效果,算法是有效的。 关键词:遗传算法;聚类;密度;距离
中图分类号:TP391.4 文献标志码:A
Clustering by density and distance analysis based on genetic algorithm
WANG Ze。,ZHANG Hongjun,ZHANG Rui,HE Dengchao
(Institute of Command and Information System,PLA University ofScience and Technology,Nanjing Jiangsu 210007,China)
基于遗传算法的聚类分析
第24卷第2期 电脑开发与应用
文章编号:1003—5850(2011)02—0007—03 基于遗传算法的聚类分析
Cluster Analysis based on Genetic Algorithm
苏良昱 苏良碧。 ( 许昌学院电气信息工程学院 河南许昌4610O0)(。内蒙古大学电子信息工程学院 呼和浩特010021) 【摘 要】遗传算法是一种模拟自然进化的优化搜索算法,它仅依靠适应度函数就可以搜索最优解。介绍了一种
基于遗传算法的聚类分析方法,采用浮点数编码方式对聚类的中心进行编码,并用特征向量与相应聚类中心的
欧氏距离的和来判断聚类划分的质量,通过选择、交叉和变异操作对聚类中心的编码进行优化,得到使聚类划
分效果最好的聚类中心。实验结果显示,该方法的聚类划分能得到比较满意的效果。
【关键词】遗传算法,聚类,适应度函数,GA
中图分类号:TP301.6 文献标识码:A ABSTRACT Genetic Algorithm is a optimized search approach which simulates the natural evolution,it can search the optimal solution only by fitness function.This paper introduce a cluster analysis algorithm which base on GA,it uses floating—point encoding method to encode the center of the cluster,and use Euclidean distance between the feature vector and the corresponding cluster center tO determine the quality of clustering,it optimizes the encoding of the cluster centers by selection,crossover and mutation operations,it can obtain the cluster centers which can make the best clustering.Experimental results show that clustering use this method can reach satisfied results. KEYWORDS genetic algorithm,cluster,fitness function,GA
基因表达数据的双聚类分析与研究
摘要
I 摘 要
如何快速从大规模基因表达数据中挖掘相关基因信息,实现高通量基因表达
数据的精准分析,成为基因表达数据分析的关键问题。基因表达数据的双聚类分
析能有效弥补传统聚类分析在搜索并确认基因局部表达模式的不足。
本文以基因表达数据的双聚类分析为切入点,以提高双聚类体积、覆盖率、
均方残差等质量评价指标和生物意义为主要目标,基于布谷鸟搜索算法,从单目
标优化、多目标优化和集成学习等方面开展双聚类分析研究,解决现有双聚类分
析方法存在的双聚类的质量差、多样性不足和生物意义不明显等问题。论文的主
要工作包括:
(1) 提出基于布谷鸟搜索双聚类分析算法(Cuckoo Search Biclustering, CSB)。
针对现有双聚类分析的低覆盖率和高均方残差等问题,该算法提出初始双聚类优
化选取的策略提高解多样性,同时在搜索过程中采用服从莱维飞行的随机搜索策
略解决解早熟。CSB算法可有效提高搜索范围和速度,并能稳定跳出局部最优解,
同时可找到包含不同基因的双聚类,避免基因过于集中问题。与CC、FLOC、ISA、
BIC-aiNet、SEBI、SAB和SSB等算法比较,实验表明CSB算法的双聚类质量和
生物意义更优。
(2) 提出基于遗传算法和布谷鸟搜索的混合双聚类分析算法(Genetic
Algorithm and Cuckoo Search hybrid Biclustering, GACSB)。通过引入遗传算法的锦
标赛选择和精英保留等策略,GACSB算法可在计算代价不大幅增加的条件下拓展
搜索范围和深度从而提高双聚类的多样性。与CC、FLOC、ISA、SEBI、SSB和
CSB等算法的对比实验表明GACSB算法在双聚类的多样性和生物意义上有大幅
提高。通过ACV、MSR和VE等指标对比分析,说明GACSB算法可搜索到不同
类型的双聚类,具有较强可扩展性。
(3) 提出基于多目标布谷鸟搜索的双聚类分析算法(Multi-Objective Cuckoo