
基于马尔可夫随机场的单目图像深度估计
MicrocomputerApplications Vo1.26,No.11,2010 技术交流 微型电脑应用 2010年第26卷第11期 文章编号:1007-757X(2010)11-0049-02 基于马尔可夫随机场的单目图像深度估计
张蓓蕾,刘洪玮 摘要:图像深度获取是机器视觉领域活跃的研究课题。将图像深度估计问题归结为模式识别问题,以单目图像深度为待分 连续模式类,在多尺度下对图像块提取绝对和相对深度特征,选择表征上下文关系的MRF(Markov Random Field)一MAP (Maximumaposteriori)方法,建立拉普拉斯模型,表述某图像块的深度和其邻域深度之间的关系。实验得到了某一类单目 图像对应的深度图像,证明了该算法的有效性。 关键词:单目图像;深度图像;马儿可夫随机场;最大后验概率 中图分类号:TP391 文献标志码:A 0引言 图像深度信息的获取,旨在得到图像中不同对象间的空 间位置信息,广泛应用于图片理解(目标识别、场景层次、 姿态感知),三维立体重建(物体、场景的三维现实模拟)、 机器人视觉(机器人行为指导)等方面。 目前主要有两种方法获得图像深度信息:一种是深度感 应器,原理是利用射线的反射时间计算距离,这种方法的优 点在于精度高,但缺点是设备成本较高,例如三维激光扫描 仪。另一种方法是基于一个场景的多幅图像或图像序列,利 用多视图摄像几何,通过求取视差,获取深度值,例如基于 双目『111、三目『2】、多目【3】、环目『4】的三维立体化方法。其 优点是条件充足,算法易行,缺点是需要摄像机参数,专业 知识要求较高。 本文利用单目图像进行深度估计,基本原理是:以模式 识别原理为框架,采用MRF(Markov Random Field) 一MAP((Maximum a posteriori)【5】方法,建立拉普拉斯深度 估计模型。实践证明该方法成本低,无需昂贵测距设备,无 需摄像机内部及外部参数,应用范围广。 l深度估计与模式识别 模式识别是指对表征事物或现象的各种形式的(数值 的、文字的或逻辑关系的)信息,进行处理和分析,进而对 事物或现象进行描述、辨认、分类和解释的过程,是信息科 学和人工智能的重要组成部分。模式识别系统的基本框架如 图1所示: 样本对象集 薄 甫 _-一分类器设计 描 L_・ 薛 分类决策 待分对象集I 描 I 图1模式识别基本过程 本文的基本思想是:将深度估计问题归结为模式识别问 题,深度即连续的待识别的模式类,图像及其对应深度图像 组成的图像对集为样本对象集,对样本对象和待分对象分别 提取深度特征,以贝叶斯原理为基础,建立分类器进行分类 决策(拉普拉斯模型),并由样本对象集训练得到模型参数, 通过最优化方法求取最大后验概率,估计出某图像块对应的 深度值。 2 MRF.MAP模型框架 构造MRF.MAP先验模型包含3个步骤【5】: (1)确定邻域和对应的基团对规则位置集(点集)、点(xy) 的邻域为 ,={ , ):0< -0 + 一,) c},由c决定邻域结沟的 大小和相应的基团;对不规则位置集,根据Delaunay三角 形(或Voronoi多边形)确定任一位置的邻域,它们有不同的 形状和尺寸,按包含的位置数划分邻域类型;在图像理解和 目标识别等问题中,常借助图论(graph theory)的方法构造 Markov图,由它表示处理这些问题时所需的上下文关系(约 束),确定邻域结构及基团。 f2)选择好基团后,再确定其函数。 (3)确定后验分布,基于随机场 的先验分布和测量噪 声分布的特征,根据Bayes定理,求得给定测量数据Y=y时, X=x的后验概论P(xlyY=p(ylx)p(x)/p(y),其中p )是一个 先验Gibbs分布,‘p(xly)是给定X=x时,Y=y的条件概论, 也称之为似然函数,它是描述测量数据条件分布的,pCy)是 一个未知常数,通常,该后验分布是关于 的邻域系统的 MRF分布。 f4)基于恰当准则的最优估计确定了上述后验概论后, 给定问题的解与预先确定的准则有关,例如MAP估计,它 是最大后验概论准则下的解。 (5)算法实现,直接求Bayes估计具有指数复杂性,因 为需要计算所有可能状态的后验概率,实际上是不可行的, 通常避开这个问题,选择可行的途径和算法。 基金项目:1国家自然科学基金(60502042);2上海市启明星基金(06QA14003)资助 作者简介:张蓓蕾(1983.),女,河南濮阳人,东华大学信息科学与技术学院,硕士,图像处理与模式识别,上海201620 刘洪玮(1982.),男,江苏徐州人,东华大学信息科学与技术学院,硕士,电力电子与电气传动,上海201620 ・49・
Microcomputer Applications Vo1.26,No.11,2010 技术交流 微型电脑应用 2010年第26卷第ll期 MRF方法有多种改进形式,例如CRF(条件随机场)和 DRF(区别性随机场)。 3基于MRF—MAP的拉普拉斯模型 3 1深度特征的提取 将一幅图片切割为小的正方形块,以块为单位提取深度 特征。深度特征的描述基于图像纹理,提取的纹理特征须对 噪声具有鲁棒性,深度特征的分类如图2所示。一幅图中, 同一对象在不同的尺度下表现出不同的分辨率,不同的相对 大小,以及不同邻域关系,因此在特征提取时采用多尺度模 型。 绝对深度特征的获取f6J:计算图像1 )第i块的统计信 息之和。对于每一块我们分别用1 5个模板(9个law’S mask, 6个纹理梯度)进行滤波,即 ,Y/=1 ,l5。对第i块的第n 个特征可以表示为:E(n)=∑㈧ 川 )l, 其中k∈{1,2), 这样便可初步得到一个30维的向量。由于许多结构在室外 情景中,往往在垂直结构上与自身相连接(并不是悬浮于空 中而是立于地面),因此,对块赋予柱状特征,由上到下, 由大到小。 同质纹理:分辨军小I 蛛厦小刷 绝对深 纹理 不同质纹理:区分不同对象 深 度特征 纹理梯度方向:深度变化虽舫向 度 (局部) 特 柱状:基于地面,在垂直方向上反映深度信 祉 相对深度特征瘟反映相邻的块间的纹理特征的相对差异 f连续性特征) 图2深度特征的提取 相对深度特征的获取:对于15个滤波器过滤后的图像, 针对每一个结果得到一个具有十分的直方图,这样对于尺度 上的块i就有150个相对深度特征 (150维的向量)。 以对应直方图的差值Y =Y 一Y, 为特征向量。 3_2基于lVlRF.MAP的拉普拉斯模型的建立 设,为一幅图片,设Y: 为图像的观察值,其中 为每个单元块的观察值;,设 =k} 为相应单元块对应的标 记,其中 表示满足MRF的邻域系统。当以】,作为条件变 量时,如果随机变量而满足马尔可夫性,即有 P(tl ,Xx一 )=P( lY, M),其中 为单元块i的邻域,则( ) 构成CRF(ConditionalMarkovField)。对于Vx,有P(xly)>0, 假设只有成对的簇的势能不为零,由Hammersley-Clifford 定理知,在观察值Y条件下,x的联合分布为: 尸( y)=exp( ̄A (‘,y)+∑∑ ( ,■,)t)) (1) E J∈ 由(1)式,考虑2个尺度,则有
・50・ (d ,0,O-)= l e砸∑^( ,‘)吲备^‘ ^’ ∑∑∑ ( d t)) :一 o"1, (2)
(3) , 一l堡 : (4) 0"2 将(3),(4)带入(2),则有: ( 目, )= Z ̄-exp(-善 ㈤ ∑∑∑ s…1 1 EⅣ(J) 其中:PL( ,cr)表示后验概率, 为归一化常数,标 准常量,可以定为l,M代表把一整幅图像划分为M块, 鼍为图像块i的”维深度特征向量, 为多尺度模型中尺度 个数,本模型中S=1,2,NO)为图像块_,的邻域,本文选择4 邻域系统, )表图像块i在尺度 下的绝对深度,在4邻 1一 域系统中有 ( ) { J (1)呻}dJ( )。 本模型为拉普拉斯模型。采用本模型的原因有三: (1)是在 ,部分,拉普拉斯分布比高斯分布更接近于 (出 )的直方图。 (2)拉普拉斯分布对于图像的特征和训练深度图像的 特征结果更稳定。 (3)拉普拉斯模型对图像的边缘敏感,因此对于结果 的显示会比较好。 深度d随着深度特征 的变化而变化的。 ,O'lr, ̄T2r: 为模型参数。其中r表示图像分块后,每一块所在的行,因 为摄像机为水平放置的,则不同行统计特性不同。 参数 ,0"1,, 在模型中的极大似然估计不易计算,首先 由线性方程可以近似得到 dr,例如可以求使得 min 一Xrorll。最小的0,。将 : 的估计与 联系起来,令 0-2 =“ l,这样有助于表现相邻的块间深度差异,使平滑 效果显著。应用于空间尺度模型,则需对每尺度下每一行的 参数 进行估计。将对 的估计转化为对“ 的估计, “ ≥0,使用二次规划实现最优值。与仃: 的估计类似,令 0"1 .7-V T ,由Xi非负,6 h非负知,V, 0。6 l 用来衡量 。,中深度对于特征的不确定性。这说明深度并不能完全依 赖于局部特征( ,,),而要依赖于邻域块的深度(I )。其 中y,和U 是相互独立的。在对参数近似表述之后,可将问 题转化为线性规划问题。设 d =arg mln log P( j , , )= d , 、 arg m log(c1 l —XO l+c2 {) (下转第59页)
MicrocomputerApplications VoL 26,No.11,2010 技术交流 微型电脑应用 2010年第26卷第ll期 Publishers 2001.614--617. f51 Giacomo Cabri,Luca Ferrari,Letizia Leonardi Agent role-based collaboration and coordination:a survey about existing approaches[C]. IEEE systems, Man and Cybemetics Conference.2004 6:5473.5478 【6】See ACL at htp://www.fp a.og/r@ositoy/acl ̄ecs.htm1. 『71 GreenwoodD,LyellM,MallyaA,SuguriH.TheIEEE F IA Approach to Integrating Software Agents and Wleb Services In: Sixth International Conference on Autonomous Agents and Multiagent Systems,Industrial Track(2007). f81 Liu S,Kitngas MatskinM.Agent-BasedWleb Service Composition witl1 E and JXTAit].Proc.of Intl Conference on Semantic Web and Wleb Services(SWWS1 2006.1lO.116. 【9]Nguyen X T and Kowalczyk R.WS2JADE:Integrating Web Service with JADE Agents[C1.Proceedings of the AAMAS’05 WOrkshop on Service-Oriented Computing and Agent-Based Engineering fSOCABE’2005) Utrecht, 1]he Netherlands.2005. 『101 Sycara K,Paolucci M,Soudry J.Dynamic Discovery and Coordination of Agent-based Semantic Wleb Services『 . IEEE Intemet Computing,2001,8f31:66.73. 【ll】XuanThang,RyszardKowalczyk.EnablingAgent-Based Management of Wleb Services with WS2JADEIC]. Proceedings of the Fifth International Conference on Quality Software,2005:407-412. 『121 CAO Jian,ZHANG Shen-sheng.Research on Adaptive Wl0rkflow Techniques Based on ECA Rulel¥].Computer Integrated Manufacturing Sy stems.CIMS,2002,8(9): 737.741. n31 ITU.T Recommendation E.800,Terms and defmitions related to quality of service and network performance including dependability.1 994. f141 Menasce D A.QoS issues in W_eb services,Intemet Computing班髓,Volume 6,Issue 6,P72.75,N0v.-Dec 2002 【l5】赵勇,刘吉强,韩臻,沈昌祥基于任务的访问控制模型研 究.计算机工程2008(5):28-30. 『161 See JADE website at http://jade.tilab.corn/. r收稿日期:2010—02.25) c6 c6 c6 c6 c£ c6 c6 cE c6拳c6 c6 t6 c6拳c6事c6 c6 6 c6 c61 c6 c6事c6事c6 c6 6事c6 c6 c6拳c6 c6¥c6 c6 c芒争c6 c6争c6拳c6 (上接第50页) l度图像表示,例如白色部分为深度大于等于81m,对应灰度 其中cl∈孵 ,c1,。=1/o"1, ,同理C 2∈飒 ,C2.f=1/tr2,。, 特征向量X∈9tM*k,Or∈瑕 ,设-d=XOr∈飒 ,O是一 个矩阵,Od给出了多层次下相邻块间深度的不同,我们增 加变量 和 2,则可转化为线性规划问题: d’=argmin 轰+C2 2 (7) 一 ≤d—d (8) 一 Od (9) 求解线性规划即可得到优化问题的解。 3I3实验结果及分析 图像及深度图像的训练库,由康奈尔大学计算机学院的 官方网站上获取。训练库中选取了100幅图像对,原图像为 1707"2272,深度图像为86*107,则图像块的大小为约为 20*20,由于激光扫设备的限制,深度的范围为0-81m,则 远于81m的深度都标记为81m。 ■
基于深度学习的单目深度估计综述
基于深度学习的单目深度估计综述
前段时间有思考过结合3D信息来辅助多目标跟踪任务,不过效果没有达到我的预期。一方面是多目标跟踪相关数据集除了KITTI之外缺乏多任务标注信息,另一方面单目深度估计对于密集拥挤人群的效果很差。所以我觉得对于稀疏场景、车辆跟踪或者提供真实3D信息和相机信息的场景任务更有意义。下面的总结主要是我2019年初整理的文献,时效性可能还没跟上。
1任务介绍
深度估计是计算机视觉领域的一个基础性问题,其可以应用在机器人导航、增强现实、三维重建、自动驾驶等领域。而目前大部分深度估计都是基于二维RGB图像到RBG-D图像的转化估计,主要包括从图像明暗、不同视角、光度、纹理信息等获取场景深度形状的Shape from X方法,还有结合SFM(Structure from motion)和SLAM(Simultaneous Localization And Mapping)等方式预测相机位姿的算法。其中虽然有很多设备可以直接获取深度,但是设备造价昂贵。也可以利用双目进行深度估计,但是由于双目图像需要利用立体匹配进行像素点对应和视差计算,所以计算复杂度也较高,尤其是对于低纹理场景的匹配效果不好。而单目深度估计则相对成本更低,更容易普及。
那么对于单目深度估计,顾名思义,就是利用一张或者唯一视角下的RGB图像,估计图像中每个像素相对拍摄源的距离。对于人眼来说,由于存在大量的先验知识,所以可以从一只眼睛所获取的图像信息中提取出大量深度信息。那么单目深度估计不仅需要从二维图像中学会客观的深度信息,而且需要提取一些经验信息,后者则对于数据集中相机和场景会比较敏感。
通过阅读文献,可以将基于深度学习的单目深度估计算法大致分为以下几类:
• 监督算法
顾名思义,直接以2维图像作为输入,以深度图为输出进行训练:
上面给的例子是KITTI数据集中的一组例子,不过深度图可能看的不是很明显,我重新将深度图涂色之后:
基于深度学习的单目深度估计方法综述
基于深度学习的单目深度估计方法综述
江俊君;李震宇;刘贤明
【期刊名称】《计算机学报》
【年(卷),期】2022(45)6
【摘 要】深度估计是一种从单张或者多张图像预测场景深度信息的技术,是计算机视觉领域非常热门的研究方向,在三维重建、场景理解、环境感知等任务中起到了关键作用.当前深度估计技术可以分为多目深度估计和单目深度估计.因为单目摄像头具有成本低、设备较普及、图像获取方便等优点,与多目深度估计技术相比,从单目图像估计深度信息是当前更为热门和更具挑战的技术.近年来,随着深度学习的迅速发展,基于深度学习的单目深度估计方法被广泛研究.本文对基于深度估计的单目深度估计方法进行综述,首先给出单目深度估计问题的定义、介绍常用于训练的数据集与模型评价指标,然后根据不同的训练方式对国内外相关技术进行分析总结,将现有方法分为基于监督学习、无监督学习和半监督学习三大类,对每种类型方法的产生思路、优缺点进行详细分析,最后梳理、总结该技术的发展趋势与关键技术.
【总页数】32页(P1276-1307)
【作 者】江俊君;李震宇;刘贤明
【作者单位】哈尔滨工业大学计算学部
【正文语种】中 文
【中图分类】TP18
【相关文献】 1.基于单目深度估计方法的图像分层虚化技术2.基于带squeeze-and-excitation模块的ResNeXt的单目图像深度估计方法3.VDAS中基于单目红外图像的深度估计方法4.基于密集卷积网络的单目图像深度估计方法5.基于ResNeXt单目深度估计的幼苗植株高度测量方法
因版权原因,仅展示原文概要,查看原文内容请购买
基于深度估计的算法

基于深度估计的算法
深度估计是一种计算机视觉领域的核心任务,旨在通过分析图像或视频中的场景来预测物体或场景的深度信息。基于深度估计的算法在许多领域中都有广泛的应用,如自动驾驶、虚拟现实、三维重建等。
一种常见的基于深度估计的算法是基于单目图像的深度估计。单目图像深度估计的挑战在于缺乏直接的深度信息,因为在2D图像中,物体的深度信息被转换为了像素强度。为了解决这个问题,研究者们提出了许多算法,如基于神经网络的方法,包括卷积神经网络、循环神经网络等。
使用深度学习算法进行深度估计的一种常见方法是通过训练一个深度估计网络。这个网络会从大量的带有已知深度的图像中学习,并将输入图像映射到对应的深度图像。训练过程中,网络通过最小化预测深度图像与真实深度图像之间的差异来优化自身的参数。在测试阶段,该网络可以接受单目图像作为输入,并输出对应的深度图像。
除了基于单目图像的深度估计,基于立体视觉的深度估计也是常见的应用之一。立体视觉利用左右两个相机的图像来获取深度信息。通过计算图像之间像素的差异,可以推断出物体的位置和距离。这样的算法需要进行视差计算、视差映射和误差优化等步骤,从而得到准确的深度估计结果。
基于深度估计的算法在计算机视觉领域有着广泛的应用。例如,在自动驾驶中,深度估计可以帮助车辆感知前方物体的距离和位置,从而进行智能驾驶决策。在虚拟现实中,深度估计可以为用户提供逼真的视觉体验,使虚拟世界与现实世界无缝融合。在三维重建中,深度估计可以提供准确的物体形状和位置信息,用于构建三维场景模型。 综上所述,基于深度估计的算法在计算机视觉领域具有重要的地位和广泛的应用前景。随着深度学习技术的进一步发展,我们可以期待更加高效和准确的深度估计算法的出现,为各个领域带来更多创新和进步。
深度估计公式

深度估计公式
深度估计的公式可以用数学方式表示,但是为了避免输出公式,我将用简单的语言来阐述其原理。深度估计的本质是通过对图像的特征进行分析和学习,找出图像中不同区域的深度信息。这里需要注意的是,深度估计是一种非直接方法,即不依赖于直接测量距离的传感器。
深度估计的方法有很多种,其中比较常用的是基于单目图像的方法。单目图像指的是只使用一张图像进行深度估计,而不需要其他传感器或相机。这种方法的优势在于成本低、便于实现,但也存在一些挑战,比如对于纹理较少的区域或遮挡情况下的深度估计较为困难。
在基于单目图像的深度估计中,常用的方法是通过学习建立图像特征与深度之间的映射关系。这可以通过使用深度学习模型来实现,比如卷积神经网络(CNN)。CNN可以从图像中提取出丰富的特征表示,然后通过回归模型来预测深度值。这种方法的关键在于训练一个有效的深度回归模型,使其能够准确地预测出图像中每个像素点的深度值。
除了基于单目图像的方法,还有其他的深度估计方法,比如基于双目图像、激光雷达等。这些方法通常会使用多个传感器或多个图像来获取更准确的深度信息。例如,基于双目图像的方法会使用两个摄像头来获取左右图像,然后通过计算两个图像之间的视差(即像素的位移)来推测深度信息。
深度估计在许多应用中都有广泛的应用。例如,在三维重建中,深度估计可以用来获取场景中物体的准确位置和形状信息,从而实现对场景的三维建模。在虚拟现实中,深度估计可以用来实现真实感的渲染和交互,增强用户的沉浸感。在自动驾驶中,深度估计可以用来识别和跟踪道路中的障碍物,帮助车辆做出安全的驾驶决策。
深度估计是计算机视觉领域中的一个重要任务,它通过分析图像中的信息来预测出每个像素点到摄像机的距离。深度估计的方法有很多种,包括基于单目图像、双目图像、激光雷达等。深度估计在许多应用中都有广泛的应用,对于实现三维重建、虚拟现实、自动驾驶等都起着关键作用。
单目深度估计方法综述
单目深度估计方法综述
展开全文
一 相关概念介绍
1. 深度估计
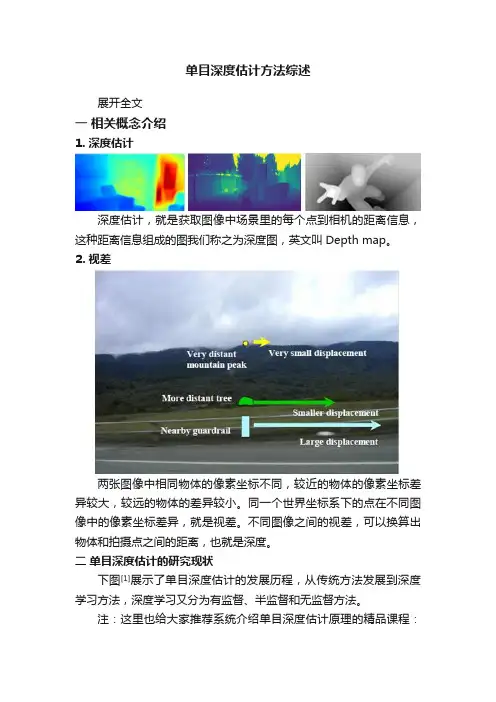
深度估计,就是获取图像中场景里的每个点到相机的距离信息,这种距离信息组成的图我们称之为深度图,英文叫Depth map。
2. 视差
两张图像中相同物体的像素坐标不同,较近的物体的像素坐标差异较大,较远的物体的差异较小。同一个世界坐标系下的点在不同图像中的像素坐标差异,就是视差。不同图像之间的视差,可以换算出物体和拍摄点之间的距离,也就是深度。
二 单目深度估计的研究现状
下图[1]展示了单目深度估计的发展历程,从传统方法发展到深度学习方法,深度学习又分为有监督、半监督和无监督方法。 注:这里也给大家推荐系统介绍单目深度估计原理的精品课程:单目深度估计方法:算法梳理与代码实现
我们将单目深度估计方法分为:基于线索的传统方法、基于机器学习的传统方法、基于有监督的深度学习方法和基于无监督的深度学习方法。
2.1 基于线索的传统方法
人类在观察周围环境时,除了依靠双目获得立体感外,大脑还能根据经验仅从单个视角捕获的各种启发式线索感知深度。常用的单目深度线索有:线性透视[2]、聚焦/散焦[8]、大气散射[7]、阴影[3]、纹理[4]、遮挡[5]和相对高度[6]等。
线性透视线索的例子 大气散射线索的例子
SFS (Shape from shading)方法
根据运动线索求解深度是最常用的一个方法。这里包含两种运动类型:一类是物体自身的运动,一类是摄像机的运动。
基于物体自身运动的深度估计方法是利用运动视差近大远小的原理。利用摄像机的运动进行深度估计,称为运动恢复结构(Structure
From Motion, SFM)[9]。假定场景静止不变,仅存在摄像机的运动,SFM 技术可以从拍摄的图像序列中恢复出摄像机的内外参数和场景的深度信息。
2.2 基于机器学习的传统方法
基于统计模式的深度估计算法由于不受特定的场景条件的限制,并且具有较好的适用性,得到了越来越广泛的研究。该类算法主要通过机器学习的方法,将大量有代表性的训练图像集和对应的深度集输入定义好的模型中进行有监督的学习,训练完成之后,将实际输入图像输入到训练好的模型中进行深度的计算。 基于传统机器学习的单目深度估计方法可分为参数学习方法与非参数学习方法。
单目深度估计比较好的算法 -回复
单目深度估计比较好的算法 -回复
什么是单目深度估计?
在计算机视觉中,单目深度估计是指利用只有一个摄像机的图像来推测图像中物体的距离和深度信息的技术。通常情况下,深度估计需要至少两个视点或者使用其他传感器的辅助信息。然而,单目深度估计任务完全依靠单个图像的特征和几何信息来进行深度估计,因此具有更广泛的应用前景和挑战。
单目深度估计算法的意义和作用
单目深度估计是计算机视觉中的一项重要任务,因为它可以为很多应用提供基础和关键信息,如增强现实、虚拟现实、自动驾驶、机器人导航和三维重建等。通过估计场景中的深度信息,我们可以更好地理解环境并进行智能决策。因此,开发出准确而高效的单目深度估计算法对于实现这些应用至关重要。
当前主流的单目深度估计方法
目前,有许多不同的方法和技术用于单目深度估计。下面将介绍一些当前主流的单目深度估计算法:
1. 基于传统机器学习的方法:这类方法利用图像中的低级特征(如边缘、纹理等)和高级特征(如角点、线段等)来预测深度。它们通常使用支持向量机(SVM)、随机森林等分类器进行深度预测。然而,这些方法在复杂场景中常常存在准确性和鲁棒性方面的挑战。
2. 基于深度学习的方法:随着深度学习的发展,越来越多的研究者开始探索使用卷积神经网络(CNN)进行单目深度估计。这些方法通过端到端的训练,可以直接从图像中学习深度信息。具有代表性的方法包括宽度不变网络(WideResNet)、深度回归网络(Depth Regression Network)等。这些方法通常具有较高的准确性和鲁棒性,但需要大量的标注数据和计算资源。
3. 基于结构光的方法:结构光是一种将光线投射到场景中以获取深度信息的技术。这种方法通常通过投射不同的光斑或纹理来估计场景的三维几何信息。然后,通过计算图像中光斑或纹理的畸变,可以推断出深度信息。这种方法在有限的场景中可以获得较高的深度估计精度,但对硬件设备要求较高。
总结
单目深度估计综述
- 1 - 单目深度估计综述
近年来,深度估计技术在计算机视觉研究中得到了广泛的应用。深度估计技术是一种方法,可以根据图像或视频帧中的像素,估算出目标物体的距离或深度信息。它可以帮助我们进行物体检测和分类、目标跟踪等计算机视觉应用任务。目前,单目深度估计作为一种很有前途的技术,已经得到了越来越多人的关注,其优势在于可以节省设备成本和功耗,同时也可以满足可用性和实时要求。
单目深度估计可以遵循以下一般步骤:(1)计算出图像或视频帧中的每个像素的深度,(2)根据特定的算法,使用深度信息进行物体检测、分割和分类。单目深度估计对于计算光流、光强变换等技术也有重要意义,可以用来现场重建和实时分析深度信息。
随着机器学习、深度学习以及大数据计算技术的发展,在单目深度估计方面也有许多研究进展。这些技术的核心思想是利用机器学习的模型来学习深度估计方法,从而精确估算出图像中目标物体的深度值。其中,基于深度学习的方法具有较高的准确度,而且需要较少的数据来训练模型,因此目前深受欢迎。
在单目深度估计方面,深度学习技术通常可以分为基于极线匹配方法、基于光流法和基于深度神经网络三大类。基于极线匹配方法通常使用传统的机器学习技术,如SIFT(Scale Invariant Feature
Transform)或SURF(Speeded-Up Robust Feature),以及图像处理技术,如角点检测,来估计图像中目标物体的深度值。基于光流法则利用光流来模拟物体的运动,以估计目标物体的深度。基于深度神经 - 2 - 网络的技术则使用深度神经网络来模拟深度估计问题,以实现更准确的深度值估计效果。
然而,单目深度估计仍然是一项具有挑战的技术,存在许多技术问题和挑战,如信息丢失、模型噪声以及系统参数等等。针对这些问题,可以通过提高训练集的大小、应用正则化技术、改进训练算法以及提高模型复杂度等方法来解决。
使用马尔科夫随机场进行图像分割的技巧(Ⅱ)
马尔科夫随机场(Markov Random Field, MRF)是一种常用于图像分割的技术。图像分割是指将图像分成若干个具有一定意义的区域或者对象。MRF能够充分考虑图像中像素之间的相关性,从而有效地进行图像分割。本文将介绍使用MRF进行图像分割的一些技巧。
一、 MRF的基本原理
MRF是一种概率图模型,它描述了一个随机场在给定一些观测值的条件下的联合概率分布。在图像分割中,MRF将图像中的像素看作随机变量,并且考虑它们之间的相互作用。MRF的基本原理是通过定义一些能量函数来描述图像的分割结果,然后利用最小化能量函数的方法得到最优的分割结果。
二、 MRF的参数估计
MRF中的参数估计是一个重要的步骤,它决定了MRF模型的准确性。常用的参数估计方法有极大似然估计和最大后验概率估计。极大似然估计是通过最大化观测数据的似然函数来估计参数,而最大后验概率估计则是在极大似然估计的基础上加上先验分布对参数进行约束。合理的参数估计能够使MRF模型更准确地描述图像的特征和结构,从而提高图像分割的准确性。
三、 MRF的图割方法
MRF的图割方法是一种常用的图像分割算法。它利用图论中的最小割最大流定理来进行图像分割。该方法将图像中的像素看作图中的节点,像素之间的相互作用看作图中的边。然后通过最小割最大流定理来找到最优的分割结果。图割方法能够有效地处理图像中的纹理和边缘信息,从而得到更好的分割效果。
四、 MRF的条件随机场方法
条件随机场(Conditional Random Field, CRF)是一种常用的无向图模型,它可以用于建模标注问题和分类问题。在图像分割中,CRF可以有效地考虑像素之间的空间相关性和颜色相似性,从而得到更准确的分割结果。CRF方法在图像分割中的应用越来越广泛,它能够有效地处理各种复杂的图像分割问题。
五、 MRF的深度学习方法
近年来,深度学习技术在图像分割领域取得了很大的进展。MRF与深度学习的结合也成为了研究的热点之一。深度学习方法能够有效地提取图像的特征和结构,而MRF能够很好地考虑像素之间的相关性。因此,MRF与深度学习的结合能够得到更好的图像分割结果。
基于深度学习的单目深度估计技术研究
基于深度学习的单目深度估计技术研究
深度学习技术的应用正在越来越广泛,其中单目深度估计技术也逐渐成为了一个重要领域。这项技术可以从一张单目图像中准确提取出不同区域的深度信息,从而为许多应用场景提供更加精准的数据支持。
单目深度估计技术是如何工作的?
单目深度估计技术要求通过算法在一张单目图像中构建三维模型,并对模型进行细致的处理和分析,从而实现对明暗、纹理等特征的提取和识别。具体来说,普通的摄像头可以捕捉到二维的图像数据,但是通过深度学习技术可以将图像中的每个像素点映射为三维坐标,从而得到更加真实和准确的数据。在实际应用中,单目深度估计技术可以帮助测量物体距离、重建三维场景、实现虚拟现实等多项任务,极大地满足了用户对真实感和交互体验的需求。
目前单目深度估计技术的研究存在哪些问题?
虽然单目深度估计技术在实际应用中呈现出了越来越高的精度和稳定性,但与此同时,该技术也面临着较多的挑战。常见的问题包括:直接使用普通神经网络的结果比较模糊,无法满足实时性要求;模型的训练数据不够丰富和多样化;模型的鲁棒性和泛化能力不足;场景适应性较差等。 如何提高基于深度学习的单目深度估计技术?
在实际应用中,我们需要在模型设计、算法改进和数据处理等方面进行探索和优化,以提高单目深度估计技术的精度和可靠性。下面我们就分别对这三方面的优化进行阐述。
1.模型设计
在模型设计上,我们需要考虑到现有深度学习技术的发展趋势和未来需求。一些相关的操作和网络结构可以用来迭代优化,例如注意力机制、残差模块等。此外,可以整合不同的任务和数据,进而打造更鲁棒以及泛化性强的深度学习模型。
2.算法改进
在算法改进方面,我们需要考虑到深度学习中一些存在的问题。例如,常见的问题是在图像中会存在一些不可见的信息,这些信息难以被捕捉和处理。我们可以通过引入先验信息,以及调整损失函数来解决这些问题。此外,我们也需要不断探索最优的超参数,以及并行化计算等技术,来提高网络训练过程的效率。
利用深度传感器大数据的单目图像深度估计
利用深度传感器大数据的单目图像深度估计
袁红星;吴少群;朱仁祥;胡劲松;安鹏
【期刊名称】《计算机辅助设计与图形学学报》
【年(卷),期】2013(025)012
【摘 要】2D视频转3D视频是解决3D片源不足的主要方法之一,而单目图像的深度估计是其中的关键步骤.考虑到互联网上不断累积的深度图数据,提出一种基于PatchMatch深度迁移的单目图像深度估计方法.首先利用图像的全局描述符从深度图数据库中检索出近邻图像;然后通过PatchMatch建立输入图像和近邻图像之间像素级稠密对应关系;再根据像素级对应关系将近邻图像的深度图迁移到输入图像上,并采用中值滤波对迁移的深度图进行融合;最后通过三边滤波对融合的深度图进行后处理,进一步提高深度图估计质量并抑制噪声.实验结果表明,与基于尺度不变特征变换流深度迁移方法相比,该方法在改善深度图估计质量的同时提高了计算速度.
【总页数】7页(P1786-1792)
【作 者】袁红星;吴少群;朱仁祥;胡劲松;安鹏
【作者单位】宁波工程学院电子与信息工程学院 宁波 315016;宁波工程学院电子与信息工程学院 宁波 315016;宁波工程学院电子与信息工程学院 宁波 315016;宁波工程学院电子与信息工程学院 宁波 315016;宁波工程学院电子与信息工程学院
宁波 315016
【正文语种】中 文 【中图分类】TN911.73
【相关文献】
1.基于CNN特征提取和加权深度迁移的单目图像深度估计 [J], 温静;安国艳;梁宇栋
2.基于CNN特征提取和加权深度迁移的单目图像深度估计 [J], 温静; 安国艳; 梁宇栋
3.利用稀疏点云偏序关系的半监督单目图像深度估计 [J], 曾一鸣; 胡瑜; 韩银和; 李晓维
4.VDAS中基于单目红外图像的深度估计方法 [J], 李旭;丁萌;魏东辉;吴晓舟;曹云峰
5.基于全卷积编解码网络的单目图像深度估计 [J], 夏梦琪;郝琨;赵璐