
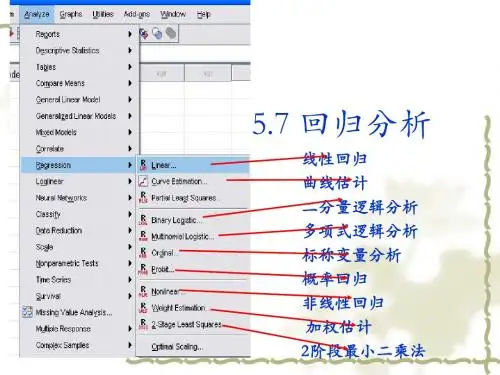
相关分析和回归分析SPSS实现
。 精选资料,欢迎下载 相关分析与回归分析 一、试验目标与要求 本试验项目的目的是学习并使用SPSS软件进行相关分析与回归分析,具体包括: (1) 皮尔逊pearson简单相关系数的计算与分析 (2) 学会在SPSS上实现一元及多元回归模型的计算与检验。 (3) 学会回归模型的散点图与样本方程图形。 (4) 学会对所计算结果进行统计分析说明。 (5) 要求试验前,了解回归分析的如下内容。 参数α、β的估计 回归模型的检验方法:回归系数β的显著性检验(t-检验);回归方程显著性检验(F-检验)。
二、试验原理
1.相关分析的统计学原理 相关分析使用某个指标来表明现象之间相互依存关系的密切程度。用来测度简单线性相关关系的系数是Pearson简单相关系数。 2.回归分析的统计学原理 相关关系不等于因果关系,要明确因果关系必须借助于回归分析。回归分析是研究两个变量或多个变量之间因果关系的统计方法。其基本思想是,在相关分析的基础上,对具有相关关系的两个或多个变量之间数量变化的一般关系进行测定,确立一个合适的数据模型,以便从一个已知量推断另一个未知量。回归分析的主要任务就是根据样本数据估计参数,建立回归模型,对参数与模型进行检验与判断,并进行预测等。 线性回归数学模型如下:
iikkiiixxxy22110 在模型中,回归系数是未知的,可以在已有样本的基础上,使用最小二乘法
对回归系数进行估计,得到如下的样本回归函数:
iikkiiiexxxyˆˆˆˆ22110 回归模型中的参数估计出来之后,还必须对其进行检验。如果通过检验发现模型有缺陷,则必须回到模型的设定阶段或参数估计阶段,重新选择被解释变量 。 精选资料,欢迎下载 与解释变量及其函数形式,或者对数据进行加工整理之后再次估计参数。回归模型的检验包括一级检验与二级检验。一级检验又叫统计学检验,它是利用统计学的抽样理论来检验样本回归方程的可靠性,具体又可以分为拟与优度评价与显著性检验;二级检验又称为经济计量学检验,它是对线性回归模型的假定条件能否得到满足进行检验,具体包括序列相关检验、异方差检验等。
三、试验演示内容与步骤
1.连续变量简单相关系数的计算与分析 在上市公司财务分析中,常常利用资产收益率、净资产收益率、每股净收益与托宾Q值4个指标来衡量公司经营绩效。本试验利用SPSS对这4个指标的相关性进行检验。操作步骤与过程: 打开数据文件“上市公司财务数据(连续变量相关分析).sav”,依次选择“【分析】→【相关】→【双变量】”打开对话框如图,将待分析的4个指标移入右边的变量列表框内。其他均可选择默认项,单击ok提交系统运行。
图5.1 Bivariate Correlations对话框 结果分析: 表给出了Pearson简单相关系数,相关检验t统计量对应的p值。相关系数右上角有两个星号表示相关系数在0.01的显著性水平下显著。从表中可以看出,每股 。 精选资料,欢迎下载 收益、净资产收益率与总资产收益率3个指标之间的相关系数都在0.8以上,对应的p值都接近0,表示3个指标具有较强的正相关关系,而托宾Q值与其他3个变量之间的相关性较弱。
表5.1 Pearson简单相关分析 Correlations
每股收益率 净资产收益率 资产收益率 托宾Q值 每股收益率 Pearson Correlation 1 .877(**) .824(**) -.073
Sig. (2-tailed) . .000 .000 .199 N 315 315 315 315 净资产收益率 Pearson Correlation .877(**) 1 .808(**) -.001
Sig. (2-tailed) .000 . .000 .983 N 315 315 315 315 资产收益率 Pearson Correlation .824(**) .808(**) 1 .011
Sig. (2-tailed) .000 .000 . .849 N 315 315 315 315 托宾Q值 Pearson Correlation -.073 -.001 .011 1
Sig. (2-tailed) .199 .983 .849 . N 315 315 315 315 ** Correlation is significant at the 0.01 level (2-tailed). 2.一元线性回归分析 实例分析:家庭住房支出与年收入的回归模型 在这个例子里,考虑家庭年收入对住房支出的影响,建立的模型如下: iixiy
其中,yi是住房支出,xi是年收入 线性回归分析的基本步骤及结果分析: (1)绘制散点图 打开数据文件,选择【图形】-【旧对话框】-【散点/点状】,如图5.2所示。 。
精选资料,欢迎下载 图5.2 散点图对话框 选择简单分布,单击定义,打开子对话框,选择X变量与Y变量,如图5.3所示。单击ok提交系统运行,结果见图5.4所示。
图5.3 Simple Scatterplot 子对话框 从图上可直观地看出住房支出与年收入之间存在线性相关关系。 。
精选资料,欢迎下载 图5.4 散点图 (2)简单相关分析 选择【分析】—>【相关】—>【双变量】,打开对话框,将变量“住房支出”与“年收入”移入variables列表框,点击ok运行,结果如表5.2所示。 表5.2 住房支出与年收入相关系数表 Correlations
住房支出(千美元) 年收入(千美元) 住房支出(千美元) Pearson Correlation 1 .966(**) Sig. (2-tailed) . .000 N 20 20 年收入(千美元) Pearson Correlation .966(**) 1 Sig. (2-tailed) .000 . N 20 20 ** Correlation is significant at the 0.01 level (2-tailed). 从表中可得到两变量之间的皮尔逊相关系数为0.966,双尾检验概率p值尾0.000<0.05,故变量之间显著相关。根据住房支出与年收入之间的散点图与相关分析显示,住房支出与年收入之间存在显著的正相关关系。在此前提下进一步进行回归分析,建立一元线性回归方程。 (3) 线性回归分析 步骤1:选择菜单“【分析】—>【回归】—>【线性】”,打开Linear Regression 对话框。将变量住房支出y移入Dependent列表框中,将年收入x移入Independents列表框中。在Method 框中选择Enter 选项,表示所选自变量全部进入回归模型。 。 精选资料,欢迎下载 图5.5 Linear Regresssion对话框 步骤2:单击Statistics按钮,如图在Statistics子对话框。该对话框中设置要输出的统计量。这里选中估计、模型拟合度复选框。
图5.6 Statistics子对话框 。
精选资料,欢迎下载 估计:输出有关回归系数的统计量,包括回归系数、回归系数的标准差、标准化的回归系数、t统计量及其对应的p值等。 置信区间:输出每个回归系数的95%的置信度估计区间。 协方差矩阵:输出解释变量的相关系数矩阵与协差阵。 模型拟合度:输出可决系数、调整的可决系数、回归方程的标准误差、回归方程F检验的方差分析。 步骤3:单击绘制按钮,在Plots子对话框中的标准化残差图选项栏中选中正态概率图复选框,以便对残差的正态性进行分析。
图5.7 plots子对话框 步骤4:单击保存按钮,在Save子对话框中残差选项栏中选中未标准化复选框,这样可以在数据文件中生成一个变量名尾res_1 的残差变量,以便对残差进行进一步分析。
图5.8 Save子对话框 其余保持Spss默认选项。在主对话框中单击ok按钮,执行线性回归命令,其结果如下: 。 精选资料,欢迎下载 表5.3给出了回归模型的拟与优度(R Square)、调整的拟与优度(Adjusted R Square)、估计标准差(Std. Error of the Estimate)以及Durbin-Watson统计量。从结果来看,回归的可决系数与调整的可决系数分别为0.934与0.93,即住房支出的90%以上的变动都可以被该模型所解释,拟与优度较高。 表5.4给出了回归模型的方差分析表,可以看到,F统计量为252.722,对应的p值为0,所以,拒绝模型整体不显著的原假设,即该模型的整体是显著的。 表5.5给出了回归系数、回归系数的标准差、标准化的回归系数值以及各个回归系数的显著性t检验。从表中可以看到无论是常数项还是解释变量x,其t统计量对应的p值都小于显著性水平0.05,因此,在0.05的显著性水平下都通过了t检验。变量x的回归系数为0.237,即年收入每增加1千美元,住房支出就增加0.237千美元。
表5.3 回归模型拟与优度评价及Durbin-Watson检验结果 Model Summary(b)
Model R R Square Adjusted R Square Std. Error of the Estimate 1 .966(a) .934 .930 .37302 a Predictors: (Constant),年收入(千美元) b Dependent Variable:住房支出(千美元) 表5.4 方差分析表 ANOVA(b)
Model Sum of Squares df Mean Square F Sig. 1 Regression 35.165 1 35.165 252.722 .000(a)
Residual 2.505 18 .139 Total 37.670 19 a Predictors: (Constant), 年收入(千美元) b Dependent Variable: 住房支出(千美元) 表5.5 回归系数估计及其显著性检验 Coefficients(a)
Model Unstandardized Coefficients Standardized Coefficients t Sig. B Std. Error Beta 1 (Constant) .890 .204 4.356 .000 年收入(千美元) .237 .015 .966 15.897 .000 a Dependent Variable: 住房支出(千美元) 为了判断随机扰动项是否服从正态分布,观察图5.9所示的标准化残差的P-P
spss中的回归分析
7、Plots(图)对话框 单击“Plots”按钮,对话框如下图所示。Plots可帮助分析
资料的正态性、线性和方差齐性,还可帮助检测奇异值或异常值。
(1)散点图:可选择如下任何两个变量为Y(纵轴变量)与X (横轴变量)作图。为 获得更多的图形,可单击“Next”按钮来重 复操作过程。
Variables
Model
Entered
1
INCOMEa
Variables
Removed
Method
. Enter
a. All requested variables entered.
b. Dependent Variable: FOODEXP
输 入 / 移 去 的 变 量b
模型 1
输入的变量 移去的变量
DEPENDENT:因变量。 *ZPRED:标准化预测值。 *ZRESID: 标准化残差。 *DRESID:删除的残差。 *ADJPRED:调整残差。 *SRESID:Student氏残差。 *SDRESID: Student氏删除残差。 (2)Standardized Residual Plots:标准化残差图。 Histogram:标准化残差的直方图,并给出正态曲线。 Normal Probality Plot:标准化残差的正态概率图(P-P图)。 (3)Produce all Partial plots:偏残差图。
Coefficie nts Beta
.923
系 数a
t -.781 12.694
Sig. .441 .000
模型
1
(常量)
非标准化系数
B
标准误
SPSS for Windows 统计分析第二讲 相关分析与回归分析

第二讲 相关分析与回归分析第一节 相关分析1.1 变量的相关性1.变量的相关性分两种,一种是研究两个变量X 与Y 的相关性,另一种是研究两组变量X 1,X 2,…,X p 与Y 1,Y 2,…,Y q 之间的相关性。
本节只研究前者,即两个变量之间的相关性;后者,即两组变量之间的相关称为典型相关,不在本节研究范围之内。
2.两个变量X 与Y 的相关性研究,是探讨这两个变量之间的关系密切到什么程度,能否给出一个定量的指标。
这个问题的难处在于“关系”二字,从数学角度看,两个变量X 、Y 之间的关系具有无限的可能性,因此泛泛谈“关系”不会有什么出路。
一个比较现实的想法是:确立一种“样板”关系,然后把X 、Y 的实际关系与“样板”关系比较,看它们“像”到了什么程度,给出一个定量指标。
3.取什么关系做“样板”关系?线性关系。
这是一种单调递增或递减的关系,在现实生活中广为应用;另外,现实世界中大量的变量服从正态分布,对这些变量而言,可以用线性关系或准线性关系构建它们之间的联系。
1.2 相关性度量1.概率论中用相关系数(correlation coefficient )度量两个变量的相关程度。
变量X 和Y 的相关系数定义为:)()(),(),(Y Var X Var Y X Cov Y X Corr其中Cov (X ,Y )是协方差,Var (X )和Var (Y )分别是变量X 和Y 的方差。
相关系数Corr (X ,Y )有性质: 1)1),(≤Y X Corr ;2)1),(=Y X Corr 当且仅当1}{=+=bX a Y P 。
而且当 Corr (X ,Y )=1时,有b >0,称为正相关;Corr (X ,Y )=-1时,有b <0,称为负相关。
特别,当Corr (X ,Y )=0,称X 和Y 不相关,这时它们没有线性关系。
为区别以下出现的样本相关系数,有时也把这里定义的相关系数称为总体相关系数。
用SPSS作回归分析

xi xi
y i
2n
n 5
∑ 140 1300 2528 21040
x xi 140 14
n 10
y yi 1300 130
n 10
ˆ0 y 1 x 130 514 60
位于有16000名 学生校园附近的
=
yˆ
60
516
140(千元)
yˆi 60 5xi
饭店的销售收入
y
变量间所具有的密切关联而又不能用函数关系精确表达的关系称相关关系。
具有相关关系的两 个变量可以是不同 类型的变量。本章 中所指的相关关系 是两个数值型变量 间的相关关系。
相关关系分析不强 调两变量间的先后 顺序,即不区分自 变量与因变量。
1400
1200 月 支 1000 出 ( 元 800 )
600
ˆ1
yi
ˆ0 ˆ0
ˆ1xi
2
0
yi
ˆ0 ˆ1xi ˆ1
20Βιβλιοθήκη 2yi ˆ0 ˆ1xi 0
2 yi ˆ0 ˆ1xi xi 0
n
i1
yi
nˆ0
ˆ1
n i 1
xi
n
n
n
i1
xi yi
ˆ0
i 1
xi
ˆ1
i 1
xi 2
ˆ1
xi yi
xi
y x y 月支出(元)
月收入(元)
家庭序号 月支出(元)
1148
8882
21
710
489
4558
22
937
1208
9053
23
1030
1065
8094
24
SPSS-回归分析

SPSS-回归分析回归分析(⼀元线性回归分析、多元线性回归分析、⾮线性回归分析、曲线估计、时间序列的曲线估计、含虚拟⾃变量的回归分析以及逻辑回归分析)回归分析中,⼀般⾸先绘制⾃变量和因变量间的散点图,然后通过数据在散点图中的分布特点选择所要进⾏回归分析的类型,是使⽤线性回归分析还是某种⾮线性的回归分析。
回归分析与相关分析对⽐:在回归分析中,变量y称为因变量,处于被解释的特殊地位;;⽽在相关分析中,变量y与变量x处于平等的地位。
在回归分析中,因变量y是随机变量,⾃变量x可以是随机变量,也可以是⾮随机的确定变量;⽽在相关分析中,变量x和变量y都是随机变量。
相关分析是测定变量之间的关系密切程度,所使⽤的⼯具是相关系数;⽽回归分析则是侧重于考察变量之间的数量变化规律。
统计检验概念:为了确定从样本(sample)统计结果推论⾄总体时所犯错的概率。
F值和t值就是这些统计检定值,与它们相对应的概率分布,就是F分布和t分布。
统计显著性(sig)就是出现⽬前样本这结果的机率。
标准差表⽰数据的离散程度,标准误表⽰抽样误差的⼤⼩。
统计检验的分类:拟合优度检验:检验样本数据聚集在样本回归直线周围的密集程度,从⽽判断回归⽅程对样本数据的代表程度。
回归⽅程的拟合优度检验⼀般⽤判定系数R2实现。
回归⽅程的显著性检验(F检验):是对因变量与所有⾃变量之间的线性关系是否显著的⼀种假设检验。
回归⽅程的显著性检验⼀般采⽤F 检验。
回归系数的显著性检验(t检验): 根据样本估计的结果对总体回归系数的有关假设进⾏检验。
1.⼀元线性回归分析定义:在排除其他影响因素或假定其他影响因素确定的条件下,分析某⼀个因素(⾃变量)是如何影响另⼀事物(因变量)的过程。
SPSS操作2.多元线性回归分析定义:研究在线性相关条件下,两个或两个以上⾃变量对⼀个因变量的数量变化关系。
表现这⼀数量关系的数学公式,称为多元线性回归模型。
SPSS操作3.⾮线性回归分析定义:研究在⾮线性相关条件下,⾃变量对因变量的数量变化关系⾮线性回归问题⼤多数可以化为线性回归问题来求解,也就是通过对⾮线性回归模型进⾏适当的变量变换,使其化为线性模型来求解。
spss对数据进行相关性分析实验报告
spss对数据进行相关性分析实验报告一、实验目的与背景在统计学的研究中,相关性分析是一种常见的分析方法,用于研究两个或多个变量之间的关联程度。
本实验旨在使用SPSS软件对收集到的数据进行相关性分析,并探索变量之间的关系。
二、实验过程1. 数据收集:根据研究目的,我们收集了一份包含多个变量的数据集。
其中,变量包括A、B、C等。
2. 数据准备:在进行相关性分析之前,我们需要对数据进行准备。
首先,我们载入数据集到SPSS软件中。
然后,对于缺失数据,我们根据需要采取相应的填补或删除策略。
接着,我们进行数据的清洗和整理,以确保数据的准确性和一致性。
3. 相关性分析:使用SPSS软件,我们可以轻松地进行相关性分析。
在SPSS的分析菜单中,选择相关性分析功能,并设置相应的参数。
我们将选择Pearson相关系数,该系数用于衡量两个变量之间的线性相关关系。
此外,还可以选择其他类型的相关系数,如Spearman相关系数,用于非线性关系的探索。
设置参数后,我们点击“运行”按钮,即可得到相关性分析的结果。
4. 结果解读:SPSS将为我们提供一份详细的结果报告。
我们可以看到每对变量之间的相关系数及其显著性水平。
如果相关系数接近1或-1,并且P值低于显著性水平(通常为0.05),则可以得出两个变量之间存在显著的线性相关关系的结论。
此外,我们还可以通过散点图、线性回归等方法进一步分析相关性结果。
5. 结论与讨论:根据相关性分析的结果,我们可以得出结论并进行讨论。
如果发现两个变量之间存在显著的相关关系,我们可以进一步探究其原因和意义。
同时,我们还可以提出假设并设计更深入的实验,以验证和解释这些相关性。
三、结果与讨论根据我们的研究目的和数据集,通过SPSS软件进行的相关性分析显示了一些有意义的结果。
我们发现变量A与变量B之间存在显著的正相关关系(Pearson相关系数为0.7,P<0.05)。
这表明随着A的增加,B也会相应增加。
相关性分析的原理及SPSS实现
实验一相关性分析相关性分析是考察两个变量之间线性关系的一种统计分析方法。
更精确地说,当一个变量发生变化时,另一个变量如何变化,此时就需要通过计算相关系数来做深入的定量考察。
P值是针对原假设H0:假设两变量无线性相关而言的。
一般假设检验的显著性水平为0.05,你只需要拿p值和0.05进行比较:如果P值小于0.05,就拒绝原假设H0,说明两变量有线性相关的关系,他们无线性相关的可能性小于0.05:如果大于0.05,则一般认为无线性相关关系,至于相关的程度则要看相关系数R值,r越大,说明越相关。
越小,相关程度越低。
而偏相关分析是指当两个变量同时与第三个变量相关时,将第三个变量的影响剔除,只分析另外两个变量之间相关程度的过程,其检验过程与相关分析相似。
使用spss软件对数据进行相关性分析,从变量之间的相关关系,寻求与人均食品支出密切相关的因素。
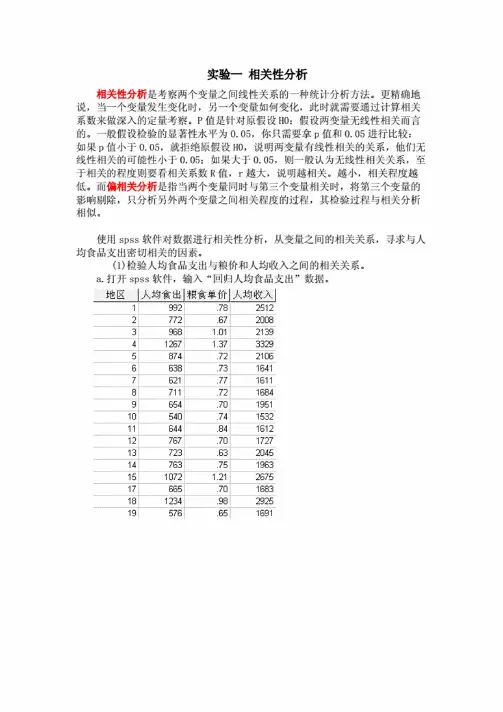
(1)检验人均食品支出与粮价和人均收入之间的相关关系。
a.打开spss软件,输入“回归人均食品支出”数据。
地区1|人均食出|粮食单价|人均收入|1992.7825122772.6720083968 1.01213941267 1.3733295874.7221066638.7316417621.7716118711.7216849654.70195110540.74153211644.84161212767.70172713723.63204514763.751963151072 1.21267517665.701683181234.98292519576.65169120733.84192921968 1.49203222717.80190623716.72170524627.61154225829.701987261016 1.04235926650.78176427928 1.01208728650.83195929852.72210130609.681877b.在 spss 的菜单栏中选择点击 Analyze —correlate — Bivariate,弹出一个对话窗口。
相关性分析spss2篇
相关性分析spss2篇篇一:多元线性回归分析在SPSS中的应用一、前言多元线性回归是一种统计分析方法,它可以用来解决多个自变量与一个因变量之间的关系。
在实际应用中,多元线性回归分析被广泛用于预测和模拟。
本文主要介绍多元线性回归在SPSS中的应用。
二、数据导入在分析多元线性回归之前,需要先将数据导入SPSS软件。
SPSS软件支持多种数据文件格式,如Excel、CSV等。
下面以Excel数据格式为例进行说明。
打开SPSS软件,选择File -> Open -> Data,再选择Excel文件格式。
在弹出的窗口中选择数据所在的工作表和范围,然后点击OK。
三、模型建立在SPSS软件中,可以通过菜单栏选择Analyze -> Regression -> Linear来建立多元线性回归模型。
在Linear Regression窗口中,将Y变量和X变量分别添加到Dependent 和Independent栏中,并点击OK按钮。
如果需要进行对各个特征变量的系数进行统计学显著性检验,可以在Linear Regression窗口中点击Statistics按钮,然后勾选Model fit和Coefficients即可。
四、模型评估为了评估多元线性回归模型的拟合程度,可以使用R²(R Square)和调整后的R²(Adjusted R Square)这两个指标。
R²表示模型解释因变量变异程度的比例,值越接近1表示模型拟合程度越好;Adjusted R²则考虑了独立变量的数量,是更具有实际意义的指标。
在SPSS中,可以在Linear Regression窗口的Model Summary表格中查看R²和Adjusted R²指标的值。
五、模型预测在模型建立完成后,可以使用该模型进行预测。
在SPSS软件中,可以通过菜单栏选择Analyze -> Regression -> Predict来进行预测。
第8章SPSS的相关和线性回归
– 确定显著性水平,并作出决策
• 若t>t,拒绝H0 • 若t<t,接受H0
示例
对前例计算的相关系数进行显著性检(0.05)
1. 提出假设:H0: ;H1: 0
2. 计算检验的统计量
t 0.9987 13 2 64.9809 1 0.99872
3. 根据显著性水平=0.05,查t分布表得 t(n-2)=2.201
0.9987
•
人均国民收入与人均消费金额之间的相关
系数为 0.9987,两者之间高度正相关.
相关系数的显著性检验
1. 检验两个变量之间是否存在线性相关关系
2. 等价于对回归系数 b1的检验
3. 采用 t 检验 4. 检验的步骤为
– 提出假设:H0: ;H1: 0
–
计算检验的统计量: t r n 2 ~ t(n 2)
相关关系的类型
相关关系
线性相关 非线性相关 完全相关
不相关
正负 相相 关关
正负 相相 关关
相关关系的图示
完全正线性相关
正线性相关
完全负线性相关
负线性相关
非线性相关
不相关
相关关系的测度——相关系数
1.对变量之间关系密切程度的度量 2.对两个变量之间线性相关程度的度量称为简单
相关分析 线性回归分析
提纲
相关分析
1
偏相关分析
2
回归分析
3
曲线估计
4
一、相关分析
• 一. 变量相关的概念 • 二. 相关系数及其计算
变量间的关系——函数关系
1. 是一一对应的确定关系
设有两个变量 x 和 y ,变量
y 随变量 x 一起变化,并完 y
第八章SPSS的相关分析和线性相关分析
第八章SPSS的相关分析和线性相关分析在统计学中,相关分析是用来研究两个或多个变量之间关系的一种方法。
SPSS(Statistical Package for the Social Sciences)是一款常用的统计软件,可用于进行相关分析和线性相关分析。
本章将介绍如何使用SPSS进行相关分析和线性相关分析,以及如何解释分析结果。
一、相关分析相关分析是一种用于研究变量之间关系的统计方法。
通过相关分析可以确定两个或多个变量之间的关联程度,以及这种关联程度的方向(正相关或负相关)。
在SPSS中进行相关分析的步骤如下:1.打开SPSS软件,选择“文件”>“打开”>“数据”,选择要进行分析的数据文件,点击“打开”。
2.在菜单栏中选择“分析”>“相关”>“双变量”或“多变量”。
3. 在弹出的对话框中,将变量移动到“变量”框中。
可以选择自定义相关性系数的类型,如Pearson相关系数、Spearman相关系数等。
4.点击“OK”进行相关分析。
5.SPSS将生成一个相关矩阵和一个相关系数表格,展示了变量之间的关联程度。
在进行相关分析时,需要注意以下几点:1.相关系数的取值范围为-1到1,-1表示完全负相关,1表示完全正相关,0表示没有相关性。
2.根据相关系数的取值大小可以判断变量之间的关联程度,一般认为相关系数大于0.7为强相关,0.3到0.7为中等相关,小于0.3为弱相关。
3.相关分析只能判断变量之间是否存在关系,不能确定因果关系。
线性相关分析是一种用于研究两个变量之间线性关系的统计方法。
通过线性相关分析可以确定两个连续变量之间的关联程度,以及这种关联程度的方向(正相关或负相关)。
在SPSS中进行线性相关分析的步骤如下:1.打开SPSS软件,选择“文件”>“打开”>“数据”,选择要进行分析的数据文件,点击“打开”。
2.在菜单栏中选择“分析”>“相关”>“双变量”。
SPSS学习系列27.回归分析报告
27. 回归分析回归分析是研究一个或多个变量(因变量)与另一些变量(自变量)之间关系的统计方法。
主要思想是用最小二乘法原理拟合因变量与自变量间的最佳回归模型(得到确定的表达式关系)。
其作用是对因变量做解释、控制、或预测。
回归与拟合的区别:拟合侧重于调整曲线的参数,使得与数据相符;而回归重在研究两个变量或多个变量之间的关系。
它可以用拟合的手法来研究两个变量的关系,以及出现的误差。
回归分析的步骤:(1)获取自变量和因变量的观测值;(2)绘制散点图,并对异常数据做修正;(3)写出带未知参数的回归方程;(4)确定回归方程中参数值;(5)假设检验,判断回归方程的拟合优度;(6)进行解释、控制、或预测。
(一)一元线性回归一、基本原理一元线性回归模型:Y=0+1X+ε其中 X 是自变量,Y 是因变量, 0, 1是待求的未知参数, 0也称为截距;ε是随机误差项,也称为残差,通常要求ε满足:① ε的均值为0; ② ε的方差为 2;③ 协方差COV(εi , εj )=0,当i≠j 时。
即对所有的i≠j, εi 与εj 互不相关。
二、用最小二乘法原理,得到最佳拟合效果的01ˆˆ,ββ值: 1121()()ˆ()niii nii x x yy x x β==--=-∑∑, 01ˆˆy x ββ=- 三、假设检验1. 拟合优度检验计算R 2,反映了自变量所能解释的方差占总方差的百分比,值越大说明模型拟合效果越好。
通常可以认为当R 2大于0.9时,所得到的回归直线拟合得较好,而当R 2小于0.5时,所得到的回归直线很难说明变量之间的依赖关系。
2. 回归方程参数的检验回归方程反应了因变量Y 随自变量X 变化而变化的规律,若 1=0,则Y 不随X 变化,此时回归方程无意义。
所以,要做如下假设检验:H 0: 1=0, H 1: 1≠0; (1) F 检验若 1=0为真,则回归平方和RSS 与残差平方和ESS/(N-2)都是 2的无偏估计,因而采用F 统计量:来检验原假设β1=0是否为真。