
计量经济学作业
课程名称: 计量经济学实验
专 业:信息与计算科学
班 级:信息12-1
学 号:***********
* *****
指导老师:***
所属学期:2015-2016学年第一学期
1 作业一:
下表是中国2007年各地区税收Y和国内生产总值GDP的统计资料。
单位:亿元
地区 Y GDP 地区 Y GDP
北 京 1435.7 9353.3 湖 北 434.0 9230.7
天 津 438.4 5050.4 湖 南 410.7 9200.0
河 北 618.3 13709.5 广 东 2415.5 31084.4
山 西 430.5 5733.4 广 西 282.7 5955.7
内蒙古 347.9 6091.1 海 南 88.0 1223.3
辽 宁 815.7 11023.5 重 庆 294.5 4122.5
吉 林 237.4 5284.7 四 川 629.0 10505.3
黑龙江 335.0 7065.0 贵 州 211.9 2741.9
上 海 1975.5 12188.9 云 南 378.6 4741.3
江 苏 1894.8 25741.2 西 藏 11.7 342.2
浙 江 1535.4 18780.4 陕 西 355.5 5465.8
安 徽 401.9 7364.2 甘 肃 142.1 2702.4
福 建 594.0 9249.1 青 海 43.3 783.6
江 西 281.9 5500.3 宁 夏 58.8 889.2
山 东 1308.4 25965.9 新 疆 220.6 3523.2
河 南 625.0 15012.5
要求,以手工和运用eviews软件:
(1)作出散点图,简历税收岁国内生产总值GDP变化的一元线性回归方程,并解释斜率的经济意义;
(2)对所建立的回归方程进行检验;
(3)若2008年某地区国内生产总值为8500亿元,求该地区税收收入的预测值及预测区间;
2
答:散点图
图 1-1
图 1-2
由上图数据结果,可得回归模型
10.629630.071047iiYX
(0.123500) (9.591245)
20.760315R, 9199198F, ..1.570523DW
3 其中,括号内的数为相应的t检验值。2R是可决系数,F与..DW是有关的两个检验统计量。
(1)
斜率的经济意义:斜率2ˆ0.071047为边际可支国内生产总值GDP,表明2007年,中国内地各省区GDP每增加1亿元时,税收平均增加0.071047亿元。
(2)
在显著性水平下,自由度为31-2=29的t分布的临界值0.025(29)2.05t。因此,从参数的t检验值看,斜率项显然不为零,但不拒绝截距项为零的假设。另外,拟合优度20.760315R表明,税收的76%的变化也以由GDP的变化来解释,因此拟合情况较好。由图1-3可直接观察到拟合情况。
图1-3 (3)
4 图1-4
图1-5
图1-6
由表可知:样本均值:
样本标准差:
样本方差:
即:若2008年某地区国内生产总值为8500亿元,该地区税收收入的预测值为593.2667。 152.7604xS64.57823127)(xVar126.8891x
5 样本: 预测值:
残差平方和: 临界值:
由公式:
代入以上数据得总体条件均值的预测区间为: ( 479.51 , 707.02 )
由公式:
代入以上数据得个别预测值的预测区间为:( -49.34 , 1235.88 )
85000X2667.593ˆ0Y27603102ie05.2)29(025.0t0000022(|)YYEYXtStSYY000000022YYYYtStSYYY
6 作业二:
在一项对某社区家庭对某种消费品的消费需要调查中,得到书中的表所示的资料。
序号 对某商品的消费支出Y 商品单价X1
家庭月收入X2 序号
对某商品的消费支出Y 商品单价X1 家庭月收入X2
1 591.9 23.56 7620 6 644.4 34.14
12920
2 654.5
24.44 9120 7 680.0 35.3 14340
3 623.6 32.07 10670 8 724.0 38.7 15960
4 647.0 32.46 11160 9 757.1 39.63 18000
5 674.0 31.15 11900 10 706.8 46.68 19300
请用手工与软件两种方法对该社区家庭对该商品的消费需求支出作二元线性回归分析。
(1)估计回归方程的参数及及随机干扰项的方差2,计算2R及2R。
(2)对方程进行F检验,对参数进行t检验,并构造参数95%的置信区间.
(3)如果商品单价变为35元,则某一月收入为20000元的家庭的消费支出估计是多少?构造该估计值的95%的置信区间。
答:
(1)手工方法:
以矩阵形式表达,二元样本回归方程为
YXβe
参数的估计值为1XXXY
由于
15.325360280.363021100.000538170.363021100.033816040.000059580.000538170.000059580.00000011XX
6703.3228956.6389275178XY
7 于是0112626.5099.790570.02862XXXY
根据随机干扰项方差的估计式
221ienk得到21nkee
而
1451507245129552116.85eeYYYYYXβYXβYYYXββXYβXXβYYYXββXYβXXXXXYYYYXβ
故22116.85302.4111021nkee
又由于2222222451507210449342.321648.74iiiiTSSYYYYYYYnYnYYY
故
22112116.8510.902221648.74RSSRTSSnYeeYY
221110.87431nRRnk
Eview方法:
8 利用eviews得到回归结果
图2-1
根据图2-1的数据,得到模型的估计结果为:
Y = 626.5092847 - 9.790570097*X1 + 0.02861815879*X2
(15.61195) (-3.061617) (4.902030)
R2=0.902218 2R =0.874281 D.W.=1.650804
∑ei2=2116.807 F=32.29408 df=(2,7)
随机干扰项的方差估计值为:2ˆ2ie/n3=2116.807/7=0.18108225
(2)方程的总体线性性检验由下面的F检验进行:
1121648.742116.85232.2921648.741021ESSTSSRSSkkFTSSTSSnknk
而在Eviews的回归结果(图2-1)也表明:
这一年,Y的变化的90.2218%可由X1和X2的变化来解释,
其F值为32.29408。在5%的显著性水平下,F统计量的临界值未0.052,74.74F,
9 可见32.29>4.74,表明方程的总体线性性显著成立。
在5%的显著性水平下,自由度为7的t分布的临界值为0.025(7)2.365t,可见常数项及X1与X2的总体参数值均显著地易于零。
常数项,X1与X2参数的95%的置信区间分别为
0ˆ00.025ˆ626.5092.36540.13tS 或(531.62, 721.40)
1ˆ10.025ˆ9.7912.3653.1978tS 或(-17.35,-2.22)
2ˆ20.025ˆ0.02862.3650.0058tS 或(0.014, 0.042)
(3)
图2-2
10
图2-3
由图2-3可以看出商品单价变为35元,则某一月为20000元的家庭的消费支出估计是856.2025.
--如图2-4所示,在第11行(预测行)即可直接显示个别值的预测值标准差为:0ˆ40.92713YS
而由于
15.325360280.363021100.000538170.363021100.033816040.000059580.000538170.000059580.00000011XX
因此,取0=13520000X,Y均值的预测的标准差为
021ˆ00ˆ()302.414.5391372.6237.05YSXXXX
在5%的显著性水平下,自由度为10-2-1=7的t分布的临界值为0.025(7)2.365t,
于是Y均值的95%的预测区间为
856.202.36537.05 或(768.58,943.82)
同样容易得到Y个值的预测的标准差为
021ˆ00ˆ1()302.411.26611675.0340.93YSXXXX
于是,Y值的95%的预测区间为
856.202.36540.93 或(759.41,952.99)
计量经济学作业
计量经济学作业
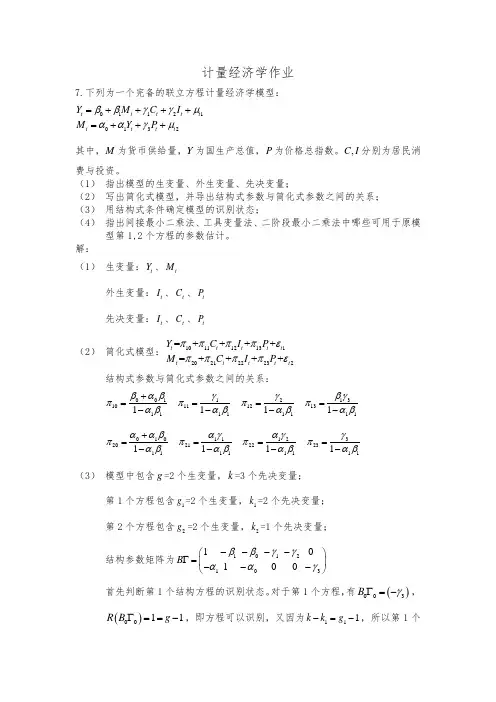
7.下列为一个完备的联立方程计量经济学模型:
011210132tttttttttYMCIMYP
其中,M为货币供给量,Y为国生产总值,P为价格总指数。,CI分别为居民消费与投资。
(1) 指出模型的生变量、外生变量、先决变量;
(2) 写出简化式模型,并导出结构式参数与简化式参数之间的关系;
(3) 用结构式条件确定模型的识别状态;
(4) 指出间接最小二乘法、工具变量法、二阶段最小二乘法中哪些可用于原模型第1,2个方程的参数估计。
解:
(1) 生变量:tY、tM
外生变量:tI、tC、tP
先决变量:tI、tC、tP
(2) 简化式模型:101112131202122232=++++=++++ttttttttttYCIPMCIP
结构式参数与简化式参数之间的关系:
001131210111213111111111111
0103111220212223111111111111
(3) 模型中包含g=2个生变量,k=3个先决变量;
第1个方程包含1g=2个生变量,1k=2个先决变量;
第2个方程包含2g=2个生变量,2k=1个先决变量;
结构参数矩阵为101210310100B
首先判断第1个结构方程的识别状态。对于第1个方程,有003B,0011RBg,即方程可以识别,又因为111kkg,所以第1个结构方程恰好识别。
对于第2个结构方程,有0012B,0011RBg,即方程可以识别,又因为221kkg,所以第2个结构方程过度识别。
(4) 工具变量法适用于原模型第1个方程的参数估计;
间接最小二乘法适用于原模型第1个方程的参数估计;
计量经济学作业-第四五章
传播优秀Word版文档 ,希望对您有帮助,可双击去除!
1 / 20 第四章上机习题
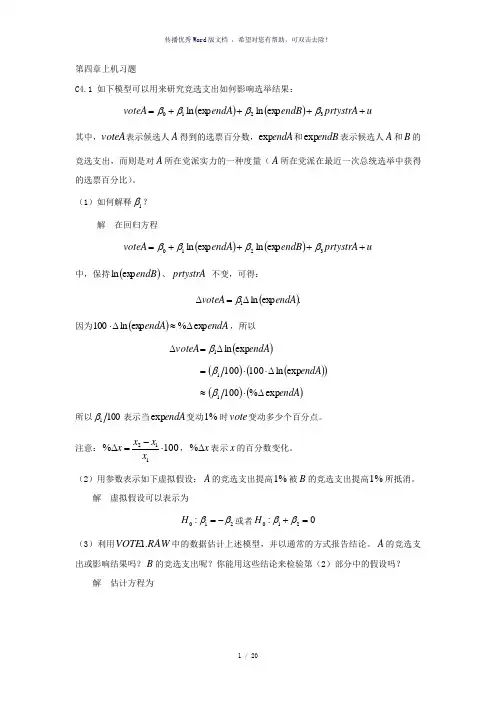
C4.1 如下模型可以用来研究竞选支出如何影响选举结果:
uprtystrAendBendAvoteA3210explnexpln
其中,voteA表示候选人A得到的选票百分数,endAexp和endBexp表示候选人A和B的竞选支出,而则是对A所在党派实力的一种度量(A所在党派在最近一次总统选举中获得的选票百分比)。
(1)如何解释1?
解 在回归方程
uprtystrAendBendAvoteA3210explnexpln
中,保持endBexpln、prtystrA 不变,可得:
.expln1endAvoteA
因为endAendAexp%expln100,所以
endAendAendAvoteAexp%100expln100100expln111
所以1001表示当endAexp变动%1时vote变动多少个百分点。
注意:100%112xxxx,x%表示x的百分数变化。
(2)用参数表示如下虚拟假设:A的竞选支出提高%1被B的竞选支出提高%1所抵消。
解 虚拟假设可以表示为
210:H或者0:210H
(3)利用RAWVOTE.1中的数据估计上述模型,并以通常的方式报告结论。A的竞选支出或影响结果吗?B的竞选支出呢?你能用这些结论来检验第(2)部分中的假设吗?
解 估计方程为传播优秀Word版文档 ,希望对您有帮助,可双击去除!
793.0,14.10052,173062.0379.0382.0926.3152.0)ln(exp615.6)ln(exp083.6079.452RSSRnprtystrAendBendAvoteA
计量经济学作业第5章(含答案)

第5章 习 题
一、单项选择题
1.对于一个含有截距项的计量经济模型,若某定性因素有m个互斥的类型,为将其引入模型中,则需要引入虚拟变量个数为( )
A. m B. m-1 C. m+1
D. m-k
2.在经济发展发生转折时期,可以通过引入虚拟变量方法来表示这种变化。例如,研究中国城镇居民消费函数时。1991年前后,城镇居民商品性实际支出Y对实际可支配收入X的回归关系明显不同。现以1991年为转折时期,设虚拟变量,数据散点图显示消费函数发生了结构性变化:基本消费部分下降了,边际消费倾向变大了。则城镇居民线性消费函数的理论方程可以写作( ) A. B.
C. D.
3.对于有限分布滞后模型
在一定条件下,参数可近似用一个关于的阿尔蒙多项式表示(),其中多项式的阶数m必须满足( )
A. B. C.
D.
4.对于有限分布滞后模型,解释变量的滞后长度每增加一期,可利用的样本数据就会( )
A. 增加1个 B. 减少1个 C. 增加2个 D. 减少2个
5.经济变量的时间序列数据大多存在序列相关性,在分布滞后模型中,这种序列相关性就转化为( )
A.异方差问题 B. 多重共线性问题
C.序列相关性问题 D. 设定误差问题 6.将一年四个季度对因变量的影响引入到模型中(含截距项),则需要引入虚拟变量的个数为( )
A. 4 B. 3 C.
2 D. 1
7.若想考察某两个地区的平均消费水平是否存在显著差异,则下列那个模型比较适合(Y代表消费支出;X代表可支配收入;D2、D3表示虚拟变量) ( ) A. B. C. D.
计量经济学作业 2

计量经济学作业
一. 一元线性回归:
居民消费模式和消费规模分析
研究的目的要求
居民消费在社会经济的持续发展中有着重要的作用。居民合理的消费模式和居民适度的消费规模有利于经济持续健康的增长,而且这也是人民生活水平的具体体现。改革开放以来随着中国经济的快速发展,人民生活水平不断提高,居民的消费水平也不断增长。但是在看到这个整体趋势的同时,还应看到全国各地区经济发展速度不同,居民消费水平也有明显差异。例如,2002年全国城市居民家庭平均每人每年消费支出为6029.88元, 最低的黑龙江省仅为人均4462.08元,最高的上海市达人均*****元,上海是黑龙江的
2.35倍。为了研究全国居民消费水平及其变动的原因,需要作具体的分析。影响各地区居民消费支出有明显差异的因素可能很多,例如,居民的收入水平、就业状况、零售物价指数、利率、居民财产、购物环境等等都可能对居民消费有影响。为了分析什么是影响各地区居民消费支出有明显差异的最主要因素,并分析影响因素与消费水平的数量关系,可以建立相应的计量经济模型去研究。
2002年中国各地区城市居民人均年消费支出和可支配收入数据含义如下: 城市居民家庭平均每人每年消费支出(元)Y
城市居民人均年可支配收入(元) X
根据数据在Eviews初步做出散点图,如上
图示:
通过观察散点图,可以大致确定变量Y、X
之间存在线性关系。
(1).拟建立如下一元线性回归模型:
Y= 0+ 1Χ+
由Eviews对数据进行分析,得下表
一般可写出如下回归分析结果:
=282.24+0.759
常数C值得标准误差为287.2649,T=0.9825;
标准误差为0.0*****,T=20.*****。
2=0.*****;F=421.9023
计量经济学课程作业
第 1 页 共 20 页
广东石油化工学院 2015—2016学年第二学期
《计量经济学》作业
班级:
作业1
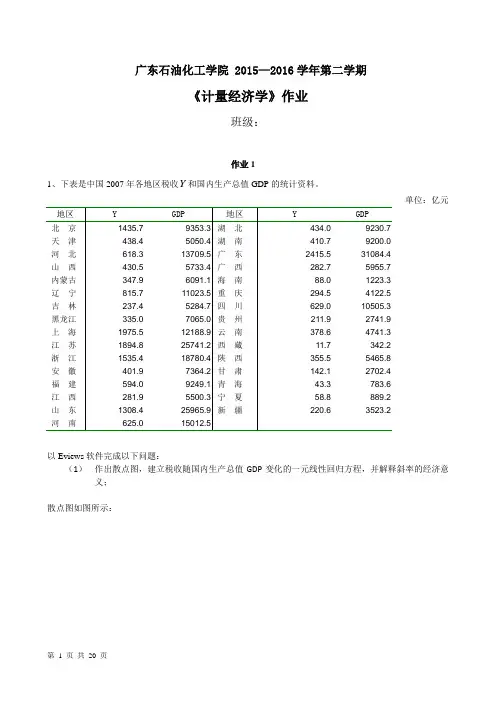
1、下表是中国2007年各地区税收Y和国内生产总值GDP的统计资料。
单位:亿元
地区 Y GDP 地区 Y GDP
北 京 1435.7 9353.3 湖 北 434.0 9230.7
天 津 438.4 5050.4 湖 南 410.7 9200.0
河 北 618.3 13709.5 广 东 2415.5 31084.4
山 西 430.5 5733.4 广 西 282.7 5955.7
内蒙古 347.9 6091.1 海 南 88.0 1223.3
辽 宁 815.7 11023.5 重 庆 294.5 4122.5
吉 林 237.4 5284.7 四 川 629.0 10505.3
黑龙江 335.0 7065.0 贵 州 211.9 2741.9
上 海 1975.5 12188.9 云 南 378.6 4741.3
江 苏 1894.8 25741.2 西 藏 11.7 342.2
浙 江 1535.4 18780.4 陕 西 355.5 5465.8
安 徽 401.9 7364.2 甘 肃 142.1 2702.4
福 建 594.0 9249.1 青 海 43.3 783.6
江 西 281.9 5500.3 宁 夏 58.8 889.2
山 东 1308.4 25965.9 新 疆 220.6 3523.2
河 南 625.0 15012.5
计量经济学上机作业试题以及答案
题目:
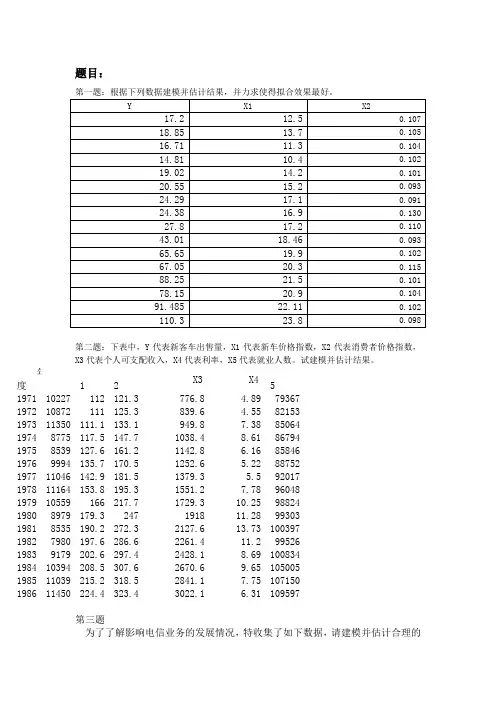
第一题:根据下列数据建模并估计结果,并力求使得拟合效果最好。
Y X1 X2
17.2 12.5 0.107
18.85 13.7 0.105
16.71 11.3 0.104
14.81 10.4 0.102
19.02 14.2 0.101
20.55 15.2 0.093
24.29 17.1 0.091
24.38 16.9 0.130
27.8 17.2 0.110
43.01 18.46 0.093
65.65 19.9 0.102
67.05 20.3 0.115
88.25 21.5 0.101
78.15 20.9 0.104
91.485 22.11 0.102
110.3 23.8 0.098
第二题:下表中,Y代表新客车出售量,X1代表新车价格指数,X2代表消费者价格指数,X3代表个人可支配收入,X4代表利率,X5代表就业人数。试建模并估计结果。
年度 1 X2 X3 X4 5
1971 10227 112 121.3 776.8 4.89 79367
1972 10872 111 125.3 839.6 4.55 82153
1973 11350 111.1 133.1 949.8 7.38 85064
1974 8775 117.5 147.7 1038.4 8.61 86794
1975 8539 127.6 161.2 1142.8 6.16 85846
1976 9994 135.7 170.5 1252.6 5.22 88752
1977 11046 142.9 181.5 1379.3 5.5 92017
1978 11164 153.8 195.3 1551.2 7.78 96048
1979 10559 166 217.7 1729.3 10.25 98824
1980 8979 179.3 247 1918 11.28 99303
1981 8535 190.2 272.3 2127.6 13.73 100397
计量经济学作业题解答
8.9
变异来源 平方和(SS) 自由度 平方和均值(MSS)
来自回归(ESS) 65965 2
32982.5
来自残差(RSS) 77 12 6.4167
总合(TSS) 66042 14 -
a.因为n-1=14,所以样本容量为n=15。
b.RSS=TSS-ESS=66042-65965=77。
c.ESS的自由度为2,因为它是一个三变量模型。RSS的自由度为12,因为15-3=12。
d.9988.02TSSESSR,9986.01)1(122knnRR。
e.采用联合假设,即两个变量的系数联合或同时为零。这个假设表明两个解释变量联合对应变量Y无影响。
f.不能,因为它们是联合对Y的影响,而不是各自的。
8.11
a.所有解释变量都与应变量Y正相关。在其他条件保持不变的情况下,空调的BTU比率每增加一个百分点,空调价格平均上升0.023元。同样地,在其他条件不变时,能量效率每增加一个百分点,空调价格平均上升19.729元。类似地,在其他条件不变时,设定数每增加一点,空调价格平均上升7.653元。当1X=2X=3X=0时,空调价格平均为-68.236元。
b.因为84.02R,所以我们可以说84%被样本回归直线解释,拟合度相当高,回归结果有经济意义。而且它说明了解释量对空调价格的影响。
c. 下面我们进行检验联合假设:0:20H vs 0:21H
)15(753.16.4005.0023.0)(095.0222tSet
所以我们拒绝零假设,也就是说空调的BTU比率对价格有正向影响。
d.)15,3(F3.287425.2641984.011484.0110.9522knRkRF
能够拒绝零假设:三个解释量在很大程度上没能解释空调价格的变动。
8.12
a. 边际消费倾向是每额外增加1美元个人可支配收入所增加的消费支出,所以边际消费倾向就是2X的系数,即MPC=0.93。
安徽大学《计量经济学》计量经济学作业
1 / 3 计量经济学作业
习题1 根据习题中给的数据,对每一个X,随机抽取一个Y,结果如下: 每周
收入X 80 100 120 140 160 180 200 220 240 260
每周
消费
支出Y 70 65 90 95 110 115 120 140 155 150
(1)以Y为纵轴,X为横轴作散点图;
每周消费水平
y = 0.5091x + 24.455
050100150200
050100150200250300
(2)Y与X之间的关系如何? 答:由上图可知,收入X与消费支出Y之间存在着正相关关系,收入越高,消费
支出越大。
(3)求样本回归函数;
在Excel中的相应散点图中选择添加趋势线并显示公式即可得其样本回归函数
为: y=0.5091x+24.455 (4)在同一个图中,作出SRF和PRF;
每周收
入X 每周消费支出Y Y条件
均值
80 55 60 65 70 75 65
100 65 70 74 80 85 88 77
120 79 84 90 94 98 89
140 80 93 95 103 108 113 115 101
160 102 107 110 116 118 125 113
180 110 115 120 130 135 140 125
200 120 136 140 144 145 137
220 135 137 140 152 157 160 162 149
240 137 145 155 165 175 189 161
260 150 152 175 178 180 185 191 173
由上表可得:总体回归函数图像如下:以横坐标为收入X,纵坐标为支出Y。 2 / 3 每周消费支出
y = 0.6x + 17
050100150200250
050100150200250300
(5)SRF和PRF相同吗?为什么?
答:(1)上图显示了SRF与PRF各自的图像,蓝点图代表着PRF即总体回归函数,
计量经济学作业(一)
一元线性回归的预测
1
贵阳学院
贵阳学院数 成绩
课程名称:计量经济学
指导教师:陈蕾
实验日期:2012/4/30
院(系):数学系
专业班级:09信息与计算科学
学生姓名:韩丹 李敏鸿 冉茂欧 罗圣永
唐菊
实验项目名称:一元线性回归方程的预测
一元线性回归的预测
2
中国居民人均消费模型
摘 要
随着社会经济发展的步伐越来越快,人民的生活水平也得到明显的提高。中国居民消费与收入的关系已成为重要的经济活动问题,因此建立总量消费函数(aggregate consumption function)已成为宏观经济管理的重要手段。
为研究中国居民人均消费模型,需建立适当的数学模型。对于时间序列数据,也可以建立类似于截面数据的计量经济模型。使用Excel来统计数据,并采用Eviews6.0软件对所建立的回归模型进行回归分析。通过回归估计的结果来检验模型的拟合程度,并根据拟合较好的回归模型来预测今后几年的中国居民人均消费水平。
关键词 人均消费模型 Excel 时间序列Eviews6.0软件 回归分析 拟合程度
一、问题重述
表2.6.3给出了中国名义支出法国内生产总值GDP、名义居民总消费CONS以及表示宏观税赋的税收总额TAX、表示价格变化的居民消费价格指数CPI(1990=100),并由这些数据整理出实际支出法国内生产总值GDPC=GDP/CPI、居民实际消费总支出Y=CONS/CPI,以及实际可支配收入X=(GDP-TAX)/CPI。为了从总体上考察中国居民人均收入与消费的关系,建立计量经济模型。
二、问题背景
为了制定更好的宏观经济管理制度,由《中国统计年鉴》整理所得到1987---2006年的时间序列数据(time series data),即观测值是连续不同年份中的数据。通过数据建立计量经济模型,并借助经济分析软件Eviews回归分析所建立的模型的拟合程度、预测2006年之后的中国居民的消费总量。
税收收入预测模型-计量经济学作业
计量经济学大作业
税收收入预测模型
选题背景:
数据挖掘是涉及数据库、统计学等学科的一门相当活跃的研究领域,是从数据集中识别出有效的、新颖的、潜在有效的以及最终可理解的模式的非平凡过程。预测是数据挖掘技术中重要的组成部分。税收收入预测一直是税务部门的一项重要工作,它决定着税收计划的制定,而税收计划的制定是经济活动的一项重要内容。针对目前税收计划的制定仍以基数加预计增长率这一方式进行的现状,要求尽快建立起一套以税收收入预测为基础的科学预测的体系,从而掌握组织收入的主动性。因此利用统计学及数据挖掘的方法科学正确的进行税收预测工作对于税务部门具有非常重要的意义。 本文对数据挖掘的相关概念、过程,统计学的相关知识进行了介绍,将数据挖掘应用于税收预测中,通过对大量历史数据的记录和与之相关的各种数据的分析,使用回归和滚动预测方法建立预测模型,对税收收入情况进行了预测,实现了对2005年度税收收入预测。并对各预测模型进行了实验结果的对比分析,指出滚动预测方法较回归预测方法能更好地进行税收收入分月预测,从而更好地指导税收计划的完成,为科学地建立税收计划进行了有效地探索,并为税收计划工作提供了重要的科学依据。 本文的主要工作是对郑州市国税局征管系统中的征收数据进行挖掘分析,建立回归和滚动预测模型。通过对税收收入问题的研究与实现,从中探索了一些可行的方法,这为税收预测问题提出了一个新的视角。本课题的成果对于税收收入预测体系,特别是基于回归预测和滚动预测的方法具有一定的参考价值。
税收收入预测是指在一定的经济理论指导下,根据经济和税收统计资料,在定性分析的基础上,运用定量方法,对未来税收收入总量和结构等发展趋势所做出的分析、判断和推测。
税收收入预测对税收工作有着 重要的作用,不仅可以为领导制订计划提供数理依据,同时也有助于加强组织收入工作,有助于税务工作者根据经济的变化及时调整相应的政策。
1税收预测工作为税收决策提供科学依据