
第7章 统计技术(1)——回归
社会统计学第十二章 相关与回归分析

2. 相关方向:正相关和负相关 所谓正相关关系是指一个变量的值增加时,另一变
量的值也增加。例如,受教育水平越高找到高薪水工作的 机会也越大。而负相关关系是指一个变量的值增加时,另 一变量的值却减少。例如,受教育水平越高,理想子女数 目越少。要强调的是,只有定序以上测量层次的变量才分 析相关方向,因为只有这些变量的值有高低或多少之分。 至于定类变量,由于变量的值并无大小、高低之分,故定 类变量与其他变量相关时就没有正负方向了。
父母智力 组合
优+优
优+劣 一般+一般
劣+劣
子女智力 子女智力
优秀
一般
71.6 25.4
33.6 42.7
18.6 66.9
5.4 34.4
子女智力 低下
3.0 23.7 14.5 60.2
通过列联表研究定类变量之间的关联性,这 实际上是通过相对频数条件分布的比较进行的。 如果对不同的X,Y的相对频数条件分布不同,且 和Y的相对频数边际分布不同,则两变量之间是 相关的。而如果变量间是相互独立的话,必然存 在着Y的相对频数条件分布相同,且和它的相对 频数边际分布相同。后者用数学式表示就是
r×c相对频数联合分布列联表
控制X,Y相对频数条件分布列联表
控制Y,X相对频数条件分布列联表
[例A1]试把下表所示的频数分布列联表,转 化为自变量受到控制的相对频数条件分布列联 表,并加以相关分析。
投票行为
受教育程度X
Y
大学以 大学以
FY
上
下
投票
160
129
289
弃权
7
61
68
合计:FX 167
r×c相对频数分布列联表的一般形式
在相对频数分布列联表中,各数据为各分类
第七章_主成分分析

3. 根据前几个较大特征根的累计贡献确定主成分 的个数m(m<p),并确定取前m 个特征向量。 4. 得到以特征向量为系数的线性组合形成的主成分 F1,F2,…,Fm ,且它们的方差等于前几个较大的 特征根,即 Var(Fi)=λ i
42
综上所述,求综合变量(主成分)F1 ,..., Fm 的过程可知,主成分在几何图形中的含义就是旋转 后的新坐标系的主轴,它们彼此不相关(图形上为 垂直),其方向就是特征向量的方向,其方差贡献 就是相应的特征值。 因此,我们利用样本数据求解主成分的过程实 际上就转化为求相关阵或离差阵的特征值和特征向 量的过程。这是最关键的。
17
18
19
2 主成分的几何意义
20
主成分的几何意义(续1)
21
主成分的几何意义(续2)
从几何上看,寻找主成分的问题,就是 寻找多维空间中椭球体的主轴问题,从数学上 容易得到它们是Xl,X2,…,Xp 的相关矩阵中 p个较大特征值所对应的特征向量,这就是主 轴的向量 通常, 用雅可比 (Jacobi) 方法计算矩阵 的特征值和特征向量。
39
注意:这个变量的顺序是不对的,应该是x3, x1, x8, x7, x2, 40 x5, x4, x6 的顺序。这是书中的错误,请上机验证。
41
再次总结前面的内容
1. 先求出向量X的协方差阵∑或数据标准化处理后 的相关阵R 2. 求该矩阵特征值(由大到小排列)1 2 p 0 以及对应的单位特征向量 u1 ,..., u p
5
但是,PCA和FA所使用的协方差矩阵
不同于前面的均值-协方差分析。均值—协方差分 析仅仅度量的是所有变量形成的集合的总体变异性, 而没有特别指明其子集合(变量的线性组合)对总 变异性的贡献。
常用统计技术考题

常用统计技术第一章1、学习掌握统计技术的意义和作用主要有:1)已有越来越多的组织开始应用统计技术2)顾客对于组织运用统计技术的要求趋于严格3)越开越多的组织不再满足于一般性的认证审核,而是希望认证审核成为一种增值的活动4)GB/Z19027标准有认证的要求A、仅1)和2)B、1)2)3)√C、仅1)和2)D、仅3)和4)2、下列关于GB/Z19027技术报告的目的描述,错误的是:(B)A、1)指导和帮助一个组织考虑和选择适合该组织需求的统计技术B、2)对一个组织进行认证审核的依据√C、3)组织应用统计技术的线路图D、4)认证审核人员学习掌握统计技术的基础正确的是:A、1)2)3)B、1)3)4)√C、2)3)4)D、1)2)4)3、GB/Z19027标准对与GB/T19001条款的实施可能有关的定量数据的需求做了识别,则在GB/T19001中的7.5.4顾客财产,有使用定量数据的需求,识别出潜在的统计需求是(A)A、描述统计、抽样√B、描述统计、SPC图C、描述统计、测量分析D、描述统计、过程能力分析4、GB/Z19027标准对与GB/T19001条款的实施可能有关的定量数据的需求做了识别,则在GB/T19001中的8.3不合格品控制“确定已交付的不合格品范围的需求”有使用定量数据的需求,识别出潜在的统计需求是(B)A、描述统计、过程能力分析B、描述统计、抽样√C、描述统计、SPCD、描述统计、试验设计、假设检验、测量分析、过程能力分析等5、以下关于GB/Z19027标准的描述,正确的是(C)A、GB/Z19027标准对与GB/T19001条款的实施都识别了可以使用统计技术B、针对已识别的定性数据的需求所列出的一个或多个统计技术适当应用于这些数据时,将使组织获得潜在利益。
C、如果定性数据能转换为定量数据,则统计技术可用于这些数据D、当GB/T19001的条款对定性数据无明显需求时,则未识别出统计技术。
计量经济学 —理论方法EVIEWS应用--第七章 序列相关性

在其他假设仍然成立的条件下,随机干扰项序列相关意味着
(7-2)
如果仅存在
E ( ) 0 , i 1 , 2 , . . . , n i i 1
(7-3)
则称为一阶序列相关或自相关(简写为AR(1)),这是常见的一种序列相关问题。
D .W .
不存在一阶自相关,构造如下统计量: t
t
( eˆ
t2
n
ˆt 1 ) 2 e
2 t
eˆ
t 1
n
杜宾—沃森证明该统计量的分布与出现在给定样本中的X值有复杂的关系,
其准确的抽样或概率分布很难得到;
因为D.W.值要从
eˆ t 中算出,而 eˆ t
又依赖于给定的X的值。
2 χ 因此D-W检验不同于t、F或 检验,它没有唯一的临界值可以导出拒绝或
用OLS法估计序列相关的模型得到的随机误差项的方差不仅是 有偏的,而且这一偏误也将传递到用OLS方法得到的参数估计 量的方差中来,从而使得建立在OLS参数估计量方差基础上的 变量显著性检验失去意义。
以一元回归模型为例,
Y X i 0 1 i i
2
ˆ) Var ( 1 2 xt
序列相关性及其产生原因序列相关性的影响序列相关性的检验序列相关的补救第一节序列相关性及其产生原因序列相关性的含义对于多元线性回归模型71在其他假设仍然成立的条件下随机干扰项序列相关意味着如果仅存在则称为一阶序列相关或自相关简写为ar1这是常见的一种序列相关问题
—理论· 方法· EViews应用
郭存芝 杜延军 李春吉 编著
二、回归检验法
, eˆ, 以 e ˆ t 为解释变量,以各种可能的相关变量,诸如 t1
MiniTab最经典最全面的操作教程

3.点击某个变量,用鼠标拖画数个变量,或者按住Ctrl键点击不连续变量。
4.点击 Select 按钮。
用键盘选择一个变量
1.按 Tab 键进入需要填写变量的文本框。 2.按 F2 键,使得变量列表框被激活。 3.使用上下箭头键,选择变量。
4. 再按 F2 键,将所选择的变量便出现在刚才被激活的文本框中了。
1. 2. 3. 4. 5. 6. 打开 File Open Worksheet Data ACID.MTW。 选择菜单:Data Display Data, 在 Columns, constants, and matrices to display 框中选入 Acid1 点击 OK 。 选择 Window Session 便能看见会话窗口中的如下内容:
在数据窗口中对数据列进行操作,排序、分组和生 成 方程式。 从基本的统计到质量管理,运用 一系列的分析 方式。 生成、修改图形,同时打印并且用各种格式保存 图形。 查看输出文本,并且改变输出文本格式,打印 和用各种格式保存。
操作和计算数据
运用数据分析 和质量工具 图形数据
管理会话窗, 生成报告
4
打开、保存、关闭PROJECT文件
7
第二章 数据管理(Managing Data)
6s
2-1 2-2 2-3
数据管理概要 在数据窗口中输入数据 生成规则数据
8
数据管理概要
6s
1. 数据保存在工作表中
在 MINITAB 里,与特定的数据集有关的所有数据都包含在工作表中 。一个 project 文件允许有许多工作表(工作表的个数取决于计算机的内存大小)。 一个工作表可以包含三种数据类型-----数值型(numeric)、文本型(text)和 日期/时间(date/time)型,表现形式为:数据列(columns)、常量(constant)、 矩阵(matrices) 。可以在多个窗口中察看数据,但大多时候都是在数据窗口中处理
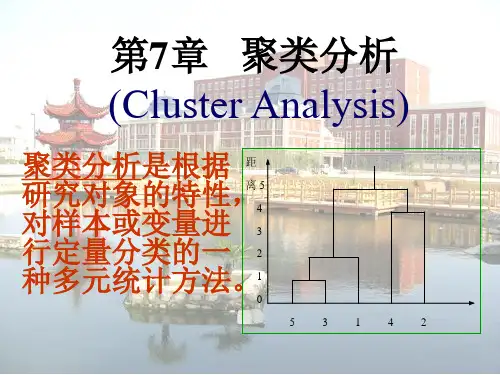
第7章 聚类分析
q=2时,欧氏(Euclidean )距离
m
dij
(xik x jk )2
k 1
闵氏距离适 用于一般p 维欧氏空间。 缺点是没有 考虑变量之 间的相关性。
二维空间欧式距离
马氏(Mahalanobis)距离
dij2 (M ) (xi x j )T s1(xi x j )
s=(sij)
sij
行分类
R型聚类
根据n个样品对p个指标进行分类 根据不同地区的样本数据对多个经济指标进行分类
两者没有本质区别,实践中人们更感兴趣的通常是Q型聚类
聚类分析的基本步骤
(1) 选择描述事物对象的变量(指标)。 (2) 建立样品数据资料矩阵。 (3) 确定数据是否要标准化。 (4) 确定表示对象距离或相似程度的统计
有两种处理方法:
(1)首先进行变量聚类,从每类中选一代 表性变量,再进行样品聚类;
(2)进行主成分分析或因子分析,降维, 使之成为不相关的新变量,再进行样品聚类。
(2 )标准化问题 指标选用的度量单 位将直接影响聚类分析的结果。例如将 高度的单位由米改为英寸,或者将重量 单位由千克改为磅,可能产生非常不同 的聚类结构。一般来说,所用度量单位 越小,变量的值域就越大,对聚类结果 的影响也越大。为了避免对变量单位选 择的依赖,数据应当标准化。数据量纲 不同时,必须进行标准化;但如果量纲 相同,可数量级相差很大,这时也应该 进行标准化。
——一旦个案(变量)被聚为一类,以后分类结果不会 改变
分层聚类
(一)思路
以分解的方式聚类
首先,所有个体都属于一类 其次,将大类中最“疏远”的小类或个体分离出去 然后,分别将小类中最“疏远”的小类或个体再分离出
去
重复上述过程,即:把类分解成越来越小的小类,直到 所有的个体自成一类为止
经济计量学
学的发展 。
14
第一章
经典经济计量学和非经典经济计量学
经典经济计量学(Classical Econometrics)一般指20世 纪70年代以前发展并广泛应用的经济计量学。
贝尔经济学奖得主挪威经济学家R.Frisch(佛里希 给定X和Z值,预测Y值
城市劳动力参与率除受城市失业率的影响之外,还受真实的小时平均工资等因素的影响。
)在1926年模仿“Biometrics”(生物计量学)提 Y = B1+ B2X
(2)利用次级资料数据(统计数据) 假设用失业率(UNR)来度量经济形势,用劳动力参与率(LFPR)来度量劳动力的参与,两数据由政府按时公布,我们依据上面步骤
15
第一章
非经典经济计量学一般指20世纪70年代以来发展的 经济计量学理论、方法及应用模型,也称为现代 经济计量学。
非经典经济计量学主要包括:微观经济计量学、非 参数经济计量学、时间序列经济计量学和动态经 济计量学等。
16
第一章
简·丁伯根——经济 计量学模式建造者 之父
拉格纳·弗里希 (RAGNAR FRISCH) 经济计量学的奠基人
AHE82(美元)
7.78 7.69 7.68 7.79 7.80 7.77 7.81 7.73 7.69 7.64 7.52 7.45 7.41 7.39 7.40 7.40 7.43 7.55 7.75 7.86 7.89 7.99 8.14
28
第一章 表1-1(新) 1980~2007年间城市劳动力参与率(CLFPR)、城市 失业率(CUNR)与真实的小时平均工资(AHE82)资料
自-统计学原理自学指导书
兰州资源环境职业技术学院成人教育部《统计学原理课程》自学指导书第一章总论一、本章主要掌握的内容统计学的研究对象;统计工作过程和统计研究方法;统计学中的几个基本概念及相互关系。
二、本章重点和难点统计学的几个基本概念三、本章学习中应注意的问题1.统计学的研究对象:明确统计学是一门方法论学科,就是研究社会经济统计方法的学科。
掌握社会经济统计的特点。
2.统计的工作过程:统计设计是计划和安排;统计调查是获取资料;统计整理是对资料进行分组汇总,为统计分析做准备,并进行简单的分析;统计分析是得出结论的过程,也就是对事物的数量特征的认识过程。
3.大量观察法用于统计调查过程;统计分组法用于统计整理阶段;综合指标法用于统计分析过程;统计推断法是在抽样调查后用来得到综合指标的方法。
4.统计总体和总体单位是统计学中最基本的一组概念,是理解其它基本概念的基础,也是认识统计工作过程的基础。
5.标志是与总体单位相联系的概念。
对于标志,难点在于区别标志与标志的表现。
区别数量标志和品质标志。
6.指标是统计工作的核心,它贯穿于统计工作全过程,包括统计设计、统计调查、统计整理和统计分析。
7.注意区别数量指标和质量指标。
一个简易的区别二者的方法是根据单位来区别,一般而言数量指标是有单位的,它的单位一般是单一单位,如米、千克、立方米等,个别情况下有复合单位,但复合单位间是相乘的关系,如反映运输工具工作量的单位吨公里(1吨公里表示某一运输工具运送1吨货物运行了1公里)等。
质量指标一般是复合单位或无单位,但复合单位间是相除的关系,如:表示价格的元/千克等。
倍、番等单位的指标也属于质量指标(其实质是无单位)。
四、本章作业1.试述统计总体的特点。
2.统计研究的基本方法包括哪些?3.什么是标志与指标?它们之间有什么区别与联系。
4.假设某市2005年商业企业有关统计资料见表1-1表1-1 某市2005年商业企业统计表要求:(1)试指出上表中的总体、总体单位、指标、数量指标、质量指标。
模式识别与数据挖掘期末总结
模式识别与数据挖掘期末总结第一章概述1.数据分析是指采用适当的统计分析方法对收集到的数据进行分析、概括和总结,对数据进行恰当地描述,提取出有用的信息的过程。
2.数据挖掘(Data Mining,DM) 是指从海量的数据中通过相关的算法来发现隐藏在数据中的规律和知识的过程。
3.数据挖掘技术的基本任务主要体现在:分类与回归、聚类、关联规则发现、时序模式、异常检测4.数据挖掘的方法:数据泛化、关联与相关分析、分类与回归、聚类分析、异常检测、离群点分析、5.数据挖掘流程:(1)明确问题:数据挖掘的首要工作是研究发现何种知识。
(2)数据准备(数据收集和数据预处理):数据选取、确定操作对象,即目标数据,一般是从原始数据库中抽取的组数据;数据预处理一般包括:消除噪声、推导计算缺值数据、消除重复记录、完成数据类型转换。
(3)数据挖掘:确定数据挖掘的任务,例如:分类、聚类、关联规则发现或序列模式发现等。
确定了挖掘任务后,就要决定使用什么样的算法。
(4)结果解释和评估:对于数据挖掘出来的模式,要进行评估,删除冗余或无关的模式。
如果模式不满足要求,需要重复先前的过程。
6.分类(Classification)是构造一个分类函数(分类模型),把具有某些特征的数据项映射到某个给定的类别上。
7.分类过程由两步构成:模型创建和模型使用。
8.分类典型方法:决策树,朴素贝叶斯分类,支持向量机,神经网络,规则分类器,基于模式的分类,逻辑回归9.聚类就是将数据划分或分割成相交或者不相交的群组的过程,通过确定数据之间在预先指定的属性上的相似性就可以完成聚类任务。
划分的原则是保持最大的组内相似性和最小的组间相似性10.机器学习主要包括监督学习、无监督学习、半监督学习等1.(1)标称属性(nominal attribute):类别,状态或事物的名字(2):布尔属性(3)序数属性(ordinal attribute):尺寸={小,中,大},军衔,职称【前面三种都是定性的】(4)数值属性(numeric attribute): 定量度量,用整数或实数值表示●区间标度(interval-scaled)属性:温度●比率标度(ratio-scaled)属性:度量重量、高度、速度和货币量●离散属性●连续属性2.数据的基本统计描述三个主要方面:中心趋势度量、数据分散度量、基本统计图●中心趋势度量:均值、加权算数平均数、中位数、众数、中列数(最大和最小值的平均值)●数据分散度量:极差(最大值与最小值之间的差距)、分位数(小于x的数据值最多为k/q,而大于x的数据值最多为(q-k)/q)、说明(特征化,区分,关联,分类,聚类,趋势/跑偏,异常值分析等)、四分位数、五数概括、离群点、盒图、方差、标准差●基本统计图:五数概括、箱图、直方图、饼图、散点图3.数据的相似性与相异性相异性:●标称属性:d(i,j)=1−m【p为涉及属性个数,m:若两个对象匹配为1否则p为0】●二元属性:d(i,j)=p+nm+n+p+q●数值属性:欧几里得距离:曼哈顿距离:闵可夫斯基距离:切比雪夫距离:●序数属性:【r是排名的值,M是排序的最大值】●余弦相似性:第三章数据预处理1.噪声数据:数据中存在着错误或异常(偏离期望值),如:血压和身高为0就是明显的错误。
计量知识要点
第一章计量经济学的任务是以经济学、统计学、数学之间的统一为工具,分析经济中的数量关系。
时序数据:同一统计指标按时间顺序记录的数据列,同一数列中的各个数据必须是同口径的,要求具有可比性。
时序数据可以是时期数,也可以是时点数。
横截面数据:同一时间,不同统计单位的相同统计指标组成的数据列。
要求统计的时间相同,但不要求统计对象及范围相同。
也要求数据的统计口紧和计算方法具有可比性。
内生变量:内生变量是具有一定概率分布的随机变量,它的数值是由模型本身决定的。
外生变量:是指非随机变量,它的取值是在模型之外决定的,是求解模型时的已知数。
解释变量:列于模型方程右边的作为影响因素的变量,即自变量。
被解释变量:是指列于模型中方程的左边作为分析对象的变量,即因变量。
滞后变量:是指内生变量和外生变量的时间滞后量(前期量)。
控制变量:是模型中决策者可以控制的变量。
政策变量:是模型中由政府操纵且反映政府政策的变量。
内生参数:是指依据样本观察值,运用统计方法估计得到的参数。
外生参数:一般是依据经济法规人为设定的参数,入资产折旧率、税率、利息率。
经济计量模型:是对现实经济系统的数学抽象,用于经济预测、结构分析、政策评价。
原则:以理论为先导,大小要适度。
行为方程:随机方程式根据经济行为建立的经济函数关系,又被称为“行为方程”。
总体设计是指选择模型中各系统模块以及各模块之间衔接关系的设计。
个体设计是变量的选择及变量间关系的描述。
模型建立步骤:设定模型,估计参数,检验模型,使用模型第二章函数关系:如果给定解释变量X的值,被杰斯变量(或称因变量)Y的值就唯一地确定了,Y与X的关系就是函数关系,即Y=f(X)。
相关关系:如果给定了解释变量X的值,被解释变量Y的值不是唯一的,Y与X的关系就是相关关系。
总体回归模型:是根据总体的全部资料建立的回归模型。
样本回归模型:是指根据样本资料建立的回归模型。
回归分析研:究被解释变量对于一个或多个解释变量的依存关系。