
STATA初级视频教程说明书(连玉君)
STATA初级视频教程(2010版)使用说明连玉君(中山大学 岭南学院 金融系)arlionn@目 录1 课程简介 (1)2 课程特色 (2)3 课程配套资料 (2)4 配套资料的使用方法 (2)5 讨论和建议 (4)6 讲师介绍 (4)7 报名咨询 (4)8 培训优惠 (4)附录A:STATA初级视频目录(时间节点) (5)第一讲STATA简介 (5)第二讲数据处理 (9)第三讲Stata绘图 (13)第四讲矩阵操作 (16)第五讲STATA 编程初步 (18)附录B:STATA高级视频教程简介 (20)工欲善其事,必先利其器。
无论是经济学、管理学还是社会科学的其他学科,定量分析都变得越来越重要了。
作为一个较为年轻的计量软件,STATA自1985年问世以来,以其在数据处理、绘图、回归分析等方面的出色表现,赢得了越来越多的青睐。
然而,相比于SPSS、Eviews等以菜单操作为主的软件,以命令操作见长的STATA软件门槛相对较高。
由于进入国内的时间较短,相关的参考资料甚为有限,而STATA公司提供的近10000页的全英文使用手册更是令多数初学者望而生畏。
这也成为阻碍多数国内同仁学习这款功能强大的计量软件的主要障碍。
鉴于上述情况,我们分别于2007年11月和2008年10月推出了“STATA初级视频教程”和“STATA高级视频教程”,内容涉及STATA的基本操作、数据处理、绘图、编程、常用计量模型的估计,以及Bootstrap和Monte Carlo模拟等内容。
视频教学的直观性,加之课程的实用性导向,使这两套教程获得了广泛的好评。
承蒙广大STATA视频教程学员的积极参与和反馈,我在过去两年多的时间里收集到了100余条修改建议,历经半年多的制作,最终得以为大家呈现这套新版STATA初级视频——“STATA初级视频教程(2010版)”。
STATA初级视频教程(2010版)共5讲,包含36个视频文件,总计40余个学时。
内容涉及:STATA入门、数据处理、绘图、矩阵以及编程。
内容简介如下(详细目录见附录A):第1讲从整体上介绍了STATA的基本架构,以便使学员在最短的时间内掌握STATA的精髓,包括:数据的导入导出、执行命令、修改和查验资料、log文件和do文件的使用、STATA与Word(Excel、LaTeX)等软件的完美结合,以及STATA常用设定等内容。
第2讲通过大量的实例,介绍了各种数据处理技巧,是本课程最为核心、最有特色的内容。
主要包括:复杂变量的创建;分位数;重复样本值、缺漏值和离群值的处理;资料的合并、追加和重新组合;文字变量、类别变量的处理;时间序列和面板资料的处理;以及数据的查验和对比等内容。
这些内容的学习将大幅提高学员的数据处理能力。
第3讲介绍STATA绘图。
为了达到举一反三的效果,我先从整体上介绍STATA绘图的基本知识,进而将绘图命令拆解成8类选项和5类元素,并最终通过40余个实例全面介绍了15类常用图形的绘制方法。
第4讲介绍STATA矩阵操作,包括矩阵的定义和管理、矩阵运算、矩阵解析等四个主题,为后续学习STATA编程知识奠定了扎实的基础。
第5讲介绍STATA编程的基本知识,包括:程序的定义和调用、单值、暂时性物件(暂元、暂时性变量、暂时性文件、暂时性矩阵等)、循环语句、条件语句,以及STATA返回值的引用等内容。
通过本讲的学习,学员将能够通过独立编写STATA程序来提高数据处理和模型估计的效率,为后续学习STATA高级程序奠定基础。
以上各讲都以专题的形式进行讲解,其中不但包含了STATA官方提供的常用命令,还包含了大量外部命令(520多个),为学员提供了强有力的实证分析工具。
STATA初级视频教程非常注重培养学员的实证分析能力。
我们一方面在尽可能呈现STATA全貌的同时做到重点突出、结构清晰,另一方面则强调实际问题的解决能力。
例如,传统教科书中很少会涉及数据的合并、离群值的处理、面板资料的筛选等问题,而这些往往又是实证分析过程中至关重要的环节。
又如,在整理回归结果的过程中,多数学员主要通过“复制-粘贴”的方式,效率甚低。
通过本课程的学习,这些问题都能得到很好的解决。
本课程的主要特色包括:(1) 视频教学,不受时间地点的限制,随时可以开始学习。
(2) 以专题的方式讲解,并辅以大量的实例,有助于学员快速掌握STATA数据处理、编程、绘图等方面的基本技巧,举一反三。
(3) 翔实的课程配套资料。
本课程除提供视频教程外,还同时提供了大量的范例数据和外部命令、PDF版do文档,以及具有“时间节点”的视频目录,便于学员课后练习和快速查找自己感兴趣的内容。
详见“3 课程配套资料”和“4 配套资料的使用方法”。
(4) 提供多种答疑和交流方式。
详见“5 讨论和建议”。
3 课程配套资料(1) 本课程中使用的 do 文档和 ado 文档,便于学员在观看视频的同时进行操作练习。
(2) 视频中所用到的所有do文档的PDF打印版(Stata_A_dofiles),附详细书签,便于快速查阅和定位。
可以利用adobe 的PDF文件搜索功能查找某个stata命令,以便了解该命令在不同情形下的使用方法。
(3) STATA11电子手册全套(能与STATA帮助文件完美链接)、STATA Journal全套(2001-2009)、STATA Technical Bulletin(STB)全套(Vol.1-Vol.61,1991-2001)。
这些资料统一存放于STATA_资料文件夹中。
(4) 100余个范例数据,包括:STATA官方范例数据包、中国宏观经济、中国上市公司范例数据等。
(5) 520多个STATA 外部命令。
4 配套资料的使用方法Q1.如何放置STATA11软件和相关资料?A:请将课程附赠的stata11.rar 文件解压后放置于 D 盘根目录下(注意:是D:\stata11,而不是D:\stata11\stata11,另外,也请注意文件名称的大小写)。
双击图标即可打开stata软件(无需安装)。
Q2.如何打开视频教程中使用的do文档?A:视频中使用的所有do文档统一存放于D:\stata11\ado\personal\Net_course_A文件夹下。
若希望练习第一讲中的相关操作,可依次执行如下命令:Step1:在STATA命令窗口中输入cd D:\stata11\ado\personal\Net_course_A命令,定义当前工作路径(会显示在STATA屏幕左下角);Step2:输入doedit A1_intro命令,即可打开第一讲的讲义A1_intro.do 文件。
当然,我们也可以通过点击菜单的方式完成上述操作,步骤如下:Step1:在STATA主菜单中点击“New do-file Editor”图标;Step2:在第一步中弹出的“Do-file Editor”窗口中点击“Open”图标,然后到D:\stata11\ado\personal\Net_course_A文件夹下,双击“A1_intro”文件即可打开之。
Q3.如何快速定位到自己希望观看的视频节点?A:你可以先浏览一下“附录A:STATA初级视频目录”,进而确定你希望观看的内容所在的视频文件,然后根据“时间节点目录”拖拽视频即可实现快速定位。
如果想了解特定命令(如esttab)的使用方法,只需在Stata_A_dofiles.pdf文档中执行全文搜索,由此便可确定该命令所在的视频文件,进而通过“时间节点目录”实现准确定位。
此外,我们已经为Stata_A_dofiles.pdf文档制作了详细的书签,便于大家浏览整个教程的结构安排。
Q4.如何修改STATA启动时的默认设定?A:在每次打开STATA时,它会自动执行D:\stata11安装目录下的profile.do文件,该文件设定了默认工作路径、STATA内存的大小、STATA结果窗口的最大显示行数,以及日志文件(log文件)的自动存储方式等内容。
你可以执行doedit D:\stata11\profile.do命令打开这个文件并修改其中的设定。
具体设定方法参见视频文件♠A1_intro_02_intro中第“1.2.2 首次使用STATA的一些基本设定”小节的介绍。
Q5.如何查看每次执行STATA的log文件?A:我在profile.do文件中进行了设定,每次启动STATA11后,屏幕上呈现的所有结果都会被自动记录到一个日志文件中(详见视频文件♠A1_intro_06_log中“1.8 log 文件: 记录你的分析过程”的介绍)。
这些日志文件被自动保存在D:\stata11\do文件夹下,文件名称为打开STATA时的时间,例如,名称为s22Apr2010111857.txt的日志文件是我在2010年4月22日11点18分57秒打开STATA11时自动生成的。
Q6.如何使用STATA官方提供的范例数据?A:多数情况下,教程中提供的资料已经足够大家练习所需了。
当然,为了满足个别学员的需求,本教程还进一步提供了STATA官方范例数据,统一存放于D:\stata11\ado\Example 文件夹中。
例如,你可以输入use "D:\stata11\ado\Examples\XTFiles\abdata.dta", clear 命令导入范例数据abdata.dta。
亦可点击STATA主界面中的按钮(快捷键为Ctrl+o),到上述目录下选择你想要练习的数据文件。
5 讨论和建议(1) 人大经济论坛STATA专版:/bbs/index.asp?boardid=67(2) 人大经济论坛“统计软件培训班VIP答疑区”。
所有STATA初级视频教程的学员都将自动升级为人大论坛VIP会员,在答疑区可以就视频教程中的疑难问题提问和讨论。
授课老师会在24小时内给出解答。
/bbs/forum-114-1.html。
(3) 连玉君的博客:/arlion,提供了大量STATA资源。
(4) E-mail: arlionn@。
在网络不畅或问题较为复杂的情况下,学员亦可通过E-mail与授课教师讨论问题。
6 讲师介绍连玉君,经济学博士,2007年7月毕业于西安交通大学金禾经济研究中心,现为中山大学岭南学院金融系讲师。
主讲课程为计量分析与STATA应用、实证金融、金融计量。
目前已在《Global Finance Journal》、《世界经济》、《统计研究》、《经济学动态》、《经济学(季刊)》、《财经研究》等期刊发表论文20余篇,出版专著一部(《中国上市公司投资效率研究》,经济管理出版社,2009年8月)。
目前主持教育部人文社科基金、高校基本业务费基金、广东自然科学基金项目各一项,并曾参与了多项国家自然科学基金、社会科学基金以及总理基金项目,具有丰富的数据处理、模型构建和模拟分析经验。
stata入门教程
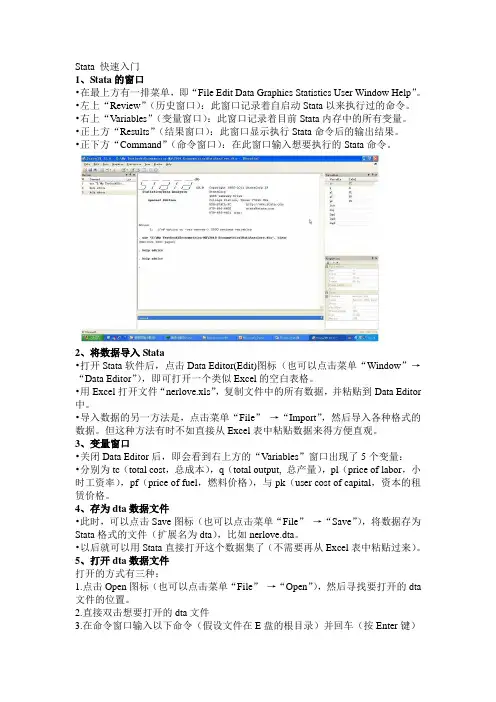
Stata 快速入门1、Stata的窗口•在最上方有一排菜单,即“File Edit Data Graphics Statistics User Window Help”。
•左上“Review”(历史窗口):此窗口记录着自启动Stata以来执行过的命令。
•右上“Variables”(变量窗口):此窗口记录着目前Stata内存中的所有变量。
•正上方“Results”(结果窗口):此窗口显示执行Stata命令后的输出结果。
•正下方“Command”(命令窗口):在此窗口输入想要执行的Stata命令。
2、将数据导入Stata•打开Stata软件后,点击Data Editor(Edit)图标(也可以点击菜单“Window”→“Data Editor”),即可打开一个类似Excel的空白表格。
•用Excel打开文件“nerlove.xls”,复制文件中的所有数据,并粘贴到Data Editor 中。
•导入数据的另一方法是,点击菜单“File”→“Import”,然后导入各种格式的数据。
但这种方法有时不如直接从Excel表中粘贴数据来得方便直观。
3、变量窗口•关闭Data Editor后,即会看到右上方的“Variables”窗口出现了5个变量:•分别为tc(total cost,总成本),q(total output, 总产量),pl(price of labor,小时工资率),pf(price of fuel,燃料价格),与pk(user cost of capital,资本的租赁价格。
4、存为dta数据文件•此时,可以点击Save图标(也可以点击菜单“File”→“Save”),将数据存为Stata格式的文件(扩展名为dta),比如nerlove.dta。
•以后就可以用Stata直接打开这个数据集了(不需要再从Excel表中粘贴过来)。
5、打开dta数据文件打开的方式有三种:1.点击Open图标(也可以点击菜单“File”→“Open”),然后寻找要打开的dta 文件的位置。
Stata命令大全 面板数据计量分析与软件实现
Stata命令大全面板数据计量分析与软件实现说明:以下do文件相当一部分内容来自于中山大学连玉君STATA教程,感谢他的贡献。
本人做了一定的修改与筛选。
*----------面板数据模型* 1.静态面板模型:FE 和RE* 2.模型选择:FE vs POLS, RE vs POLS, FE vs RE (pols混合最小二乘估计) * 3.异方差、序列相关和截面相关检验* 4.动态面板模型(DID-GMM,SYS-GMM)* 5.面板随机前沿模型* 6.面板协整分析(FMOLS,DOLS)*** 说明:1-5均用STATA软件实现, 6用GAUSS软件实现。
* 生产效率分析(尤其指TFP):数据包络分析(DEA)与随机前沿分析(SFA)*** 说明:DEA由DEAP2.1软件实现,SFA由Frontier4.1实现,尤其后者,侧重于比较C-D与Translog生产函数,一步法与两步法的区别。
常应用于地区经济差异、FDI 溢出效应(Spillovers Effect)、工业行业效率状况等。
* 空间计量分析:SLM模型与SEM模型*说明:STATA与Matlab结合使用。
常应用于空间溢出效应(R&D)、财政分权、地方政府公共行为等。
* ---------------------------------* --------一、常用的数据处理与作图-----------* ---------------------------------* 指定面板格式xtset id year (id为截面名称,year为时间名称)xtdes /*数据特征*/xtsum logy h /*数据统计特征*/sum logy h /*数据统计特征*/*添加标签或更改变量名label var h "人力资本"rename h hum*排序sort id year /*是以STATA面板数据格式出现*/sort year id /*是以DEA格式出现*/*删除个别年份或省份drop if year<1992drop if id==2 /*注意用==*/*如何得到连续year或id编号(当完成上述操作时,year或id就不连续,为形成panel 格式,需要用egen命令)egen year_new=group(year)xtset id year_new**保留变量或保留观测值keep inv /*删除变量*/**或keep if year==2000**排序sort id year /*是以STATA面板数据格式出现sort year id /*是以DEA格式出现**长数据和宽数据的转换*长>>>宽数据reshape wide logy,i(id) j(year)*宽>>>长数据reshape logy,i(id) j(year)**追加数据(用于面板数据和时间序列)xtset id year*或者xtdestsappend,add(5) /表示在每个省份再追加5年,用于面板数据/tsset*或者tsdes.tsappend,add(8) /表示追加8年,用于时间序列/*方差分解,比如三个变量Y,X,Z都是面板格式的数据,且满足Y=X+Z,求方差var(Y),协方差Cov(X,Y)和Cov(Z,Y)bysort year:corr Y X Z,cov**生产虚拟变量*生成年份虚拟变量tab year,gen(yr)*生成省份虚拟变量tab id,gen(dum)**生成滞后项和差分项xtset id yeargen ylag=l.y /*产生一阶滞后项),同样可产生二阶滞后项*/gen ylag2=L2.ygen dy=D.y /*产生差分项*/*求出各省2000年以前的open inv的平均增长率collapse (mean) open inv if year<2000,by(id)变量排序,当变量太多,按规律排列。
STATA 教学大纲
(2)内生性问题,包括处理效应模型和倾向得分匹配分析两类模型(第5讲),作为这一讲的基础,在第4讲中,将介绍Logit模型;
(3)随机边界分析相关的模型:传统的SFA模型、异质性SFA模型、面板SFA模型,以及双边SFA模型(第6讲);
序列相关检验和过度识别检验(Sargan检验)
面板VAR模型简介
冲击反应函数 (பைடு நூலகம்RF)、方差分解 (FEVD)
应用实例(介绍3篇论文)
第2讲(3小时)
自抽样和蒙特卡洛模拟
Bootstrap的原理和Stata实现
Bootstrap组间系数差异检验
Bootstrap获取复杂统计量的临界值
Monte Carlo的基本原理
多元Logit模型(Multinomial Logit)
应用实例(介绍3篇论文)
第5讲(3小时)
内生性问题
Heckman选择模型(Heckman Selection Model)
处理效应模型(Treatment Effect Model)
倾向得分匹配分析(Propensity Score Matching, PSM)
第6讲(3小时)
时间序列模拟分析
时间序列简介
ARIMA过程模拟分析
白噪声和随机游走过程模拟分析
伪回归问题模拟分析
GARCH模型模拟分析
第7讲(3小时)
面板数据模型
静态面板模型:固定效应和随机效应
基于Bootstrap的Hausman检验
异方差和序列相关(Bootstrap、Cluster调整标准误)
stata命令大全(全)
*********面板数据计量分析与软件实现*********之迟辟智美创作说明:以下do文件相当一部份内容来自于中山年夜学连玉君STATA教程,感谢他的贡献.自己做了一定的修改与筛选.*面板数据模型* 1.静态面板模型:FE 和RE* 2.模型选择:FE vs POLS, RE vs POLS, FE vs RE(pols混合最小二乘估计)* 3.异方差、序列相关和截面相关检验* 4.静态面板模型(DIDGMM,SYSGMM)* 6.面板协整分析(FMOLS,DOLS)*** 说明:15均用STATA软件实现, 6用GAUSS软件实现.* 生产效率分析(尤其指TFP):数据包络分析(DEA)与随机前沿分析(SFA)*** 说明:DEA由DEAP2.1软件实现,SFA由Frontier4.1实现,尤其后者,偏重于比力CD与Translog生产函数,一步法与两步法的区别.常应用于地域经济不同、FDI溢出效应(Spillovers Effect)、工业行业效率状况等.* 空间计量分析:SLM模型与SEM模型*说明:STATA与Matlab结合使用.常应用于空间溢出效应(R&D)、财政分权、处所政府公共行为等.** 一、经常使用的数据处置与作图** 指定面板格式xtset id year(id为截面名称,year为时间名称)xtdes /*数据特征*/xtsum logy h /*数据统计特征*/sum logy h /*数据统计特征*/*添加标签或更改变量名label var h "人力资本"rename h hum*排序sort id year /*是以STATA面板数据格式呈现*/sort year id /*是以DEA格式呈现*/*删除个别年份或省份drop if year<1992drop if id==2 /*注意用==*/*如何获得连续year或id编号(当完成上述把持时,year或id就不连续,为形成panel格式,需要用egen命令)egen year_new=group(year)xtset id year_new**保管变量或保管观测值keep inv /*删除变量*/**或keep if year==2000**排序sort id year /*是以STATA面板数据格式呈现sort year id /*是以DEA格式呈现**长数据和宽数据的转换*长>>>宽数据reshape wide logy,i(id) j(year)*宽>>>长数据reshape logy,i(id) j(year)**追加数据(用于面板数据和时间序列)xtset id year*或者xtdestsappend,add(5) /暗示在每个省份再追加5年,用于面板数据/ tsset*或者tsdes.tsappend,add(8) /暗示追加8年,用于时间序列/*方差分解,比如三个变量Y,X,Z都是面板格式的数据,且满足Y=X+Z,求方差var(Y),协方差Cov(X,Y)和Cov(Z,Y)bysort year:corr Y X Z,cov**生产虚拟变量*生成年份虚拟变量tab year,gen(yr)*生成省份虚拟变量tab id,gen(dum)**生成滞后项和差分项xtset id yeargen ylag=l.y /*发生一阶滞后项),同样可发生二阶滞后项*/gen dy=D.y /*发生差分项*/*求出各省2000年以前的open inv的平均增长率collapse (mean) open inv if year<2000,by(id)变量排序,当变量太多,按规律排列.可用命令aorder或者order fdi open insti** 二、静态面板模型** 简介* 面板数据的结构(兼具截面资料和时间序列资料的特征)use product.dta, clearbrowsextset id yearxtdes** 固定效应模型** 实质上就是在传统的线性回归模型中加入 N1 个虚拟变量,* 使得每个截面都有自己的截距项,* 截距项的分歧反映了个体的某些不随时间改变的特征** 例如: lny = a_i + b1*lnK + b2*lnL + e_it* 考虑中国29个省份的CD生产函数*******画图**散点图+线性拟合直线twoway (scatter logy h) (lfit logy h)*散点图+二次拟合曲线twoway (scatter logy h) (qfit logy h)*散点图+线性拟合直线+置信区间twoway (scatter logy h) (lfit logy h) (lfitci logy h)*按分歧个体画出散点图和拟合线,可以以做出fe vs re的初判断*twoway (scatter logy h if id<4) (lfit logy h if id<4) (lfit logy h if id==1) (lfit logy h if id==2) (lfit logy h if id==3)*按分歧个体画散点图,so beautiful!!!*graph twoway scatter logy h if id==1 || scatter logy h ifid==2,msymbol(Sh) || scatter logy h if id==3,msymbol(T) || scatter logy h if id==4,msymbol(d) || , legend(position(11) ring(0) label(1 "北京") label(2 "天津") label(3 "河北") label(4 "山西")) **每个省份logy与h的散点图,并将各个图形合并twoway scatter logy h,by(id) ylabel(,format(%3.0f))xlabel(,format(%3.0f))*每个个体的时间趋势图*xtline h if id<11,overlay legend(on)* 一个例子:中国29个省份的CD生产函数的估计tab id, gen(dum)list* 回归分析reg logy logk logl dum*,est store m_olsxtreg logy logk logl, feest store m_feest table m_ols m_fe, b(%6.3f) star(0.1 0.05 0.01)* Wald 检验test logk=logl=0test logk=logl* stata的估计方法解析* 目的:如果截面的个数非常多,那么采纳虚拟变量的方式运算量过年夜* 因此,要寻求合理的方式去除失落个体效应* 因为,我们关注的是 x 的系数,而非每个截面的截距项 * 处置方法:** y_it = u_i + x_it*b + e_it (1)* ym_i = u_i + xm_i*b + em_i (2) 组内平均* ym = um + xm*b + em (3) 样本平均* (1) (2), 可得:* (y_it ym_i) = (x_it xm_i)*b + (e_it em_i) (4) /*within estimator*/* (4)+(3), 可得:* (y_itym_i+ym) = um + (x_itxm_i+xm)*b + (e_item_i+em) * 可重新暗示为:* Y_it = a_0 + X_it*b + E_it* 对该模型执行 OLS 估计,即可获得 b 的无偏估计量**stata后台把持,揭开fe估计的神秘面纱!!!egen y_meanw = mean(logy), by(id) /*个体内部平均*/egen y_mean = mean(logy) /*样本平均*/egen k_meanw = mean(logk), by(id)egen k_mean = mean(logk)egen l_meanw = mean(logl), by(id)egen l_mean = mean(logl)gen dyw = logy y_meanwgen dkw = logk k_meanwgen dlw=logll_meanwreg dyw dkw dlw,noconsest store m_statagen dy = logy y_meanw + y_meangen dk = logk k_meanw +k_meangen dl=logll_meanw+l_meanreg dy dk dlest store m_stataest table m_*, b(%6.3f) star(0.1 0.05 0.01)* 解读 xtreg,fe 的估计结果xtreg logy h inv gov open,fe* R^2* y_it = a_0 + x_it*b_o + e_it (1) pooled OLS* y_it = u_i + x_it*b_w + e_it (2) within estimator* ym_i = a_0 + xm_i*b_b + em_i (3) between estimator** > Rsq: within 模型(2)对应的R2,是一个真正意义上的R2 * > Rsq: between corr{xm_i*b_w,ym_i}^2* > Rsq: overall corr{x_it*b_w,y_it}^2***** sigma_u, sigma_e, rho* rho = sigma_u^2 / (sigma_u^2 + sigma_e^2)dis e(sigma_u)^2 / (e(sigma_u)^2 + e(sigma_e)^2)** 个体效应是否显著?* F(28, 373) = 338.86 H0: a1 = a2 = a3 = a4 = a29* Prob > F = 0.0000 标明,固定效应高度显著*如何获得调整后的 R2,即 adjR2 ?ereturn listreg logy h inv gov open dum**拟合值和残差* y_it = u_i + x_it*b + e_it* predict newvar, [option]/*xb xb, fitted values; the defaultstdp calculate standard error of the fitted valuesue u_i + e_it, the combined residualxbu xb + u_i, prediction including effectu u_i, the fixed or randomerror componente e_it, the overall error component */xtreg logy logk logl, fepredict y_hatpredict a , upredict res,epredict cres, uegen ares = a + reslist ares cres in 1/10** 随机效应模型** y_it = x_it*b + (a_i + u_it)* = x_it*b + v_it* 基本思想:将随机干扰项分成两种* 一种是不随时间改变的,即个体效应 a_i* 另一种是随时间改变的,即通常意义上的干扰项 u_it * 估计方法:FGLS* Var(v_it) = sigma_a^2 + sigma_u^2* Cov(v_it,v_is) = sigma_a^2* Cov(v_it,v_js) = 0* 利用Pooled OLS,Within Estimator, Between Estimator* 可以估计出sigma_a^2和sigma_u^2,进而采纳GLS或FGLS* Re估计量是Fe估计量和Be估计量的加权平均* yr_it = y_it theta*ym_i* xr_it = x_it theta*xm_i* theta = 1 sigma_u / sqrt[(T*sigma_a^2 + sigma_u^2)]* 解读 xtreg,re 的估计结果use product.dta, clearxtreg logy logk logl, re* R2* > Rsq: within corr{(x_itxm_i)*b_r, y_itym_i}^2* > Rsq: between corr{xm_i*b_r,ym_i}^2* > Rsq: overall corr{x_it*b_r,y_it}^2* 上述R2都不是真正意义上的R2,因为Re模型采纳的是GLS估计.** rho = sigma_u^2 / (sigma_u^2 + sigma_e^2)dis e(sigma_u)^2 / (e(sigma_u)^2 + e(sigma_e)^2)** corr(u_i, X) = 0 (assumed)* 这是随机效应模型的一个最重要,也限制该模型应用的一个重要假设* 然而,采纳固定效应模型,我们可以粗略估计出corr(u_i, X) xtreg market invest stock, fe** 时间效应、模型的筛选和罕见问题*目录* 时间效应(双向固定(随机)效应模型)* 模型的筛选* 面板数据罕见问题* 面板数据的转换** 时间效应** 单向固定效应模型* y_it = u_i + x_it*b + e_it* 双向固定效应模型* y_it = u_i + f_t + x_it*b + e_itqui tab year, gen(yr)drop yr1xtreg logy logk logl yr*, fe* 随机效应模型中的时间效应xtreg logy logk logl yr*, fe** 模型的筛选** 固定效应模型还是Pooled OLS?xtreg logy logk logl yr*, fe /*Wald 检验*/ qui tab id, gen(dum) /*LR检验*/ reg logy logk logl /*POLS*/est store m_olsreg logy logk logl dum*,noconsest store m_felrtest m_ols m_feest table m_*, b(%6.3f) star(0.1 0.05 0.01) * RE vs Pooled OLS?* H0: Var(u) = 0* 方法一:BP 检验xtreg logy logk logl, rexttest0* FE vs RE?* y_it = u_i + x_it*b + e_it* Hausman 检验* 基本思想:如果 Corr(u_i,x_it) = 0, Fe 和 Re 都是一致的,但Re更有效* 如果 Corr(u_i,x_it)!= 0, Fe 仍然有效,但Re是有偏的* 基本步伐***情形1:huasman为正数xtreg logy logk logl, feest store m_fextreg logy logk logl, reest store m_rehausman m_fe m_re*** 情形2:qui xtreg logy h inv gov open,feest store fequi xtreg logy h inv gov open,reest store rehausman fe re* Hausman 检验值为负怎么办?* 通常是因为RE模型的基本假设 Corr(x,u_i)=0 无法获得满足* 检验过程中两个模型的方差协方差矩阵都采纳Fe模型的 hausman fe re, sigmaless* 两个模型的方差协方差矩阵都采纳Re模型的hausman fe re, sigmamore*== 为何有些变量会被drop失落?use nlswork.dta, cleartsset idcode yearxtreg ln_wage hours tenure ttl_exp, fe /*正常执行*/* 发生种族虚拟变量tab race, gen(dum_race)xtreg ln_wage hours tenure ttl_exp dum_race2 dum_race3, fe * 为何 dum_race2 和 dum_race3 会被 dropped ?* 固定效应模型的设定:y_it = u_i + x_it*b + e_it (1)* 由于个体效应 u_i 不随时间改变,* 因此若 x_it 包括了任何不随时间改变的变量,* 城市与 u_i 构成多重共线性,Stata会自动删除之.*******异方差、序列相关和截面相关问题* 简介* y_it = x_it*b + u_i + e_it** 由于面板数据同时兼顾了截面数据和时间序列的特征,* 所以异方差和序列相关肯定会存在于面板数据中;* 同时,由于面板数据中每个截面(公司、个人、国家、地域)之间还可能存在内在的联系,* 所以,截面相关性也是一个需要考虑的问题.** 此前的分析依赖三个假设条件:* (1) Var[e_it] = sigma^2 同方差假设* (2) Corr[e_it, e_its] = 0 序列无关假设* (3) Corr[e_it, e_jt] = 0 截面不相关假设** 当这三个假设无法获得满足时,便分别呈现异方差、序列相关和截面相关问题;* 我们一方面要采纳各种方法来检验这些假设是否获得了满足;* 另一方面,也要在这些假设无法满足时寻求合理的估计方法.* 假设检验*== 组间异方差检验(截面数据的特征)* Var(e_i) = sigma_i^2* Fe 模型xtreg logy logk logl, fexttest3* Re 模型* Re自己已经较年夜水平的考虑了异方差问题,主要体现在sigma_u^2上*== 序列相关检验* Fe 模型xtserial logy logk loglxtserial logy logk logl, output* Re 模型xtreg logy logk logl, rexttest1 /*提供多个统计检验量*/*== 截面相关检验* xttest2命令 H0: 所有截面残差的相关系数都相等xtreg logy logk logl, fexttest2* 由于检验过程中执行了SUE估计,所以要求T>Nxtreg logy logk logl if id<6, fexttest2* xtcsd 命令(提供了三种检验方法)xtreg logy logk logl, fextcsd , pesaran /*Pesaran()*/xtcsd , friedman /*Friedman(1937)*/xtreg logy logk logl, rextcsd , pesaran* 估计方法*== 异方差稳健型估计xtreg logy h inv gov open, fe robustest store fe_rbxtreg logy h inv gov open, fe robustest store fe* 结果比较esttab fe_rb fe, b(%6.3f) se(%6.3f) mtitle(fe_rb fe)*== 序列相关估计* 一阶自相关 xtregar, fe/re* 模型: y_it = u_i + x_it*b + v_it (1)* v_it = rho*v_it1 + z_it (2)xtregar logy h inv gov open, feest store fe_ar1xtregar logy h inv gov open,fe lbi /*BaltagiWu LBI test*/* 说明:* (1) 这里的DurbinWatson =1.280677 具有较为复杂的分布,* 分歧于时间序列中的DW统计量.* (2) 其临界值见Bhargava et al. (1982, The Review of Economic Studies 49:553549)* (3) BaltagiWu LBI = 1.4739834 基本上没有太年夜的参考价值,* 因为他们并未提供临界值表,而该统计量的分布又相当复杂xtregar logy h inv gov open, reest store re_ar1* 两阶段估计xtregar logy h inv gov open, fe twostepest store fe_ar1_two* 结果比较xtreg logy h inv gov open, feest store felocal models "fe fe_ar1 re_ar1 fe_ar1_two "esttab `models', b(%6.3f) se(%6.3f) mtitle(`models') r2sca(r2_w corr)* 高阶自相关* newey2 命令newey2 logy h inv gov open, lag(2)*== 组间相关(截面相关)* cluster 选项use xtcs.dta, clearxtreg logy h inv gov open, fe cluster(id)est store fe_clusterxtreg logy h inv gov open, re cluster(id)est store re_cluster************看过去很晕,采纳一种综合处置:* xtgls 命令* xtpcse 命令* 简介(Greene, 2000, chp15)** 模型* y = X*b + U* 重点在于考虑干扰项 U 的结构,包括* (1) 异方差 (2) 序列相关 (3) 截面相关性* 应用范围:多用于“年夜T,小N”型面板数据,* 因为,此时截面的异质性其实不是重点关注的,而时序特征则较为明显* 因此,模型设定中未考虑个体效果* | y_1 | | X_1 | | e_1 |* | y_2 | | X_2 | | e_2 |* | . | | . | | . |* | . | = | . | * b + | . |* | . | | . | | . |* | y_n | | X_n | | e_n |* 截面异方差* E[e_i*e_i'] = s_i^2** | s1^2 0 ... 0 |* | 0 s2^2 ... 0 |* | . |* V = | . |* | . |* | 0 0 ... sn^2 |* 截面相关* E[e_i*e_i'] = s_ij^2** | s_11 s_12 ... s_1n |* | s_21 s_22 ... s_2n |* | . |* V = | . | * sigma^2* | . |* | s_n1 s_n2 ... s_nn |* 序列相关* E[e_i*e_i'] = s_i^2 * M_i** | s1^2*M_1 0 ... 0 |* | 0 s2^2*M_2 ... 0 |* | . |* V = | . |* | . |* | 0 0 ... sn^2*M_n |* GLS 估计* b = [X'V^{1}*X]^{1}[X'V^{1}y]* Var[b] = [X'V^{1}*X]^{1}* 估计和检验*=== xtgls 命令use invest2.dta, clearxtgls market invest stock, panels(iid) /*iid, 同即是Pooled OLS*/est store g_0reg market invest stockest store g_olsxtgls market invest stock, panel(het) /*截面异方差*/est store g_phetxtgls market invest stock, corr(ar1) /*所有截面具有相同的自相关系数*/est store g_par1xtgls market invest stock, corr(psar1) /*每个截面有自己的自相关系数*/est store g_psar1xtgls market invest stock, panel(corr) /*截面间相关且异方差*/est store g_pcorrxtgls market invest stock, p(c) corr(ar1)est store g_all* 检验异方差xtgls market invest stock, panel(het) /*截面异方差*/xttest3* 检验序列相关xtserial market invest stock* 检验截面相关xtgls market invest stock, panel(het)xttest2* 结果比较xtreg market invest stock, feest store felocal models "fe g_0 g_ols"esttab `models', b(%6.3f) se(%6.3f) mtitle(`models') r2sca(r2_w)local models "fe g_phet g_par1 g_psar1 g_pcorr g_all"esttab `models', b(%6.3f) se(%6.3f) mtitle(`models') r2sca(r2_w) compress* 说明:* 为何 xtgls 不汇报 R2 ?* 因为此时的R2未必介于0和1之间,不具有传统线性回归模型中R2的含义*=== xtpcse 命令* 默认假设:存在截面异方差和截面相关* 估计方法:OLS 或 PraisWinsten 回归* 有别于xtgls(采纳FGLS估计)* 更适于方块面板 N不年夜(1020),T不年夜(1040)* 与 xtgls 的区别:估计方法分歧* xtgls 采纳GLS进行估计,而xtpsce采纳OLS.use invest2.dta, clearxtpcse invest market stockest store pcse_full /*OLS估计,调整异方差和截面相关后的标准误*/xtgls invest market stock, panels(correlated)est store m_xtgls /*FGLS估计,异方差和截面相关*/ xtpcse invest market stock, correlation(ar1)est store pcse_ar1 /*Prais_Winsten估计,共同的自相关系数*/xtpcse invest market stock, correlation(ar1) hetonlyest store pcse_ar1 /*不考虑截面相关*/* 结果比较xtreg invest market stock, feest store felocal models "fe pcse_full m_xtgls pcse_ar1 pcse_ar1"esttab `models', b(%6.3f) se(%6.3f) mtitle(`models') r2sca(r2_w)* xtpcse 的结果与 xtgls 非常相似,但前者可以汇报R2* 当N较年夜时,采纳该方法会非常费时,* 因为方差协方差矩阵是采纳OLS估计的残差计算的use xtcs.dta, clearxtdesxtpcse tl size ndts tang tobin npr /*年夜约58分钟*/est store xtpcsextreg tl size ndts tang tobin npr, feest store fe* 结果比较local models "fe xtpcse"esttab `models', b(%6.3f) se(%6.3f) mtitle(`models') r2sca(r2_w)* 系数估计值有较年夜分歧,但符号和显著性是一致的.***静态面板模型 Part I** 静态面板模型** 简介* 一阶差分IV估计量(Anderson and Hisao, 1982)* 一阶差分GMM估计量(Arellano and Bond, 1991)* 系统GMM估计量(AB,1995; BB,1998)* == 简介 ==** 模型: y[it] = a0*y[it1] + a1*x[it] + a2*w[it] + u_i + e[it]** 特征:解释变量中包括了被解释变量的一阶滞后项* 可以是非平行面板,但要保证时间连续* x[it] ——严格外生变量 E[x_it,e_is] =0 for all t and s* 即,所有干扰项与x都不相关* w[it] ——先决变量 E[w_it,e_is]!=0 for s<t, butE[x_it,v_is]=0 for all s>=t* 即,前期干扰项与当期x相关,但当期和未来期干扰项与x不相关.* y[it1]——内生变量 E[x_it,e_is]!=0 for s<=t* 即,前期和当期,尤其是当期干扰项与x相关* u_i 随机效应,在截面间是 iid 的.u_i 与 e[it] 自力.** 内生性问题:* (1) 若假设 u_i 为随机效应,则 Corr(y[i,t1], u_i) !=0* (2) 若假设 u_i 为个体效应,需要想法子去除之,因为数据为"年夜N小T"* 一阶差分: D.y[i,t1] = y[i,t1] y[i,t2]* D.e[i,t] = e[i,t] e[i,t1]* 显然: Corr(D.y[i,t1], D.e[i,t]) !=0, 差分方程存在内生问题;* 组内去心: ym[i,t1] = y[i,t1] 1/(T1)*(y[i,t1]+...+y[i,T])* em[i,t] = e[i,t] 1/T*(e[i,t]+e[i,t1]+...+e[i,T])* 显然: Corr(ym[i,t1], em[i,t]) !=0, 仍然存在内生性问题** 处置法子:IV估计或GMM估计,选择合适的工具变量** 矩条件: E[e_it,z_it] = 0*========================================*========= 一阶差分 IV 估计量 ============*========Anderson and Hisao(1982)========*========================================** 基本思想:采纳一阶差分去除个体效应 u_i,* y 的滞后二阶作为 D.y[it1] 的工具变量* 同时,D.y[it2] 也可以作为 D.y[it1] 的工具变量use abdata.dta, cleardes /*变量的界说*/tsset id year* 模型: n_it = b1*n_it1 + b2*n_it2* + b3*w_it + b4*w_it1* + b5*k_it + b6*k_it1 + b7*k_it2* + b8*ys_it + b9*ys_it1 + b10*ys_it2*xtivreg n L2.n w L1.w k L1.k L2.k ys L1.ys L2.ysyr1981yr1984 ///(L.n = L3.n), fd** 等价于*xtivreg n L2.n L(0/1).w L(0/2).(k ys) yr1981yr1984 (L.n = L3.n), fd*====================================*========= 一阶差分GMM估计量 =========*==============AB91==================** L.Hansen (1982) 提出 GMM** Arellano and Bond (1991)** 模型:** y[it] = a0*y[it1] + a1*x[it] + a2*w[it] + u_i + v[it]** 假设条件:* 干扰项 v[it] 不存在序列相关;** 适用范围:* 年夜N,小T* 随后,我们会介绍“小N年夜T”型静态面板的估计方法** 基本思想:** 在 Anderson and Hisao(1982) 基础上增加了更多可用的工具变量** 在 t=3 处,y_i1 可以作为所有滞后项的工具变量* 在 t=4 处, y_i1, y_i2 可以作为所有滞后项的工具变量** D.y[it] = a1*D.y[it1] + a2*D.X[it] + D.v[it] X_it = [x_it, w_it] ** 因此,所有工具变量构成的矩阵如下:** |y_i1 0 0 0 0 0 ... 0 ... 0 D.x_i3 |* | 0 y_i1 y_i2 0 0 0 ... 0 ... 0 D.x_i4 |* | 0 0 0 y_i1 y_i2 y_i3 ... 0 ... 0 D.x_i5 |* Z_i = | . . . . . . . . . . . |* | . . . . . . . . . . . |* | 0 0 0 0 0 0 ... y_i1 ... yiT2 D.x_iT |** Z_i 的行数为 T2* Z_i 的列数为 sum_(m=1)^(T2){m} + K, K 为 X 的列数** 以 T =7,K=3 为例,则 Z_i 的列数为 (1+2+3+4+5)+3 = 18 ** 设定工具变量的基来源根基则:** 对内生变量的处置:与上述方法类似,* 即滞后两阶以上的水平变量均可作为差分方程的工具变量 (GMM type)* 对先决变量的处置:滞后一阶以上的水平变量均可作为工具变量 (GMM type)* 对外生变量的处置:自己作为自己的工具变量 (Standard IV) *== 例1:一阶差分估计量的基本设定* 解释变量仅包括 y_it 的一阶滞后项,默认设定* 干扰项同方差,一阶段估计use abdata.dta, clearxtabond n L(0/1).w L(0/2).(k ys) yr1980yr1984est store ab_0* 结果释疑** 1 工具变量的个数是如何确定的?(xtdpd, p.74)** 外生变量的工具变量即是外生变量的个数* L(0/1).w L(0/2).(k ys) yr1980yr1984 共 13个* 内生变量的工具变量:共 27个*list id year n L2.n DL2.n if id == 140** 差分方程的可用工具变量** year of Years of Number of* difference equation instruments instruments* 1978 1976 1* 1979 19761977 2* 1980 19761978 3* 1981 19761979 4* 1982 19761980 5* 1983 19761981 6* 1984 19761982 7** 28个* 2 GMMtype 和 Standard 两种类型的工具变量有何不同?(xtabond,p.27)** GMMtype 是针对内生变量或先决变量而言的工具变量,有多列* Standard 是针对外生变量而言的工具变量,只有一列* 过度识别检验(工具变量的使用是否合理)*estat sargan** 说明:* H0: overidentifying restrictions are valid* 这里,我们拒绝了原假设,但AB91指出,当干扰项存在异方差时,* Sargan检验倾向于过度拒绝原假设,因此此处获得的结论其实不成信.* 采纳两阶段估计,然后再执行Sargan检验较为稳妥:*xtabond n L(0/1).w L(0/2).(k ys) yr1980yr1984,twostepestat sargan** 说明:不外,AB91发现,* 若存在异方差,在两阶段估计后执行Sargan检验往往倾向于* Underreject问题,即过度接受原假设.* 通常而言,这很可能是我们的模型设定不妥,或是工具变量的选择分歧理.* 干扰项序列相关检验** AB91 一阶差分估计量要求原始模型的干扰项不存在序列相关,* 显然,差分后的干扰项肯定存在一阶序列相关,* 因此,我们需要检验差分方程的残差是否存在二阶(或更高阶)序列相关即可** 默认,二阶序列相关检验xtabond n L(0/1).w L(0/2).(k ys) yr1980yr1984,vce(robust)estat abond* 说明:若存在二阶相关,则意味着选取的工具变量分歧理* 高阶序列相关检验xtabond n L(0/1).w L(0/2).(k ys) yr1980yr1984,vce(robust) artest(3)estat abond*== 稳健型估计xtabond n L(0/1).w L(0/2).(k ys) yr1980yr1984, lags(2) robust est store ab4_one_rb* 此时,无法 Sargan 统计量estat sargan*== 两阶段估计 AB91(Tab4(a2)) 考虑异方差问题* 利用第一阶段估计获得的残差构造方差协方差矩阵,进而重新估计模型*xtabond n L(0/1).w L(0/2).(k ys) yr1980yr1984, lags(2) twostep est store ab4_twostep* 此时,Sargan 检验无法拒绝原假设*estat sargan* AB91重要建议:* (1) 采纳一阶段估计结果进行系数显著性的统计推断;* (2) 采纳两阶段估计给出的 Sargan统计量进行模型筛选** 进一步的讨论:* 虽然AB91建议不要采纳两阶段(非稳健)估计进行统计推断,* 但Windmeijer(,Journal of Econometrics)通过模拟分析标明,* 采纳纠偏(biascorrected,WC)后的稳健性VCE,可以更好地进行统计推断xtabond n L(0/1).w L(0/2).(k ys) yr1980yr1984, lags(2) twostep vce(robust)est store ab_wc_rb* 结果比较local mm "ab4_one_rb ab4_twostep ab_wc_rb"esttab `mm',mtitle(`mm')** 结论:* AB91_onestep_rb 的结果与 AB91_WC_rb 的参数估计相同,后者标准误较年夜* 建议采纳 Windmeijer() 两阶段纠偏稳健型估计量.*== 先决变量的设定* 由于当期干扰项显然会影响后续 w 和 k,所以把它们设定为先决变量更为合理* 注意: 此时逗号前就不能再呈现这两个变量了xtabond n L(0/1).ys yr1980yr1984, lags(2) twostep ///pre(w k)est store ab4_preestat sargan* 从 Sargan p值来看,将 w 和 k 设为先决变量似乎更为合理 * pre() 选项的设定xtabond n L(0/1).ys yr1980yr1984, lags(2) twostep ///pre(w,lag(1,3)) pre(k,lag(2,.))** 解释:* pre(w,lag(1,3))* lag(1,3) 中的 1 暗示 L.w 也会作为解释变量,* lag(1,3) 中的 3 暗示 L2.w 和 L3.w 可以作为 L.w 的工具变量,但 L4.w 不成以;* pre(k,lag(2,.))* lag(2,.) 中的 2 暗示 L1.k, L2.k 城市作为解释变量;* lag(2,.) 中的 . 暗示 L3.k, L4.k ... 都可以作为 L2.k 的工具变量* 说明:上述设建都可附加 vce(robust) 选项以便获得稳健型标准误.*== 工具变量过多招致的问题* 过多的工具变量往往招致过度约束假设无法满足* 估计结果的有效性降低,因为部份工具变量与内生或先决变量的相关性很弱* 对矩阵尺寸的要求增加* 解决法子:限制最年夜的滞后阶数xtabond n L(0/1).ys yr1980yr1984, lags(2) twostep ///pre(w,lag(1,3)) pre(k,lag(2,3))*== 系数估计的上下限* 虽然 Pooled OLS 和 Fixed Effects 估计都是有偏的,* 可是二者却决定了 y_it1 真是估计值的上界和下界* 换言之, Pooled OLS 估计高估了真实值* 而 Fixed effects 估计则低估了真实值*=======================================*============= 系统GMM估计量 ===========*==============AB95,BB98===============*=======================================* Arellano and Bover (1995),* Blundell and Bond(1998)* Haha(1999), Judson and Owen(1999)** 适用范围:* 年夜N,小T** AB91 的局限* (1) 当 y[i,t1] 的系数较年夜,即 y[i,t] 暗示出强烈的序列相关时;* (2) 当 Var[u_i]/Var[e_it] 较年夜时,即个体效应的摆荡远年夜于惯例干扰项的摆荡;* AB91 的暗示欠佳.* 原因在于,水平滞后项是差分方程中内生变量的弱工具变量;* 因此,需要寻求更佳的工具变量**== 基本思想:** 几个概念** 水平值—— y x* 水平方程:y_it = b1*y_it1 + b2*x_it + u_i + v_it* 可用工具变量:D.y[i,t1] 可以作为 y[i,t1] 的工具变量* 可用工具变量:y[i,t2],y[i,t3]...都可以作为 D.y[i,t1]的工具变量** 差分GMM估计量与系统GMM估计量的区别** (1) 差分GMM估计量采纳水平值的滞后项作为差分变量的工具变量;* 如 y_it3 是 D.y_it1 的工具变量* (2) 系统GMM估计量进一步采纳差分变量的滞后项作为水平值的工具变量;* 相当于进一步增加了可用的工具变量,* 且估计过程中同时使用水平方程和差分方程* (3) 主要原因在于差分GMM的工具变量往往是弱工具变量,即 corr(X,Z) 过低** xtabond2 命令Roodman()** 既可以估计差分 GMM 估计量,也可以估计系统 GMM 估计量;* 同时可以估计一般化的回归模型* 提供两阶自相关检验,Sargan检验,Hansen检验,以及工具变量外生性检验** xtdpdsys 命令 Stata官方命令,以 xtabond2命令为基础** xtabond2 命令** 适用于 Stata810 各个版本* 既可以完成一阶差分GMM估计* 也可以完成系统GMM估计* 详细参考资料:* Roodman, D. . How to Do xtabond2:* An Introduction to "Difference" and "System" GMM in Stata. * Working Paper 103. Center for Global Development, Washington.*== 使用 xtabond2 命令获得一阶差分估计量* 附加 noleveleq 选项即可* 采纳 xtabond2 估计 AB91 文中表4 的结果* Arellano and Bond (1991), Table 4* Column (a1)use abdata, clearxtabond2 n L(1/2).n L(0/1).w L(0/2).(k ys) yr1980yr1984, ///gmm(L.n) iv(L(0/1).w l(0/2).(k ys) yr1980yr1984) /// nomata noleveleq small* gmm(*) 填写内生变量的名称* iv(*) 填写所有外生变量以及自己设定的工具变量的名称* noleveleq 暗示估计过程中不使用水平方程,即为差分GMM估计量est store aba1_ab2xtabond n L(0/1).w L(0/2).(k ys) yr1980yr1984, lags(2)est store aba1_abesttab aba1_ab2 aba1_ab, mtitle(aba1_ab2 aba1_ab)* Column (a2)* 两阶段估计xtabond2 n L(0/1).w L(0/2).(k ys) L(1/2).n yr1980yr1984, /// gmm(L.n) iv(L(0/1).w l(0/2).(k ys) yr1980yr1984) /// noleveleq small twostepest store aba2_ab2xtabond n L(0/1).w L(0/2).(k ys) yr1980yr1984, lags(2) twostep est store aba2_abesttab aba2_ab2 aba2_ab, mtitle(aba2_ab2 aba2_ab)*=== 一阶差分估计量部份解释变量内生* 一阶段估计xtabond2 n L.n L(0/1).(w k) yr1980yr1984, ///gmm(L.(w k n)) iv(yr1980yr1984) ///noleveleq noconstant small robustest store fd_1s* 两阶段估计xtabond2 n L.n L(0/1).(w k) yr1980yr1984, ///gmm(L.(w k n)) iv(yr1980yr1984) ///noleveleq robust small twostepest store fd_2sesttab fd_1s fd_2s, mtitle(fd_1s fd_2s)*== 系统 GMM 估计量xtabond2 n L.n L(0/1).(w k) yr1978yr1984, ///gmm(L.n) iv(L(0/1).(w k) yr1978yr1984) ///robust small** 解释:** gmm() 选项* 设定内生变量和先决变量,它们的工具变量将有多列,GMM** iv() 选项* 设定严格外生变量,作为自己的工具变量,在工具变量矩阵中仅占一列** 差分方程和水平方程* 默认情况下,差分方程和水平方程都介入估计** robust 选项* (1) 对一阶段估计(不附加twostep选项),* 采纳传统异方差序列相关稳健型估计量计算标准误;* (2) 对两阶段估计(附加twostep选项),* 采纳Windmeijer()纠偏估计量计算标准误;* Sargan检验* Sargan test of overid. restrictions: chi2(34)* 34 = 47 13 (13是外生变量的个数,包括常数项)* 可见,无论采纳Sargan检验还是Hansen J检验,都拒绝了工具变量合理的原假设* 指定工具变量应用于水平方程还是差分方程* 例如,假设 w, k, 以及年度虚拟变量都是外生的(固然,这一假设可能其实分歧理)*xtabond2 n L.n L(0/1).(w k) yr1978yr1984, gmm(L.n) ///iv(L(0/1).(w k) yr1978yr1984, eq(level)) ///robust small twostepest store sys_wkexg* 将 w 和 k 都设定为内生变量* yr dummies 仅呈现在水平方程中xtabond2 n L.n L(0/1).(w k) yr1978yr1984, ///gmm(L.(w k n)) iv(yr1978yr1984, eq(level)) ///robust small twostepest store sys_wkendog_lev* yr dummies 同时呈现在水平方程和差分方程中xtabond2 n L.n L(0/1).(w k) yr1978yr1984, ///gmm(L.(w k n)) iv(yr1978yr1984, eq(both)) ///robust small twostepest store sys_wkendog_both* 结果比较local mm "fd_1s fd_2s sys_wkexg sys_wkendog_levsys_wkendog_both"esttab `mm', mtitle(`mm') compress** xtdpdsys 命令** 仅适用于 Stata10 版本* 中国上市公司资本结构静态调整use xtcs.dta, clearqui tab year, gen(yr)drop yr1* Case I:假设所有解释变量均为外生变量(L.tl除外)*local xx "size tang ndts L(0/1).tobin L(0/1).npr yr*"xtdpdsys tl `xx', vce(robust) twostepdis ln(2) / (1 _b[L1.tl]) /*调整半周期*/est store dycs_2sys* 设定说明:* (1) 无需设定 L.tl, 因为 xtdpdsys 默认设定被解释变量的滞后一期为解释变量,* 而且该变量被自动设定为内生变量;* (2) 稳健型估计采纳 vce(robust) 选项加以设定;* (3) 该命令不会自动进行 AR(2)序列相关检验和Sargan过度识别检验* 序列相关检验estat abond* 过度识别检验estat sargan /*稳健型估计下无法获得Sargan统计量*/* 正确方法local xx "size tang ndts L(0/1).tobin L(0/1).npr yr*"xtdpdsys tl `xx', twostepestat sargan* Case II:假设Tobin和npr为先决变量local xx "size tang ndts yr*" /*此处不应再包括 tobin和npr*/ xtdpdsys tl `xx', pre(tobin npr,lag(1,.)) twostepest store dycs_2preestat abondestat sargan* Case III:假设Tobin和npr为内生变量local xx "size tang ndts yr*" /*此处不应再包括 tobin和npr*/ xtdpdsys tl `xx', endog(tobin npr,lag(1,.)) twostepest store dycs_2endogestat abondestat sargan* Case IV: 假设除年度虚拟变量和公司规模外,所有解释变量均为先决变量local xx "size yr*"xtdpdsys tl `xx', pre(tobin npr,lag(1,.)) ///pre(tang ndts) twostepest store dycs_2preAllestat abondestat sargan* 假设除 L.tl 外的所有解释变量外生最为合适.* OLS 估计(调整系数的上限)local xx "size tang ndts L(0/1).tobin L(0/1).npr yr*"reg tl L.tl `xx', robustest store dycs_2OLS* FE 估计(调整系数的下限)local xx "size tang ndts L(0/1).tobin L(0/1).npr yr*"xtreg tl L.tl `xx', robust feest store dycs_2FE* 结果比较local mm "dycs_2sys dycs_2pre dycs_2endog dycs_2preAll dycs_2OLS dycs_2FE"local ss "ar2 ar2p sargan sar_df sarganp"esttab `mm',mtitle(`mm') scalar(`ss') compress* 结论:* (1) 估计出的调整系数介于合理的范围内,即OLS和FE之间;* (2) 就模型设定而言,dycs_2sys 最为合理,即把所有解释变量均设定为外生变量.** 调整半周期为:local xx "size tang ndts L(0/1).tobin L(0/1).npr yr*"xtdpdsys tl `xx', vce(robust) twostepdis ln(2) / (1 _b[L1.tl]) /*调整半周期*/xtabond2 logy l.logy h inv gov open fdi yr4yr14, ///gmm(l.logy h) iv(gov open fdi yr4yr14)robust twostep。
stata教程
基本命令语句中,[]中的内容表示可以省略的部分, 因此我们可以看出,只有command是必不可少的,其 他部分的内容用户可以根据自己的需要进行选择。
(3)变量窗口(Variables),主要是用来显示变量名 称和类型的窗口。点击某个变量名称,其就可以显示 在右方的命令窗口中。如果想要删除某个变量,则只 需要在命令窗口中输入drop命令,然后鼠标左键单击 相应的变量名称,然后点击回车键即可完成删除操作。
(4)命令输入窗口(Command),是用户进行交互 式程序操作的主要实现场所,只要用户将相关命令输 入,然后点击回车键即可。
1.3Stata主要功能模块介绍
Stata软件具有数据处理、绘图、统计分析、回归分析和编 程处理这五大主要功能,其相互配合,可以完成系统完整 的数据分析和处理任务。
1.3.1数据处理
用户得到第一手数据之后要做的就是对数据进行基本的处 理,主要包括数据的读入、类型的转换、压缩等,此外还 可以对数据进行基本的描述分析,包括频数分布、离散趋 势、集中趋势的分析等等。以上内容将在第二章中具体讲 述。
分析的重中之重,主要包括基本回归分析、模型的设定与修正、 离散被解释变量模型、计数模型、受限因变量模型、时间序列 分析、面板数据分析、系统方程模型、蒙特卡罗模拟与自助法 等方面的内容,这些将会在第六至第十五章中具体讲述。
1.3.5编程 Stata还可以实现用户自己编写的程序,极大地方便了用户的使
(二)Stata自带帮助系统是使用最方便,也是最常用 的方法。其语法格式为:help [所要查询命令]
stata命令大全(全)

stata命令大全(全)********* 面板数据计量分析与软件实现 *********说明:以下do文件相当一部分内容来自于中山大学连玉君STATA教程,感谢他的贡献。
本人做了一定的修改与筛选。
*----------面板数据模型 * 1.静态面板模型:FE 和RE* 2.模型选择:FE vs POLS, RE vs POLS, FE vs RE (pols混合最小二乘估计)* 3.异方差、序列相关和截面相关检验 * 4.动态面板模型(DID-GMM,SYS-GMM) * 5.面板随机前沿模型* 6.面板协整分析(FMOLS,DOLS)*** 说明:1-5均用STATA软件实现, 6用GAUSS软件实现。
* 生产效率分析(尤其指TFP):数据包络分析(DEA)与随机前沿分析(SFA)*** 说明:DEA由DEAP2.1软件实现,SFA由Frontier4.1实现,尤其后者,侧重于比较C-D与Translog生产函数,一步法与两步法的区别。
常应用于地区经济差异、FDI溢出效应(Spillovers Effect)、工业行业效率状况等。
* 空间计量分析:SLM模型与SEM模型*说明:STATA与Matlab结合使用。
常应用于空间溢出效应(R&D)、财政分权、地方政府公共行为等。
* ---------------------------------* -------- 一、常用的数据处理与作图 ----------- * ---------------------------------* 指定面板格式xtset id year (id为截面名称,year为时间名称) xtdes /*数据特征*/xtsum logy h /*数据统计特征*/ sum logy h /*数据统计特征*/*添加标签或更改变量名 label var h \人力资本\rename h hum*排序sort id year /*是以STATA面板数据格式出现*/ sort year id /*是以DEA格式出现*/*删除个别年份或省份 drop if year<1992drop if id==2 /*注意用==*/*如何得到连续year或id编号(当完成上述操作时,year或id就不连续,为形成panel格式,需要用egen命令)egen year_new=group(year) xtset id year_new**保留变量或保留观测值 keep inv /*删除变量*/ **或keep if year==2000**排序sort id year /*是以STATA面板数据格式出现 sort year id /*是以DEA格式出现**长数据和宽数据的转换 *长>>>宽数据reshape wide logy,i(id) j(year)*宽>>>长数据reshape logy,i(id) j(year)**追加数据(用于面板数据和时间序列)xtset id year *或者 xtdestsappend,add(5) /表示在每个省份再追加5年,用于面板数据/tsset *或者 tsdes.tsappend,add(8) /表示追加8年,用于时间序列/*方差分解,比如三个变量Y,X,Z都是面板格式的数据,且满足Y=X+Z,求方差var(Y),协方差Cov(X,Y)和Cov(Z,Y)bysort year:corr Y X Z,cov**生产虚拟变量 *生成年份虚拟变量 tab year,gen(yr) *生成省份虚拟变量 tab id,gen(dum)**生成滞后项和差分项 xtset id yeargen ylag=l.y /*产生一阶滞后项),同样可产生二阶滞后项*/ gen ylag2=L2.ygen dy=D.y /*产生差分项*/*求出各省2000年以前的open inv的平均增长率 collapse (mean) open inv if year<2000,by(id)变量排序,当变量太多,按规律排列。
stata命令大全(全)
********* 面板数据计量分析与软件实现 *********说明:以下do文件相当一部分内容来自于中山大学连玉君STATA教程,感谢他的贡献。
本人做了一定的修改与筛选。
*----------面板数据模型* 1.静态面板模型:FE 和RE* 2.模型选择:FE vs POLS, RE vs POLS, FE vs RE (pols混合最小二乘估计) * 3.异方差、序列相关和截面相关检验* 4.动态面板模型(DID-GMM,SYS-GMM)* 5.面板随机前沿模型* 6.面板协整分析(FMOLS,DOLS)*** 说明:1-5均用STATA软件实现, 6用GAUSS软件实现。
* 生产效率分析(尤其指TFP):数据包络分析(DEA)与随机前沿分析(SFA)*** 说明:DEA由DEAP2.1软件实现,SFA由Frontier4.1实现,尤其后者,侧重于比较C-D与Translog生产函数,一步法与两步法的区别。
常应用于地区经济差异、FDI 溢出效应(Spillovers Effect)、工业行业效率状况等。
* 空间计量分析:SLM模型与SEM模型*说明:STATA与Matlab结合使用。
常应用于空间溢出效应(R&D)、财政分权、地方政府公共行为等。
* ---------------------------------* --------一、常用的数据处理与作图-----------* ---------------------------------* 指定面板格式xtset id year (id为截面名称,year为时间名称)xtdes /*数据特征*/xtsum logy h /*数据统计特征*/sum logy h /*数据统计特征*/*添加标签或更改变量名label var h "人力资本"rename h hum*排序sort id year /*是以STATA面板数据格式出现*/sort year id /*是以DEA格式出现*/*删除个别年份或省份drop if year<1992drop if id==2 /*注意用==*/*如何得到连续year或id编号(当完成上述操作时,year或id就不连续,为形成panel 格式,需要用egen命令)egen year_new=group(year)xtset id year_new**保留变量或保留观测值keep inv /*删除变量*/**或keep if year==2000**排序sort id year /*是以STATA面板数据格式出现sort year id /*是以DEA格式出现**长数据和宽数据的转换*长>>>宽数据reshape wide logy,i(id) j(year)*宽>>>长数据reshape logy,i(id) j(year)**追加数据(用于面板数据和时间序列)xtset id year*或者xtdestsappend,add(5) /表示在每个省份再追加5年,用于面板数据/tsset*或者tsdes.tsappend,add(8) /表示追加8年,用于时间序列/*方差分解,比如三个变量Y,X,Z都是面板格式的数据,且满足Y=X+Z,求方差var(Y),协方差Cov(X,Y)和Cov(Z,Y)bysort year:corr Y X Z,cov**生产虚拟变量*生成年份虚拟变量tab year,gen(yr)*生成省份虚拟变量tab id,gen(dum)**生成滞后项和差分项xtset id yeargen ylag=l.y /*产生一阶滞后项),同样可产生二阶滞后项*/gen ylag2=L2.ygen dy=D.y /*产生差分项*/*求出各省2000年以前的open inv的平均增长率collapse (mean) open inv if year<2000,by(id)变量排序,当变量太多,按规律排列。
stata命令大全(全)
********* 面板数据计量分析与软件实现 *********说明:以下do文件相当一部分内容来自于中山大学连玉君STATA教程,感谢他的贡献。
本人做了一定的修改与筛选。
*----------面板数据模型* 1.静态面板模型:FE 和RE* 2.模型选择:FE vs POLS, RE vs POLS, FE vs RE (pols混合最小二乘估计)* 3.异方差、序列相关和截面相关检验* 4.动态面板模型(DID-GMM,SYS-GMM)* 5.面板随机前沿模型* 6.面板协整分析(FMOLS,DOLS)*** 说明:1-5均用STATA软件实现, 6用GAUSS软件实现。
* 生产效率分析(尤其指TFP):数据包络分析(DEA)与随机前沿分析(SFA)*** 说明:DEA由DEAP2.1软件实现,SFA由Frontier4.1实现,尤其后者,侧重于比较C-D与Translog生产函数,一步法与两步法的区别。
常应用于地区经济差异、FDI溢出效应(Spillovers Effect)、工业行业效率状况等。
* 空间计量分析:SLM模型与SEM模型*说明:STATA与Matlab结合使用。
常应用于空间溢出效应(R&D)、财政分权、地方政府公共行为等。
* ---------------------------------* --------一、常用的数据处理与作图-----------* ---------------------------------* 指定面板格式xtset id year (id为截面名称,year为时间名称)xtdes /*数据特征*/xtsum logy h /*数据统计特征*/sum logy h /*数据统计特征*/*添加标签或更改变量名label var h "人力资本"rename h hum*排序sort id year /*是以STATA面板数据格式出现*/sort year id /*是以DEA格式出现*/*删除个别年份或省份drop if year<1992drop if id==2 /*注意用==*/*如何得到连续year或id编号(当完成上述操作时,year或id就不连续,为形成panel格式,需要用egen命令)egen year_new=group(year)xtset id year_new**保留变量或保留观测值keep inv /*删除变量*/**或keep if year==2000**排序sort id year /*是以STATA面板数据格式出现sort year id /*是以DEA格式出现**长数据和宽数据的转换*长>>>宽数据reshape wide logy,i(id) j(year)*宽>>>长数据reshape logy,i(id) j(year)**追加数据(用于面板数据和时间序列)xtset id year*或者xtdestsappend,add(5) /表示在每个省份再追加5年,用于面板数据/tsset*或者tsdes.tsappend,add(8) /表示追加8年,用于时间序列/*方差分解,比如三个变量Y,X,Z都是面板格式的数据,且满足Y=X+Z,求方差var(Y),协方差Cov(X,Y)和Cov(Z,Y)bysort year:corr Y X Z,cov**生产虚拟变量*生成年份虚拟变量tab year,gen(yr)*生成省份虚拟变量tab id,gen(dum)**生成滞后项和差分项xtset id yeargen ylag=l.y /*产生一阶滞后项),同样可产生二阶滞后项*/gen ylag2=L2.ygen dy=D.y /*产生差分项*/*求出各省2000年以前的open inv的平均增长率collapse (mean) open inv if year<2000,by(id)变量排序,当变量太多,按规律排列。
门槛回归模型系列讲解(二):门槛回归模型完全攻略
门槛回归模型系列讲解(⼆):门槛回归模型完全攻略⽬录第⼀部分模型背景以及简介history&Hansen第⼆部分优秀论⽂解读1、优秀中⽂论⽂解读2、优秀英⽂论⽂解读第三部分时间序列门槛模型stata操作第四部分⾯板数据门槛模型stata操作4.1 王群勇⽼师xthreg与xtptm命令4.2 连⽟君⽼师xtthres命令第⼀部分模型背景以及简介进⾏回归分析,⼀般需要研究系数的估计值是否稳定。
很多经济变量都存在结构突变问题,使⽤普通回归的做法就是确定结构突变点,进⾏分段回归。
这就像我们⾼中学习的分段函数。
但是对于⼤样本、⾯板数据如何寻找结构突变点。
所以本⽂在此讲解⾯板门限回归的问题,门限回归也适⽤于时间序列。
、门限效应,是指当⼀个经济参数达到特定的数值后,引起另外⼀个经济参数发⽣突然转向其它发展形式的现象(结构突变)。
作为原因现象的临界值称为门限值。
例如,成果和时间存在⾮线性关系,但是在每个阶段是线性关系。
有些⼈将这样的模型称为门槛模型,或者门限模型。
如果模型的研究对象包含多个个体多个年度,那么就是门限⾯板模型。
history&Hansen常见模型如下:门槛回归模型(thresholdregression,也称门限回归):汉森(Bruce E. Hansen)在门限回归模型上做出了很多贡献。
Hansen于1996年在《Econometrica》上发表⽂章《Inference when a nuisance parameter is not identified under the nullhypothesis》,提出了时间序列门限⾃回归模型(TAR)的估计和检验。
之后,他在门限模型上连续追踪,发表了⼏篇经典⽂章,尤其是1999年的《Threshold effects in non-dynamicpanels: Estimation, testing and inference》(Hansen(1999) ⾸次介绍了具有个体效应的⾯板门限模型的计量分析⽅法, 该⽅法以残差平⽅和最⼩化为条件确定门限值, 并检验门限值的显著性, 克服了主观设定结构突变点的偏误。
stata命令大全(全)
*********面板数据计量阐发与软件实现*********之五兆芳芳创作说明:以下do文件相当一部分外容来自于中山大学连玉君STATA教程,感激他的奉献.自己做了一定的修改与筛选.*面板数据模型* 1.静态面板模型:FE 和RE* 2.模型选择:FE vs POLS, RE vs POLS, FE vs RE(pols混杂最小二乘估量)* 3.异方差、序列相关和截面相关查验* 4.动态面板模型(DIDGMM,SYSGMM)* 6.面板协整阐发(FMOLS,DOLS)*** 说明:15均用STATA软件实现, 6用GAUSS软件实现.* 生产效率阐发(尤其指TFP):数据包络阐发(DEA)与随机前沿阐发(SFA)*** 说明:DEA由DEAP2.1软件实现,SFA由Frontier4.1实现,尤其后者,偏重于比较CD与Translog生产函数,一步法与两步法的区别.常应用于地区经济差别、FDI溢出效应(Spillovers Effect)、产业行业效率状况等.* 空间计量阐发:SLM模型与SEM模型*说明:STATA与Matlab结合使用.常应用于空间溢出效应(R&D)、财务分权、地方政府公共行动等.** 一、经常使用的数据处理与作图** 指定面板格局xtset id year(id为截面名称,year为时间名称)xtdes /*数据特征*/xtsum logy h /*数据统计特征*/sum logy h /*数据统计特征*/*添加标签或更改动量名label var h "人力资本"rename h hum*排序sort id year /*是以STATA面板数据格局出现*/sort year id /*是以DEA格局出现*/*删除个别年份或省份drop if year<1992drop if id==2 /*注意用==*/*如何得到连续year或id编号(当完成上述操纵时,year或id就不连续,为形成panel格局,需要用egen命令)egen year_new=group(year)xtset id year_new**保存变量或保存不雅测值keep inv /*删除变量*/**或keep if year==2000**排序sort id year /*是以STATA面板数据格局出现sort year id /*是以DEA格局出现**长数据和宽数据的转换*长>>>宽数据reshape wide logy,i(id) j(year)*宽>>>长数据reshape logy,i(id) j(year)**追加数据(用于面板数据和时间序列)xtset id year*或xtdestsappend,add(5) /暗示在每个省份再追加5年,用于面板数据/ tsset*或tsdes.tsappend,add(8) /暗示追加8年,用于时间序列/*方差分化,比方三个变量Y,X,Z都是面板格局的数据,且满足Y=X+Z,求方差var(Y),协方差Cov(X,Y)和Cov(Z,Y)bysort year:corr Y X Z,cov**生产虚拟变量*生成年份虚拟变量tab year,gen(yr)*生成省份虚拟变量tab id,gen(dum)**生成滞后项和差分项xtset id yeargen ylag=l.y /*产生一阶滞后项),同样可产生二阶滞后项*/gen dy=D.y /*产生差分项*/*求出各省2000年以前的open inv的平均增长率collapse (mean) open inv if year<2000,by(id)变量排序,当变量太多,按纪律排列.可用命令aorder或order fdi open insti** 二、静态面板模型** 简介* 面板数据的结构(兼具截面资料和时间序列资料的特征)use product.dta, clearbrowsextset id yearxtdes** 固定效应模型** 实质上就是在传统的线性回归模型中参加 N1 个虚拟变量,* 使得每个截面都有自己的截距项,* 截距项的不合反应了个别的某些不随时间改动的特征** 例如: lny = a_i + b1*lnK + b2*lnL + e_it* 考虑中国29个省份的CD生产函数*******绘图**散点图+线性拟合直线twoway (scatter logy h) (lfit logy h)*散点图+二次拟合曲线twoway (scatter logy h) (qfit logy h)*散点图+线性拟合直线+置信区间twoway (scatter logy h) (lfit logy h) (lfitci logy h)*按不合个别画出散点图和拟合线,可以以做出fe vs re的初判断*twoway (scatter logy h if id<4) (lfit logy h if id<4) (lfit logy h if id==1) (lfit logy h if id==2) (lfit logy h if id==3)*按不合个别画散点图,so beautiful!!!*graph twoway scatter logy h if id==1 || scatter logy h ifid==2,msymbol(Sh) || scatter logy h if id==3,msymbol(T) || scatter logy h if id==4,msymbol(d) || , legend(position(11) ring(0) label(1 "北京") label(2 "天津") label(3 "河北") label(4 "山西")) **每个省份logy与h的散点图,并将各个图形归并twoway scatter logy h,by(id) ylabel(,format(%3.0f))xlabel(,format(%3.0f))*每个个别的时间趋势图*xtline h if id<11,overlay legend(on)* 一个例子:中国29个省份的CD生产函数的估量tab id, gen(dum)list* 回归阐发reg logy logk logl dum*,est store m_olsxtreg logy logk logl, feest store m_feest table m_ols m_fe, b(%6.3f) star(0.1 0.05 0.01)* Wald 查验test logk=logl=0test logk=logl* stata的估量办法解析* 目的:如果截面的个数很是多,那么采取虚拟变量的方法运算量过大* 因此,要寻求公道的方法去除掉个别效应* 因为,我们存眷的是 x 的系数,而非每个截面的截距项 * 处理办法:** y_it = u_i + x_it*b + e_it (1)* ym_i = u_i + xm_i*b + em_i (2) 组内平均* ym = um + xm*b + em (3) 样本平均* (1) (2), 可得:* (y_it ym_i) = (x_it xm_i)*b + (e_it em_i) (4) /*within estimator*/* (4)+(3), 可得:* (y_itym_i+ym) = um + (x_itxm_i+xm)*b + (e_item_i+em) * 可重新暗示为:* Y_it = a_0 + X_it*b + E_it* 对该模型执行 OLS 估量,便可得到 b 的无偏估量量**stata后台操纵,揭开fe估量的神秘面纱!!!egen y_meanw = mean(logy), by(id) /*个别内部平均*/egen y_mean = mean(logy) /*样本平均*/egen k_meanw = mean(logk), by(id)egen k_mean = mean(logk)egen l_meanw = mean(logl), by(id)egen l_mean = mean(logl)gen dyw = logy y_meanwgen dkw = logk k_meanwgen dlw=logll_meanwreg dyw dkw dlw,noconsest store m_statagen dy = logy y_meanw + y_meangen dk = logk k_meanw +k_meangen dl=logll_meanw+l_meanreg dy dk dlest store m_stataest table m_*, b(%6.3f) star(0.1 0.05 0.01)* 解读 xtreg,fe 的估量结果xtreg logy h inv gov open,fe* R^2* y_it = a_0 + x_it*b_o + e_it (1) pooled OLS* y_it = u_i + x_it*b_w + e_it (2) within estimator* ym_i = a_0 + xm_i*b_b + em_i (3) between estimator** > Rsq: within 模型(2)对应的R2,是一个真正意义上的R2 * > Rsq: between corr{xm_i*b_w,ym_i}^2* > Rsq: overall corr{x_it*b_w,y_it}^2***** sigma_u, sigma_e, rho* rho = sigma_u^2 / (sigma_u^2 + sigma_e^2)dis e(sigma_u)^2 / (e(sigma_u)^2 + e(sigma_e)^2)** 个别效应是否显著?* F(28, 373) = 338.86 H0: a1 = a2 = a3 = a4 = a29* Prob > F = 0.0000 标明,固定效应高度显著*如何得到调整后的 R2,即 adjR2 ?ereturn listreg logy h inv gov open dum**拟合值和残差* y_it = u_i + x_it*b + e_it* predict newvar, [option]/*xb xb, fitted values; the defaultstdp calculate standard error of the fitted valuesue u_i + e_it, the combined residualxbu xb + u_i, prediction including effectu u_i, the fixed or randomerror componente e_it, the overall error component */xtreg logy logk logl, fepredict y_hatpredict a , upredict res,epredict cres, uegen ares = a + reslist ares cres in 1/10** 随机效应模型** y_it = x_it*b + (a_i + u_it)* = x_it*b + v_it* 根本思想:将随机搅扰项分红两种* 一种是不随时间改动的,即个别效应 a_i* 另一种是随时间改动的,即通常意义上的搅扰项 u_it * 估量办法:FGLS* Var(v_it) = sigma_a^2 + sigma_u^2* Cov(v_it,v_is) = sigma_a^2* Cov(v_it,v_js) = 0* 利用Pooled OLS,Within Estimator, Between Estimator* 可以估量出sigma_a^2和sigma_u^2,进而采取GLS或FGLS* Re估量量是Fe估量量和Be估量量的加权平均* yr_it = y_it theta*ym_i* xr_it = x_it theta*xm_i* theta = 1 sigma_u / sqrt[(T*sigma_a^2 + sigma_u^2)]* 解读 xtreg,re 的估量结果use product.dta, clearxtreg logy logk logl, re* R2* > Rsq: within corr{(x_itxm_i)*b_r, y_itym_i}^2* > Rsq: between corr{xm_i*b_r,ym_i}^2* > Rsq: overall corr{x_it*b_r,y_it}^2* 上述R2都不是真正意义上的R2,因为Re模型采取的是GLS估量.** rho = sigma_u^2 / (sigma_u^2 + sigma_e^2)dis e(sigma_u)^2 / (e(sigma_u)^2 + e(sigma_e)^2)** corr(u_i, X) = 0 (assumed)* 这是随机效应模型的一个最重要,也限制该模型应用的一个重要假定* 然而,采取固定效应模型,我们可以粗略估量出corr(u_i, X) xtreg market invest stock, fe** 时间效应、模型的筛选和罕有问题*目录* 时间效应(双向固定(随机)效应模型)* 模型的筛选* 面板数据罕有问题* 面板数据的转换** 时间效应** 单向固定效应模型* y_it = u_i + x_it*b + e_it* 双向固定效应模型* y_it = u_i + f_t + x_it*b + e_itqui tab year, gen(yr)drop yr1xtreg logy logk logl yr*, fe* 随机效应模型中的时间效应xtreg logy logk logl yr*, fe** 模型的筛选** 固定效应模型仍是Pooled OLS?xtreg logy logk logl yr*, fe /*Wald 查验*/qui tab id, gen(dum) /*LR查验*/reg logy logk logl /*POLS*/est store m_olsreg logy logk logl dum*,noconsest store m_felrtest m_ols m_feest table m_*, b(%6.3f) star(0.1 0.05 0.01)* RE vs Pooled OLS?* H0: Var(u) = 0* 办法一:BP 查验xtreg logy logk logl, rexttest0* FE vs RE?* y_it = u_i + x_it*b + e_it* Hausman 查验* 根本思想:如果 Corr(u_i,x_it) = 0, Fe 和 Re 都是一致的,但Re更有效* 如果 Corr(u_i,x_it)!= 0, Fe 仍然有效,但Re是有偏的* 根本步调***情形1:huasman为正数xtreg logy logk logl, feest store m_fextreg logy logk logl, reest store m_rehausman m_fe m_re*** 情形2:qui xtreg logy h inv gov open,feest store fequi xtreg logy h inv gov open,reest store rehausman fe re* Hausman 查验值为负怎么办?* 通常是因为RE模型的根本假定 Corr(x,u_i)=0 无法得到满足* 查验进程中两个模型的方差协方差矩阵都采取Fe模型的 hausman fe re, sigmaless* 两个模型的方差协方差矩阵都采取Re模型的hausman fe re, sigmamore*== 为何有些变量会被drop掉?use nlswork.dta, cleartsset idcode yearxtreg ln_wage hours tenure ttl_exp, fe /*正常执行*/* 产生种族虚拟变量tab race, gen(dum_race)xtreg ln_wage hours tenure ttl_exp dum_race2 dum_race3, fe * 为何 dum_race2 和 dum_race3 会被 dropped ?* 固定效应模型的设定:y_it = u_i + x_it*b + e_it (1)* 由于个别效应 u_i 不随时间改动,* 因此若 x_it 包含了任何不随时间改动的变量,* 都会与 u_i 组成多重共线性,Stata会自动删除之.*******异方差、序列相关和截面相关问题* 简介* y_it = x_it*b + u_i + e_it** 由于面板数据同时统筹了截面数据和时间序列的特征,* 所以异方差和序列相关必定会存在于面板数据中;* 同时,由于面板数据中每个截面(公司、团体、国度、地区)之间还可能存在内在的联系,* 所以,截面相关性也是一个需要考虑的问题.** 此前的阐发依赖三个假定条件:* (1) Var[e_it] = sigma^2 同方差假定* (2) Corr[e_it, e_its] = 0 序列无关假定* (3) Corr[e_it, e_jt] = 0 截面不相关假定** 当这三个假定无法得到满足时,便辨别出现异方差、序列相关和截面相关问题;* 我们一方面要采取各类办法来查验这些假定是否得到了满足;* 另一方面,也要在这些假定无法满足时寻求公道的估量办法.* 假定查验*== 组间异方差查验(截面数据的特征)* Var(e_i) = sigma_i^2* Fe 模型xtreg logy logk logl, fexttest3* Re 模型* Re自己已经较大程度的考虑了异方差问题,主要体现在sigma_u^2上*== 序列相关查验* Fe 模型xtserial logy logk loglxtserial logy logk logl, output* Re 模型xtreg logy logk logl, rexttest1 /*提供多个统计查验量*/*== 截面相关查验* xttest2命令 H0: 所有截面残差的相关系数都相等xtreg logy logk logl, fexttest2* 由于查验进程中执行了SUE估量,所以要求T>Nxtreg logy logk logl if id<6, fexttest2* xtcsd 命令(提供了三种查验办法)xtreg logy logk logl, fextcsd , pesaran /*Pesaran()*/xtcsd , friedman /*Friedman(1937)*/xtreg logy logk logl, rextcsd , pesaran* 估量办法*== 异方差稳健型估量xtreg logy h inv gov open, fe robustest store fe_rbxtreg logy h inv gov open, fe robustest store fe* 结果对比esttab fe_rb fe, b(%6.3f) se(%6.3f) mtitle(fe_rb fe)*== 序列相关估量* 一阶自相关 xtregar, fe/re* 模型: y_it = u_i + x_it*b + v_it (1)* v_it = rho*v_it1 + z_it (2)xtregar logy h inv gov open, feest store fe_ar1xtregar logy h inv gov open,fe lbi /*BaltagiWu LBI test*/* 说明:* (1) 这里的DurbinWatson =1.280677 具有较为庞杂的散布,* 不合于时间序列中的DW统计量.* (2) 其临界值见Bhargava et al. (1982, The Review of Economic Studies 49:553549)* (3) BaltagiWu LBI = 1.4739834 根本上没有太大的参考价值,* 因为他们并未提供临界值表,而该统计量的散布又相当庞杂xtregar logy h inv gov open, reest store re_ar1* 两阶段估量xtregar logy h inv gov open, fe twostepest store fe_ar1_two* 结果对比xtreg logy h inv gov open, feest store felocal models "fe fe_ar1 re_ar1 fe_ar1_two "esttab `models', b(%6.3f) se(%6.3f) mtitle(`models') r2sca(r2_w corr)* 高阶自相关* newey2 命令newey2 logy h inv gov open, lag(2)*== 组间相关(截面相关)* cluster 选项use xtcs.dta, clearxtreg logy h inv gov open, fe cluster(id)est store fe_clusterxtreg logy h inv gov open, re cluster(id)est store re_cluster************看过来很晕,采取一种综合处理:* xtgls 命令* xtpcse 命令* 简介(Greene, 2000, chp15)** 模型* y = X*b + U* 重点在于考虑搅扰项 U 的结构,包含* (1) 异方差 (2) 序列相关 (3) 截面相关性* 应用范围:多用于“大T,小N”型面板数据,* 因为,此时截面的异质性其实不是重点存眷的,而时序特征则较为明显* 因此,模型设定中未考虑个别效果* | y_1 | | X_1 | | e_1 |* | y_2 | | X_2 | | e_2 |* | . | | . | | . |* | . | = | . | * b + | . |* | . | | . | | . |* | y_n | | X_n | | e_n |* 截面异方差* E[e_i*e_i'] = s_i^2** | s1^2 0 ... 0 |* | 0 s2^2 ... 0 |* | . |* V = | . |* | . |* | 0 0 ... sn^2 |* 截面相关* E[e_i*e_i'] = s_ij^2** | s_11 s_12 ... s_1n |* | s_21 s_22 ... s_2n |* | . |* V = | . | * sigma^2* | . |* | s_n1 s_n2 ... s_nn |* 序列相关* E[e_i*e_i'] = s_i^2 * M_i** | s1^2*M_1 0 ... 0 |* | 0 s2^2*M_2 ... 0 |* | . |* V = | . |* | . |* | 0 0 ... sn^2*M_n |* GLS 估量* b = [X'V^{1}*X]^{1}[X'V^{1}y]* Var[b] = [X'V^{1}*X]^{1}* 估量和查验*=== xtgls 命令use invest2.dta, clearxtgls market invest stock, panels(iid) /*iid, 等同于Pooled OLS*/est store g_0reg market invest stockest store g_olsxtgls market invest stock, panel(het) /*截面异方差*/est store g_phetxtgls market invest stock, corr(ar1) /*所有截面具有相同的自相关系数*/est store g_par1xtgls market invest stock, corr(psar1) /*每个截面有自己的自相关系数*/est store g_psar1xtgls market invest stock, panel(corr) /*截面间相关且异方差*/est store g_pcorrxtgls market invest stock, p(c) corr(ar1)est store g_all* 查验异方差xtgls market invest stock, panel(het) /*截面异方差*/xttest3* 查验序列相关xtserial market invest stock* 查验截面相关xtgls market invest stock, panel(het)xttest2* 结果对比xtreg market invest stock, feest store felocal models "fe g_0 g_ols"esttab `models', b(%6.3f) se(%6.3f) mtitle(`models') r2sca(r2_w)local models "fe g_phet g_par1 g_psar1 g_pcorr g_all"esttab `models', b(%6.3f) se(%6.3f) mtitle(`models') r2sca(r2_w) compress* 说明:* 为何 xtgls 不报告请示 R2 ?* 因为此时的R2未必介于0和1之间,不具有传统线性回归模型中R2的寄义*=== xtpcse 命令* 默认假定:存在截面异方差和截面相关* 估量办法:OLS 或 PraisWinsten 回归* 有别于xtgls(采取FGLS估量)* 更适于方块面板 N不大(1020),T不大(1040)* 与 xtgls 的区别:估量办法不合* xtgls 采取GLS进行估量,而xtpsce采取OLS.use invest2.dta, clearxtpcse invest market stockest store pcse_full /*OLS估量,调整异方差和截面相关后的尺度误*/xtgls invest market stock, panels(correlated)est store m_xtgls /*FGLS估量,异方差和截面相关*/ xtpcse invest market stock, correlation(ar1)est store pcse_ar1 /*Prais_Winsten估量,配合的自相关系数*/xtpcse invest market stock, correlation(ar1) hetonlyest store pcse_ar1 /*不考虑截面相关*/* 结果对比xtreg invest market stock, feest store felocal models "fe pcse_full m_xtgls pcse_ar1 pcse_ar1"esttab `models', b(%6.3f) se(%6.3f) mtitle(`models') r2sca(r2_w)* xtpcse 的结果与 xtgls 很是相似,但前者可以报告请示R2 * 当N较大时,采取该办法会很是费时,* 因为方差协方差矩阵是采取OLS估量的残差计较的use xtcs.dta, clearxtdesxtpcse tl size ndts tang tobin npr /*大约58分钟*/est store xtpcsextreg tl size ndts tang tobin npr, feest store fe* 结果对比local models "fe xtpcse"esttab `models', b(%6.3f) se(%6.3f) mtitle(`models') r2sca(r2_w)* 系数估量值有较大不同,但符号和显著性是一致的.***动态面板模型 Part I** 动态面板模型** 简介* 一阶差分IV估量量(Anderson and Hisao, 1982)* 一阶差分GMM估量量(Arellano and Bond, 1991)* 系统GMM估量量(AB,1995; BB,1998)* == 简介 ==** 模型: y[it] = a0*y[it1] + a1*x[it] + a2*w[it] + u_i + e[it]** 特征:解释变量中包含了被解释变量的一阶滞后项* 可以是非平行面板,但要包管时间连续* x[it] ——严非分特别生变量 E[x_it,e_is] =0 for all t and s* 即,所有搅扰项与x都不相关* w[it] ——先决变量 E[w_it,e_is]!=0 for s<t, butE[x_it,v_is]=0 for all s>=t* 即,前期搅扰项与当期x相关,但当期和未来期搅扰项与x不相关.* y[it1]——内生变量 E[x_it,e_is]!=0 for s<=t* 即,前期和当期,尤其是当期搅扰项与x相关* u_i 随机效应,在截面间是 iid 的.u_i 与 e[it] 独立.** 内生性问题:* (1) 若假定 u_i 为随机效应,则 Corr(y[i,t1], u_i) !=0* (2) 若假定 u_i 为个别效应,需要想办法去除之,因为数据为"大N小T"* 一阶差分: D.y[i,t1] = y[i,t1] y[i,t2]* D.e[i,t] = e[i,t] e[i,t1]* 显然: Corr(D.y[i,t1], D.e[i,t]) !=0, 差分方程存在内生问题;* 组内去心: ym[i,t1] = y[i,t1] 1/(T1)*(y[i,t1]+...+y[i,T])* em[i,t] = e[i,t] 1/T*(e[i,t]+e[i,t1]+...+e[i,T])* 显然: Corr(ym[i,t1], em[i,t]) !=0, 仍然存在内生性问题** 处理办法:IV估量或GMM估量,选择适合的东西变量** 矩条件: E[e_it,z_it] = 0*========================================*========= 一阶差分 IV 估量量 ============*========Anderson and Hisao(1982)========*========================================** 根本思想:采取一阶差分去除个别效应 u_i,* y 的滞后二阶作为 D.y[it1] 的东西变量* 同时,D.y[it2] 也可以作为 D.y[it1] 的东西变量use abdata.dta, cleardes /*变量的定义*/tsset id year* 模型: n_it = b1*n_it1 + b2*n_it2* + b3*w_it + b4*w_it1* + b5*k_it + b6*k_it1 + b7*k_it2* + b8*ys_it + b9*ys_it1 + b10*ys_it2*xtivreg n L2.n w L1.w k L1.k L2.k ys L1.ys L2.ysyr1981yr1984 ///(L.n = L3.n), fd** 等价于*xtivreg n L2.n L(0/1).w L(0/2).(k ys) yr1981yr1984 (L.n = L3.n), fd*====================================*========= 一阶差分GMM估量量 =========*==============AB91==================** L.Hansen (1982) 提出 GMM** Arellano and Bond (1991)** 模型:** y[it] = a0*y[it1] + a1*x[it] + a2*w[it] + u_i + v[it]** 假定条件:* 搅扰项 v[it] 不存在序列相关;** 适用范围:* 大N,小T* 随后,我们会介绍“小N大T”型动态面板的估量办法** 根本思想:** 在 Anderson and Hisao(1982) 根本上增加了更多可用的东西变量** 在 t=3 处,y_i1 可以作为所有滞后项的东西变量* 在 t=4 处, y_i1, y_i2 可以作为所有滞后项的东西变量** D.y[it] = a1*D.y[it1] + a2*D.X[it] + D.v[it] X_it = [x_it, w_it] ** 因此,所有东西变量组成的矩阵如下:** |y_i1 0 0 0 0 0 ... 0 ... 0 D.x_i3 |* | 0 y_i1 y_i2 0 0 0 ... 0 ... 0 D.x_i4 |* | 0 0 0 y_i1 y_i2 y_i3 ... 0 ... 0 D.x_i5 |* Z_i = | . . . . . . . . . . . |* | . . . . . . . . . . . |* | 0 0 0 0 0 0 ... y_i1 ... yiT2 D.x_iT |** Z_i 的行数为 T2* Z_i 的列数为 sum_(m=1)^(T2){m} + K, K 为 X 的列数** 以 T =7,K=3 为例,则 Z_i 的列数为 (1+2+3+4+5)+3 = 18 ** 设定东西变量的基来源根底则:** 对内生变量的处理:与上述办法类似,* 即滞后两阶以上的水平变量均可作为差分方程的东西变量 (GMM type)* 对先决变量的处理:滞后一阶以上的水平变量均可作为东西变量 (GMM type)* 对外生变量的处理:自己作为自己的东西变量 (Standard IV) *== 例1:一阶差分估量量的根本设定* 解释变量仅包含 y_it 的一阶滞后项,默认设定* 搅扰项同方差,一阶段估量use abdata.dta, clearxtabond n L(0/1).w L(0/2).(k ys) yr1980yr1984est store ab_0* 结果释疑** 1 东西变量的个数是如何确定的?(xtdpd, p.74)** 外生变量的东西变量等于外生变量的个数* L(0/1).w L(0/2).(k ys) yr1980yr1984 共 13个* 内生变量的东西变量:共 27个*list id year n L2.n DL2.n if id == 140** 差分方程的可用东西变量** year of Years of Number of* difference equation instruments instruments* 1978 1976 1* 1979 19761977 2* 1980 19761978 3* 1981 19761979 4* 1982 19761980 5* 1983 19761981 6* 1984 19761982 7** 28个* 2 GMMtype 和 Standard 两种类型的东西变量有何差别?(xtabond,p.27)** GMMtype 是针对内生变量或先决变量而言的东西变量,有多列* Standard 是针对外生变量而言的东西变量,只有一列* 过度识别查验(东西变量的使用是否公道)*estat sargan** 说明:* H0: overidentifying restrictions are valid* 这里,我们拒绝了原假定,但AB91指出,当搅扰项存在异方差时,* Sargan查验倾向于过度拒绝原假定,因此此处得到的结论其实不成信.* 采取两阶段估量,然后再执行Sargan查验较为稳妥:*xtabond n L(0/1).w L(0/2).(k ys) yr1980yr1984,twostepestat sargan** 说明:不过,AB91发明,* 若存在异方差,在两阶段估量后执行Sargan查验往往倾向于* Underreject问题,即过度接受原假定.* 通常而言,这极可能是我们的模型设定不当,或是东西变量的选择不公道.* 搅扰项序列相关查验** AB91 一阶差分估量量要求原始模型的搅扰项不存在序列相关,* 显然,差分后的搅扰项必定存在一阶序列相关,* 因此,我们需要查验差分方程的残差是否存在二阶(或更高阶)序列相关便可** 默认,二阶序列相关查验xtabond n L(0/1).w L(0/2).(k ys) yr1980yr1984,vce(robust)estat abond* 说明:若存在二阶相关,则意味着选取的东西变量不公道 * 高阶序列相关查验xtabond n L(0/1).w L(0/2).(k ys) yr1980yr1984,vce(robust) artest(3)estat abond*== 稳健型估量xtabond n L(0/1).w L(0/2).(k ys) yr1980yr1984, lags(2) robustest store ab4_one_rb* 此时,无法 Sargan 统计量estat sargan*== 两阶段估量 AB91(Tab4(a2)) 考虑异方差问题* 利用第一阶段估量得到的残差机关方差协方差矩阵,进而重新估量模型*xtabond n L(0/1).w L(0/2).(k ys) yr1980yr1984, lags(2) twostep est store ab4_twostep* 此时,Sargan 查验无法拒绝原假定*estat sargan* AB91重要建议:* (1) 采取一阶段估量结果进行系数显著性的统计推断;* (2) 采取两阶段估量给出的 Sargan统计量进行模型筛选** 进一步的讨论:* 虽然AB91建议不要采取两阶段(非稳健)估量进行统计推断,* 但Windmeijer(,Journal of Econometrics)通过模拟阐发标明,* 采取纠偏(biascorrected,WC)后的稳健性VCE,可以更好地进行统计推断xtabond n L(0/1).w L(0/2).(k ys) yr1980yr1984, lags(2) twostep vce(robust)est store ab_wc_rb* 结果对比local mm "ab4_one_rb ab4_twostep ab_wc_rb"esttab `mm',mtitle(`mm')** 结论:* AB91_onestep_rb 的结果与 AB91_WC_rb 的参数估量相同,后者尺度误较大* 建议采取 Windmeijer() 两阶段纠偏稳健型估量量.*== 先决变量的设定* 由于当期搅扰项显然会影响后续 w 和 k,所以把它们设定为先决变量更加公道* 注意: 此时逗号前就不克不及再出现这两个变量了xtabond n L(0/1).ys yr1980yr1984, lags(2) twostep ///pre(w k)est store ab4_preestat sargan* 从 Sargan p值来看,将 w 和 k 设为先决变量似乎更加公道 * pre() 选项的设定xtabond n L(0/1).ys yr1980yr1984, lags(2) twostep ///pre(w,lag(1,3)) pre(k,lag(2,.))** 解释:* pre(w,lag(1,3))* lag(1,3) 中的 1 暗示 L.w 也会作为解释变量,* lag(1,3) 中的 3 暗示 L2.w 和 L3.w 可以作为 L.w 的东西变量,但 L4.w 不成以;* pre(k,lag(2,.))* lag(2,.) 中的 2 暗示 L1.k, L2.k 都会作为解释变量;* lag(2,.) 中的 . 暗示 L3.k, L4.k ... 都可以作为 L2.k 的东西变量* 说明:上述设定都可附加 vce(robust) 选项以便取得稳健型尺度误.*== 东西变量过量导致的问题* 过量的东西变量往往导致过度约束假定无法满足* 估量结果的有效性下降,因为部分东西变量与内生或先决变量的相关性很弱* 对矩阵尺寸的要求增加* 解决办法:限制最大的滞后阶数xtabond n L(0/1).ys yr1980yr1984, lags(2) twostep ///pre(w,lag(1,3)) pre(k,lag(2,3))*== 系数估量的上下限* 虽然 Pooled OLS 和 Fixed Effects 估量都是有偏的,* 但是两者却决定了 y_it1 真是估量值的上界和下界* 换言之, Pooled OLS 估量高估了真实值* 而 Fixed effects 估量则低估了真实值*=======================================*============= 系统GMM估量量 ===========*==============AB95,BB98===============*=======================================* Arellano and Bover (1995),* Blundell and Bond(1998)* Haha(1999), Judson and Owen(1999)** 适用范围:* 大N,小T** AB91 的局限* (1) 当 y[i,t1] 的系数较大,即 y[i,t] 表示出强烈的序列相关时;* (2) 当 Var[u_i]/Var[e_it] 较大时,即个别效应的动摇远大于常规搅扰项的动摇;* AB91 的表示欠佳.* 原因在于,水平滞后项是差分方程中内生变量的弱东西变量;* 因此,需要寻求更佳的东西变量**== 根本思想:** 几个概念** 水平值—— y x* 水平方程:y_it = b1*y_it1 + b2*x_it + u_i + v_it* 可用东西变量:D.y[i,t1] 可以作为 y[i,t1] 的东西变量* 可用东西变量:y[i,t2],y[i,t3]...都可以作为 D.y[i,t1]的东西变量** 差分GMM估量量与系统GMM估量量的区别** (1) 差分GMM估量量采取水平值的滞后项作为差分变量的东西变量;* 如 y_it3 是 D.y_it1 的东西变量* (2) 系统GMM估量量进一步采取差分变量的滞后项作为水平值的东西变量;* 相当于进一步增加了可用的东西变量,* 且估量进程中同时使用水平方程和差分方程* (3) 主要原因在于差分GMM的东西变量往往是弱东西变量,即 corr(X,Z) 太低** xtabond2 命令Roodman()** 既可以估量差分 GMM 估量量,也可以估量系统 GMM 估量量;* 同时可以估量一般化的回归模型* 提供两阶自相关查验,Sargan查验,Hansen查验,以及东西变量外生性查验** xtdpdsys 命令 Stata官方命令,以 xtabond2命令为根本** xtabond2 命令** 适用于 Stata810 各个版本* 既可以完成一阶差分GMM估量* 也可以完成系统GMM估量* 详细参考资料:* Roodman, D. . How to Do xtabond2:* An Introduction to "Difference" and "System" GMM in Stata. * Working Paper 103. Center for Global Development, Washington.*== 使用 xtabond2 命令得到一阶差分估量量* 附加 noleveleq 选项便可* 采取 xtabond2 估量 AB91 文中表4 的结果* Arellano and Bond (1991), Table 4* Column (a1)use abdata, clearxtabond2 n L(1/2).n L(0/1).w L(0/2).(k ys) yr1980yr1984, ///gmm(L.n) iv(L(0/1).w l(0/2).(k ys) yr1980yr1984) /// nomata noleveleq small* gmm(*) 填写内生变量的名称* iv(*) 填写所有外生变量以及自己设定的东西变量的名称* noleveleq 暗示估量进程中不使用水平方程,即为差分GMM估量量est store aba1_ab2xtabond n L(0/1).w L(0/2).(k ys) yr1980yr1984, lags(2)est store aba1_abesttab aba1_ab2 aba1_ab, mtitle(aba1_ab2 aba1_ab)* Column (a2)* 两阶段估量xtabond2 n L(0/1).w L(0/2).(k ys) L(1/2).n yr1980yr1984, /// gmm(L.n) iv(L(0/1).w l(0/2).(k ys) yr1980yr1984) /// noleveleq small twostepest store aba2_ab2xtabond n L(0/1).w L(0/2).(k ys) yr1980yr1984, lags(2) twostep est store aba2_abesttab aba2_ab2 aba2_ab, mtitle(aba2_ab2 aba2_ab)*=== 一阶差分估量量部分化释变量内生* 一阶段估量xtabond2 n L.n L(0/1).(w k) yr1980yr1984, ///gmm(L.(w k n)) iv(yr1980yr1984) ///noleveleq noconstant small robustest store fd_1s* 两阶段估量xtabond2 n L.n L(0/1).(w k) yr1980yr1984, ///gmm(L.(w k n)) iv(yr1980yr1984) ///noleveleq robust small twostepest store fd_2sesttab fd_1s fd_2s, mtitle(fd_1s fd_2s)*== 系统 GMM 估量量xtabond2 n L.n L(0/1).(w k) yr1978yr1984, ///gmm(L.n) iv(L(0/1).(w k) yr1978yr1984) ///robust small** 解释:** gmm() 选项* 设定内生变量和先决变量,它们的东西变量将有多列,GMM** iv() 选项* 设定严非分特别生变量,作为自己的东西变量,在东西变量矩阵中仅占一列** 差分方程和水平方程* 默认情况下,差分方程和水平方程都介入估量** robust 选项* (1) 对于一阶段估量(不附加twostep选项),* 采取传统异方差序列相关稳健型估量量计较尺度误;* (2) 对于两阶段估量(附加twostep选项),* 采取Windmeijer()纠偏估量量计较尺度误;* Sargan查验* Sargan test of overid. restrictions: chi2(34)* 34 = 47 13 (13是外生变量的个数,包含常数项)* 可见,无论采取Sargan查验仍是Hansen J查验,都拒绝了东西变量公道的原假定* 指定东西变量应用于水平方程仍是差分方程* 例如,假定 w, k, 以及年度虚拟变量都是外生的(当然,这一假定可能其实不公道)*xtabond2 n L.n L(0/1).(w k) yr1978yr1984, gmm(L.n) ///iv(L(0/1).(w k) yr1978yr1984, eq(level)) ///robust small twostepest store sys_wkexg* 将 w 和 k 都设定为内生变量* yr dummies 仅出现在水平方程中xtabond2 n L.n L(0/1).(w k) yr1978yr1984, ///gmm(L.(w k n)) iv(yr1978yr1984, eq(level)) ///robust small twostepest store sys_wkendog_lev* yr dummies 同时出现在水平方程和差分方程中xtabond2 n L.n L(0/1).(w k) yr1978yr1984, ///gmm(L.(w k n)) iv(yr1978yr1984, eq(both)) ///robust small twostepest store sys_wkendog_both* 结果对比local mm "fd_1s fd_2s sys_wkexg sys_wkendog_levsys_wkendog_both"esttab `mm', mtitle(`mm') compress** xtdpdsys 命令** 仅适用于 Stata10 版本* 中国上市公司资本结构动态调整use xtcs.dta, clearqui tab year, gen(yr)drop yr1* Case I:假定所有解释变量均为外生变量(L.tl除外)*local xx "size tang ndts L(0/1).tobin L(0/1).npr yr*"xtdpdsys tl `xx', vce(robust) twostepdis ln(2) / (1 _b[L1.tl]) /*调整半周期*/est store dycs_2sys* 设定说明:* (1) 无需设定 L.tl, 因为 xtdpdsys 默认设定被解释变量的滞后一期为解释变量,* 并且该变量被自动设定为内生变量;* (2) 稳健型估量采取 vce(robust) 选项加以设定;* (3) 该命令不会自动进行 AR(2)序列相关查验和Sargan过度识别查验* 序列相关查验estat abond* 过度识别查验estat sargan /*稳健型估量下无法取得Sargan统计量*/* 正确办法local xx "size tang ndts L(0/1).tobin L(0/1).npr yr*"xtdpdsys tl `xx', twostepestat sargan* Case II:假定Tobin和npr为先决变量local xx "size tang ndts yr*" /*此处不该再包含 tobin和npr*/ xtdpdsys tl `xx', pre(tobin npr,lag(1,.)) twostepest store dycs_2preestat abondestat sargan* Case III:假定Tobin和npr为内生变量local xx "size tang ndts yr*" /*此处不该再包含 tobin和npr*/ xtdpdsys tl `xx', endog(tobin npr,lag(1,.)) twostepest store dycs_2endogestat abondestat sargan* Case IV: 假定除了年度虚拟变量和公司范围外,所有解释变量均为先决变量local xx "size yr*"xtdpdsys tl `xx', pre(tobin npr,lag(1,.)) ///pre(tang ndts) twostepest store dycs_2preAllestat abondestat sargan* 假定除 L.tl 外的所有解释变量外生最为适合.* OLS 估量(调整系数的上限)local xx "size tang ndts L(0/1).tobin L(0/1).npr yr*"reg tl L.tl `xx', robustest store dycs_2OLS* FE 估量(调整系数的下限)local xx "size tang ndts L(0/1).tobin L(0/1).npr yr*"xtreg tl L.tl `xx', robust feest store dycs_2FE* 结果对比local mm "dycs_2sys dycs_2pre dycs_2endog dycs_2preAll dycs_2OLS dycs_2FE"local ss "ar2 ar2p sargan sar_df sarganp"esttab `mm',mtitle(`mm') scalar(`ss') compress* 结论:* (1) 估量出的调整系数介于公道的范围内,即OLS和FE之间;* (2) 就模型设定而言,dycs_2sys 最为公道,即把所有解释变量均设定为外生变量.** 调整半周期为:local xx "size tang ndts L(0/1).tobin L(0/1).npr yr*"xtdpdsys tl `xx', vce(robust) twostepdis ln(2) / (1 _b[L1.tl]) /*调整半周期*/xtabond2 logy l.logy h inv gov open fdi yr4yr14, ///gmm(l.logy h) iv(gov open fdi yr4yr14)robust twostep。