
算法的收敛性和收敛速度的定义式
gradf( x1 , x2 )
P
f ( x, y) c1
x1
梯度为等高线上的法向量
f ( x1 , x2 ) c
等高线
o
3、方向导数和梯度的关系 根据矢量代数的概念,方向导数的表达式可写 成:
西 南 科 技 大 学 网 络 教 育 系 列 课 程
f ( X ( k ) ) (k ) T f ( X ) S S
2 2 | PP | (Dx ) + (Dy ) ,
且 Dz f ( x + Dx, y + Dy ) f ( x, y ) 考虑
Dzபைடு நூலகம்
当 P 沿着 l 趋于 P 时,
lim
0
f ( x + Dx, y + Dy ) f ( x, y )
是否存在?
定义 函数的增量 f ( x + Dx, y + Dy ) f ( x, y )与 PP/ 两点间的距离 ( Dx )2 + ( Dy )2 之比值,
f ( X ( 2 ) ) 0 2 + 2 2 2
西 南 科 技 大 学 网 络 教 育 系 列 课 程
单位梯度的向量为:
S
(1)
f ( X (1) ) 1 (1) f ( X ) 2 2
2 2 / 2 2 2 / 2
S (2)
沿着x 轴负向、 y 轴负向的方向导数是 f x , f y .
2)方向导数的计算 定理 如果函数z f ( x , y ) 在点P ( x , y ) 是可微分 的,那么函数在该点沿任意方向 L 的方向导数都 存在,且有
其中 j 为 x 轴到方向 L 的转角。 证明
f f f , cos j + sin j l x y
其中 a12 a21 ,于是梯度为
f ( X ) x a x + a x + b a a x b 1 f ( X ) 11 1 12 2 1 11 12 1 + 1 f ( X ) a 21 x1 + a 22 x2 + b2 x2 b2 a 21 a 22 x 2
这说明,与梯度成锐角的方向是函数值上升 的方向,而与梯度成钝角的方向则是函数值下降 的方向。
西 南 科 技 大 学 网 络 教 育 系 列 课 程
综上所述,函数的梯度具有以下性质 (1)函数在一点的梯度是一个向量。梯度的方向 是该点函数值上升得最快的方向,梯度的大小就是 它的模长。 (2) 一点的梯度方向为过该点的等值线或等值 面的切线或切平面相垂直的方向,或者说是该点等 值线或等值面的法线方向。 (3) 梯度是函数在一点邻域内局部性态的描述。 在一点上升得快的方向,离开该领域后就不一定上 升得快,甚至可能下降。
西南科技大学网络教育系列课程
5. 优 化 设 计
5.2 优化方法的数学基础
5.2.1函数的方向导数和梯度
1、函数的方向导数
实例:一块长方形的金属板,四个顶点的坐 标是(1,1),(5,1),(1,3),(5,3)。在坐标原点处有 一个火焰,它使金属板受热。假定板上任意一点 处的温度与该点到原点的距离成反比。在(3,2)处 有一个蚂蚁,问这只蚂蚁应沿什么方向爬行才能 最快到达较凉快的地点? 问题的实质:应沿由热变冷变化最剧烈的方 向(即梯度方向)爬行.
当方向S与梯度方向的夹角为锐角时有:
f ( X ( k ) ) (k ) T f ( X ) S 0 S
当方向S与梯度方向的夹角为钝角时有:
T f ( X ( k ) ) f ( X ( k ) ) S 0 S
西 南 科 技 大 学 网 络 教 育 系 列 课 程
西 南 科 技 大 学 网 络 教 育 系 列 课 程
2、 梯度 1)梯度的定义 函数在点X( k)的梯度是由函数在该点的各个 一阶偏导数组成的向量。 2)梯度的表达式
f ( X
(k )
f ( X ) f ( X ) f ( X ) ) , , , x x x 1 2 n
(k ) (k ) (k )
T
结论 函数在某点的梯度是这样一个向量,它的 方向与取得最大方向导数的方向一致, 而它的模为 方向导数的最大值。梯度的模为 gradf
f f gradf ( x1 , x2 ) x + x 1 2
2 2
f ( X ( k ) ) f ( X ( k ) ) S
从图中可以看出: 当方向S与点X( k)的梯度相垂直时,函数在该 点沿S的方向导数等于零,即
西 南 科 技 大 学 网 络 教 育 系 列 课 程
f ( X ( k ) ) f ( X ( k ) ) S
T
S 0
P
f x 轴到梯度的转角的正切为 tan x2 f x1
f 不为零时, 当 x
gradf
在几何上 z f ( x1 , x2 ) 表示一个曲面
曲面被平面 z
c
z f ( x1 , x2 ) 所截得 , z c
所得曲线在xoy面上投影如图
x2
f ( x1 , x2 ) c2
f f ( x + Dx, y + Dy, z + Dz ) f ( x, y, z ) lim , 0 l
2 2 2 ( D x ) + ( D y ) + ( D z ) 其中
设方向 L 的方向角为 , ,
Dx cos , Dy cos , Dz cos ,
西 南 科 技 大 学 网 络 教 育 系 列 课 程
1)方向导数的定义 讨论函数 z f ( x , y ) 在一点P沿某一方向 的变化率问题.
设函数z f ( x , y )在点 P ( x , y ) 的某一邻域 U ( P ) 内有定义,自点 P 引射线 l。 设 x 轴正向到射线 l 的转角 / j , P 为 并设 ( x + Dx , y + Dy ) 为 l 上的另一点且 P/ U ( p/). (如图)
cosj
sin j
f f ( x + Dx, y + Dy ) f ( x, y ) lim l 0 f f cos j + sin j . x y
推广可得三元函数方向导数的定义
对于三元函数 u f ( x , y , z ),它在空间一点 P ( x , y , z ) 沿着方向 L 的方向导数 ,可定义 为
B b1 b2
C为常数,求梯度 f ( X ) 。
5.2.1 函数的方向导数和梯度
解:将二元二次函数的矩阵式展开
1 2 f ( X ) ( a11 x12 + 2a12 x1 x2 + a 22 x2 ) + b1 x1 + b2 x2 + C 2
西 南 科 技 大 学 网 络 教 育 系 列 课 程
(k ) (k ) (k )
2
2
2
f ( X ( k ) ) f ( X ( k ) ) cos f ( X ( k ) ), S S 由上式表明:函数在某点沿方向S的方向导数 等于该点的梯度在方向身上的投影。见下图。
西 南 科 技 大 学 网 络 教 育 系 列 课 程
当方向S与梯度的 夹角为零时,方向 导数达到最大值, 即
f ( X ( k ) ) S cos f ( X ( k ) ), S
S cos 2 1 + cos 2 2 + + cos 2 n 1
f ( X
(k )
f ( X ) f ( X ) f ( X ) ) + + + x x x 1 2 n
图5.11 例1的梯度
5.2.1 函数的方向导数和梯度
例题2 一般二元二次函数的矩阵式为
1 T f ( X ) X AX + B T X + C 2
西 南 科 技 大 学 网 络 教 育 系 列 课 程
,其中
X x1 x2
a11 a12 A a21 a22
cos1 cos (k ) (k ) (k ) f ( X ) f ( X ) f ( X ) 2 (k ) T , , , [ f ( X )] S x 2 x n : x1 cos n
西 南 科 技 大 学 网 络 教 育 系 列 课 程
同理:当函数在此点可微时,那末函数在该点 沿任意方向 L 的方向导数都存在,且有
f f f f cos + cos + cos . l x y z
推导出n元函数f(x)在点X( k)处沿任意给定方 向S的方向导数 表达式为:
f ( X ( k ) ) f ( X ( k ) ) f ( X ( k ) ) f ( X ( k ) ) cos1 + cos 2 + + cosn S x1 x 2 x n
f f f ( x + Dx, y + Dy ) f ( x, y ) Dx + Dy + o( ) x y
两边同除以 , 得到
由于函数可微,则增量可表示为
f ( x + Dx , y + Dy ) f ( x , y )
7.2 迭代法及其收敛性

k4.1045
1/ 2
表 7.2.1 用不动点迭代法计算例7.2.1的结果
0 (a) 1.5 -0.625 6.447 -378.2 5.3697e7 -1.547e23 (b) 1.5 0.912871 2.454577 (c) (d) (e) 1.5 1.5 1.5 1.241638702 1.333333333 1.365079365 1.424290116 1.305205188 1.387624336 1.332682451 1.370291856 1.344991115 1.362217505 1.350582520 1.358732441 1.355350555 1.354767869 1.355301399 1.355384418 1.355301398 1.355288480 1.355303407 1.355301085 1.355301446 1.355301390
*
k
xk x L x0 x L max x0 a , b x0 ,
* k * k
从而 7.2.4 成立.
再由 7.2.3 , 对m k 1, 我们有
x m x k x m x m 1 x m 1 x m 2 x k 1 x k x m x m 1 x m 1 x m 2 x k 1 x k Lm 1 x1 x0 Lm 2 x1 x0 Lk x1 x0 Lk x1 x0 1 L L2 Lm k 1 .
(7.2.1)
其中 ( x )为连续函数,其取法不唯一,例如可取
方程(7.2.1)的解称为函数 ( x )的不动点, 求方程 (7.2.1)的解的问题称为不动点问题.
迭代下降算法概述-最优化方法

四.算法的收敛性
收敛性:下降迭代算法的收敛性,是指某种
迭代程序产生的迭代序列 Xk k 0,1, 2,…
收敛于 lim X k X k1
收敛速度:
(1)线性收敛速度( =1)
(2)超线性收敛速度(1< < 2)
(3)二阶收敛速度( =2)
四.算法的收敛性
初始点X1
新的点X2
1.目标函数值:f(X1)> f(X2) > f(X3) > f (X4)…
2.f:算法规则
初始点X2
3.点列:{Xi},i=1,2…n
新的点X3
4.Xn趋于极小点或期望的其他点(平稳点或K-T点)
初始点X3
新的点X4
一.算法的基本格式
2.基本格式:
X k 1 X k k Pk
(1)线性收敛速度
一阶收敛不一定是线性收敛
四.算法的收敛性
(2) 阶收敛速度
设某算法产生的点列 Xk收敛于X,若存
在正数 k0 ,有以及与k无关的 >0, >1,使
得当k> k0 时,恒有
Xk1 Xk Xk X 称此算法具有 阶收敛速度。
二次函数时,都能在有限步内达到极小点,则称此 算法具有收敛性。
有限收敛性(二次收敛性)指一个算法用于具有正 定矩阵的二次函数 f (X ) 1 X T AX bT X C 在有限步可
2
以达到它的极小值,具有线性以上的收敛,收敛速 度较快。
f (Xk P)PT 0 XK1 Xk P
二.最优步长的性质
由于 k 是最优步长,故 是 X k1 f ( X )在过点 X k1
计算科学中的迭代和收敛性分析

计算科学中的迭代和收敛性分析在计算科学中,迭代和收敛性分析是两个常见的概念。
迭代是指通过重复执行一定的计算过程来逐步逼近所要求解的问题的方法。
而收敛性则是评估所得解与真实解之间的误差以及迭代过程中的精度变化。
迭代方法在计算科学中的应用非常广泛。
例如,在求解非线性方程和求解常微分方程等问题中,常用的方法都是迭代法。
迭代法的基本思想是从初始条件开始,逐步逼近所要求解的问题。
具体操作时,首先需要选定一个初始值,然后通过一定的迭代公式进行计算,得到一个新的值,并将其作为下一次迭代时的初始值。
如此重复执行,直到所求解的问题达到所期望的精度要求为止。
然而,迭代方法并不总是能够收敛到所要求的真实解。
这就引出了收敛性分析的问题。
收敛性指的是迭代方法是否在无限迭代的情况下,能够收敛到真实解。
如果能够收敛,那么我们还需要考虑的是其收敛速度,即迭代过程中精度变化的规律。
在实际应用中,迭代法的收敛性和收敛速度是非常重要的问题,因为它们直接影响到所得结果的可靠性和计算效率。
因此,在迭代法的设计和评估中,收敛性分析是一个非常重要的环节。
收敛性分析的方法很多。
其中,最常用的方法是通过构造数值序列来评估迭代法的收敛性和收敛速度。
构造数值序列可以通过一系列数学技巧和推导来实现。
对于线性问题,可以通过构造矩阵和向量来实现数值序列的构造。
而对于非线性问题,一般需要考虑一些特定的方法,如牛顿迭代法、欧拉迭代法等。
除了构造数值序列外,在收敛性分析中还有一些其他的方法。
例如,可以考虑迭代法的局部收敛性和全局收敛性。
局部收敛性是指迭代法在某一点附近是否收敛。
这个问题往往可以通过利用泰勒级数来解决。
而全局收敛性则是指迭代法是否对任意的初始值都能收敛。
这个问题的解决通常需要使用一些特定的技巧和算法,例如逐步缩小逼近区间法。
总之,迭代和收敛性分析是计算科学中常见的概念,对于许多实际问题的求解都有重要的应用价值。
通过对迭代法的设计、评估和分析,我们可以帮助提高计算效率和解决实际问题,为科学研究和工程应用做出贡献。
计算方法实验指导书
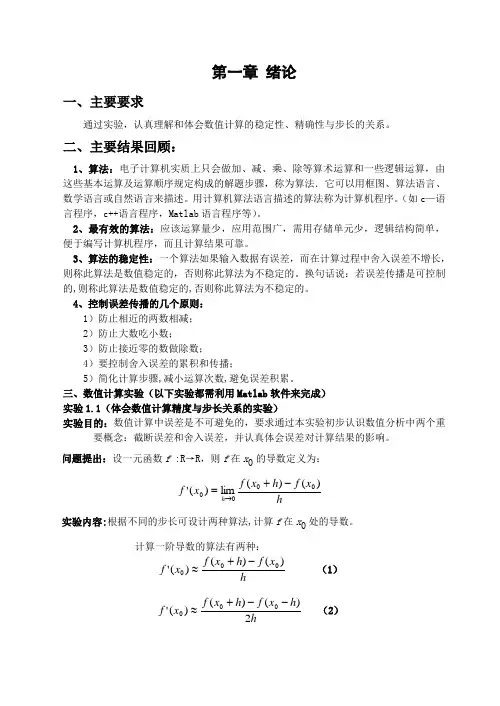
第一章 绪论一、主要要求通过实验,认真理解和体会数值计算的稳定性、精确性与步长的关系。
二、主要结果回顾:1、算法:电子计算机实质上只会做加、减、乘、除等算术运算和一些逻辑运算,由这些基本运算及运算顺序规定构成的解题步骤,称为算法.它可以用框图、算法语言、数学语言或自然语言来描述。
用计算机算法语言描述的算法称为计算机程序。
(如c —语言程序,c++语言程序,Matlab 语言程序等)。
2、最有效的算法:应该运算量少,应用范围广,需用存储单元少,逻辑结构简单,便于编写计算机程序,而且计算结果可靠。
3、算法的稳定性:一个算法如果输入数据有误差,而在计算过程中舍入误差不增长,则称此算法是数值稳定的,否则称此算法为不稳定的。
换句话说:若误差传播是可控制的,则称此算法是数值稳定的,否则称此算法为不稳定的。
4、控制误差传播的几个原则: 1)防止相近的两数相减; 2)防止大数吃小数;3)防止接近零的数做除数;4)要控制舍入误差的累积和传播;5)简化计算步骤,减小运算次数,避免误差积累。
三、数值计算实验(以下实验都需利用Matlab 软件来完成) 实验1.1(体会数值计算精度与步长关系的实验)实验目的:数值计算中误差是不可避免的,要求通过本实验初步认识数值分析中两个重要概念:截断误差和舍入误差,并认真体会误差对计算结果的影响。
问题提出:设一元函数f :R →R ,则f 在x 0的导数定义为:hx f h x f x f h )()(lim)('0000-+=→实验内容:根据不同的步长可设计两种算法,计算f 在x 0处的导数。
计算一阶导数的算法有两种:hx f h x f x f )()()('000-+≈(1)hh x f h x f x f 2)()()('000--+≈(2)请给出几个计算高阶导数的近似算法,并完成如下工作: 1、对同样的h ,比较(1)式和(2)式的计算结果;2、针对计算高阶导数的算法,比较h 取不同值时(1)式和(2)式的计算结果。
数值分析10迭代法的收敛性分析
研究方向
进一步深入研究迭代法的收敛性,探索更有 效的迭代公式和算法,以提高收敛速度和稳 定性。
展望
随着计算技术的发展,迭代法在数值分析中 的应用将更加广泛,其收敛性分析将为解决 实际问题提供更有力的支持。同时,随着数 学理论的发展,迭代法的收敛性分析将更加 深入和完善。
感谢您的观看
THANKS
例如,梯度下降法和牛顿法是两种常见的求解优化问 题的迭代法。通过收敛性分析,可以发现梯度下降法 在一般情况下是收敛的,但可能会遇到收敛速度较慢 或者不收敛的情况;而牛顿法在一般情况下也是收敛 的,且收敛速度可能比梯度下降法更快。因此,在实 际应用中,可以根据问题的具体情况选择合适的迭代 方法。
06
迭代法收敛的充要条件
迭代法收敛的充要条件是迭代矩阵的谱半径小于1。谱半径是迭代矩阵所有特征值的模的最大值。
收敛性的判定方法
可以通过计算迭代矩阵的特征值来判断迭代法的收敛性,也可以通过迭代矩阵的范数来近似判断。
收敛速度的度量
01
02
03
迭代次数
迭代次数是衡量收敛速度 的一个直观指标,迭代次 数越少,收敛速度越快。
在非线性方程求解中的应用
非线性方程的求解是数值分析中的另一个重 要问题,迭代法也是求解非线性方程的重要 方法之一。与线性方程组求解类似,收敛性 分析在非线性方程求解中也有着重要的作用 。通过收敛性分析,可以判断迭代法的收敛 速度和收敛性,从而选择合适的迭代方法和 参数,提高求解效率。
算法的收敛性和收敛速度的定义式

5.2.1 函数的方向导数和梯度
例题2 一般二元二次函数的矩阵式为
1 T f ( X ) X AX + B T X + C 2
西 南 科 技 大 学 网 络 教 育 系 列 课 程
,其中
X x1 x2
a11 a12 A a21 a22
f ( X ( 2 ) ) 0 2 + 2 2 2
西 南 科 技 大 学 网 络 教 育 系 列 课 程
单位梯度的向量为:
S
(1)
f ( X (1) ) 1 (1) f ( X ) 2 2
2 2 / 2 2 2 / 2
S (2)
f ( X ( k ) ) S cos f ( X ( k ) ), S
S cos 2 1 + cos 2 2 + + cos 2 n 1
f ( X
(k )
f ( X ) f ( X ) f ( X ) ) + + + x x x 1 2 n
f ( X ( k ) ) f ( X ( k ) ) S
从图中可以看出: 当方向S与点X( k)的梯度相垂直时,函数在该 点沿S的方向导数等于零,即
西 南 科 技 大 学 网 络 教 育 系 列 课 程
f ( X ( k ) ) f ( X ( k ) ) S
T
S 0
这说明,与梯度成锐角的方向是函数值上升 的方向,而与梯度成钝角的方向则是函数值下降 的方向。
西 南 科 技 大 学 网 络 教 育 系 列 课 程
最优化方法-迭代下降算法概述
四.算法的收敛性
X k1 X k X k X
(1) 1 ,算法具有线性收敛速度
(2) 1 2 ,算法具有超线性收敛速度
(3) 2 ,算法具有二阶收敛速度
四.算法的收敛性
定义 3.16(有限收敛性或二次收敛性): 若将某种算法应用与任意一个具有正定Hesse矩阵的
二.最优步长的性质
设无约束极小化问题为:min f(X),X E n
二、最优步长的性质
2.几何意义:
f ( X k P)PT 0 X K 1 X k P
二.最优步长的性质
由于 k 是最优步长,故 是 X k1 f ( X )在过点 X k1
而与搜索方向 Pk 平行的直线L上的极小点。因
算法产生的点列通常只是其极限属于某个指定的解 集,须规定一些准则,使得计算经过有限次迭代后 在满足过给的准则的条件下终止。
三.计算过程的终止
终止准则
(1)梯度准则:目标函数在迭代点的梯度的 模达到充分小,即 f (Xk ) (2)点距准则:两个迭代之间的距离充分
小,即
X km X k 2 或比值
迭代下降算法概述
本节主要内容
一.算法的基本格式 二.最优步长的性质 三.计算过程的终止 四.算法的收敛
本章的目的和要求
掌握算法的基本格式 熟悉最优步长的性质 知道计算过程的终止准则 了解算法的收敛性
一.算法的基本格式
定义 1 基本格式 2
一.算法的基本格式
1.定义(下降迭代算法):从某个初始点出 发,根据一定的算法规则,产生一个是目标 函数值有所下降的新的点;再从这个新的点 出发,重复上述过程,这样可以得到一个点 列,在一定的条件下,这个点列将趋于极小 点或我们所期1)线性收敛速度
2.2 迭代法
x k +1 = 3 x k + 1
计算结果如下: 计算结果如下:
k=0,1,2,3…….
计算方法
k 0 1 2 3 4
xk
1.5 1.35721 1.33086 1.32588 1.32494
k 5 6 7 8
xk
1.32476 1.32473 1.32Байду номын сангаас72 1.32472
精确到小数点后五位
x = 1.32472
′( x* ) = ϕ ′′( x* ) = L = ϕ ( p−1) ( x* ) = 0, ϕ ( p ) ( x* ) ≠ 0 ϕ 邻域是p阶收敛的。 则迭代过程在 x * 邻域是p阶收敛的。
证: 由于 ϕ ′( x * ) = 0 * ′( x* ) < 1 , 即在 x 邻域 ϕ ϕ ( xk ) 在 x * 处 有局部收敛性, 所以 xk+1 = ϕ( xk ) 有局部收敛性, 将 泰勒展开
计算方法
一、迭代法的基本思想: 迭代法的基本思想: 为求解非线性方程f(x)=0的根,先将其写成便于 的根, 为求解非线性方程 的根 迭代的等价方程
x = ϕ ( x)
的连续函数。 其中ϕ ( x ) 为x的连续函数。 的连续函数
(2.3)
计算方法
即如果数 α 使 f(x)=0, 则也有 α = ϕ (α ) , 反之, 反之, 若α = ϕ (α ) ,则也有 f (α ) = 0 的右端, 任取一个初值 x ,代入式 x = ϕ ( x ) 的右端, 得到 0
ϕ ′( x ) ≤ L < 1
计算方法
则对于任意的初始值 x0 ∈ S ,由迭代公式 收敛于方程的根。 产生的数列 { xn } 收敛于方程的根。 (这时称迭代法在 α 的S邻域具有局部收敛性。) 邻域具有局部收敛性。)
Newton法的局部收敛性
另外也可能不收敛, 或者不是收敛到离初值最近的根. 当然, 对于三次 函数, 除了个别点, 牛迭总是收敛到某个根的, 因为初值远离原点时由 于函数的单调性, 总会被拉回"局部".
事实上在复平面上三次函数的根的牛迭收敛行为是个著名的分形 ...足 见全局收敛性的复杂.
定义6.2
设迭代过程xk 1 ( xk )收敛于方程x ( x)的根x*, 如果迭代误差ek xk x*当k 时成立下列渐近关系式 ek 1 C (C 0为常数) p ek
具体来说
局部收敛性有如下定理 1.设已知 f(x) = 0 有根 a, f(x) 充分光滑(各阶导数存在且连续). 2.若 f'(a) != 0(单重零点), 则初值取在 a 的某个邻域内时, 迭代法 x[n+1] = x[n] - f(x[n])/f'(x[n]) 得到的序列 x[n] 总收敛到 a, 且收敛速度至少是 二阶的. 3.若 f'(a) == 0(多重零点), 则初值取在 a 的某个邻域内时, 收敛速度是 一阶的.
则称该迭代过程是p阶收敛的。特别地,p=1时称为线性收敛,p>1时 称为超线性收敛,p=2时称为平方收敛。
定理6.3
对于迭代过程xk 1 ( xk ), 如果 ( p ) ( x) 在所求根x*的邻近连续,并且
' * '' * ( p 1) ( x* ) 0, ( x ) ( x ) ... ( p) * ( x ) 0, 则该迭代过程在点x*邻近是p阶收敛的.
记 g(x)=x-f(x)/f'(x), 其中"某个邻域"可由 |g'(x)|<1 的区间确定, 但是 g'(a)==0, 所以这样的邻域总是能取到的. 说收敛速度是 r 阶指的是: 存在 r 及常数 c 使 lim_{n->\inf} |x[n+1]a|/|x[n]-a|^r = c 至于牛顿迭代法的全局收敛性, 一般的数值分析书都没有详细叙述, 而 只是举一些例子. 因为牛迭是否收敛依赖于函数是否"单调", 一些"曲折"大的函数就可能 使迭代法不收敛了.
网络拓扑结构优化算法收敛速度评估说明
网络拓扑结构优化算法收敛速度评估说明网络拓扑结构优化算法是通过优化网络中的链路连接关系,以提高网络性能和可靠性的方法。
在实际应用中,算法的收敛速度是评估其效果的重要指标之一。
本文将从定义收敛速度、影响收敛速度的因素以及评估收敛速度的方法三个方面进行论述。
首先,什么是收敛速度?收敛速度是指网络拓扑优化算法在迭代过程中逐渐接近最优解所花费的时间。
在拓扑结构优化中,最优解往往是指网络中链路带宽利用率最大化或者时延最小化。
因此,一个快速收敛的算法意味着它能够在尽可能短的时间内达到最佳的拓扑优化状态。
其次,影响收敛速度的因素有很多,其中主要包括以下几个方面:1. 算法本身的特性:不同的算法有不同的收敛速度。
例如,梯度下降算法通常能够较快地收敛,因为它能够有效地利用目标函数的梯度信息。
而遗传算法等启发式算法则往往需要较长的时间来搜索全局最优解。
2. 网络的规模和复杂度:网络的规模越大、结构越复杂,拓扑优化算法往往需要更长的时间才能达到最优解。
这是因为大规模网络中的连接关系更加复杂,优化问题的搜索空间更大。
3. 初始拓扑状态:拓扑优化算法的初始拓扑状态也会对收敛速度产生影响。
如果初始的拓扑已经非常接近最优解,那么算法的收敛速度通常会更快。
最后,评估算法的收敛速度可以采用以下几种方法:1. 迭代次数统计:可以记录算法运行的迭代次数,并根据迭代次数来评估算法的收敛速度。
一般来说,迭代次数越少,收敛速度越快。
2. 收敛过程可视化:可以将算法的迭代过程可视化,通过观察目标函数值或者拓扑结构的变化来评估算法的收敛速度。
如果在前几次迭代中,目标函数值或者拓扑结构的变化比较大,而后续变化较小,那么算法可能已经接近最优解,收敛速度较快。
3. 算法效果评估:可以通过对比不同算法在相同条件下的优化效果来评估其收敛速度。
具体方法包括比较不同算法达到相同优化效果所需要的时间或者迭代次数。
综上所述,网络拓扑结构优化算法的收敛速度是评估其效果的重要指标之一。