
编译原理实验报告FIRST集和FOLLOW集
编译原理实验报告 实验名称 计算first集合和follow集合 实验时间 院系 计算机科学与技术 班级 软件工程1班 学号 姓名 1. 实验目的 输入:任意的上下文无关文法。 输出:所输入的上下文无关文法一切非终结符的first集合和follow集合。
2. 实验原理 设文法G[S]=(VN,VT,P,S),则首字符集为: FIRST(α)={a | α*aβ,a∈VT,α,β∈V *}。 若α*ε,ε∈FIRST(α)。
由定义可以看出,FIRST(α)是指符号串α能够推导出的所有符号串中处于串首的终结符号组成的集合。所以FIRST集也称为首符号集。 设α=x1x2…xn,FIRST(α)可按下列方法求得: 令FIRST(α)=Φ,i=1; (1) 若xi∈VT,则xi∈FIRST(α); (2) 若xi∈VN; ① 若εFIRST(xi),则FIRST(xi)∈FIRST(α); ② 若ε∈FIRST(xi),则FIRST(xi)-{ε}∈FIRST(α); (3) i=i+1,重复(1)、(2),直到xi∈VT,(i=2,3,…,n)或xi
∈VN且若εFIRST(xi)或i>n为止。
当一个文法中存在ε产生式时,例如,存在A→ε,只有知道哪些符号可以合法地出现在非终结符A之后,才能知道是否选择A→ε产生式。这些合法地出现在非终结符A之后的符号组成的集合被称为FOLLOW集合。下面我们给出文法的FOLLOW集的定义。 设文法G[S]=(VN,VT,P,S),则
FOLLOW(A)={a | S… Aa …,a∈VT}。
若S*…A,#∈FOLLOW(A)。
由定义可以看出,FOLLOW(A)是指在文法G[S]的所有句型中,紧跟在非终结符A后的终结符号的集合。 FOLLOW集可按下列方法求得: (1) 对于文法G[S]的开始符号S,有#∈FOLLOW(S); (2) 若文法G[S]中有形如B→xAy的规则,其中x,y∈V *,则FIRST(y)-{ε}∈FOLLOW(A); (3) 若文法G[S]中有形如B→xA的规则,或形如B→xAy的规则且ε∈FIRST(y),其中x,y∈V *,则FOLLOW(B)∈FOLLOW(A); 3.实验内容 计算first集合和follow集合
4.实验心得 通过上机实验我对文法符号的FIRST集和FOLLOW集有了更深刻的理解,已经熟练的掌握了求解的思想和方法,同时也锻炼了自己的动手解决问题的能力,对编程能力也有所提高。
5.实验代码与结果 #include #include #include using namespace std; #define MAXS 50 int NONE[MAXS]={0}; string strings;//产生式 string Vn;//非终结符 string Vt;//终结符 string first[MAXS];// 用于存放每个终结符的first集 string First[MAXS];// 用于存放每个非终结符的first集 string Follow[MAXS]; // 用于存放每个非终结符的follow集 int N;//产生式个数
struct STR { string left; string right; };
//求VN和VT void VNVT(STR *p) { int i,j; for(i=0;i{ for(j=0;j<(int)p[i].left.length();j++) { if((p[i].left[j]>='A'&&p[i].left[j]<='Z')) { if(Vn.find(p[i].left[j])>100) Vn+=p[i].left[j]; } else { if(Vt.find(p[i].left[j])>100) Vt +=p[i].left[j]; } } for(j=0;j<(int)p[i].right.length();j++) { if(!(p[i].right[j]>='A'&&p[i].right[j]<='Z')) { if(Vt.find(p[i].right[j])>100) Vt +=p[i].right[j]; } else { if(Vn.find(p[i].right[j])>100) Vn+=p[i].right[j]; } } } }
void getlr(STR *p,int i) { int j; for(j=0;j{ if(strings[j]=='-'&&strings[j+1]=='>') { p[i].left=strings.substr(0,j); p[i].right=strings.substr(j+2,strings.length()-j); } } }
//对每个文法符号求first集 string Letter_First(STR *p,char ch) { int t; if(!(Vt.find(ch)>100)) { first[Vt.find(ch)]="ch"; return first[Vt.find(ch)-1]; } if(!(Vn.find(ch)>100)) { for(int i=0;i{ if(p[i].left[0]==ch) { if(!(Vt.find(p[i].right[0])>100)) { if(First[Vn.find(ch)].find(p[i].right[0])>100) { First[Vn.find(ch)]+=p[i].right[0]; } } if(p[i].right[0]=='*') { if(First[Vn.find(ch)].find('*')>100) { First[Vn.find(ch)]+='*'; } } if(!(Vn.find(p[i].right[0])>100)) { if(p[i].right.length()==1) { string ff; ff=Letter_First(p,p[i].right[0]); for(int i_i=0;i_i{ if( First[Vn.find(ch)].find(ff[i_i])>100) { First[Vn.find(ch)]+=ff[i_i]; } }
} else { for(int j=0;j{ string TT; TT=Letter_First(p,p[i].right[j]); if(!(TT.find('*')>100)&&(j+1){ sort(TT.begin(),TT.end()); string tt; for(int t=1;t{ tt+=TT[t]; } TT=tt; tt=""; for(t=0;t{ if( First[Vn.find(ch)].find(TT[t])>100) { First[Vn.find(ch)]+=TT[t]; } } } else { for(t=0;t{ if( First[Vn.find(ch)].find(TT[t])>100) { First[Vn.find(ch)]+=TT[t]; } } break; } } }
} } } return First[Vn.find(ch)]; } } // 求每个非终结符的Follow集 string Letter_Follow(STR *p,char ch) { int t,k; NONE[Vn.find(ch)]++; if(NONE[Vn.find(ch)]==2) { NONE[Vn.find(ch)]=0; return Follow[Vn.find(ch)]; } for(int i=0;i{ for(int j=0;j{ if(p[i].right[j]==ch) { if(j+1==p[i].right.length()) { string gg; gg=Letter_Follow(p,p[i].left[0]); NONE[Vn.find(p[i].left[0])]=0; for(int k=0;k{ if(Follow[Vn.find(ch)].find(gg[k])>100) { Follow[Vn.find(ch)]+=gg[k]; } } } else { string FF; for(int jj=j+1;jj{ string TT; TT=Letter_First(p,p[i].right[jj]); if(!(TT.find('*')>100)&&(jj+1){ sort(TT.begin(),TT.end()); string tt; for(int t=1;t{ tt+=TT[t]; } TT=tt; tt=""; for(t=0;t{ if( FF.find(TT[t])>100&&TT[t]!='*') {
(完整版)编译原理及实现课后习题答案
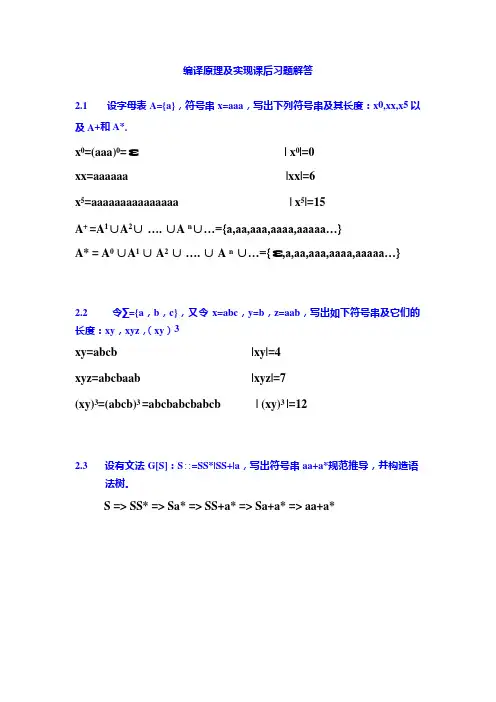
编译原理及实现课后习题解答2.1设字母表A={a},符号串x=aaa,写出下列符号串及其长度:x0,xx,x5 以及A+和A*.x0=(aaa)0=ε| x0|=0xx=aaaaaa |xx|=6x5=aaaaaaaaaaaaaaa | x5|=15A+ =A1∪A2∪ …. ∪A n∪…={a,aa,aaa,aaaa,aaaaa…}A* = A0 ∪A1 ∪A2 ∪…. ∪A n ∪…={ε,a,aa,aaa,aaaa,aaaaa…}2.2令∑={a,b,c},又令x=abc,y=b,z=aab,写出如下符号串及它们的长度:xy,xyz,(xy)3xy=abcb |xy|=4xyz=abcbaab |xyz|=7(xy)3=(abcb)3 =abcbabcbabcb | (xy)3 |=122.3设有文法G[S]:S∷=SS*|SS+|a,写出符号串aa+a*规范推导,并构造语法树。
S => SS* => Sa* => SS+a* => Sa+a* => aa+a*SS S *S S + aa a2.4 已知文法G[Z]:Z∷=U0∣V1 、U∷=Z1∣1 、V∷=Z0∣0 ,请写出全部由此文法描述的只含有四个符号的句子。
Z=>U0=>Z10=>U010=>1010Z=>U0=>Z10=>V110=>0110Z=>V1=>Z01=>U001=>1001Z=>V1=>Z01=>V101=>01012.5已知文法G[S]:S∷=AB A∷=aA︱εB∷=bBc︱bc , 写出该文法描述的语言。
A∷=aA︱ε描述的语言: {a n|n>=0}B∷=bBc︱bc 描述的语言:{b n c n|n>=1}L(G[S])={a n b m c m|n>=0,m>=1}2.6已知文法E∷=T∣E+T∣E-T 、T∷=F∣T*F∣T/F 、F∷=(E)∣i,写出该文法的开始符号、终结符号集合V T、非终结符号集合V N。
编译原理[张素琴]第2版答案清华大学出版社

《编译原理》课后习题第1章引论第1题解释下列术语:(1)编译程序:如果源语言为高级语言,目标语言为某台计算机上的汇编语言或机器语言,则此翻译程序称为编译程序。
(2)源程序:源语言编写的程序称为源程序。
(3)目标程序:目标语言书写的程序称为目标程序。
(4)编译程序的前端:它由这样一些阶段组成:这些阶段的工作主要依赖于源语言而与目标机无关。
通常前端包括词法分析、语法分析、语义分析和中间代码生成这些阶段,某些优化工作也可在前端做,也包括与前端每个阶段相关的出错处理工作和符号表管理等工作。
(5)后端:指那些依赖于目标机而一般不依赖源语言,只与中间代码有关的那些阶段,即目标代码生成,以及相关出错处理和符号表操作。
(6)遍:是对源程序或其等价的中间语言程序从头到尾扫视并完成规定任务的过程。
第2题一个典型的编译程序通常由哪些部分组成?各部分的主要功能是什么?并画出编译程序的总体结构图。
答案:一个典型的编译程序通常包含8个组成部分,它们是词法分析程序、语法分析程序、语义分析程序、中间代码生成程序、中间代码优化程序、目标代码生成程序、表格管理程序和错误处理程序。
其各部分的主要功能简述如下。
词法分析程序:输入源程序,拼单词、检查单词和分析单词,输出单词的机内表达形式。
语法分析程序:检查源程序中存在的形式语法错误,输出错误处理信息。
语义分析程序:进行语义检查和分析语义信息,并把分析的结果保存到各类语义信息表中。
中间代码生成程序:按照语义规则,将语法分析程序分析出的语法单位转换成一定形式的中间语言代码,如三元式或四元式。
中间代码优化程序:为了产生高质量的目标代码,对中间代码进行等价变换处理。
目标代码生成程序:将优化后的中间代码程序转换成目标代码程序。
表格管理程序:负责建立、填写和查找等一系列表格工作。
表格的作用是记录源程序的各类信息和编译各阶段的进展情况,编译的每个阶段所需信息多数都从表格中读取,产生的中间结果都记录在相应的表格中。
编译原理

一、选择1.将编译程序分成若干个“遍”是为了_使程序的结构更加清晰__。
2.正规式 MI 和 M2 等价是指__.M1 和 M2 所识别的语言集相等_。
3.中间代码生成时所依据的是 _语义规则_。
4.后缀式 ab+cd+/可用表达式__(a+b)/(c+d)_来表示。
6.一个编译程序中,不仅包含词法分析,_语法分析 ____,中间代码生成,代码优化,目标代码生成等五个部分。
7.词法分析器用于识别__单词___。
8.语法分析器则可以发现源程序中的___语法错误__。
9.下面关于解释程序的描述正确的是__解释程序的特点是处理程序时不产生目标代码 ___。
10.解释程序处理语言时 , 大多数采用的是__先将源程序转化为中间代码 , 再解释执行___方法。
11.编译过程中 , 语法分析器的任务就是__(2)(3)(4)___。
(1) 分析单词是怎样构成的 (2) 分析单词串是如何构成语句和说明的(3) 分析语句和说明是如何构成程序的 (4) 分析程序的结构12.编译程序是一种__解释程序__。
13.文法 G 所描述的语言是_由文法的开始符号推出的所有终极符串___的集合。
14.文法分为四种类型,即 0 型、1 型、2 型、3 型。
其中 3 型文法是___正则文法__。
15.一个上下文无关文法 G 包括四个组成部分,它们是:一组非终结符号,一组终结符号,一个开始符号,以及一组 _产生式__。
16.通常一个编译程序中,不仅包含词法分析,语法分析,中间代码生成,代码优化,目标代码生成等五个部分,还应包括_表格处理和出错处理__。
17.文法 G[N]= ( {b} , {N , B} , N , {N→b│ bB , B→bN} ),该文法所描述的语言是L(G[N])={b2i+1│ i ≥0}18.一个句型中的最左_简单短语___称为该句型的句柄。
19.设 G 是一个给定的文法,S 是文法的开始符号,如果 S->x( 其中 x∈V*), 则称 x 是文法 G 的一个__句型__。
编译原理第三版课后习题答案
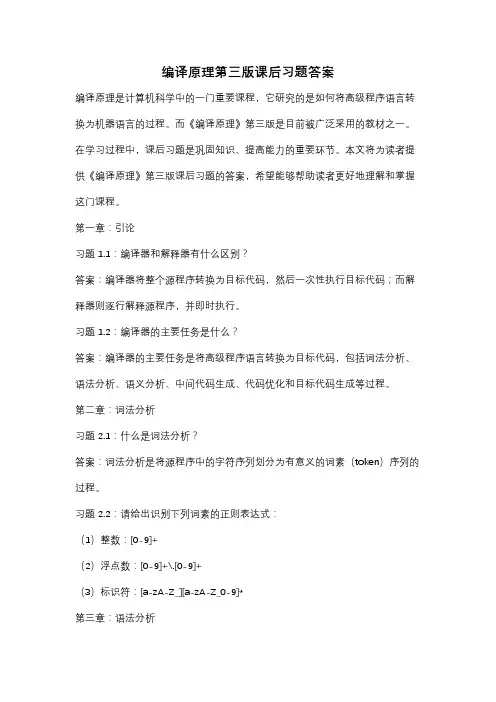
编译原理第三版课后习题答案编译原理是计算机科学中的一门重要课程,它研究的是如何将高级程序语言转换为机器语言的过程。
而《编译原理》第三版是目前被广泛采用的教材之一。
在学习过程中,课后习题是巩固知识、提高能力的重要环节。
本文将为读者提供《编译原理》第三版课后习题的答案,希望能够帮助读者更好地理解和掌握这门课程。
第一章:引论习题1.1:编译器和解释器有什么区别?答案:编译器将整个源程序转换为目标代码,然后一次性执行目标代码;而解释器则逐行解释源程序,并即时执行。
习题1.2:编译器的主要任务是什么?答案:编译器的主要任务是将高级程序语言转换为目标代码,包括词法分析、语法分析、语义分析、中间代码生成、代码优化和目标代码生成等过程。
第二章:词法分析习题2.1:什么是词法分析?答案:词法分析是将源程序中的字符序列划分为有意义的词素(token)序列的过程。
习题2.2:请给出识别下列词素的正则表达式:(1)整数:[0-9]+(2)浮点数:[0-9]+\.[0-9]+(3)标识符:[a-zA-Z_][a-zA-Z_0-9]*第三章:语法分析习题3.1:什么是语法分析?答案:语法分析是将词法分析得到的词素序列转换为语法树的过程。
习题3.2:请给出下列文法的FIRST集和FOLLOW集:S -> aAbA -> cA | ε答案:FIRST(S) = {a}FIRST(A) = {c, ε}FOLLOW(S) = {$}FOLLOW(A) = {b}第四章:语义分析习题4.1:什么是语义分析?答案:语义分析是对源程序进行静态和动态语义检查的过程。
习题4.2:请给出下列文法的语义动作:S -> if E then S1 else S2答案:1. 计算E的值2. 如果E的值为真,则执行S1;否则执行S2。
第五章:中间代码生成习题5.1:什么是中间代码?答案:中间代码是一种介于源代码和目标代码之间的表示形式,它将源代码转换为一种更容易进行优化和转换的形式。
编译原理大题
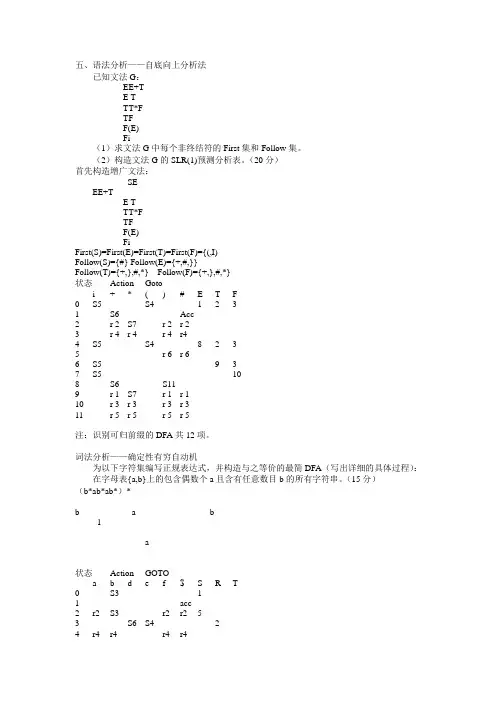
五、语法分析——自底向上分析法已知文法G:EE+TE TTT*FTFF(E)Fi(1)求文法G中每个非终结符的First集和Follow集。
(2)构造文法G的SLR(1)预测分析表。
(20分)首先构造增广文法:SEEE+TE TTT*FTFF(E)FiFirst(S)=First(E)=First(T)=First(F)={(,I)Follow(S)={#} Follow(E)={+,#,}}Follow(T)={+,},#,*} Follow(F)={+,},#,*}状态Action Gotoi + * ( ) # E T F0 S5 S4 1 2 31 S6 Acc2 r 2 S7 r 2 r 23 r4 r 4 r 4 r44 S5 S4 8 2 35 r6 r 66 S5 9 37 S5 108 S6 S119 r 1 S7 r 1 r 110 r 3 r 3 r 3 r 311 r 5 r 5 r 5 r 5注:识别可归前缀的DFA共12项。
词法分析——确定性有穷自动机为以下字符集编写正规表达式,并构造与之等价的最简DFA(写出详细的具体过程):在字母表{a,b}上的包含偶数个a且含有任意数目b的所有字符串。
(15分)(b*ab*ab*)*b a b1a状态Action GOTOa b d e f $ S R T0 S3 11 acc2 r2 S3 r2 r2 53 S6 S4 24 r4 r4 r4 r45 S10 96 77 S88 r3 r3 r3 r39 r1 r1 r110 r6 S6 S4 r6 r6 1111 S1212 r5 r5 r5五、语法分析——自底向上分析法已知文法G:S’SS bRSTS bRRdSaR eTfRaTf(1)求文法G中每个非终结符的First集和Follow集。
(2)构造文法G的SLR(1)预测分析表。
(20分)frist(s’)={b} follow(s’)={$}frist(s)={b} follow(s)={f,a, $}frist(R) ={d,e} follow( R )={a,b,f, $}frist(T)={t} follow (T)={a,f,#}五、对下面的文法(15分)S->UTa|TbT->S|Sc|dU->US|e判断是否为LR(0),SLR(1),说明理由,并构造相应的分析表。
编译原理期末复习题

3.2是非判断,对下面的陈述,正确的在陈述后的括号内写T,否则写F。
(1)有穷自动机接受的语言是正则语言。
()(2)若r1和r2是Σ上的正规式,则r1|r2也是。
()(3)设M是一个NFA,并且L(M)={x,y,z},则M的状态数至少为4个。
()(4)令Σ={a,b},则Σ上所有以b为首的字构成的正规集的正规式为b*(a|b)*。
()(5)对任何一个NFA M,都存在一个DFA M',使得L(M')=L(M)。
()(6)对一个右线性文法G,必存在一个左线性文法G',使得L(G)=L(G'),反之亦然。
()答案(1) T (2) T (3) F(4) F (5) T (6) T3.3描述下列各正规表达式所表示的语言。
(1) 0(0|1)*0(2) ((ε|0)1*)*(3) (0|1)*0(0|1)(0|1)(4) 0*10*10*10*(5) (00|11)*((01|10)(00|11)*(01|10)(00|11)*)*答案(1) 以0开头并且以0结尾的,由0和1组成的符号串。
(2) {α|α∈{0,1}*}(3) 由0和1组成的符号串,且从右边开始数第3位为0。
(4) 含3个1的由0和1组成的符号串。
{α|α∈{0,1}+,且α中含有3个1 }(5) {α|α∈{0,1}*,α中0和1为偶数}3.4对于下列语言分别写出它们的正规表达式。
(1) 英文字母组成的所有符号串,要求符号串中顺序包含五个元音。
(2) 英文字母组成的所有符号串,要求符号串中的字母依照词典顺序排列。
(3) Σ={0,1}上的含偶数个1的所有串。
(4) Σ={0,1}上的含奇数个1的所有串。
(5) 具有偶数个0和奇数个1的有0和1组成的符号串的全体。
(6) 不包含子串011的由0和1组成的符号串的全体。
(7) 由0和1组成的符号串,把它看成二进制数,能被3整除的符号串的全体。
答案(1) 令Letter表示除这五个元音外的其它字母。
带括号的四则混合运算编译原理课程设计报告
课程设计报告课程名称编译程序设计原理课题名称带括号的四则混合运算专业班级学号姓名指导教师20XX年 6 月27日湖南工程学院课程设计任务书课程名称编译程序设计原理课题带括号的四则混合运算专业班级学生姓名学号指导老师审批任务书下达日期2014 年6月23日任务完成日期20XX年6月27日20XX级《编译原理课程设计》任务书一、课程设计的性质和目的编译原理课程设计是计算机专业课程,通过课程设计使学生进一步巩固课堂所学知识,全面熟悉、掌握编译程序编写的基本设计方法和技巧,进一步提高分析问题、解决问题及上机操作能力,为将来从事高层次的计算机软件开发工作打下一定的专业基础。
二、设计课题课题一:应用编译原理的方法实现带括号的四则混合运算给定条件:1、词法符号定义如下:INTC → D+FLOATC → (D+.D+) | (D+.) | ( .D+)FLOATC →( (D+.D+) | (D+.) | ( .D+)| (D+) ) ( E | e ) ( + | − | λ ) D+OPADD → +OPSUB →−OPMUL → *OPDIV → /LPAREN →‘(’RPAREN →‘)’LINE →‘\n’ASSIGN → =2、表达式文法定义如下:01. S → E02. E → T03. E →E OPADD T04. E →E OPSUB T05. T → P06. T → T OPMUL P07. T → T OPDIV P08. P → INTC09. P → FLOATC10. P → LPAREN E RPAREN基本要求:1、以ASSIGN作为文法结束符号;2、应用词法分析技术识别单词;3、应用SLR(1)分析技术判别表达式的合法性;4、应用尾动作文法技术计算表达式的类型与值;5、要求表达式的类型与值严格一致。
三、课程设计报告要求1、课程设计报告必须按本系规定的格式要求打印成册;2、课程设计报告每人一份,正文必须包含如下几个方面的内容:1)基本设计思想;2)主要数据结构;3)总结与体会。
编译原理第章自上而下语法分析
3
对输入符号的依赖
自上而下的语法分析需要在分析过程中不断查看 输入符号,因此对输入符号的依赖较强。
编译原理的发展趋势与挑战
静态代码分析与优化
通过静态代码分析技术,编译器可以在编译时检测出更多的潜在错误,并进行 相应的优化。
非递归预测分析的基本思想
消除左递归
通过改写文法规则,消除直接和间接左递归,使得分析过程能够 顺利进行。
构造预测分析表
根据文法规则和非终结符的FOLLOW集,构造预测分析表,用于 指导分析过程。
栈和输入符号的同步处理
使用栈保存分析过程中的信息,并根据输入符号和栈顶信息进行同 步处理,实现语法分析。
非递归预测分析表的构造
介绍LL(1)文法的定义和判别方法,包括FIRST集和 FOLLOW集的构造。
递归下降分析算法设计
介绍递归下降分析算法的设计方法,包括递归子程序的 编写和错误处理机制。
02
CATALOGUE
语法分析基础
语法分析器的作用
识别语法错误
语法分析器能够检查源代码是否 符合语言的语法规则,识别出语 法错误并提供相应的错误信息。
在推导过程中,如果遇到非终 结符,则根据相应的产生式规 则进行替换,直到最终得到终
结符序列为止。
递归下降分析器的构造
分析函数根据当前输入符号和文 法规则判断应该执行的操作。
如果当前输入符号与文法规则中的某 个终结符相匹配,则消耗掉该输入符 号,并继续分析下一个输入符号。
如果当前输入符号与文法规则中 的某个非终结符相匹配,则调用 相应的分析函数进行递归分析。
预测分析算法的实现
初始化分析栈
编译原理---递归下降分析法
编译原理---递归下降分析法所谓递归下降法 (recursive descent method),是指对⽂法的每⼀⾮终结符号,都根据相应产⽣式各候选式的结构,为其编写⼀个⼦程序 (或函数),⽤来识别该⾮终结符号所表⽰的语法范畴。
例如,对于产⽣式E′→+TE′,可写出相应的⼦程序如下:exprprime( ){if (match (PLUS)){advance( );term( );exprprime( );}}其中:函数match()的功能是,以其实参与当前正扫视的符号 (单词)进⾏匹配,若成功则回送true,否则回送false;函数advance()是⼀个读单词⼦程序,其功能是从输⼊单词串中读取下⼀个单词,并将它赋给变量Lookahead;term则是与⾮终结符号T相对应的⼦程序。
诸如上述这类⼦程序的全体,便组成了所需的⾃顶向下的语法分析程序。
应当指出,由于⼀个语⾔的各个语法范畴 (⾮终结符号)常常是按某种递归⽅式来定义的,此种特点也就决定了这组⼦程序必然以相互递归的⽅式进⾏调⽤,因此,在实现递归下降分析法时,应使⽤⽀持递归调⽤的语⾔来编写程序。
所以,通常也将上述⽅法称为递归⼦程序法。
例4 2对于如下的⽂法G[statements]:statements→expression; statements |εexpression→term expression′expression′→+term expression′ |εterm→factor term′term′→*factor term′ |εfactor→numorid | (expression)通过对其中各⾮终结符号求出相应的FIRST集和FOLLOW集 (计算FIRST集和FOLLOW集的⽅法后⾯再做介绍),可以验证,此⽂法为⼀LL(1)⽂法,故可写出递归下降语法分析程序如程序41所⽰(其中,在⽂件lex.h⾥,将分号、加号、乘号、左括号、右括号、输⼊结束符及运算对象分别命名为SEMI,PLUS,TIMES,LP,RP,EOI及NUMORID,并指定了它们的内部码;此外,还对外部变量yytext,yyleng及yylineno进⾏了说明)。
LL(1)文法分析表的构造和分析过程示例
LL(1)⽂法分析表的构造和分析过程⽰例在考完编译原理之后才弄懂,悲哀啊。
不过懂了就好,知识吗,不能局限于考试。
⽂法:E→TE'E'→+TE'|εT→FT 'T'→*FT'|εF→id| (E)⼀、⾸先判断是不是 LL(1)⽂法--------------------------------------------------------------------------------------------------------⽂法G的任意两个具有相同左部的产⽣式 A --> α|β满⾜下列条件:1、如果α和β不能同时推导出ε,则 FIRST(α)∩FIRST(β) = 空2、α和β⾄多有⼀个能推导出ε3、如果β --*--> ε ,则 FIRST(α)∩ FOLLOW(A)=空--------------------------------------------------------------------------------------------------------对于 E'→+TE'|ε,显然ε --> ε, First(+TE') = {+} ,Follow(E') = {{),#} 显然⼆者交集为空满⾜。
对于 F→id|(E) ,First(id) = {id} First((E)) = {(} 显然⼆者交集为空满⾜。
所以该⽂法是LL(1)⽂法。
⼆、计算出First集和Follow集参考:三、构建LL(1)分析表输⼊:⽂法G输出:分析表M步骤:1、对G中任意⼀个产⽣式 A --> α执⾏第2步和第3步2、for 任意a ∈ First(α),将 A --> α填⼊M[A,a]3、if ε∈ First(α) then 任意a ∈ Follow(A),将 A --> α填⼊M[A,a]if ε∈ First(α) & # ∈Follow(A), then 将 A --> α填⼊M[A,#] (觉得这步没⽤)4、将所有没有定义的M[A,b] 标上出错标志(留空也可以)--------------------------------------------------------------------------------------------------------过程就不赘述了,结果:四、分析过程步骤:1、如果 X = a = # 则分析成功并停机2、如果 X = a != # 则弹出栈顶符号X, 并将输⼊指针移到下⼀个符号上3、如果 X != a,查询分析表M[X,a] , 如果 M[X,a] = {X --> UVW},则⽤UVW (U在栈顶) 替换栈顶符号 X。