
机器学习中距离与相似度度量
ne的式量

ne的式量
什么是ne的式量?
在计算机科学中,“ne的式量”是指一种用于衡量两个对象之间相似度的度量方法。它被广泛应用于信息检索、自然语言处理、机器学习等领域。ne的式量可以帮助我们判断两个对象之间的相似程度,进而进行分类、聚类、推荐等任务。
ne的式量的定义
ne的式量可以通过计算两个对象之间的距离或差异来评估它们之间的相似程度。常用的ne的式量包括欧氏距离、曼哈顿距离、余弦相似度等。
欧氏距离
欧氏距离是最常见和直观的一种ne的式量方法。它计算两个n维向量之间的直线距离,公式如下:
其中,xi和yi分别表示向量中第i个元素。
曼哈顿距离
曼哈顿距离是另一种常用的ne的式量方法,它计算两个n维向量之间的曼哈顿距离,即两个向量对应元素差值的绝对值之和,公式如下:
余弦相似度
余弦相似度是一种用于衡量两个向量夹角的相似度方法。它通过计算两个向量的内积除以它们的模长乘积来得到一个范围在[-1, 1]之间的相似度值,公式如下:
其中,A和B分别表示两个向量。
ne的式量的应用
ne的式量在信息检索、自然语言处理、机器学习等领域有着广泛的应用。
在信息检索中,ne的式量可以帮助搜索引擎根据用户查询与文档之间的相似度进行排序和匹配。比如,在搜索引擎中输入关键词”苹果手机”,搜索引擎可以通过计算用户查询与各个文档之间的相似度,将与”苹果手机”相关度较高的文档排在前面。
在自然语言处理中,ne的式量可以用于文本分类、聚类和相似句子匹配等任务。比如,在情感分析中,我们可以使用ne的式量来衡量两个句子之间的相似程度,从而判断它们是否表达了相同或相似的情感。 在机器学习中,ne的式量可以用于特征选择和模型评估。通过计算不同特征之间的ne的式量,我们可以选择那些与目标变量高度相关的特征作为输入。此外,在模型评估中,ne的式量可以用于衡量预测值与真实值之间的差异,从而评估模型性能。
总结
ne的式量是一种用于衡量两个对象之间相似度的度量方法。它通过计算距离或差异来评估两个对象之间的相似程度。常用的ne的式量包括欧氏距离、曼哈顿距离和余弦相似度等。ne的式量在信息检索、自然语言处理、机器学习等领域有着广泛应用,并且在许多实际问题中发挥着重要作用。
milvus相似度距离 参数

milvus相似度距离 参数
Milvus是一个开源的向量相似度搜索引擎,特别适用于大规模向量检索任务。它为用户提供了高效的相似度计算和快速的向量搜索功能,可以在海量数据中迅速找到与查询向量最相似的向量。在Milvus中,相似度计算是通过距离度量来实现的,其中常用的距离度量方法包括欧氏距离、内积和汉明距离等。
Milvus的相似度计算主要有两种方法:基于内积的相似度计算和基于汉明距离的相似度计算。基于内积的相似度计算是通过计算向量之间的内积来衡量相似度,其计算方法简单高效。而基于汉明距离的相似度计算则是通过计算向量之间的汉明距离来衡量相似度,适用于二进制向量的相似度计算。
在Milvus中,用户可以选择不同的参数来优化相似度搜索的效果。以下是一些常见的参数及其相关参考内容:
1. 距离度量方法参数:Milvus支持多种距离度量方法,包括欧氏距离(L2)、内积和汉明距离等。用户可以根据具体的需求选择合适的距离度量方法。更多有关这些不同距离度量方法的详细介绍,可以参考相关的机器学习和数据挖掘教材,如《机器学习》(周志华著)。
2. 距离度量参数设置:对于欧氏距离(L2)和内积等距离度量方法,用户可以设置距离阈值参数,用于筛选出与查询向量距离小于阈值的相似向量。具体的参数设置可以根据实际应用场景进行调整。相关的参数调优技巧可以参考文献《近似最近邻查询技术综述》。
3. 高效索引结构参数:Milvus提供了多种高效索引结构,包括倒排索引(IVF)、多索引结构(HNSW、PQ)等。用户可以根据数据特点选择合适的索引结构,以提高搜索效率和准确度。关于不同索引结构的介绍和性能对比,可以参考《快速近似最近邻搜索算法综述》(李春著)。
4. 量化参数:对于二进制向量的相似度计算,Milvus提供了量化方法,将高维向量转换为低维二进制码,从而加速相似度计算和搜索过程。用户可以根据数据特点和搜索需求设置不同的量化参数。更多关于量化方法的详细介绍,可以参考相关论文《Scalable Distance Informed Locality Sensitive Hashing for
Matlab中的相似度度量与相似性分析方法

Matlab中的相似度度量与相似性分析方法
引言:
相似性分析是一种常用的数据分析方法,它在许多领域中起着关键的作用,如模式识别、图像处理、自然语言处理等。Matlab作为一种强大的科学计算工具,提供了丰富的相似度度量和相似性分析方法,本文将重点介绍Matlab中常用的相似度度量方法和它们在相似性分析中的应用。
一、欧几里得距离
欧几里得距离是最常用的相似度度量方法之一,它描述了两个向量之间的距离。在Matlab中,可以使用"pdist"函数来计算欧几里得距离。下面是一个简单的示例代码:
```matlab
X = [1 2 3; 4 5 6; 7 8 9]; % 原始数据矩阵
D = pdist(X); % 计算两两样本之间的欧几里得距离
```
二、余弦相似度
余弦相似度是一种常用的度量方法,用于衡量两个向量之间的夹角。在Matlab中,可以使用"cosine"函数来计算余弦相似度。下面是一个简单的示例代码:
```matlab
X = [1 2 3; 4 5 6; 7 8 9]; % 原始数据矩阵
S = 1 - pdist2(X, X, 'cosine'); % 计算两两样本之间的余弦相似度
``` 三、相关系数
相关系数是一种用于衡量两个变量之间相关关系的方法,它描述了两个变量之间的线性关系程度。在Matlab中,可以使用"corrcoef"函数来计算相关系数。下面是一个简单的示例代码:
```matlab
X = [1 2 3; 4 5 6; 7 8 9]; % 原始数据矩阵
C = corrcoef(X); % 计算变量之间的相关系数
```
四、编辑距离
编辑距离是一种用于衡量两个字符串之间的相似性的方法,它描述了将一个字符串转换为另一个字符串所需的最小操作次数。在Matlab中,可以使用"editdist"函数来计算编辑距离。下面是一个简单的示例代码:
```matlab
kl距离公式

kl距离公式
KL距离公式是一种用于度量两个概率分布之间的差异程度的方法。KL距离公式来源于信息论,被广泛应用于机器学习和数据挖掘领域。
KL距离公式的全称是Kullback-Leibler距离公式,又称为相对熵。它由Kullback和Leibler在20世纪50年代提出,用于度量两个概率分布P和Q之间的差异程度。KL距离公式的计算方法如下:
KL(P||Q) = Σ(P(x) * log(P(x)/Q(x)))
其中,P(x)和Q(x)分别表示两个概率分布P和Q在样本点x上的概率值。log表示以2为底的对数。Σ表示对所有样本点x求和。
KL距离公式的计算结果是一个非负的值,当且仅当P和Q完全相同的时候,KL距离等于0。当P和Q之间的差异越大时,KL距离的值越大。
KL距离公式的应用非常广泛。在机器学习领域,KL距离常用于度量两个概率分布之间的相似度或差异度。例如,在聚类算法中,可以使用KL距离来度量不同样本之间的相似度,从而将相似的样本聚集在一起。在图像处理领域,KL距离可以用于图像检索和图像分类等任务中。
KL距离还有一些重要的性质和应用。首先,KL距离是非对称的,即KL(P||Q) ≠ KL(Q||P)。这意味着P和Q之间的差异程度可能与Q和P之间的差异程度不同。其次,KL距离是一种度量,它满足三角不等式,即KL(P||Q) + KL(Q||R) ≥ KL(P||R)。这意味着KL距离可以用于构建距离度量空间,从而可以应用于各种机器学习算法中。
总结起来,KL距离公式是一种用于度量两个概率分布之间差异程度的方法。它在机器学习和数据挖掘领域具有重要的应用价值。通过计算KL距离,我们可以量化不同概率分布之间的差异,从而为各种机器学习任务提供支持。
马氏距离的算法实现
- 1 - 马氏距离的算法实现
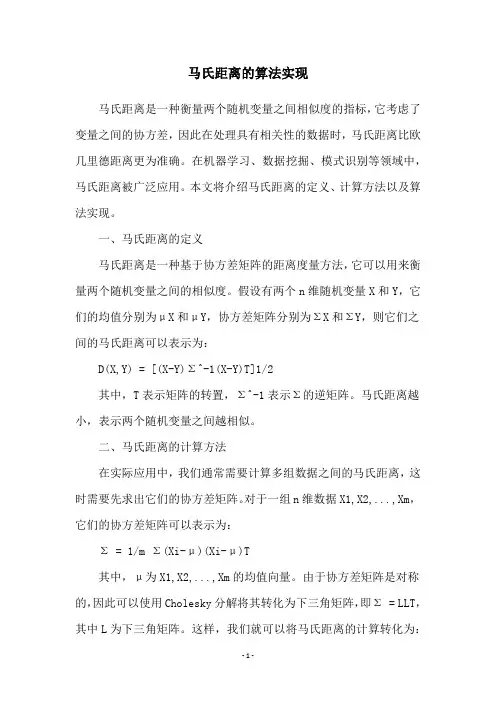
马氏距离是一种衡量两个随机变量之间相似度的指标,它考虑了变量之间的协方差,因此在处理具有相关性的数据时,马氏距离比欧几里德距离更为准确。在机器学习、数据挖掘、模式识别等领域中,马氏距离被广泛应用。本文将介绍马氏距离的定义、计算方法以及算法实现。
一、马氏距离的定义
马氏距离是一种基于协方差矩阵的距离度量方法,它可以用来衡量两个随机变量之间的相似度。假设有两个n维随机变量X和Y,它们的均值分别为μX和μY,协方差矩阵分别为ΣX和ΣY,则它们之间的马氏距离可以表示为:
D(X,Y) = [(X-Y)Σ^-1(X-Y)T]1/2
其中,T表示矩阵的转置,Σ^-1表示Σ的逆矩阵。马氏距离越小,表示两个随机变量之间越相似。
二、马氏距离的计算方法
在实际应用中,我们通常需要计算多组数据之间的马氏距离,这时需要先求出它们的协方差矩阵。对于一组n维数据X1,X2,...,Xm,它们的协方差矩阵可以表示为:
Σ = 1/m Σ(Xi-μ)(Xi-μ)T
其中,μ为X1,X2,...,Xm的均值向量。由于协方差矩阵是对称的,因此可以使用Cholesky分解将其转化为下三角矩阵,即Σ = LLT,其中L为下三角矩阵。这样,我们就可以将马氏距离的计算转化为: - 2 - D(X,Y) = [(X-Y)L^-1(L^-1)T(X-Y)T]1/2
其中,L^-1为L的逆矩阵。
三、马氏距离的算法实现
在Python中,使用NumPy库可以方便地实现马氏距离的计算。下面是一个简单的示例代码:
import numpy as np
def mahalanobis_distance(x, y, cov):
'''
计算两个n维向量x和y之间的马氏距离
:param x: n维向量
欧几里得度量方法
欧几里得度量方法
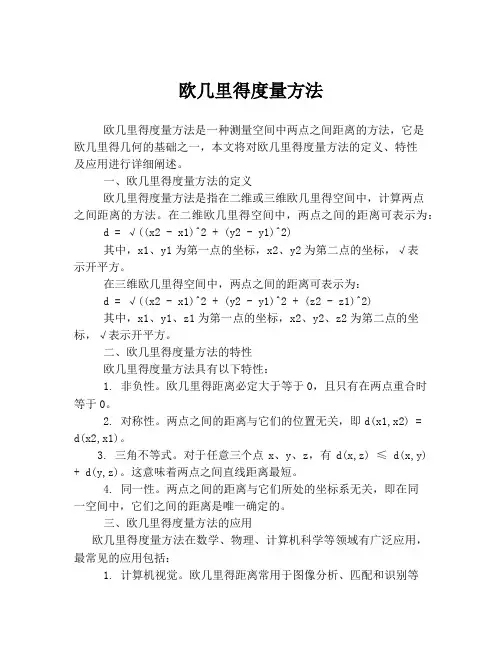
欧几里得度量方法是一种测量空间中两点之间距离的方法,它是欧几里得几何的基础之一,本文将对欧几里得度量方法的定义、特性及应用进行详细阐述。
一、欧几里得度量方法的定义
欧几里得度量方法是指在二维或三维欧几里得空间中,计算两点之间距离的方法。在二维欧几里得空间中,两点之间的距离可表示为:
d = √((x2 - x1)^2 + (y2 - y1)^2)
其中,x1、y1为第一点的坐标,x2、y2为第二点的坐标,√表示开平方。
在三维欧几里得空间中,两点之间的距离可表示为:
d = √((x2 - x1)^2 + (y2 - y1)^2 + (z2 - z1)^2)
其中,x1、y1、z1为第一点的坐标,x2、y2、z2为第二点的坐标,√表示开平方。
二、欧几里得度量方法的特性
欧几里得度量方法具有以下特性:
1. 非负性。欧几里得距离必定大于等于0,且只有在两点重合时等于0。
2. 对称性。两点之间的距离与它们的位置无关,即d(x1,x2) =
d(x2,x1)。
3. 三角不等式。对于任意三个点x、y、z,有d(x,z) ≤ d(x,y)
+ d(y,z)。这意味着两点之间直线距离最短。
4. 同一性。两点之间的距离与它们所处的坐标系无关,即在同一空间中,它们之间的距离是唯一确定的。
三、欧几里得度量方法的应用
欧几里得度量方法在数学、物理、计算机科学等领域有广泛应用,最常见的应用包括:
1. 计算机视觉。欧几里得距离常用于图像分析、匹配和识别等领域。在计算机视觉中,欧几里得距离可用于判断两张图片的相似度。
2. 机器学习。在机器学习中,欧几里得距离可用于计算两个向量之间的距离,进而计算它们之间的相似度。
3. 三维建模。欧几里得距离可用于计算三维图形中各个点之间的距离和表面积等参数,以及计算三维物体的体积和重心等属性。
4. 运动学。在机器人学和运动学中,欧几里得距离被用来衡量机械臂的部件之间的距离和位置,进而实现机器人的定位和导航。
m3e计算相似度
m3e计算相似度
m3e是一种用于计算数据相似度的方法,它的全称是“mean of means of Euclidean distances”。m3e方法主要应用于多维数据分析和模式识别领域,它的基本思想是通过计算数据点到数据集均值的欧氏距离的均值,来衡量数据点之间的相似度。
下面,我们将详细介绍m3e方法计算相似度的具体步骤和原理。
一、m3e方法的原理
m3e方法的基本思想是将数据点之间的相似度转化为距离度量问题。对于给定的数据集,首先计算每个数据点到数据集均值的欧氏距离,然后计算这些距离的均值,最后利用这个均值来衡量数据点之间的相似度。
二、m3e方法的计算步骤
m3e方法的计算步骤如下:
1. 计算数据集的均值向量。对于给定的数据集,首先计算每个特征的均值,然后将这些均值组合成一个均值向量。
2. 计算每个数据点到数据集均值的欧氏距离。对于数据集中的每个数据点,计算它到数据集均值向量的欧氏距离。欧氏距离的计算公式为:d(i,j)=∑(x_i - x_j)^2,其中x_i和x_j分别表示数据点i和数据点j的特征值。
3. 计算欧氏距离的均值。将所有数据点到数据集均值的欧氏距离求和,然后除以数据点的数量,得到欧氏距离的均值。
4. 计算相似度。利用欧氏距离的均值来衡量数据点之间的相似度。一般来说,欧氏距离的均值越小,数据点之间的相似度越高。
三、m3e方法的特点与应用
m3e方法具有以下特点:
1. m3e方法是一种基于距离的相似度计算方法,它将数据点之间的相似度转化为距离度量问题,具有较好的直观性和合理性。
2. m3e方法对异常值和噪声具有较强的鲁棒性,能够有效地减少这些因素对相似度计算结果的影响。
3. m3e方法计算简单,易于实现,适用于大规模数据集的计算。
因此,m3e方法在模式识别、机器学习、数据挖掘等领域具有广泛的应用。例如,在图像识别、文本分类、基因表达数据分析等领域,m3e方法都取得了较好的效果。
欧式距离的优点及应用
欧式距离的优点及应用
欧式距离是指在欧几里德空间中,两点间距离的计算方法,也称为欧几里德距离。欧式距离在数学和计算机科学领域具有广泛的应用,它的主要优点有以下几个方面。
首先,欧式距离计算简单、直观。欧式距离的计算方法是通过计算两点在坐标系中的直线距离来得到的,这种计算方法非常直观,易于理解和实现。
其次,欧式距离能够量化特征之间的差异。在机器学习和数据挖掘领域,我们经常需要计算样本之间的相似度或差异度。欧式距离可以将样本之间的特征差异量化为一个具体的数值,方便进行比较和分析。
第三,欧式距离对异常值不敏感。在一些场景中,数据中可能存在一些异常值(outliers),这些异常值可能会对距离计算产生影响。然而,欧式距离对异常值并不敏感,因为它只关注两个点之间的直线距离,而不考虑其他因素。
第四,欧式距离适用于连续性的特征。欧式距离在处理连续型数据时非常有效,因为它可以直接计算两个点在每个维度上的差异大小。这使得欧式距离在数据挖掘和聚类算法中得到广泛应用。
欧式距离的应用非常广泛,下面以几个常见的应用场景说明它的具体应用。
首先,在机器学习中,欧式距离经常用于特征相似性的度量。比如,在推荐系统中,我们可以通过计算用户对商品的评分向量之间的欧式距离,来度量用户之间的相似度,从而为用户进行个性化推荐。欧式距离还可以用于图像识别中的特征匹配,通过计算图像特征向量之间的欧式距离,找到最相似的图像。
其次,在数据挖掘领域,欧式距离经常用于聚类算法中的样本相似性度量。比如,K-means算法将样本点分为若干个簇,欧式距离被用作计算样本点与簇中心之间的距离。欧式距离还被广泛应用于层次聚类、密度聚类等算法中。
此外,欧式距离还应用于数据压缩和降维算法中。在主成分分析(PCA)算法中,欧式距离被用来计算原始数据与降维后数据之间的差异,从而找到最佳的投影方向。欧式距离也被用于多维缩放(MDS)算法中,通过计算样本点在低维空间中的欧式距离,来还原高维数据的结构信息。
k-近邻算法 欧式距离 高斯距离
k-近邻算法 欧式距离 高斯距离
以k-近邻算法 欧式距离 高斯距离为标题的文章
近年来,随着机器学习的飞速发展,k-近邻算法成为了一种常用的分类算法。该算法基于样本之间的距离来判断其类别,并通过找出k个最近邻样本的类别进行投票来确定待分类样本的类别。在k-近邻算法中,欧式距离和高斯距离是常用的距离度量方法,它们在计算样本之间的相似度时起到了重要的作用。
我们来介绍一下欧式距离。欧式距离是一种常见的距离度量方法,它衡量的是样本之间的绝对距离。对于两个样本点x和y,它们在n维空间中的欧式距离可以通过以下公式来计算:
d(x, y) = sqrt((x1 - y1)^2 + (x2 - y2)^2 + ... + (xn -
yn)^2)
其中,x1, x2, ..., xn和y1, y2, ..., yn分别表示x和y在每个维度上的取值。欧式距离越小,说明两个样本点越相似。
接下来,我们来介绍一下高斯距离。高斯距离也被称为高斯相似度,它是一种基于概率密度函数的距离度量方法。对于两个样本点x和y,它们的高斯距离可以通过以下公式来计算:
d(x, y) = exp(-||x - y||^2 / (2 * sigma^2))
其中,||x - y||表示x和y之间的欧氏距离,sigma是高斯核函数的带宽参数。高斯距离越大,说明两个样本点越相似。
在k-近邻算法中,我们需要选择合适的距离度量方法来计算样本之间的相似度。一般来说,欧式距离适用于特征空间为连续值的情况,而高斯距离适用于特征空间为离散值的情况。在实际应用中,我们可以根据具体的问题和数据特点选择合适的距离度量方法。
除了距离度量方法,k-近邻算法还需要确定一个合适的k值。k值表示选择多少个最近邻样本来进行投票。一般来说,k值越小,模型的复杂度越低,容易受到噪声的影响;k值越大,模型的复杂度越高,容易受到样本不平衡的影响。因此,在选择k值时需要考虑到模型的复杂度和数据的分布情况。
欧几里得距离公式排序
欧几里得距离公式排序
欧几里得距离公式,也称为欧氏距离公式,是空间中两点之间的距离计算方法。它以数学形式展示了我们常用的直线距离。欧几里得距离公式在几何学、机器学习等领域具有广泛应用。
在二维平面中,欧几里得距离公式可以用以下公式表示:distance
= √((x2-x1)² + (y2-y1)²)。其中,(x1, y1)和(x2, y2)分别表示两个点的坐标。
例如,假设有两个点A(1, 2)和B(4, 6),我们可以使用欧几里得距离公式计算它们之间的距离。根据公式,我们可以得到distance =
√((4-1)² + (6-2)²) = √(3² + 4²) = √(9 + 16) = √25 = 5。
欧几里得距离公式的应用范围非常广泛。在几何学中,我们可以使用欧几里得距离公式计算线段的长度。在机器学习中,欧几里得距离公式常用于计算向量之间的相似度。例如,在推荐系统中,我们可以使用欧几里得距离公式计算用户之间的兴趣相似度,从而推荐相似的物品给用户。
除了二维平面,欧几里得距离公式也适用于更高维度的空间。在三维空间中,我们可以通过类似的方式计算两个点之间的距离。在多维空间中,欧几里得距离公式可以推广到任意维度。
欧几里得距离公式的优点是简单易懂,并且计算效率高。然而,它也有一些局限性。例如,在处理文本数据时,欧几里得距离公式无法捕捉到词语之间的语义关系。在这种情况下,我们需要使用其他距离度量方法,如余弦相似度。
总结起来,欧几里得距离公式是一种常用的距离度量方法,适用于各种领域。它可以帮助我们计算点、线段或向量之间的距离,从而解决各种实际问题。了解和掌握欧几里得距离公式对于理解和应用相关领域的知识非常重要。我们可以通过数学计算,利用欧几里得距离公式来解决实际问题,提高我们的工作效率和准确性。