
严蔚敏数据结构课件10哈希表
数据结构之哈希表
实验目的:
1. 训练与培养解决实际问题的能力
2. 学会面对一个问题时应该如何分析问题,设计解决方法,实际编码及结果测试。
3. 熟悉哈希表的使用
4. 设计哈希表实现电话号码查询系统。
5. 设计程序完成以下要求:
(1)设每个记录有下列数据项:电话号码、用户名、地址;
(2)从键盘输入各记录,以电话号码为关键字建立哈希表(至少要有12个以上的记录,哈希表的长度为8);
(3)采用链地址法解决冲突;
(4)显示建立好的哈希表,对于学有余力的同学可以实现哈希表的查找。
实验仪器与设备:
计算机
实验内容:
(1)采用除留余数法进行哈希表的散列,即以电话号码作为主关键字,将电话号码的11位相加,按照模7取余;
(2)解决冲突用链地址法。、
(3)实现哈希表的显示与号码的查询
实验方法与步骤:
1. 根据问题进行分析,明确要解决的问题是什么,怎样解决
2. 根据分析设计问题求解算法
3. 用特定语言对设计进行编码
4. 对程序进行测试
实验原理:
1. 对于哈希电话本问题的分析:哈希表问题实际上和图问题一样,先创建一个数组。在号码存入时,如果数组中哈希关键字位置没有写入号码,则在该处写入,并把该处设置为已写入。如果该处已写入号码,则在该处建立新的结点,并写入号码。
2. 号码显示用for和while两个循环,具体实现过程可看附录代码。
3. 号码查询按号码显示的函数书写,只是实现函数不同。 实验心得:
通过这次的实验,我更加熟练了分析问题的方法。深刻题解算法的重要性。本次的算法实现中,对算法的时间空间复杂度进行了优化处理。这是一个以前没做过的地方。
在哈希表的显示与查询中,出了一个错误,在纸上模拟了很久也没看出问题。后来睡觉时才突然想到写少了一个函数,这提示我,写程序要细心,不能大意。
实验具体代码如下:
// 哈希表问题.cpp : 定义控制台应用程序的入口点。
#include"stdafx.h"
清华大学严蔚敏版数据结构考研要点(精华版)
1、数据(Data) :是客观事物的符号表示。在计算机科学中指的是所有能输入到计算机中并被计算机程序处理的符号的总称。
数据元素(Data Element) :是数据的基本单位,在程序中通常作为一个整体来进行考虑和处理。
一个数据元素可由若干个数据项(Data Item)组成。数据项是数据的不可分割的最小单位。数据项是对客观事物某一方面特性的数据描述。
数据对象(Data Object):是性质相同的数据元素的集合,是数据的一个子集。如字符集合C={‘A’,’B’,’C,…} 。
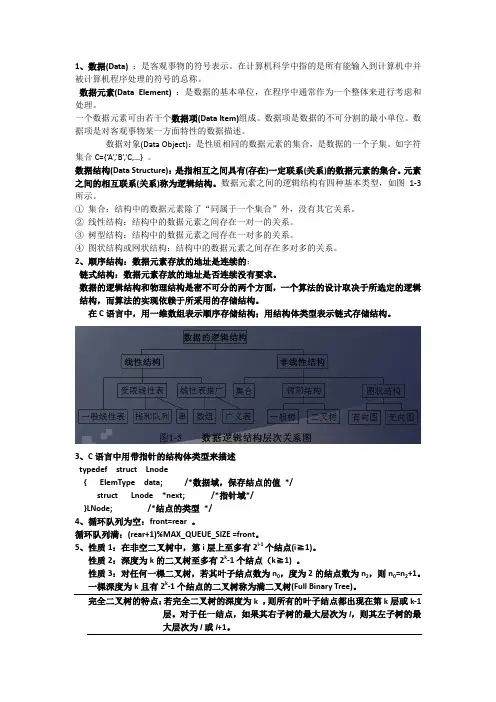
数据结构(Data Structure):是指相互之间具有(存在)一定联系(关系)的数据元素的集合。元素之间的相互联系(关系)称为逻辑结构。数据元素之间的逻辑结构有四种基本类型,如图1-3所示。
① 集合:结构中的数据元素除了“同属于一个集合”外,没有其它关系。
② 线性结构:结构中的数据元素之间存在一对一的关系。
③ 树型结构:结构中的数据元素之间存在一对多的关系。
④ 图状结构或网状结构:结构中的数据元素之间存在多对多的关系。
2、顺序结构:数据元素存放的地址是连续的;
链式结构:数据元素存放的地址是否连续没有要求。
数据的逻辑结构和物理结构是密不可分的两个方面,一个算法的设计取决于所选定的逻辑结构,而算法的实现依赖于所采用的存储结构。
在C语言中,用一维数组表示顺序存储结构;用结构体类型表示链式存储结构。
3、C语言中用带指针的结构体类型来描述
typedef struct Lnode
{ ElemType data; /*数据域,保存结点的值 */
struct Lnode *next; /*指针域*/
}LNode; /*结点的类型 */
4、循环队列为空:front=rear 。
循环队列满:(rear+1)%MAX_QUEUE_SIZE =front。
自-精 品[精品]00《数据结构讲义》哈希表及其查找

1.握散列相关知识。学习要点包括各种散列函数的使用及其比较。
2.理解解决冲突的主要方法。
➢ 教学重点:
哈希表及哈希查找。
解决地址冲突的方法。
➢ 教学难点:
解决地址冲突的方法。
➢ 授课内容
3 哈希表查找(杂凑法)
3.1 哈希表与哈希方法
以上讨论的查找方法,由于数据元素的存储位置与关键码之间不存在确定的关系,因此,查找时,需要进行一系列对关键码的查找比较,即“查找算法”是建立在比较的基础上的,查找效率由比较一次缩小的查找范围决定。理想的情况是依据关键码直接得到其对应的数据元素位置,即要求关键码与数据元素间存在一一对应关系,通过这个关系,能很快地由关键码得到对应的数据元素位置。
【例3】11个元素的关键码分别为 18,27,1,20,22,6,10,13,41,15,25。选取关键码与元素位置间的函数为 f(key)=key mod 11
1. 通过这个函数对11个元素建立查找表如下:
0 1 2 3 4 5 6 7 8 9 10
22 1 13 25 15 27 6 18 41 20 10
2. 查找时,对给定值kx依然通过这个函数计算出地址,再将kx与该地址单元中元素的关键码比较,若相等,查找成功。
哈希表与哈希方法:选取某个函数,依该函数按关键码计算元素的存储位置,并按此存放;查找时,由同一个函数对给定值kx计算地址,将kx与地址单元中元素关键码进行比,确定查找是否成功,这就是哈希方法(杂凑法);哈希方法中使用的转换函数称为哈希函数(杂 哈希表及其查找
凑函数);按这个思想构造的表称为哈希表(杂凑表)。
对于n个数据元素的集合,总能找到关键码与存放地址一一对应的函数。若最大关键为m,可以分配m个数据元素存放单元,选取函数f(key)=key即可,但这样会造成存储空间的很大浪费,甚至不可能分配这么大的存储空间。通常关键码的集合比哈希地址集合大得多,因而经过哈希函数变换后,可能将不同的关键码映射到同一个哈希地址上,这种现象称为冲突(Collision),映射到同一哈希地址上的关键码称为同义词。可以说,冲突不可能避免,只能尽可能减少。所以,哈希方法需要解决以下两个问题:
实验4—哈希表

实 验 报 告
一、实验目的
(1) 掌握静态查找表和动态查找表的抽象数据类型特征。
(2) 掌握将台查找表和动态查找表的实现方法。
(3) 学会在顺序表、二叉排序树上设计查找算法,学会根据关键字特征设计哈希函数,设计哈希表,并实现哈希表查找过程。
二、实验内容与实验步骤
[问题描述]
真对你所在的集体(比如你所在的班级)中的人名设计一个哈希表,使得平均查找长度不超过R,完成相应的建表和查表的程序。
[基本要求]
假设人名为中国人姓名的汉语拼音形式,待填入的哈希表的人名共有30个,取平均查找长度的上限为2。哈希函数用除留余数方法构造,用伪随机探测再散列处理冲突。
[测试数据]
取你周围熟悉的30个人的姓名。
[实现提示]
如果随机函数自行构造,则应首先调整好随机函数,使其分布均匀。人名的长度均不超过19个字符,最长的人名如:庄双双(Zhuang Shuangshuang)。字符的取码方法可直接利用C语言中的toascii函数,并可对过长的人名先作折叠处理。
1 .存储结构定义
typedef struct
{ char *name; //名字所对应的拼音字母
int k; //汉字拼音所对应的整数值
}NAME;
typedef struct //定义哈希表结构体
{ char *name; //名字的拼音
int k; //拼音所对应的整数
int len; //查找的长度
}HASH;
2. 姓名初始化
名字以拼音的形式够成字符串,将字符串的各个字符所对应的ASCII码相加,所得的整数做为哈希表的关键字。
void InitkName() //姓名初始化函数
{
//人名初始化如下
kName[0].name="cunjian";
kName[1].name="mayun";
数据结构严蔚敏版第十章答案

第十章 内部排序
10.23
void Insert_Sort1(SqList &L)//监视哨设在高下标端的插入排序算法
{
k=L.length;
for(i=k-1;i;--i) //从后向前逐个插入排序
if(L.r[i].key>L.r[i+1].key)
{
L.r[k+1].key=L.r[i].key; //监视哨
for(j=i+1;L.r[j].key>L.r[i].key;++j)
L.r[j-1].key=L.r[j].key; //前移
L.r[j-1].key=L.r[k+1].key; //插入
}
}//Insert_Sort1
10.24
void BiInsert_Sort(SqList &L)//二路插入排序的算法
{
int d[MAXSIZE]; //辅助存储
x=L.r.key;d=x;
first=1;final=1;
for(i=2;i<=L.length;i++)
{
if(L.r[i].key>=x) //插入前部
{
for(j=final;d[j]>L.r[i].key;j--)
d[j+1]=d[j];
d[j+1]=L.r[i].key;
final++;
}
else //插入后部
{
for(j=first;d[j]
d[j-1]=d[j];
d[(j-2)%MAXSIZE+1]=L.r[i].key;
first=(first-2)%MAXSIZE+1; //这种形式的表达式是为了兼顾first=1的情况
}
}//for
for(i=first,j=1;d[i];i=i%MAXSIZE+1,j++)//将序列复制回去
数据结构教案

数据结构教案(总32页)
-CAL-FENGHAI.-(YICAI)-Company One1
-CAL-本页仅作为文档封面,使用请直接删除
2015 至2016 学年第二学期
数 据 结 构 课程
教
案
课程编码: 1261D03
总学时/周学时: 80 / 5
开课时间: 2016年2 月 24日第 1 周至第 16
周
授课年级、专业、班级: 15级网工程2班
使用教材 严蔚敏. 数据结构(C语言版)[M] 北京:清华大学出版社,2011.
系别/教研室: 信息工程学院 / 物联网工程
授课教师: 刘波 教学目标:
《数据结构》是物联网工程专业的一门专业必修课。用计算机解决任何问题都需要进行数据表示和数据处理,而数据表示和数据处理正是《数据结构》要研究的内容。主要介绍如何合理地组织数据、有效地存储和处理数据,正确地设计算法以及对算法的分析和评价。
通过本课程教学,使学生了解数据结构的基本概念,理解数据结构的逻辑结构和物理结构的基本概念以及有关算法,掌握算法描述及算法的评价标准,熟悉在不同存储结构上实现不同的运算,并对算法设计的方式和技巧有所体会,旨在培养学生基本的、良好的程序设计技能,编制高效可靠的程序,并为学生日后学习操作系统和数据库等后续课程奠定基础。
教学要求:
本课程主要是以抽象数据类型的观点来组织和讲解线性表、栈、队列、树、二叉树、图等各种主要的数学模型并定义为相应的抽象数据类型,给出各种物理表示法和有关算法,关于数据处理技术介绍几种主要的排序和查找算法。
学生通过学习该课程后主要应掌握以下内容:
1.了解数据结构及有关的基本概念;
数据结构
数据结构课程设计报告
统计C程序单词的个数
—采用hash函数与二分查找技术
目录:
摘要(题目):
问题描述:扫描c源程序,利用hash技术和二分查找技术统计该源程序中的关键字出现的频度,并比较各自查找的次数。
实现要求:
(1)、先用Hash表存储c语言中32个关键字,再扫描c源程序取出每个单词,利用Hash查找技术统计该程序中的关键字出现的频度。发生Hash冲突用线性探测法解决。设Hash函数为:
Hash(key)=[(key的第一个字母序号)*100+(key的最后一个字母序号)] MOD 41。
(2)、用顺序表存储c语言中的关键字,把c源程序取出每个单词利用二分查找技术统计该程序中的关键字的出现频度。
1. 引言
哈希表是为了便于快速搜索而组织的值组合的集合。Hash Table是一种数组,可以用任意简单变量值来访问其元素,这种数组叫做关联数组,也叫哈希表。值对的集合。
线性表的顺序表是指用一组地址连续的存储单元依次存储线性表的数据元素。
二分查找也叫折半查找,是以处于区间中间的位置记录的关键字和给定值比较,若相等,则查找成功,若不等,则缩小范围,直至新的区间中间位置记录的关键字等于给定的值或者查找区间的大小小于零时,则表示查找不成功为止。即其查找过程是先确定待查记录所在的范围区间,然后逐步缩小范围直到找到或找不到记录为止。
2. 需求分析
理想的情况下是希望不经过任何比较,一次存储就能得到所查到的记录,那就必须在记录的存储位置和它的关键字之间建立一个确定的对应关系f,使每个关键字和结构中一个唯一的存储位置相对应。
基本要求:使用一个下标范围比较大的数组来存储元素。可以设计一个函数(哈希函数,也叫做散列函数),使得每个元素的关键字都与一个函数值(即数组下标,hash值)存在一一对应的关系,于是用这个数组单元来存储这个元素。也可以简单的理解为,按照关键字为每一个元素“分类”。使用哈希表的好处是把数据的存储和查找消耗的时间大大降低,编码比较容易也。但是对不同的关键字可能得到同一个哈希地址 即key1≠key2,而f(key1)=f(key2)。因此,在建造哈希表时不仅要设定一个好的哈希函数,而且要设定一种处理冲突的方法。因此必须有个处理冲突的办法。
数据结构 程序设计 哈希表设计
学 号
数据结构课程设计
设计说明书
哈希表设计
起止日期: 2011年 12月 12 日 至 2011 年 12月16日
学生姓名
班级
成绩
指导教师(签字)
电子与信息工程系
2011年 12月16日
1 2 天津城市建设学院
课程设计任务书
2011—2012学年第1学期
电子与信息工程 系 软件工程 专业 班级
课程设计名称: 数据结构课程设计
设计题目: 哈希表设计
完成期限:自 2011 年 12 月 12 日至 2011 年 12 月 16 日共 1 周
设计依据、要求及主要内容(可另加附页):
一、设计目的
熟悉各种数据结构和运算,会使用数据结构的基本操作解决一些实际问题。
二、设计要求
(1)重视课程设计环节,用严谨、科学和踏实的工作态度对待课程设计的每一项任务;
(2)按照课程设计的题目要求,独立地完成各项任务,严禁抄袭;凡发现抄袭,抄袭者与被抄袭者皆以零分计入本课程设计成绩。凡发现实验报告或源程序雷同,涉及的全部人员皆以零分计入本课程设计成绩;
(3)学生在接受设计任务后,首先要按设计任务书的要求编写设计进程表;
(4)认真编写课程设计报告。
三、设计内容
1)问题描述
针对某个集体中人名设计一个哈希表,使得平均查找长度不超过R,并完成相应的建表和查表程序。
2)基本要求
假设人名为中国人姓名的汉语拼音形式。待填入哈希表的人名共有30个,取平均查找长度的上限为2。哈希函数用除留余数法构造,用线性探测再散列法或链地址法处理冲突。
3)测试数据
取读者周围较熟悉的30个人名。
四、参考文献
1.王红梅.数据结构.清华大学出版社
2.王红梅.数据结构学习辅导与实验指导.清华大学出版社
严蔚敏数据结构复习整理完整版
1.复杂性分析
对各种操作的时间复杂性的分析。
主要是链表,树,排序等简单一些的分析。
分析的时候,从简单的入手,学会方法。
后续的各种豆可能让你分析时间复杂度。
线性链表(顺序表和单链表)
链表 循环链表
双向链表
2.线性结构 队列(循环队列)
栈
链表主要操作:找某一个元素,插入一个(在哪个位置增加),删除一个(在哪个位置删除)。
栈:查找,插入(位置固定),删除(位置固定)
队列:查找,插入(位置固定),删除(位置固定)
顺序表(可以视为一个数组)
单链表:
(删除)
(插入)
倒置:
(查找)
循环链表
双向链表
栈:
(插入删除查找)
队列
(插入删除查找)
循环队列的实现,并不是像上面的图那样,实现了一个循环的样子。
3.二叉树
基本概念
二叉树是每个节点最多有两个子树的有序树。二叉树常被用于实现二叉查找树和二叉堆。值得注意的是,二叉树不是树的特殊情形。
二叉树是每个结点最多有两个子树的有序树。通常根的子树被称作“左子树”(left
subtree)和“右子树”(right subtree)。二叉树常被用作二叉查找树和二叉堆或是二叉排序树。二叉树的每个结点至多只有二棵子树(不存在出度大于2的结点),二叉树的子树有左右之分,次序不能颠倒。
二叉树不是树的一种特殊情形,尽管其与树有许多相似之处,但树和二叉树有两个主要差别:
1. 树中结点的最大度数没有限制,而二叉树结点的最大度数为2;
2。 树的结点无左、右之分,而二叉树的结点有左、右之分。
二叉树是递归定义的,其结点有左右子树之分,逻辑上二叉树有五种基本形态:
(1)空二叉树——如图(a);
(2)只有一个根结点的二叉树——如图(b);
(3)只有左子树——如图(c);
严蔚敏版大数据结构所有算法代码
实用标准
文档大全 严蔚敏版数据结构所有算法代码
------------------------线性数据结构-----------------------------
2013年9月
//线性表、链表
//栈、队列
//数组、广义表
//串
-------------------------线性表----------------------
typedef struct
{
char name[20];//注意如果应用指针的形式
//在初始化每个结点时一定要先为结点中的每个变量开辟内存空间
char sex;
char addr[100];
unsigned int age;
char phonenum[20];
}node;//结点描述
typedef struct
{
node *p;
int length;//当前顺序表长度
int listsize;//当前分配的线性表长度
}list;//线性表描述
list L;//定义一个线性表
int initlist(list &l)//构造一个空的线性表
{
l.p=(node*)malloc(LIST_INIT_SIZE*sizeof(node));
if(!(l.p))
exit(1);
l.length=0;
l.listsize=LIST_INIT_SIZE;
return true;
}
void destroylist(list &l)//销毁线性表操作
{
if(l.p!=NULL)
{
free(l.p);
printf("销毁成功!\n");
}
else 实用标准
文档大全 printf("线性表不存在!\n");
}
int clearlist(list &l)//将线性表置空操作