
攻击文法与攻击图模型的对比研究
攻击文法与攻击图模型的对比研究1张殷乾,王轶骏,薛质上海交通大学信息安全工程学院,200240【摘要】攻击文法【1】是我们提出的一种保障大型计算机网络安全的分析模型和工具。
与传统的攻击图模型相比,攻击文法有其独特的优势。
本文以近年来国内外的攻击图研究成果为背景,对比分析攻击文法在网络攻击建模、模型描述能力和算法复杂度等方面的优点和不足。
同时,通过回顾理清该领域当前世界最先进的研究思路和发展方向,明确攻击文法的定位,为未来研究奠定基础。
【关键词】网络安全攻击文法攻击图网络攻击建模A Comparative Review of Researches on Attack Grammar and Attack GraphYinqian Zhang Yijun Wang Zhi Xue(School of Information Security Engineering, SJTU, Minhang District, Shanghai, 200240, China)Abstract: Our attack grammar is a new approach to large scale network attack modeling and analysis. Compared with traditional models such as attack graphs, attack grammars have their unique advantages. In this paper we summarize recent researches on attack graphs and compare them with our attack grammar approach in the ability of network attack modeling, attack scenario expressing and scaling. In the mean while, a review of the most advanced techniques in attack graphs is proposed in order to summarize their methodology and to provide a clearer research direction for future studies.Key words: Network security, attack grammar, attack graph, network attack modeling.1.引言计算机网络由于软件和配置漏洞而存在着安全威胁。
在大规模的计算机网络中,黑客的入侵不再是针对一台主机,而是以跳板的方式,一步一步渗透至网络内部。
负责安全防护的网络管理员必须在错综复杂的网络环境中找到所有可能的攻击路径,并在技术和资金允许的情况下优先选择修补最为关键的安全漏洞,或者监控最薄弱的安全环节。
为此目的,学者们设计出了多种安全威胁模型。
这些模型中最重要的就是攻击图。
攻击图是一种用图来表示大型网络中攻击路径的方法【2】。
它利用大型网络的配置和漏洞信息,从全局的角度分析它们的依存关系,找出所有可能的攻击路径,并且为网络管理员提供安全建议。
近年来,攻击图的研究重点主要围绕以下几个问题:一、网络结构和主机配置的自动获取;二、漏洞细节的自动生成;三、攻击图生成算法的扩展性(scalability);四、基于攻击图自动提出网络安全增强建议。
这些研究使攻击图逐步从理论走向了实践。
但是,我们认为攻击图方法本身存在着一定的不足。
首先,对于复杂网络,攻击图的规模往往大到无法控制,使管理员很难理解图的内容。
第二,攻击图中普遍存在冗余信息,加大了分析的1作者简介:张殷乾(1983.7-),男,硕士研究生,主要研究领域为网络与信息安全(email: stanielzhang@)。
王轶骏(1980.9-),讲师,主要研究网络与信息安全。
薛质(1971.2-),教授,博士生导师,主要研究网络与信息安全。
难度。
第三,攻击图不能有效表达漏洞间的依赖关系,不适合用于入侵检测系统(IDS)报警关联。
为此,我们提出了一种基于上下文无关文法的网络攻击模型和安全分析系统——攻击文法【1】。
攻击文法能够从一个新的角度去解决攻击图模型固有的问题,为该领域带来了新的思路。
2.攻击图研究回顾根据攻击图的基本研究方法分类,可以把攻击图研究分为两类:基于图的方法和基于逻辑的方法。
2.1 基于图的方法早期的基于图的方法研究攻击图的代表是Swiler和Phillips等人在1998年提出的方法【4】【5】,他们用网络的状态变量的集合来建模攻击图的结点,用黑客的动作来建模攻击图的边。
该方法的运行时间对网络的规模具有指数特征。
Ammann提出的基于图搜索的方法,假设网络攻击具有单调性,即黑客在攻击过程中不会放弃已经获得的权限。
这种假设在大多数的网络攻击场景中都适用,同时大大降低了算法的复杂度。
Jajodia等人提出的TV A系统【6】就结合了这种假设并且设计出O(N6)的算法。
2006年,麻省理工学院提出使用预测图(predictive graph)的NetSPA v1【7】和使用了多重先决条件图(Multiple-prerequisite graph,简称MP图) 的NetSPA v2【2】。
NetSPA v2是一个端到端的攻击图生成和分析工具。
它解决了以往攻击图研究中的网络数据自动采集问题和攻击图生成算法扩展性的问题。
它定义了更为简单的网络模型,方便系统自动采集网络数据;它采用MP图来代替NetSPA v1的预测图,使攻击图的生成算法几乎达到O(N)。
NetSPA的网络模型中包括了主机,端口和漏洞。
这些信息可以由Nessus扫描结果得到。
模型还定义了漏洞利用的两种先决条件——可达性和信用凭证。
可达性可以由防火墙配置得到;信用凭证用来建模用于访问控制的密码或者私钥。
NetSPA简化了漏洞的前提和影响结果,并采用自动化工具来提取NVD和Bugtraq漏洞库中的文本信息中的关键内容。
MP图包含了三种不同的结点:状态结点、先决条件结点和漏洞实例结点。
状态结点代表黑客在主机上的权限。
与状态结点通过有向边连接的先决条件结点表示黑客在该状态上可获得的先决条件,它可以是一个可达性条件,也可以是一个信用凭证。
与先决条件结点连接的漏洞实例结点表示该先决条件可以利用的漏洞。
漏洞实例结点通过有向边与新的状态结点相连。
NetSPA提供了把网络模型转化为MP图的算法。
算法的复杂度最坏情况下是O(max(V,T )NC),其中V代表漏洞实例的个数,T代表端口数,C代表信任凭证的数目,N代表主机群的个数。
实验数据表明NetSPA的性能非常好,可以在数秒内完成对数百台主机的安全检测和分析。
2.2 基于逻辑的方法早期的基于逻辑的方法大都源于模型检查。
Ritchey和Ammann等人提出使用模型检查器来为已知的漏洞生成攻击路径【8】。
Sheyner的工作【3】扩展了模型检查,但是模型检查没有假设网络攻击具有单调性,所以这些方法扩展性都不好,一个3台主机和4个漏洞的实例需要运行2个小时才能得到攻击图。
2005年Ou等人提出了MulV AL【9】。
MulV AL是一种基于逻辑的网络安全分析器。
它是一个端到端的多主机、多层次的网络安全分析架构和推理系统。
它使用Datalog作为建模语言,能够结合网络扫描器自动收集网络数据,并转化为Datalog语言描述的网络模型。
MulV AL 把网络模型输入给推理引擎,其推理规则假设了网络攻击的单调性。
引擎输出结果是该网络的一条攻击路径。
MulVUL具有强大的网络数据采集能力。
它能够整合开放漏洞评估语言(OV AL)兼容的网络扫描工具,把OV AL描述的漏洞信息和主机配置信息整合为Datalog描述的语句。
它还能够自动提取ICAT漏洞数据库的漏洞描述,为扫描得到的漏洞提供前提条件和影响结果的细节。
性能优势是MulV AL系统的一个特点。
实验数据显示,MulV AL的算法复杂度在O(N2)到O(N3)之间。
对于2000台主机的模拟网络运行时间大约在15秒左右。
MulV AL的缺陷在于它仅仅给出了一条攻击路径,而不是产生一个完整的攻击图。
另外,它在最坏情况下的复杂度也可能是指数的。
X. Ou进一步扩展了MulV AL【10】,把其生成的攻击路径拓展成为攻击图。
论文证明,生成攻击图的算法的复杂度为O(N2logN)。
3.攻击文法我们提出一种基于下推自动机(PDA)的网络攻击模型和利用上下文无关文法进行安全分析的工具——攻击文法。
攻击文法的工具如图所示。
Nessus图1 攻击文法工具组成3.1 网络模型和攻击文法攻击文法的网络模型中,主机是网络中可能受到攻击的网络实体,主机具有网络接口、端口和漏洞等属性。
主机群是具有相同可达性和相同漏洞的主机的集合。
模型中的漏洞使用前提条件和影响结果来描述,这两者都通过多维向量对象来建模,它们都表示黑客在某台主机上的某种权限或者知识,也称为黑客状态。
模型允许同时存在多个攻击目标。
攻击文法工具能够自动的把网络信息建模到PDA中。
一个攻击模型PDA定义为一个7元组:(S, Σ, Γ, δ, q0, Z0, F), 其中S是状态集合,代表网络攻击场景中的主机群。
Σ是输入符号的集合,代表漏洞或者对应的漏洞利用。
Γ是栈顶符号的集合,代表黑客状态。
δ是转移函数(Σ×S×Γ)→ (S×Γ)的集合,描述了一个漏洞利用的过程。
q0是初始状态,代表黑客的初始攻击点,Z0是栈中的初始符号,用于定义“空栈”接受的语言。
F是S的子集,表示终结状态。
攻击文法定义为一个四元组:(V, T, R, S),其中V是文法中变量的集合,T是终结变量的集合,R是产生式的集合,S是初始符号。
攻击文法与PDA模型具有相同的描述能力。
攻击模型PDA描述了一个网络的攻击场景,如果一系列攻击动作对应的输入符号串能够被PDA所接受,那么这个攻击序列就能够使黑客从他的初始状态成功入侵目标主机;相应的,这个攻击序列应该是该网络的攻击文法所能够生成的一个句子。
我们的工具能够自动的把描述网络攻击模型的PDA转化为攻击文法。
自动生成的攻击文法往往非常庞大,我们设计了一系列的攻击文法简化算法,包括去除可空变量、去除无逻辑意义变量、去除非产生变量、去除非可达变量,目的是使攻击文法更简约明了,其变量更具有实际意义。
简化后的攻击文法中,一个终结变量代表了黑客入侵中可能利用的一种漏洞,一个非终结变量代表了黑客在攻击过程中的一种状态,这个状态能够与网络中的某台主机上的某种权限对应。
BLP模型实现方法的研究
论文分类号:TP39单位代码 1 0 1 8 3密级:公开研究生学号2004532174吉林大学硕士学位论文BLP模型实现方法的研究Research of Bayesian Logic Program Model Realization作者姓名:李丽娜专业:计算机应用技术导师姓名:刘大有及职称:教授学位类别:工学硕士论文起止年月:2005年9月至2007年4月吉林大学硕士学位论文原创性声明本人郑重声明:所呈交的硕士学位论文,是本人在指导教师的指导下,独立进行研究工作所取得的成果。
除文中已经注明引用的内容外,本论文不包含任何其他个人或集体已经发表或撰写过的作品成果。
对本文的研究做出重要贡献的个人和集体,均已在文中以明确方式标明。
本人完全意识到本声明的法律结果由本人承担。
学位论文作者签名:日期:2007 年 4 月 20 日《中国优秀博硕士学位论文全文数据库》投稿声明研究生院:本人同意《中国优秀博硕士学位论文全文数据库》出版章程的内容,愿意将本人的学位论文委托研究生院向中国学术期刊(光盘版)电子杂志社的《中国优秀博硕士学位论文全文数据库》投稿,希望《中国优秀博硕士学位论文全文数据库》给予出版,并同意在《中国博硕士学位论文评价数据库》和CNKI 系列数据库中使用,同意按章程规定享受相关权益。
论文级别:■硕士□博士学科专业:计算机应用技术论文题目:BLP模型实现方法的研究作者签名:指导教师签名:2007年 4 月 20 日作者联系地址(邮编):吉林省长春市吉林大学前卫校区计算机科学与技术学院 130012作者联系电话:************作者姓名李丽娜论文分类号TP39保密级别公开研究生学号2004532174 学位类别工学硕士授予学位单位吉林大学专业名称计算机应用技术培养单位(院、所、中心)计算机科学与技术学院研究方向数据挖掘学习时间2004年9月至2007年6月论文中文题目 BLP模型实现方法的研究论文英文题目Research of Bayesian Logic Program Model Realization 关键词(3-8个) 贝叶斯逻辑程序,归纳逻辑,贝叶斯网姓名刘大有职称教授导师情况学历学位硕士工作单位计算机科学与技术学院论文提交日期 2007年4月答辩日期2007年6月日是否基金资助项目是基金类别及编号国家自然科学基金项目(60573073)如已经出版,请填写以下内容出版地(城市名、省名)出版者(机构)名称出版日期出版者地址(包括邮编)提 要BLP(Bayesian logic program)模型结合贝叶斯网和确定子句逻辑理论,以确定子句逻辑作为知识表示语言,以贝叶斯网建模不确定性,是表示现实世界问题的有效一阶概率模型。
基于迁移学习的小样本DGA恶意域名检测方法

收稿日期:2020-04-15 修回日期:2020-05-28 文章编号:1002-8331(2021)14-0103-07
104 2021,57(14)
Computer Engineering and Applications 计算机工程与应用
域名对僵尸网络、钓鱼网络、勒索软件等恶意网络 活动的构建起着重要的作用。为了更好地隐蔽网络攻 击,恶意域名通常会使用一些方法以躲避安全人员的封 堵,域名生成算法(Domain Generation Algorithm,DGA) 就是一种常用的手段[1]。通过特定算法和强随机性的种 子,嵌入在恶意程序中的 DGA 可以生成大量域名,其中 只有一部分域名会被用来注册。当某个恶意域名被甄 别并加入黑名单拦截后,攻击者仍可使用 DGA 生成的 新的恶意域名进行通信和攻击,因此很难通过黑名单的 方式有效实现对攻击的拦截。
摘 要:域名生成算法(DGA)存在变化多、部分类别样本难获取的特点,使得采用传统机器学习的恶意域名检测模 型准确性不高。提出一种基于迁移学习和多核 CNN 的小样本 DGA 恶意域名检测模型。该模型将目标域名映射到 向量空间中,使用样本充足的 DGA 种类进行预训练,并迁移预训练得到的参数到小样本检测模型。采用多核 CNN 小样本分类模型根据发音习惯进行域名特征提取并分类。通过实验对比发现 ,无知识迁移的小样本分类模型只有 11 类域名准确率超过 92%,经过迁移学习的多核 CNN 模型 20 类准确率超过 92%,11 类准确率超过 97%,检测效果接 近数据充足时的分类效果。 关键词:恶意域名 ;卷积神经网络 ;迁移学习 ;域名生成算法 ;小样本学习 文献标志码:A 中图分类号:TP393 doi:10.3778/j.issn.1002-8331.2004-0209
网络攻防原理与技术课件最新版第8章身份认证与口令攻击
Kerberos认证协议
安全性分析
一旦用户获得过访问某个服务器的许可证, 只要在许可证的有效期内,该服务器就可根 据这个许可证对用户进行认证,而无需KDC 的再次参与;
实现了客户和服务器间的双向认证; 支持跨域认证; 应用广泛,互操作性好。
Kerberos认证协议
安全性分析
Kerberos认证中使用的时间戳机制依赖于域 内时钟同步,如果时间不同步存在较大的安 全风险;
第 八 章 身份认证与口令攻击
内容提纲
1 身份认证 2 口令行为规律和口令猜测
3 口令破解 4 口令防御
身份认证
一个系统的安全性常常依赖于对终端用户身份的正确识别 与检查。对计算机系统的访问必须根据访问者的身份施加 一定的限制,这些是最基本的安全问题。
身份认证一般涉及两方面的内容:识别和验证。 识别:识别是指要明确访问者是谁,即必须对系统中 的每个合法用户都有识别能力。 要保证识别的有效性,必须保证任意两个不同的用 户都不能具有相同的识别符。 验证:验证是指在访问者声称自己的身份后(向系统输 入它的识别符),系统还必须对它所声称的身份进行验 证,以防假冒。
脆弱口令行为
口令构造的偏好性选择:口令字符构成
表8-4 中英文用户口令的字符组成结构(文献[52]的表3,表中数据单位为%)
脆弱口令行为
口令构造的偏好性选择:口令长度
表8-5 中英文用户口令的长度分布(文献[52]的表4,表中数据单位为%)
脆弱口令行为
口令重用:
为了方便记忆,用户不可避免地使用流行密码 ,在不同网站重复使用同一个密码,同时在密 码中嵌入个人相关信息,如姓名和生日等
S/KEY
基本原理
S/KEY
安全性分析
【计算机工程与设计】_状态转换_期刊发文热词逐年推荐_20140726
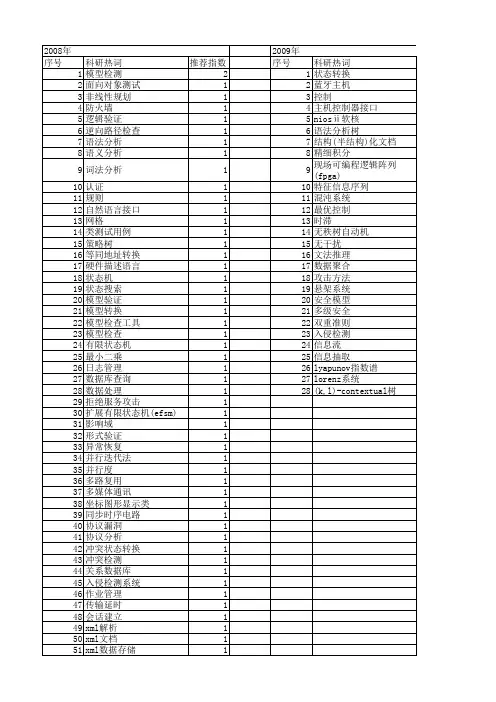
科研热词 状态转换 蓝牙主机 控制 主机控制器接口 niosⅱ软核 语法分析树 结构(半结构)化文档 精细积分 现场可编程逻辑阵列(fpga) 特征信息序列 混沌系统 最优控制 时滞 无秩树自动机 无干扰 文法推理 数据聚合 攻击方法 悬架系统 安全模型 多级安全 双重准则 入侵检测 信息流 信息抽取 lyapunov指数谱 lorenz系统 (k,l)-contextual树
2008年 序号 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52
2012年 序号 1 2 3 4 5
科研热词 阈值设定 自动解码Hale Waihona Puke 光电转换 光学解码器 三值光学计算机
推荐指数 1 1 1 1 1
2013年 序号 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25
科研热词 静态分析 转向延误 策略调整 策略分析 空间定位 状态流 混杂petri网 水箱液位控制 树突状细胞算法 权限控制 有限状态机 最优路径 智能搜索 无标识 无序数据集 无向petri网 数据融合 异常检测 建模 安全增强的linux系统 姿势识别 大屏幕投影环境 危险理论 动态仿真模块 使能规则
推荐指数 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1
2014年 序号 1 2 3 4
2014年 科研热词 自动化测试 爬行捕获算法 测试路径 ajax应用程序 推荐指数 1 1 1 1
多模态藏语情感分类的研究

多模态藏语情感分类的研究作者:拉桑吉安见才让来源:《计算机时代》2022年第10期摘要:在藏文自然语言处理领域内,目前情感分类的研究只有单一的文本和图像模态,采用方法也是传统的机器学习分类算法。
然而评论数据一般是多模态的。
本文选用基于神经网络的藏文情感分类(FCNNMSCTT)、情感表情图像分类(CNNMEITSA)、融合(FUSIONMODEL)三种模型对多模态藏语情感分类数据进行情感分类。
最终实验结果是,FCNNMSCTT准确率达到了56%,CNNMEITSA准确率达到了88.75%。
Fusion model准确率达到了96.98%。
关键词:藏文情感分类; 表情图像情感分类; 神经网络模型; 多模态数据集中图分类号:TP391.41;TP391.1;TP18 文献标识码:A 文章编号:1006-8228(2022)10-98-05Research on multimodal emotion classification of Tibetan languageRa Sangji Anjian Cairang(1. School of computer, Qinghai University for Minzu, Xining, Qinghai 810007, China;2. Qinghai Key Laboratory of Tibetan information processing and machine translation;3. State Key Laboratory of Tibetan intelligent information processing and Application)Abstract: In the field of Tibetan natural language processing, the research of emotion classification has only a single text and image mode, and the method used is also the traditional machine learning classification algorithm. However, comment data are generally multimodal. In this paper, three models of FCNNMSCTT, CNNMEITSA and FUSIONMODEL are used to classify the multimodal Tibetan emotion classification data. The experimental results show that the accuracy of FCNNMSCTT, CNNMEITSA, and FUSIONMODEL are 56%, 88.75%, and 96.98%,respectively.Key words: Tibetan emotion classification; emotion classification of expression image; neural network model; multimodal data set0 引言近年來,深度学习体现出较为优异的学习表现,越来越多的研究人员开始倾向使用神经网络来学习文本或者图像的特征用于情感分类。
Sum-Product Networks模型的研究及其在文本分类的应用
Sum-Product Networks模型的研究及其在文本分类的应用李俊【摘要】Graph model is wide used in the area of machinepared with Graph model, the model of Sum-Product Networks is more representative and faster than graph model, thus it is widely used to model text and image data. This paper firstly summarizes the research progress of Sum-Product Networks, new deep probability model, and then introduces the method of parameter learning with fixed structure of SPN and the method of structure learning based on different input data for Sum-Product Networks. At last, the paper introduces the application of discriminant Sum-Product Networks in text classification.%图模型在机器学习有着广泛的应用。
相比图模型,Sum-Product Networks模型具有更强表达能力和更快的推理速度,所以其在对文本和图像数据建模有着广泛的应用。
本文总结Sum-Product Networks这一新的深度概率模型的研究进展,先介绍了固定结构的Sum-Product Networks的参数学习方法,再介绍了根据不同的输入数据而进行的结构和参数学习方法。
计算机学科的12个核心概念
Binding 绑定通过将一个抽象的概念与附加特性相联系,从而使一个抽象概念具体化的过程。
例如,把一个进程与一个处理机、一种类型与一个变量名.一个库目标程序与子程序中的一个符号引用等分别关联起来。
在逻辑程序设计中,用面向对象语言将一个方法与一个消息相关联,从抽象的描述建立具体的实例。
绑定有时又译为联编、结合等。
然而译为绑定既可表音,乂能达义,在计算机专业英语的汉译中能达到这一境界的诚然不多。
绑定在许多计算机领域中都存在太多的实例。
面向对象程序设计中的多态性特征将这一概念发挥得淋漓尽致。
程序在运行期间的多态性取决于函数名与函数体相关联的动态性,只有支持动态绑定的程序设计语言才能表达运行期间的多态性,而传统语言通常只支持函数名与函数体的静态绑定[5]。
还可为绑定找到一个更通俗的实例。
将配偶这一抽象概念与某位异性相关联,这一过程称作绑定。
指腹为婚是为静态绑定,自山恋爱是为动态绑定。
现有的面向对象程序设讣语言都不允许离婚或重婚,但在一定程度上允许再婚。
□Complexity of Large Problems 大问题的复杂性随着问题规模的增长,复杂性呈非线性增加的效应。
这是区分和选择各种方法的重要因素。
以此来度量不同的数据规模、问题空间和程序规模。
假如我们编写的程序只是处理全班近百人的成绩排序,选择一个最简单的排序算法就可以了。
但如果我们编写的程序负责处理全省儿十万考生的高考成绩排序,就必须认真选择一个排序算法,因为随着数据量的增大,一个不好的算法的执行时间可能是按指数级增长的,从而使你最终无法忍受等待该算法的输出结果。
软件设计中的许多机制正是面向复杂问题的。
例如在一个小小程序中标识符的命名原则是无关重要的,但在一个多人合作开发的软件系统中这种重要性会体现出来;goto语句自山灵活、随意操控,但实践证明了在复杂程序中控制流的无序弊远大于利;结构化程序设计已取得不错成绩,但在更大规模问题求解时保持解空间与问题空间结构的一致性显得更重要。
【计算机科学】_网络安全评估_期刊发文热词逐年推荐_20140726
科研热词 进展 路由 美国国家漏洞数据库 网络攻击效果 测试评估 模糊集合 标准化 机密性 智能算法 完整性 安全 多路径 可用性 可信计算平台 可信计算 可信度 入侵检测系统 信任链 ad hoc
推荐指数 2 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1
2010年 序号 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46
推荐指数 3 3 2 2 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1
2011年 序号 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52
科研热词 攻击图 网络安全 风险评估 跨层优化 超轻量级 贝叶斯网络 认证协议 行为预测 蚁群优化算法 网络编码 网络安全风险评估 用户行为 混杂系统 模糊网络分析法 模糊时间混合petri网 机器学习 最优攻击路径 无线传感器网络 攻防对抗信息 攻防对抗 性能评估 射频识别 实时评估 安全风险概率 安全评估 威胁评估 多agent 可靠性评估 可靠传输协议 可视化 可信评估 协作通信 动态攻击图 入侵检测 信息融合 信息物理融合系统 交叉 云贝叶斯网络 云计算 云模型 manet ban逻辑
常用统计翻译模型在口语汉英翻译中的比较研究
常用 统 计 翻 译模 型 在 口语 汉 英 翻 译 中 的 比较 研 究
李
摘
俊 ,薛永增 ,赵铁军
( 尔滨工业 大 学 计算机 科 学与技 术 学院 语 音语 言教 育部微 软重 点 实验 室, 龙江 哈 尔滨 100 ) 哈 黑 50 1
要 :通过 汉语到 英语 的翻译 实验 以及 对 结果译 文的 分析 , 对基 于词 的模 型 、 于短语 的 模 型和 基 于 句 法的 基
维普资讯
第 2 第 6期 4卷
20 年 6 月 07
计 算 机 应 用 研 究
Ap l a in Re e r h o mp t m p i t s a c fCo u e c o
Vo
中图分 类号 :T 3 12 P9 .
文献标 志码 :A
文章编 号 :10 -65 20 )606 -3 0 139 (07 0 —090
C mp r t e Su y o tt t a r n lt n Mo es o o a ai t d fS ai i lT a sai d l n v sc o
模型 的翻 译性 能进行 了比较 。结果表 明基 于短语 的模 型性 能优 于其他 两 个模 型 , 是使 用的 参数 较 多; 于句 但 基 法 的模 型 虽然翻 译性 能不理 想 , 可 以用较 少的参数 表达 更丰 富 的信 息 , 但 值得 深入研 究。
关键 词 : 自然语 言 处理 ;统计 机 器翻译 ;翻 译模 型 ;句法分 析 器
机器翻译 的 目标就是 将给定 的一个 源语言 文本翻译 成 目
标语言文本 。对 汉英翻译来说 , 输入一个 汉语 句子 C c , (7 m为 句子长度 ) 可能会有很多英语译文 e e , , ( n为句子长度 )统 计 , 机器 翻译 的任务 是在所有可能 的译文 中, 找到最佳译 文。根据
信息安全考试题
一、填空题1.计算机犯罪是指非法侵入受国家保护的重要计算机信息系统及破坏计算机信息系统并造成严重后果的应受刑法处罚的危害社会的行为。
2.侵入计算机信息系统罪是指违反国家规定,侵入国家事务、国防建设、尖端科学技术领域的计算机信息系统的行为。
3.破坏计算机信息系统罪是指破坏计算机信息系统功能,破坏计算机数据、程序和制作、传播计算机病毒等犯罪行为。
4.以计算机为工具的犯罪是指利用计算机实施金融诈骗、盗窃、贪污、挪用公款、窃取国家秘密等犯罪行为。
5.计算机犯罪都可以毫无疑问地被称为高智能犯罪。
6.隐私权在性质上是绝对权,其核心内容是对自己的隐私有依照自己的意志进行支配的权利,其他任何人都不得侵犯。
7.通过信息安全立法,可使国家在信息空间的利益与社会的相关公共利益不受威胁和侵犯,并得到积极的保护。
8.计算机病毒是一段附着在其他程序上的可以实现自我繁殖的程序代码。
9.计算机病毒是指编制或者在计算机程序中插入的破坏计算机功能或者数据,影响计算机使用并且能够自我复制的一组计算机指令或者程序10.计算机先驱冯·诺依曼在《复杂自动机组织论》论文中提出了能自我复制的计算机程序的构想,这实际上就是计算机病毒程序。
11.安全的范围涉及数据的安全、对数据的随机访问限制和对未授权访问的控制等问题。
12.移位密码的加密方法是将明文字母按某种方式进行移位。
13.根据水印嵌入图像的方式不同,目前的水印技术大致分为空间域技术和变换域技术。
14.密钥的存储不同于一般的数据存储,需要保密存储。
15.iSignature电子签章系统是一套基于 Windows 平台采用ActiveX技术开发的应用软件。
16.抑制电磁干扰的方法一是采用屏蔽技术,二是采用接地技术。
17.程序设计错误漏洞是程序员在编写程序时由于技术上的疏忽而造成的。
18.PPTP只能在IP网络上传输。
19.Web安全技术主要包括 Web服务器安全技术、Web应用服务安全技术和Web浏览器安全技术。