
论述一元线性回归的基本步骤
论述一元线性回归的基本步骤
一元线性回归是一种统计学方法,用来描述两个变量之间的线性关系,并建立相应的回归模型。
基本的步骤包括:
(1)确定数据源和变量:从数据源中收集相关的数据,并确定要进行研究的变量:x代表自变量,y代表因变量。
(2)进行各种统计分析:绘制散点图或残差图,用于可视化数据并判断是否存在线性关系;同时,计算出x与y之间的相关系数,试图发现x与y 之间的关联,以确定是否存在线性回归关系。
(3)拟合线性模型:使用常见的最小二乘法方法根据已有数据估计线性模型,即拟合误差平方和最小化的拟合直线,从而得到线性回归模型。
(4)检验线性模型:检验线性模型的有效性是至关重要的一步,可以检验残差图的正态分布假设、小概率假设和模型假设,可以构建R2、F值、AIC和BIC等指标,以进一步确定模型的有效性。
(5)预测新数据:如果经过上述模型检验发现线性模型是有效的,则可以用该模型预测新数据的结果。
总的来说,一元线性回归的基本步骤主要是确定数据源和变量,进行各种统计分析,拟合线性模型,检验模型的有效性,最后利用模型预测新的数据。
origin线性拟合的斜率和截距

origin线性拟合的斜率和截距
求origin线性拟合的斜率和截距,是求解一元线性回归问题的
基本步骤。
一元线性回归问题的模型可以表示为:y=ax+b,
其中a为斜率,b为截距。
要求求解origin线性拟合的斜率和截距,首先需要准备足够的
数据,即x和y的值,并将其分别放入x和y的数组中。
然后,根据x和y的值,计算出x的平均值和y的平均值,分别记为
x_mean和y_mean。
接下来,根据x和y的值,计算出x和y的方差,分别记为
x_var和y_var,以及x和y的协方差,分别记为x_cov和
y_cov。
最后,根据以上计算出的x_mean、y_mean、x_var、y_var、
x_cov和y_cov,可以计算出origin线性拟合的斜率a和截距b,其计算公式分别为:
a=x_cov/x_var
b=y_mean-a*x_mean
因此,求origin线性拟合的斜率和截距,需要准备足够的数据,并计算出x的平均值、y的平均值、x的方差、y的方差、x的
协方差和y的协方差,最后根据以上计算出的值,可以计算出origin线性拟合的斜率和截距。
基于一元线性回归模型预测工程项目的造价

(3)进行线性回归分析:利用最小二乘法对自变量和因变量进行线性回归分 析,得到回归模型的参数a和b。
(4)验证模型:利用历史数据对模型进行训练和预测,并计算预测误差,以 验证模型的准确性和可靠性。
2、提取影响工程项目造价的关 键因素
工程项目造价受到多种因素的影响,包括工程量、材料价格、人工成本、市场 环境等。在一元线性回归模型中,我们需要根据历史数据和实际情况,提取对 工程项目造价影响最为显著的关键因素作为自变量。
(3)地区差异性:不同地区的工程项目造价可能存在较大差异,因此模型的 适用范围可能受到限制。未来可以考虑建立地区特定的模型,以提高模型的适 用性。
结论
本次演示基于一元线性回归模型预测工程项目的造价,通过提取影响工程项目 造价的关键因素,建立回归模型并利用历史数据进行训练和预测。结果表明, 一元线性回归模型在工程项目造价预测中具有较好的准确性,但同时也存在一 定的局限性。未来可以进一步完善模型结构,考虑更多影响因素,提高模型的 预测精度和适用范围。
接下来,利用得到的模型参数,我们对测试集进行预测。对于每个测试项目, 我们根据其工程量、材料价格和人工成本等数据,代入回归模型计算出预测的 工程造价。将预测值与实际值进行比较,可得到模型的预测误差。
4、分析预测结果及模型局限性
通过计算,我们得到了模型的预测误差为10%,表明一元线性回归模型在工程 项目造价预测中具有较好的准确性。但同时我们也发现模型的预测结果存在一 定的偏差,这可能与以下因素有关:
谢谢观看
结论与展望
一元线性回归模型在经济预测中具有广泛的应用价值,其能够通过对历史数据 的分析,揭示变量之间的线性关系,并以此为依据对未来趋势进行预测。然而, 需要注意的是,这种模型的应用也存在一定的局限性。例如,它无法处理非线 性关系和复杂因素的影响,对于一些不确定性和变化性较大的经济现象可能无 法得出准确的预测结果。
总结:线性回归分析的基本步骤

线性回归分析的基本步骤步骤一、建立模型知识点:1、总体回归模型、总体回归方程、样本回归模型、样本回归方程 ①总体回归模型:研究总体之中自变量和因变量之间某种非确定依赖关系的计量模型。
Y X U β=+特点:由于随机误差项U 的存在,使得Y 和X 不在一条直线/平面上。
例1:某镇共有60个家庭,经普查,60个家庭的每周收入(X )与每周消费(Y )数据如下:作出其散点图如下:②总体回归方程(线):由于假定0EU =,因此因变量的均值与自变量总处于一条直线上,这条直线()|E Y X X β=就称为总体回归线(方程)。
总体回归方程的求法:以例1的数据为例,求出E (Y |X 由于01|i i i E Y X X ββ=+,因此任意带入两个X i 和其对应的E (Y |X i )值,即可求出01ββ和,并进而得到总体回归方程。
如将()()222777100,|77200,|137X E Y X X E Y X ====和代入()01|i i i E Y X X ββ=+可得:01001177100171372000.6ββββββ=+=⎧⎧⇒⎨⎨=+=⎩⎩以上求出01ββ和反映了E (Y |X i )和X i 之间的真实关系,即所求的总体回归方程为:()|170.6i i i E Y X X =+,其图形为:③样本回归模型:总体通常难以得到,因此只能通过抽样得到样本数据。
如在例1中,通过抽样考察,我们得到了20个家庭的样本数据:那么描述样本数据中因变量Y 和自变量X 之间非确定依赖关系的模型ˆY X e β=+就称为样本回归模型。
④样本回归方程(线):通过样本数据估计出ˆβ,得到样本观测值的拟合值与解释变量之间的关系方程ˆˆY X β=称为样本回归方程。
如下图所示:⑤四者之间的关系:ⅰ:总体回归模型建立在总体数据之上,它描述的是因变量Y 和自变量X 之间的真实的非确定型依赖关系;样本回归模型建立在抽样数据基础之上,它描述的是因变量Y 和自变量X 之间的近似于真实的非确定型依赖关系。
线性回归分析的基本步骤
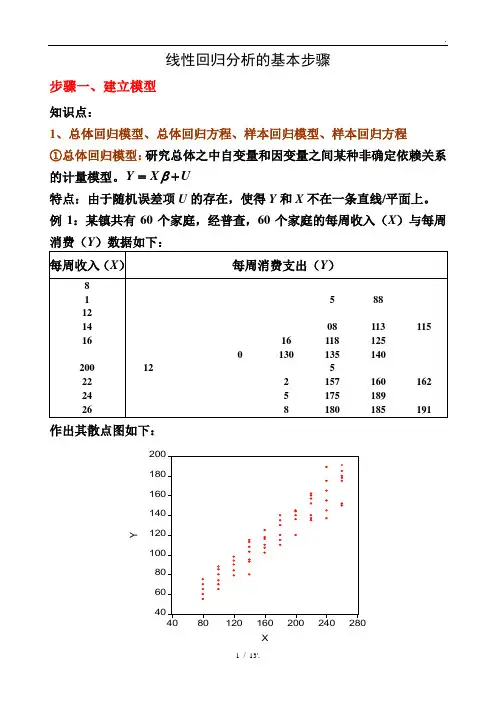
线性回归分析的基本步骤步骤一、建立模型知识点:1、总体回归模型、总体回归方程、样本回归模型、样本回归方程 ①总体回归模型:研究总体之中自变量和因变量之间某种非确定依赖关系的计量模型。
Y X U β=+特点:由于随机误差项U 的存在,使得Y 和X 不在一条直线/平面上。
例1:某镇共有60个家庭,经普查,60个家庭的每周收入(X )与每周消费(Y )数据如下:作出其散点图如下:②总体回归方程(线):由于假定0EU =,因此因变量的均值与自变量总处于一条直线上,这条直线()|E Y X X β=就称为总体回归线(方程)。
总体回归方程的求法:以例1的数据为例 由于01|i i i E Y X X ββ=+,因此任意带入两个X i 和其对应的E (Y |X i )值,即可求出01ββ和,并进而得到总体回归方程。
如将()()222777100,|77200,|137X E Y X X E Y X ====和代入()01|i i i E Y X X ββ=+可得:01001177100171372000.6ββββββ=+=⎧⎧⇒⎨⎨=+=⎩⎩以上求出01ββ和反映了E (Y |X i )和X i 之间的真实关系,即所求的总体回归方程为:()|170.6i i i E Y X X =+,其图形为:③样本回归模型:总体通常难以得到,因此只能通过抽样得到样本数据。
如在例1中,通过抽样考察,我们得到了20个家庭的样本数据:那么描述样本数据中因变量Y 和自变量X 之间非确定依赖关系的模型ˆY X e β=+就称为样本回归模型。
④样本回归方程(线):通过样本数据估计出ˆβ,得到样本观测值的拟合值与解释变量之间的关系方程ˆˆY X β=称为样本回归方程。
如下图所示:⑤四者之间的关系:ⅰ:总体回归模型建立在总体数据之上,它描述的是因变量Y 和自变量X 之间的真实的非确定型依赖关系;样本回归模型建立在抽样数据基础之上,它描述的是因变量Y 和自变量X 之间的近似于真实的非确定型依赖关系。
统计学 一元线性回归

第11章 一元线性回归
第一节 变量间关系的度量 第二节 一元线性回归 第三节 利用回归方程进行估计和预测 第四节 残差分析
学习内容
1. 相关关系的分析方法 2. 一元线性回归的基本原理和参数的最小二乘估计 3. 回归直线的拟合优度 4. 回归方程的显著性检验 5. 利用回归方程进行估计和预测 6. 残差分析
r (x x)(y y) (x x)2 (y y)2
或化简为 r
n xy x y
n x2 x2 n y2 y2
相关系数的性质
性质1:r 的取值范围是 [-1,1]
|r|=1,为完全相关 r =1,为完全正相关 r =-1,为完全负相关
r = 0,讨论:r=0意为着什么?
3. 利用所求的关系式,根据一个或几个变量的 取值来预测或控制另一个特定变量的取值, 并给出这种预测或控制的精确程度。
回归分析的特点:
(1)相关分析所研究的两个变量是对等关系。 回归分析所研究的两个变量不是对等关系, 必须根据研究目的,先确定其中一个是自变 量,另一个是因变量。
(2)对两个变量x和y 来说,相关分析只能计算出一 个相关系数,计算中改变x和y 的地位不影响相关系 数的数值; 回归分析则不同,有时可以根据研究目的不同 分别建立两个不同的回归方程。即以x为自变量,y 为因变量,则可以得出y倚x 的回归方程;若以y 为 自变量,x为因变量,则可以得出x倚y 的回归方程。
影响
是不能由 x 和 y 之间的线性关系所解释的变异性 b0 和 b1 称为模型的参数
一元线性回归模型
(基本假定)
1. 因变量x与自变量y之间具有线性关系 2. 在重复抽样中,自变量x的取值是固定的,即假定x是非
计量经济学第二篇一元线性回归模型

第二章 一元线性回归模型2.1 一元线性回归模型的基本假定有一元线性回归模型(统计模型)如下, y t = β0 + β1 x t + u t上式表示变量y t 和x t 之间的真实关系。
其中y t 称被解释变量(因变量),x t 称解释变量(自变量),u t 称随机误差项,β0称常数项,β1称回归系数(通常未知)。
上模型可以分为两部分。
(1)回归函数部分,E(y t ) = β0 + β1 x t ,(2)随机部分,u t 。
图2.1 真实的回归直线这种模型可以赋予各种实际意义,居民收入与支出的关系;商品价格与供给量的关系;企业产量与库存的关系;身高与体重的关系等。
以收入与支出的关系为例。
假设固定对一个家庭进行观察,随着收入水平的不同,与支出呈线性函数关系。
但实际上数据来自各个家庭,来自同一收入水平的家庭,受其他条件的影响,如家庭子女的多少、消费习惯等等,其出也不尽相同。
所以由数据得到的散点图不在一条直线上(不呈函数关系),而是散在直线周围,服从统计关系。
“线性”一词在这里有两重含义。
它一方面指被解释变量Y 与解释变量X 之间为线性关系,即另一方面也指被解释变量与参数0β、1β之间的线性关系,即。
1ty x β∂=∂,221ty β∂=∂0 ,1ty β∂=∂,2200ty β∂=∂2.1.2 随机误差项的性质随机误差项u t 中可能包括家庭人口数不同,消费习惯不同,不同地域的消费指数不同,不同家庭的外来收入不同等因素。
所以在经济问题上“控制其他因素不变”是不可能的。
随机误差项u t 正是计量模型与其它模型的区别所在,也是其优势所在,今后咱们的很多内容,都是围绕随机误差项u t 进行了。
回归模型的随机误差项中一般包括如下几项内容: (1)非重要解释变量的省略,(2)数学模型形式欠妥, (3)测量误差等,(4)随机误差(自然灾害、经济危机、人的偶然行为等)。
2.1.3 一元线性回归模型的基本假定通常线性回归函数E(y t ) = β0 + β1 x t 是观察不到的,利用样本得到的只是对E(y t ) =β0 + β1 x t 的估计,即对β0和β1的估计。
建立一元线性回归模型
建立一元线性回归模型
建立一元线性回归模型的步骤如下:
1.选择自变量和因变量:确定自变量和因变量之间的关系,并准备
好数据。
2.计算自变量的平均值和标准差,因变量的平均值和标准差:使用
公式计算自变量和因变量的平均值和标准差。
3.计算自变量和因变量的相关系数:使用公式计算自变量和因变量
的相关系数。
4.计算回归系数:使用公式计算回归系数。
5.建立回归方程:使用计算得到的回归系数和自变量的平均值,建
立回归方程。
6.对回归方程进行检验:使用残差平方和、残差平均值、残差标准
差和相关系数等指标对回归方程进行检验。
7.进行预测:使用建立的回归方程进行预测,得出因变量的预测值。
8.对预测结果进行评估:使用预测误差、预测精度、预测准确率等
指标对预测结果进行评估。
总的来说,建立一元线性回归模型的过程包括选择自变量和因变量、计算自变量和因变量的平均值和标准差、计算自变量和因变量的相关系数、计算回归系数、建立回归方程、对回归方程进行检验、进行预测和对预测结果进行评估。
一元线性回归分析的作用方法步骤
一元线性回归分析的作用方法步骤一元线性回归分析是一种用来探究两个变量之间关系的统计方法。
它基于一个假设,即两个变量之间存在线性关系。
以下是一元线性回归分析的一般步骤:1. 数据收集:首先,需要收集所需的数据。
需要考虑收集的数据是否与研究目的相关,并确保数据的准确性和完整性。
2. 变量定义:定义自变量和因变量。
自变量是用来预测因变量的变量,而因变量是我们想要预测或解释的变量。
3. 数据探索:进行数据探索,包括数据的描述性统计和绘图。
这一步可以帮助我们了解数据的分布、异常值和离群点。
4. 模型选择:选择适当的线性模型。
这可以通过查看散点图、相关性分析和领域知识来完成。
通常,一个线性模型可以用以下方程表示:Y = β0 + β1X + ε,其中Y是因变量,X是自变量,β0和β1是回归系数,ε是误差项。
5. 模型估计:使用最小二乘法来估计回归系数。
最小二乘法的目标是找到最佳拟合直线,使得预测值与实际值之间的残差平方和最小化。
6. 模型评估:评估模型的拟合优度。
常用的指标包括R平方值和调整R平方值。
R平方值介于0和1之间,表示因变量变异性的百分比可以由自变量解释。
调整R平方值是对R平方值的修正,考虑了自变量的数量和样本量。
7. 模型解释:根据回归系数的估计值,解释自变量对因变量的影响。
根据回归系数的正负和大小,可以确定变量之间的关系是正向还是负向,并量化这种关系的强度。
8. 结果验证:验证模型的有效性和稳健性。
这可以通过对新数据集的预测进行测试,或使用交叉验证的方法来完成。
9. 结果解释:对模型结果进行解释,提供有关回归系数的结论,并解释模型对现实世界问题的意义。
总结来说,一元线性回归分析的方法步骤包括数据收集、变量定义、数据探索、模型选择、模型估计、模型评估、模型解释、结果验证和结果解释。
它们相互关联,构成了一元线性回归分析的完整过程。
一元线性回归方程
n
n
避免其偏离差(有正误差、负误差)相互抵消,采用偏离差平方和 Q(a ,b) ( yi yi )2
i 1
i 1
( yi a bxi )2(也称残差平方和)来刻画观测值(xi ,yi )与直线 y a bx 的偏离程度 . 一般
所说的回归直线就是使 Q(a ,b) 最小的直线,求所需回归直线的截距和斜率,就转化成了求使
Lxx (4)写出回归(估计)方程 y a bx .
一元线性回归方程
1.2 线性相关关系的显著性检验
从以上建立回归直线方程的过程不难看出,用最小二乘法所建立的回归直线方程,只是通 过一组样本观察值 (xi ,yi ) (i 1,2 , ,n) 来建立的 . 变量 x 与 y 之间是否存在线性关系,或者 其线性关系是否显著,还需进行检验.常用的线性相关关系的显著性检验有两种方法,即 F 检 验法和相关系数检验法 . 在此仅介绍相关系数检验法 .
0, 0.
即nan b a i1 xi
n
n
xi yi ,
i 1
i 1
n
n
b xi2 xi
i 1
i 1
yi
,取
x
y
1 n 1 n
n
i 1 n
i 1
xi , yi .
一元线性回归方程
n
n
n
n xi yi xi yi
n
xi yi nx y
b
解之得
i 1
,
即Q(a ,b) Lyy (1 R2 ) .
一元线性回归方程
n
n
因为Q(a ,b) ( yi yi )2 0 ,Lyy ( yi y)2 0 ,
i 1
计量经济学一元线性回归模型总结
第一节 两变量线性回归模型一.模型的建立1.数理模型的基本形式y x αβ=+ (2.1)这里y 称为被解释变量(dependent variable),x 称为解释变量(independent variable)注意:(1)x 、y 选择的方法:主要是从所研究的问题的经济关系出发,根据已有的经济理论进行合理选择。
(2)变量之间是否是线性关系可先通过散点图来观察。
2.例如果在研究上海消费规律时,已经得到上海城市居民1981-1998年期间的人均可支配收入和人均消费性支出数据(见表1),能否用两变量线性函数进行分析?表1.上海居民收入消费情况年份 可支配收入 消费性支出 年份 可支配收入 消费性支出 1981 636.82 585 1990 2181.65 1936 1982 659.25 576 1991 2485.46 2167 1983 685.92 615 1992 3008.97 2509 1984 834.15 726 1993 4277.38 3530 1985 1075.26 992 1994 5868.48 4669 19861293.24117019957171.91586819871437.09128219968158.746763 19881723.44164819978438.896820 19891975.64181219988773.168662.一些非线性模型向线性模型的转化一些双变量之间虽然不存在线性关系,但通过变量代换可化为线性形式,这些双变量关系包括对数关系、双曲线关系等。
例3-2 如果认为一个国家或地区总产出具有规模报酬不变的特征,那么采用人均产出y与人均资本k的形式,该国家或者说地区的总产出规律可以表示为下列C-D生产函数形式y Akα=(2.2)也就是人均产出是人均资本的函数。
能不能用两变量线性回归模型分析这种总量生产规律?3.计量模型的设定 (1)基本形式:y x αβε=++ (2.3) 这里ε是一个随机变量,它的数学期望为0,即(2.3)中的变量y 、x 之间的关系已经是不确定的了。