
并查集
void join(int x,int y) { //判断 x y 是否连通 //如果已经连通,就不用管了 //如果不连通,就把它们所在的连通分支合并起来 int fx=find(x),fy=find(y); if(fx!=fy) pre[fx ]=fy; } 为了解释并查集的原理,我将举一个更有爱的例子。 话说江湖上散落着各式各样的大侠,有上千个之多。他们没有什么正当职业,整天背着 剑在外面走来走去,碰到和自己不是一路人的,就免不了要打一架。但大侠们有一个优点就 是讲义气,绝对不打自己的朋友。而且他们信奉“朋友的朋友就是我的朋友”,只要是能通过 朋友关系串联起来的,不管拐了多少个弯,都认为是自己人。这样一来,江湖上就形成了一 个一个的群落,通过两两之间的朋友关系串联起来。而不在同一个群落的人,无论如何都无 法通过朋友关系连起来,于是就可以放心往死了打。但是两个原本互不相识的人,如何判断 是否属于一个朋友圈呢?我们可以在每个朋友圈内推举出一个比较有名望的人, 作为该圈子 的代表人物,这样,每个圈子就可以这样命名“齐达内朋友之队”“罗纳尔多朋友之队”……两 人只要互相对一下自己的队长是不是同一个人,就可以确定敌友关系了。 但是还有问题啊,大侠们只知道自己直接的朋友是谁,很多人压根就不认识队长,要判 断自己的队长是谁,只能漫无目的的通过朋友的朋友关系问下去: “你是不是队长?你是不 是队长?”这样一来,队长面子上挂不住了,而且效率太低,还有可能陷入无限循环中。于 是队长下令,重新组队。队内所有人实行分等级制度,形成树状结构,我队长就是根节点, 下面分别是二级队员、三级队员。每个人只要记住自己的上级是谁就行了。遇到判断敌友的 时候,只要一层层向上问,直到最高层,就可以在短时间内确定队长是谁了。由于我们关心 的只是两个人之间是否连通,至于他们是如何连通的,以及每个圈子内部的结构是怎样的, 甚至队长是谁,并不重要。所以我们可以放任队长随意重新组队,只要不搞错敌友关系就好 了。于是,门派产生了。
还是举江湖的例子,假设现在武林中的形势如图所示。虚竹小和尚与周芷若 MM 是我 非常喜欢的两个人物,他们的终极 boss 分别是玄慈方丈和灭绝师太,那明显就是两个阵营 了。我不希望他们互相打架,就对他俩说:“你们两位拉拉勾,做好朋友吧。”他们看在我的 面子上,同意了。这一同意可非同小可,整个少林和峨眉派的人就不能打架了。这么重大的 变化,可如何实现呀,要改动多少地方?其实非常简单,我对玄慈方丈说: “大师,麻烦你 把你的上级改为灭绝师太吧。这样一来,两派原先的所有人员的终极 boss 都是师太,那还 打个球啊!反正我们关心的只是连通性,门派内部的结构不要紧的。”玄慈一听肯定火大了: “我靠,凭什么是我变成她手下呀,怎么不反过来?我抗议!”抗议无效,上天安排的,最大。 反正谁加入谁效果是一样的,我就随手指定了一个。这段函数的意思很明白了吧? void join(int x,int y)//我想让虚竹和周芷若做朋友 { int fx=find(x),fy=find(y); //虚竹的老大是玄慈,芷若 MM 的老大是灭绝 if(fx!=fy)//玄慈和灭绝显然不是同一个人 pre[fx ]=fy;//方丈只好委委屈屈地当了师太的手下啦 } 再来看看路径压缩算法。建立门派的过程是用 join 函数两个人两个人地连接起来的, 谁当谁的手下完全随机。最后的树状结构会变成什么胎唇样,我也完全无法预计,一字长蛇 阵也有可能。 这样查找的效率就会比较低下。 最理想的情况就是所有人的直接上级都是掌门, 一共就两级结构,只要找一次就找到掌门了。哪怕不能完全做到,也最好尽量接近。这样就 产生了路径压缩算法。 设想这样一个场景:两个互不相识的大侠碰面了,想知道能不能揍。 于是赶紧打电话问自己的上级:“你是不是掌门?” 上级说:“我不是呀,我的上级是谁谁谁,你问问他看看。” 一路问下去,原来两人的最终 boss 都是东厂曹公公。 “哎呀呀,原来是记己人,西礼西礼,在下三营六组白面葫芦娃!” “幸会幸会,在下九营十八组仙子狗尾巴花!” 两人高高兴兴地手拉手喝酒去了。 “等等等等,两位同学请留步,还有事情没完成呢!”我叫住他俩。 “哦,对了,还要做路径压缩。”两人醒悟。 白面葫芦娃打电话给他的上级六组长:“组长啊,我查过了,其习偶们的掌门是曹公公。 不如偶们一起及接拜在曹公公手下吧,省得级别太低,以后查找掌门麻环。” “唔,有道理。” 白面葫芦娃接着打电话给刚才拜访过的三营长……仙子狗尾巴花也做了同样的事情。 这样, 查询中所有涉及到的人物都聚集在曹公公的直接领导下。 每次查询都做了优化处 理,所以整个门派树的层数都会维持在比较低的水平上。路径压缩的代码,看得懂很好, 看 不懂也没关系,直接抄上用就行了。总之它所实现的功能就是这么个意思。
{ int n,m,p1,p2,i,total,f1,f2; while(scanf("%d",&n) && n)//读入 n,如果 n 为0,结束 { //刚开始的时候,有 n 个城镇,一条路都没有 //那么要修 n-1条路才能把它们连起来 total=n-1; //每个点互相独立,自成一个集合,从1编号到 n //所以每个点的上级都是自己 for(i=1;i<=n;i++) { pre[i ]=i; } //共有 m 条路 scanf("%d",&m); while(m--) { //下面这段代码,其实就是 join 函数,只是稍作改动以适应题目要求 //每读入一条路,看它的端点 p1,p2是否已经在一个连通分支里了 scanf("%d %d",&p1,&p2); f1=find(p1); f2=find(p2); //如果是不连通的,那么把这两个分支连起来 //分支的总数就减少了1,还需建的路也就减了1 if(f1!=f2) { pre[f2 ]=f1; total--; } //如果两点已经连通了,那么这条路只是在图上增加了一个环 //对连通性没有任何影响,无视掉 } //最后输出还要修的路条数 printf("%d\n",total); } return 0; }
下面我们来看并查集的实现。 int pre[1000]; 这个数组,记录了每个大侠的上级是谁。大侠们从 1 或者 0 开始编号(依据题意而定) , pre[15]=3 就表示 15 号大侠的上级是 3 号大侠。如果一个人的上级就是他自己,那说明他就 是掌门人了,查找到此为止。也有孤家寡人自成一派的,比如欧阳锋,那么他的上级就是他 自己。 每个人都只认自己的上级。 比如胡青牛同学只知道自己的上级是杨左使。 张无忌是谁? 不认识!要想知道自己的掌门是谁,只能一级级查上去。 find 这个函数就是找掌门用的,意义再清楚不过了(路径压缩算法先不论,后面再说) 。 int find(int x) { //查找根节点 int r=x; while (pre[r ]!=r)//如果我的上级不是掌门 r=pre[r ];//我就接着找他的上级,直到找到掌门为止。 //返回根节点 return r;//掌门驾到~~~ } 再来看看 join 函数,就是在两个点之间连一条线,这样一来,原先它们所在的两个板 块的所有点就都可以互通了。这在图上很好办,画条线就行了。但我们现在是用并查集来描 述武林中的状况的,一共只有一个 pre[]数组,该如何实现呢?
并查集是我暑假从高手那里学到的一招, 觉得真是太精妙的设计了。 以前我无法解决的一 类问题竟然可以用如此简单高效的方法搞定。不分享出来真是对不起 party 了。 (party:我 靠,关我嘛事啊?我跟你很熟么?) 来看一个实例,杭电 1232 畅通工程 /showproblem.php?pid=1232 首先在地图上给你若干个城镇, 这些城镇都可以看作点, 然后告诉你哪些对城镇之间是 有道路直接相连的。最后要解决的是整幅图的连通性问题。比如随意给你两个点,让你判断 它们是否连通,或者问你整幅图一共有几个连通分支,也就是被分成了几个互相独立的块。 像畅通工程这题,问还需要修几条路,实质就是求有几个连通分支。如果是 1 个连通分支, 说明整幅图上的点都连起来了,不用再修路了;如果是 2 个连通分支,则只要再修 1 条路, 从两个分支中各选一个点,把它们连起来,那么所有的点都是连起来的了;如果是 3 个连通 分支,则只要再修两条路…… 以下面这组数据输入数据来说明 42 13 43 第一行告诉你,一共有 4 个点,2 条路。下面两行告诉你, 1、3 之间有条路,4、3 之 间有条路。那么整幅图就被分成了 1-3-4 和 2 两部分。只要再加一条路,把 2 和其他任意一 个点连起来,畅通工程就实现了,那么这个这组数据的输出结果就是 1。好了,现在编程实 现这个功能吧,城镇有几百个,路有不知道多少条,而且可能有回路。 这可如何是好?我以前也不会呀,自从用了并查集之后,嗨,效果还真好!我们全家都 用它! 并查集由一个整数型的数组和两个函数构成。数组 pre[]记录了每个点的前导点是什么, 函数 find 是查找,join 是合并。 int pre[1000 ]; int find(int x) { //查找根节点 int r=x; while (pre[r ]!=r) r=pre[r ]; //路径压缩 int i=x; int j; while(i!=r) { j=pre[i ]; pre[i ]=r; i=j; } //返回根节点 return r; }
回到开头提出的问题,我的代码如下: #include int pre[1000 ]; int find(int x) { int r=x; while (pre[r ]!=r) r=pre[r ]; int i=x; int j; while(i!=r) { j=pre[i ]; pre[i ]=r; i=j; } return r; } int main()
并查集路径压缩优化方法讲解

并查集路径压缩优化方法讲解并查集(Disjoint Set Union)是一种用于解决连通性问题的数据结构,常用于判断图中两个节点是否属于同一个连通分量。
在并查集中,每个节点表示一个元素,通过合并节点来构建集合,实现快速的查找和合并操作。
1. 并查集基本原理并查集最初的实现方法是通过使用树来表示集合,其中每个节点通过指向父节点来建立树结构。
树的根节点表示集合的代表元素,每个节点的父节点指向它所属集合的代表元素。
2. 查找操作查找操作用于找到某个元素所属的集合,即找到该元素的代表元素。
从给定的元素开始,不断向上查找直到找到根节点,即代表元素。
代码示例:```int find(int[] parent, int x) {if (parent[x] == x) {return x;}parent[x] = find(parent, parent[x]); // 路径压缩return parent[x];}```这段代码中的`find`方法使用了递归来实现路径压缩。
路径压缩的核心思想是将查找路径上的每个节点直接指向根节点,从而减少后续的查找时间。
3. 合并操作合并操作用于将两个集合合并成一个,即将两个集合的根节点连接起来。
合并操作可以简单地将一个根节点的父节点指向另一个根节点,从而实现合并。
代码示例:```void union(int[] parent, int x, int y) {int rootX = find(parent, x);int rootY = find(parent, y);if (rootX != rootY) {parent[rootX] = rootY;}}```4. 路径压缩优化路径压缩优化通过将每个节点直接指向根节点,使得查找操作的路径更短。
在常规的实现中,每个节点的父节点都指向其根节点,但这会导致树的高度较高,进而影响查找操作的性能。
路径压缩优化在查找操作中,将经过的节点直接指向根节点,从而使得树的高度减少。
并查集的路径压缩

并查集的路径压缩并查集(Disjoint Set)是一种用于解决“动态连通性”问题的数据结构。
它主要用于维护一个不相交的集合,支持快速判断两个元素是否属于同一个集合,以及合并两个集合。
并查集的路径压缩是一种优化算法,用于减少查找操作的时间复杂度。
1. 并查集基本操作并查集包括以下几种基本操作:初始化并查集、查找元素所属的集合、合并两个集合。
1.1 初始化并查集初始化并查集时,每个元素都是一个独立的集合。
可以使用数组来表示并查集,数组索引表示元素,数组值表示元素所属的集合。
示例:```cppint parent[MAX_SIZE];void init(int n) {for (int i = 0; i < n; i++) {parent[i] = i;}}```在上述示例中,`MAX_SIZE`表示并查集的最大容量,`init`函数用于初始化并查集。
1.2 查找元素所属的集合查找元素所属的集合时,可以通过递归的方式查找祖先节点,直到找到根节点。
示例:```cppint find(int x) {return parent[x] == x ? x : find(parent[x]);}```在上述示例中,`find`函数用于查找元素所属的集合,递归调用`find`函数可以找到根节点。
1.3 合并两个集合合并两个集合时,可以通过将一个根节点的父节点指向另一个根节点,将两个集合合并为一个集合。
示例:```cppvoid merge(int x, int y) {int root_x = find(x);int root_y = find(y);if (root_x != root_y) {parent[root_x] = root_y;}}```在上述示例中,`merge`函数用于合并两个集合,首先找到两个集合的根节点,然后将一个根节点的父节点指向另一个根节点。
2. 并查集路径压缩并查集的路径压缩是一种优化算法,通过将节点在查找的过程中直接指向根节点,减少后续查找的时间复杂度。
NOCOW_并查集
并查集并查集是一种树型的数据结构,用于处理一些不相交集合(Disjoint Sets)的 合并及查询问题。
常常在使用中以森林来表示。
[编辑]并查集的主要操作1. 合并两个不相交集合 2. 判断两个元素是否属于同一集合 [编辑]主要操作的解释及代码需要注意的是,一开始我们假设元素都是分别属于一个独立的集合里的。
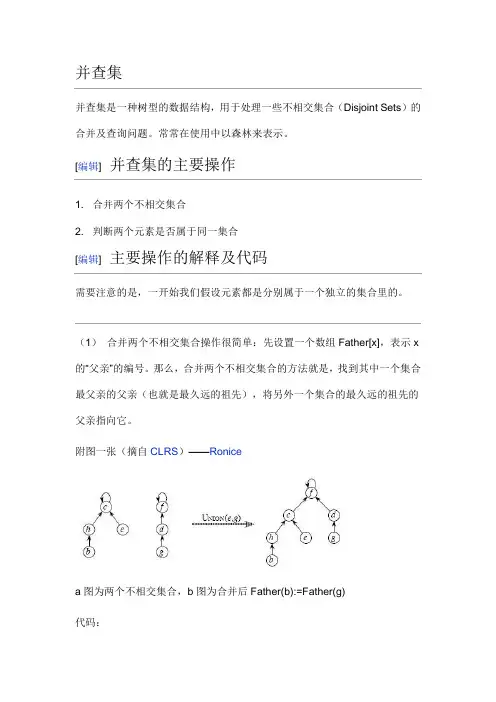
(1) 合并两个不相交集合操作很简单:先设置一个数组 Father[x],表示 x 的“父亲”的编号。
那么,合并两个不相交集合的方法就是,找到其中一个集合 最父亲的父亲(也就是最久远的祖先),将另外一个集合的最久远的祖先的 父亲指向它。
附图一张(摘自 CLRS)——Ronicea 图为两个不相交集合,b 图为合并后 Father(b):=Father(g) 代码:Procedure Union(x,y:integer);{其中 GetFather 是下面将讲到的操作} var fx,fy : integer; begin fx := GetFather(x); fy := GetFather(y); If fx<>fy then Father[fx] := fy;{指向最祖先的祖先} end;(2) 判断两个元素是否属于同一集合仍然使用上面的数组。
则本操作即可 转换为寻找两个元素的最久远祖先是否相同。
可以采用递归实现。
(有待补 图,制作中)代码:Function Same(x,y:integer):boolean; begin if GetFather(x)=GetFather(y) then exit(true else true) true exit(false false); false end;[编辑]并查集的优化(1)路径压缩 刚才我们说过,寻找祖先时采用递归,但是一旦元素一多起来,或退化成一 条链, 每次 GetFather 都将会使用 O (n) 的复杂度, 这显然不是我们想要的。
并查集的两种实现(按秩合并+路径压缩)

并查集的两种实现(按秩合并+路径压缩)并查集:就是有求并集,查找元素属于哪个集合的功能。
1、路径压缩:使X到根上的每⼀个节点的⽗节点都变为根节点。
查询:void Find(int x){if(a[x]==0) return x;else return a[x]=Find(a[x]);}合并:void Merge(int x,int y){int t1=Find(x),t2=Find(y);if(t1!=t2) a[t1]=t2;}2、按秩合并:使较浅的树成为较深的树的⼦树。
查询:void Find(int x){if(a[x]==0) return x;else return a[x]=Find(a[x]);}合并:void Merge(int x,int y){int t1=Find(x),t2=Find(y);if(t1!=t2){if(rank[t1]<=rank[t2]) a[t1]=t2,rank[t2]=max(rank[t2],rank[t1]+1);else a[t2]=t1,rank[t1]=max(rank[t1],rank[t2]+1);}}例题:解法⼀:路径压缩#include<iostream>#include<cstdio>#include<cstring>using namespace std;const int maxn = 1200;int fa[maxn];int f(int x){if(fa[x]==0) return x;else return fa[x]=f(fa[x]);}int main(void){int n,m,t1,t2,i,x,y;while(~scanf("%d",&n)&&n){scanf("%d",&m);memset(fa,0,sizeof(fa));while(m--){scanf("%d%d",&x,&y);t1=f(x),t2=f(y);if(t1!=t2) fa[t1]=t2;}int cnt=0;for(i=1;i<=n;i++){if(fa[i]==0) cnt++;}printf("%d\n",cnt-1);}return0;}View Code解法⼆:按秩求和#include<iostream>#include<cstdio>#include<cstring>using namespace std;const int maxn = 1200;int fa[maxn],rk[maxn];int f(int x){if(fa[x]==0) return x;else return fa[x]=f(fa[x]);}int MAX(int x,int y){return x>y?x:y;}int main(void){int n,m,x,y,t1,t2,i;while(~scanf("%d",&n)&&n){scanf("%d",&m);memset(fa,0,sizeof(fa));memset(rk,0,sizeof(rk));while(m--){scanf("%d%d",&x,&y);t1=f(x),t2=f(y);if(t1!=t2){if(rk[t1]<=rk[t2]) fa[t1]=t2,rk[t1]=MAX(rk[t1],rk[t2]+1);else fa[t2]=t1,rk[t2]=MAX(rk[t2],rk[t1]+1);}}int cnt=0;for(i=1;i<=n;i++)if(fa[i]==0) cnt++;printf("%d\n",cnt-1);}return0;}View Code。
并查集的应用探讨并查集在实际问题中的应用场景
并查集的应用探讨并查集在实际问题中的应用场景并查集的应用探讨:并查集在实际问题中的应用场景一、引言并查集(Disjoint Set)是一种常用的数据结构,主要用于解决集合的合并与查询问题。
它在实际问题中有着广泛的应用,本文将探讨并查集在实际问题中的应用场景。
二、并查集简介并查集是一种用于处理集合的数据结构,它支持三种操作:查找(Find)、合并(Union)和创建(MakeSet)。
其中查找用于找到元素所属的集合,合并用于将两个集合合并为一个集合,创建则用于创建一个新的集合。
三、应用场景一:网络连通性问题在计算机网络中,经常需要判断两个主机是否能够互相通信或者是否处于同一个网络中。
通过使用并查集来处理网络连通性问题,可以快速判断两个主机是否连通,从而进行相应的网络配置。
以一个局域网中多个主机的连通性判断为例,将每个主机看作一个节点,使用并查集来管理它们的连通关系。
当两个主机通过网络连接后,可以通过合并这两个主机所在的集合,即执行Union操作,将它们放在同一个连通分量中。
当需要判断两个主机是否连通时,只需要执行Find操作判断它们是否属于同一个连通分量即可。
四、应用场景二:社交网络中的朋友圈在社交网络中,人们经常需要查找自己与他人的关系是否存在连接,如朋友圈等。
通过利用并查集,可以快速构建和查询人际关系,判断两个人是否属于同一个朋友圈。
将每个人看作一个节点,使用并查集来管理它们的社交关系。
当两个人成为朋友时,即执行Union操作,将它们放在同一个朋友圈中。
当需要判断两个人是否属于同一个朋友圈时,只需要执行Find操作,判断它们是否属于同一个连通分量即可。
五、应用场景三:图的连通分量在图论中,连通分量是指无向图中的一组顶点,其中任意两个顶点之间都存在路径。
通过并查集,可以快速找到图中的连通分量,从而进行相应的图分析和处理。
以社交网络中用户之间的关注关系为例,将每个用户看作一个节点,使用并查集来管理它们的关系。
并查集__Union-Find_Sets_

对于并查集来说,每个集合用一棵树表示。 对于并查集来说,每个集合用一棵树表示。 集合中每个元素的元素名分别存放在树的结 点中,此外, 点中,此外,树的每一个结点还有一个指向其 双亲结点的指针。 双亲结点的指针。 为此,需要有两个映射: 为此,需要有两个映射: 集合元素到存放该元素名的树结点间的对 应; 集合名到表示该集合的树的根结点间的对 应。 设 S1= {0, 6, 7, 8 },S2= { 1, 4, 9 },S3= { 2, 3, , , 5}
O(∑ i ) = O( n )
2 i =1
n
Union操作的加权规则 Union操作的加权规则
为避免产生退化的树, 为避免产生退化的树,改进方法是先判断两集合中元素 的个数, 的个数,如果以 i 为根的树中的结点个数少于以 j 为根 的树中的结点个数, 的树中的结点个数,即parent[i] > parent[j],则让 j 成为 , i 的双亲,否则,让i成为 的双亲。 的双亲,否则, 成为 的双亲。 成为j的双亲 此即Union的加权规则。 此即 的加权规则
下标
0
123ຫໍສະໝຸດ 4567
8
9
parent - 1
4
-1 2
-1 2
0
0 0
4
集合S1, S2和 S3的双亲表示
S1 U S2的可能的表示方法
®
const int DefaultSize = 10; class UFSets { //并查集的类定义 并查集的类定义 public: UFSets ( int s = DefaultSize ); ~UFSets ( ) { delete [ ] parent; } const UFSets & operator = ( UFSets const & Value ); void Union ( int Root1, int Root2 ); int Find ( int x ); void UnionByHeight ( int Root1, int Root2 ); private: int *parent; int size; };
js 并查集写法 -回复
js 并查集写法-回复JS并查集写法并查集是一种用于解决元素分组问题的数据结构,它可以高效地合并集合并判断两个元素是否属于同一集合。
在本文中,我们将详细讨论如何使用JavaScript实现并查集。
1. 基本实现在开始之前,我们需要创建一个类来表示并查集。
该类将包含以下两个主要方法:`find`和`union`。
`find`方法用于查找元素所属的集合。
如果两个元素属于同一集合,则它们具有相同的根节点。
`union`方法用于合并两个集合。
它接受两个元素作为参数,并将它们所属的集合合并为一个集合。
下面是一个基本的并查集实现:class UnionFind {constructor(size) {this.parent = new Array(size);for(let i = 0; i < size; i++) {this.parent[i] = i;}}find(x) {while(this.parent[x] !== x) {x = this.parent[x];}return x;}union(x, y) {let rootX = this.find(x);let rootY = this.find(y);if(rootX !== rootY) {this.parent[rootX] = rootY;}}}2. 使用示例现在我们来使用上面的并查集实现解决一个具体的问题。
假设我们有一组人员,每个人员都有一个唯一的标识符。
我们希望能够判断两个人员是否属于同一组。
首先,我们需要创建一个并查集对象,并将人员的数量作为参数传递给它。
javascriptlet uf = new UnionFind(10);现在,我们可以使用`union`方法合并两个人员所属的组:javascriptuf.union(1, 2); 合并1和2所属的组uf.union(3, 4); 合并3和4所属的组uf.union(1, 4); 合并1和4所属的组最后,我们可以使用`find`方法来判断两个人员是否属于同一组:javascriptconsole.log(uf.find(1) === uf.find(2)); trueconsole.log(uf.find(3) === uf.find(4)); trueconsole.log(uf.find(1) === uf.find(3)); false3. 优化上面的基本实现在合并操作时的效率较低,会导致并查集的高度过高。
并查集与的连通性问题
并查集与的连通性问题并查集与图的连通性问题在图论中,连通性问题是一个非常重要的概念。
它研究的是在一个图中,任意两个节点是否存在路径相连。
而解决这类问题的一种常用数据结构就是并查集。
一、并查集的基本概念并查集(Disjoint Set Union)是一种树型的数据结构,常用于处理不相交集合的合并与查询问题。
它可以高效地判断两个元素是否处于同一集合,并进行集合的合并操作。
在并查集中,每个节点都有一个指针指向它的父节点,如果一个节点的父节点为自己,则代表该节点是集合的代表元素。
为了提高效率,还可以使用路径压缩和按秩合并两种优化策略。
二、并查集的操作1. 初始化操作首先,我们需要将每个元素初始化为一个单独的集合,也就是每个元素的父节点都指向自己。
2. 查找操作查找操作用于判断两个元素是否属于同一个集合。
它通过一层一层地往上查找,直到找到根节点,根节点就是集合的代表元素。
3. 合并操作合并操作用于将两个集合合并为一个集合。
首先需要找到两个元素所在集合的代表元素,然后将其中一个代表元素的父节点指向另一个代表元素。
三、并查集解决连通性问题在图的连通性问题中,可以使用并查集来快速判断两个节点是否连通。
具体步骤如下:1. 初始化并查集,将每个节点都初始化为一个独立的集合。
2. 遍历图中的所有边,对于每条边 (u,v),找到 u 和 v 所在集合的代表元素。
3. 如果 u 和 v 的代表元素相同,则说明 u 和 v 已经连通,否则将 u 和 v 所在的集合合并。
4. 重复步骤2和步骤3,直到遍历完所有的边。
通过以上操作,就可以得到一个具有连通性信息的图。
在实际应用中,我们可以使用并查集来判断网络中是否存在通路、判断图中是否存在回路等。
四、应用场景举例并查集在算法和数据结构中有广泛的应用场景,例如:1. 最小生成树:使用 Kruskal 算法或者 Prim 算法来构造最小生成树时,可以使用并查集来判断各个节点之间是否连通。
信息学奥赛一本通 第4章 第5节 并查集(C++版)
具体程序如下:
#include<iostream>
#include<cstdio>
using namespace std;
#define maxn 20001
int father[maxn];
int m,n,i,x,y,q;
/*
int find(int x)
/用非递归的实现
{
while (father[x] != x) x = father[x];
并查集的基本思想
优化的具体程序如下:
#include<iostream>
#include<cstdio>
using namespace std;
#define maxn 20001
int father[maxn];
int m,n,i,x,y,q;
/*
int find(int x)
//用非递归的实现
路径压缩实际上是在找完根结点之后,在递归回来的时候顺便把路径上元素的 父亲指针都指向根结点。
这就是说,我们在“合并5和3”的时候,不是简单地将5的父亲指向3,而是直 接指向根节点1,如图:
1
2
3
5
4
由此我们得到了一个复杂度几乎为常数的算法。
【程序清单】 (1)初始化:
for (i = 1; i <= n; i++) father[i] = i; 因为每个元素属于单独的一个集合,所以每个元素以自己作为根结点。
并查集的基本思想
(2)寻找根结点编号并压缩路径: int find (int x) { if (father[x] != x) father[x] = find (father[x]); return father[x]; }
并查集应用场景全面梳理
并查集应用场景全面梳理在计算机科学领域中,并查集是一种常用的数据结构,用于解决一些集合相关的问题。
并查集主要用于维护一组不相交的动态集合,并支持合并两个集合以及查询两个元素是否属于同一集合的操作。
本文将全面梳理并查集的应用场景,并介绍它们在不同领域的实际应用。
一、社交网络中的好友圈关系建立与查询在社交网络中,人与人之间存在着好友关系。
通过并查集可以方便地建立和查询好友圈关系。
首先,我们可以将每个人看作一个节点,利用并查集建立这些节点之间的关系。
当两个人成为好友时,我们将它们所在的两个集合进行合并操作。
通过查询某两个人是否属于同一个集合,我们就可以判断他们是否在同一个好友圈中。
二、电子地图中的连接性问题解决在电子地图中,我们经常需要判断两个地点之间是否存在路径。
并查集可以用来解决这个连接性问题。
我们可以将地图上的每个地点看作一个节点,利用并查集来表示各个地点的连接关系。
当两个地点之间存在路径时,我们将它们所在的两个集合进行合并操作。
通过查询两个地点是否属于同一个集合,我们就可以判断它们之间是否存在路径。
三、图像分割与图像压缩在图像处理领域,图像分割和图像压缩是非常重要的应用。
并查集可以用来实现图像分割的算法。
我们可以将图像的像素看作节点,利用并查集来表示各个像素的连通性。
通过对图像像素进行合并操作,将相邻像素划分为同一个集合,从而实现图像分割。
此外,图像压缩也可以借助并查集来实现。
通过将相邻像素合并为同一集合,减少图像中的冗余信息,从而实现图像压缩。
四、互联网网络中的网络连接问题在互联网网络中,我们经常需要处理网络连接的问题。
并查集可以被应用于解决网络连接问题。
我们可以将网络中的每个节点看作一个机器或者设备,利用并查集来表示网络中各个节点的连接关系。
通过对两个节点进行合并操作,将它们所在的集合合并为一个集合,从而建立网络连接。
通过查询两个节点是否属于同一个集合,我们就可以判断它们之间是否存在网络连接。