
最新模式识别实验报告.pdf
[VIP专享]模式识别报告
一、模式识别概论在信息的处理过程中,首先需要解决的就是信息的分类问题。
按“物以类聚”的自然规律,将大容量的信息分门别类,各种类别的信息分别归集在一起,然后找出它们内部的规律,以及它们相互之间的规律,然后按规律建立模型,进行生产过程的操作和控制,这样才能达到事半功倍的效果。
对具体的个别事物进行观测所得到的具有时间和空间分布的信息称为模式,而把模式所属的类别或同一类中模式的总体称为模式类。
人们为了掌握客观事物,按事物相似的程度组成类别。
模式识别的作用和目的就在于对某一具体事物时将其准确地归入某一类别。
模式识别系统都由两个过程所组成,即设计和实现。
设计是指用一定数量的样本进行分类器的设计。
实现是指用所设计的分类器对待识别的样本进行分类决策。
模式识别系统主要由4个部分组成:数据获取,预处理,特征提取和选择,分类决策。
分类决策就是在特征空间中用统计方法把被识别对象归为某一类别。
基本作法是在样本训练集基础上确定某个判决规则,使按这种判决规则对被识别对象进行分类所造成的错误识别率最小或引起的损失最小。
二、模式识别的方法模式分类是模式识别的主要内容,即将某个模式分到某个模式类中。
在这个过程中首先需要建立样本库,然后根据样本库建立判别函数,这一过程由机器来实现,成为学习过程。
然后对一个未知的新对象分析它的特征,并根据判别函数决定它属于哪一类。
模式分类是一种监督学习的方法。
可用于模式分类的方法有很多,经典的方法有:①统计模式识别统计模式识别方法是受数学中的决策理论启发而产生的一种识别方法。
其基本思想是将特征提取阶段得到的特征向量定义在一个特征空间中,这个空间包含了所有的特征矢量。
不同的特征向量,或者说不同类别的对象,都对应于此空间中的一点。
在分类阶段,则利用统计决策的原理对特征空间进行划分,从而达到识别不同特征对象的目的。
统计识别中应用的统计决策分类理论相对比较成熟,研究的重点是特征提取。
这类方法中常用的方法有贝叶斯分类、线性分类、非线性分类和聚类分析。
模式识别方PCA实验报告
模式识别作业《模式识别》大作业人脸识别方法一 ---- 基于PCA 和欧几里得距离判据的模板匹配分类器一、 理论知识1、主成分分析主成分分析是把多个特征映射为少数几个综合特征的一种统计分析方法。
在多特征的研究中,往往由于特征个数太多,且彼此之间存在着一定的相关性,因而使得所观测的数据在一定程度上有信息的重叠。
当特征较多时,在高维空间中研究样本的分布规律就更麻烦。
主成分分析采取一种降维的方法,找出几个综合因子来代表原来众多的特征,使这些综合因子尽可能地反映原来变量的信息,而且彼此之间互不相关,从而达到简化的目的。
主成分的表示相当于把原来的特征进行坐标变换(乘以一个变换矩阵),得到相关性较小(严格来说是零)的综合因子。
1.1 问题的提出一般来说,如果N 个样品中的每个样品有n 个特征12,,n x x x ,经过主成分分析,将它们综合成n 综合变量,即11111221221122221122n nn n n n n nn ny c x c x c x y c x c x c x y c x c x c x =+++⎧⎪=+++⎪⎨⎪⎪=+++⎩ij c 由下列原则决定:1、i y 和j y (i j ≠,i,j = 1,2,...n )相互独立;2、y 的排序原则是方差从大到小。
这样的综合指标因子分别是原变量的第1、第2、……、第n 个主分量,它们的方差依次递减。
1.2 主成分的导出我们观察上述方程组,用我们熟知的矩阵表示,设12n x x X x ⎡⎤⎢⎥⎢⎥=⎢⎥⎢⎥⎣⎦是一个n 维随机向量,12n y y Y y ⎡⎤⎢⎥⎢⎥=⎢⎥⎢⎥⎣⎦是满足上式的新变量所构成的向量。
于是我们可以写成Y=CX,C 是一个正交矩阵,满足CC ’=I 。
坐标旋转是指新坐标轴相互正交,仍构成一个直角坐标系。
变换后的N 个点在1y 轴上有最大方差,而在n y 轴上有最小方差。
同时,注意上面第一条原则,由此我们要求i y 轴和j y 轴的协方差为零,那么要求T YY =Λ12n λλλ⎡⎤⎢⎥⎢⎥Λ=⎢⎥⎢⎥⎣⎦令T R XX =,则T T RC C =Λ经过上面式子的变换,我们得到以下n 个方程111111212112111221122111121211()0()0()0n n n n n n nn n r c r c r c r c r c r c r c r c r c λλλ-+++=+-++=+++-=1.3 主成分分析的结果我们要求解出C ,即解出上述齐次方程的非零解,要求ij c 的系数行列式为0。
图象处理与模式识别实验报告

数字图像处理一、实验名称:数字图像处理基本操作。
二、实验内容:1、图像转置:将图像的第一行像素变为第一列,第二行变为第二列,以此类推;2、图像拆分:将一幅M×2N的图像拆分为两幅M×N的图像,第一幅对应原图像的1至N列,第二幅对应原图像的N+1至2N 列;3、图像拼接:将两幅尺寸分别为M×N1和M×N2的图像拼接为一幅M×(N1+N2)图像;4、算术操作:分别对图像进行加,减,乘,除四种算术操作;5、几何空间变换:分别对图像进行尺寸,旋转,平移,偏移等操作;6、均值、标准差:求几幅相近图像的均值,标准差,比较并说明图像均值,标准差的意义。
三、实验结果及程序代码1、图像转置:用Matlab中求矩阵转置运算(‘’’)的方法来处理图像对应的矩阵,从而实现图像的转置。
Matlab程序如下:>>clear>>f=imread('001.tif');>>g=f';>>subplot(1,2,1);imshow(f);subplot(1,2,2);imshow(g);实验结果如下图一所示:图一图一中第一幅图像为原图,第二幅图像为原图的转置。
2、图像拆分:处理图像相应的矩阵f,用函数size()求得矩阵的行列数分别为:M、N,取此矩阵的1至N/2列元素为f1,(N/2)+1至N列元素为f2,则矩阵f1,f2所对应的图像即为拆分的结果。
Matlab程序如下:>>clear>>f=imread('001.tif');>>[M,N]=size(f);>>f1=f(:,1:N/2);>>f2=f(:,(N/2)+1:N);>>subplot(1,3,1);imshow(f);subplot(1,3,2);imshow(f1);subplot(1,3,3);imshow(f2);实验结果如下图二所示:图二图二中第一幅图像为原图,第二,三幅图为拆分原图得到的图像。
模式识别报告
标签比例信息最重要的应用:在 non-full bag 情况下,利用比例 信息,可以减少分配的种数。例如有 C 个标签,以及与其对应的有 个未被标记的样本,如果没有标签比例,那么可能分配的种类数有
C
mi
个, 分配后的标签比例也有很多种; 但是如果提前知道标签比例,
那么只有满足标签比例的分配情况才是有效的。如果用
包 Bi 中的样本属于不同的类(
个样本的类标签是未知的,这种包叫做非全包(non-full bags ) , Non-full bag 的情况增加了分类时的不确定性,当标签是均匀分布 时,non-full bag B i 的不确定度更高, 之间的差异最小。
三、贝叶斯网络分类器
在出现数据丢失时,结构期望最大化策略(Structural EM )提 供了一个合适的框架来学习贝叶斯网络。 它包括网络结构和模型参数 的学习。 贝叶斯网络是一种概率网络,它是基于概率推理的图形化网络, 而贝叶斯公式则是这个概率网络的基础。 贝叶斯网络是基于概率推理 的数学模型,所谓概率推理就是通过一些变量的信息来获取其他的概 率信息的过程,基于概率推理的贝叶斯网络(Bayesian network)是为 了解决不定性和不完整性问题而提出的, 它对于解决复杂设备不确定 性和关联性引起的故障有很的优势,在多个领域中获得广泛应用。 贝叶斯网络的建造是一个复杂的任务, 需要知识工程师和领域专 家的参与。在实际中可能是反复交叉进行而不断完善的。 面向设备故 障诊断应用的贝叶斯网络的建造所需要的信息来自多种渠道, 如设备 手册,生产过程,测试过程,维修资料以及专家经验等。首先将设备 故障分为各个相互独立且完全包含的类别 (各故障类别至少应该具有 可以区分的界限) ,然后对各个故障类别分别建造贝叶斯网络模型, 需要注意的是诊断模型只在发生故障时启动, 因此无需对设备正常状 态建模。 通常设备故障由一个或几个原因造成的, 这些原因又可能由 一个或几个更低层次的原因造成。建立起网络的节点关系后,还需要 进行概率估计。 具体方法是假设在某故障原因出现的情况下,估计该 故障原因的各个节点的条件概率, 这种局部化概率估计的方法可以大 大提高效率。
模式识别报告
一、模式识别概论在信息的处理过程中,首先需要解决的就是信息的分类问题。
按“物以类聚”的自然规律,将大容量的信息分门别类,各种类别的信息分别归集在一起,然后找出它们内部的规律,以及它们相互之间的规律,然后按规律建立模型,进行生产过程的操作和控制,这样才能达到事半功倍的效果。
对具体的个别事物进行观测所得到的具有时间和空间分布的信息称为模式,而把模式所属的类别或同一类中模式的总体称为模式类。
人们为了掌握客观事物,按事物相似的程度组成类别。
模式识别的作用和目的就在于对某一具体事物时将其准确地归入某一类别。
模式识别系统都由两个过程所组成,即设计和实现。
设计是指用一定数量的样本进行分类器的设计。
实现是指用所设计的分类器对待识别的样本进行分类决策。
模式识别系统主要由4个部分组成:数据获取,预处理,特征提取和选择,分类决策。
分类决策就是在特征空间中用统计方法把被识别对象归为某一类别。
基本作法是在样本训练集基础上确定某个判决规则,使按这种判决规则对被识别对象进行分类所造成的错误识别率最小或引起的损失最小。
二、模式识别的方法模式分类是模式识别的主要内容,即将某个模式分到某个模式类中。
在这个过程中首先需要建立样本库,然后根据样本库建立判别函数,这一过程由机器来实现,成为学习过程。
然后对一个未知的新对象分析它的特征,并根据判别函数决定它属于哪一类。
模式分类是一种监督学习的方法。
可用于模式分类的方法有很多,经典的方法有:①统计模式识别统计模式识别方法是受数学中的决策理论启发而产生的一种识别方法。
其基本思想是将特征提取阶段得到的特征向量定义在一个特征空间中,这个空间包含了所有的特征矢量。
不同的特征向量,或者说不同类别的对象,都对应于此空间中的一点。
在分类阶段,则利用统计决策的原理对特征空间进行划分,从而达到识别不同特征对象的目的。
统计识别中应用的统计决策分类理论相对比较成熟,研究的重点是特征提取。
这类方法中常用的方法有贝叶斯分类、线性分类、非线性分类和聚类分析。
哈工大模式识别实验报告
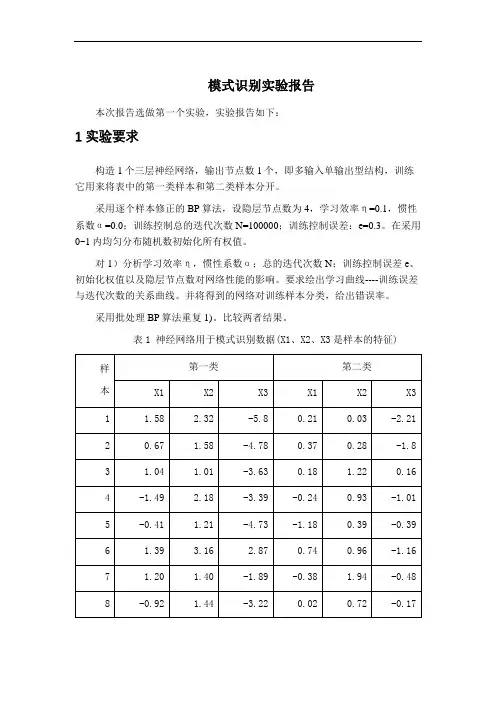
模式识别实验报告本次报告选做第一个实验,实验报告如下:1 实验要求构造1个三层神经网络,输出节点数1个,即多输入单输出型结构,训练它用来将表中的第一类样本和第二类样本分开。
采用逐个样本修正的BP算法,设隐层节点数为4,学习效率η=0.1,惯性系数α=0.0;训练控制总的迭代次数N=100000;训练控制误差:e=0.3。
在采用0~1内均匀分布随机数初始化所有权值。
对1)分析学习效率η,惯性系数α;总的迭代次数N;训练控制误差e、初始化权值以及隐层节点数对网络性能的影响。
要求绘出学习曲线----训练误差与迭代次数的关系曲线。
并将得到的网络对训练样本分类,给出错误率。
采用批处理BP算法重复1)。
比较两者结果。
表1 神经网络用于模式识别数据(X1、X2、X3是样本的特征)2 BP 网络的构建三层前馈神经网络示意图,见图1.图1三层前馈神经网络①网络初始化,用一组随机数对网络赋初始权值,设置学习步长η、允许误差ε、网络结构(即网络层数L 和每层节点数n l );②为网络提供一组学习样本; ③对每个学习样本p 循环a .逐层正向计算网络各节点的输入和输出;b .计算第p 个样本的输出的误差Ep 和网络的总误差E ;c .当E 小于允许误差ε或者达到指定的迭代次数时,学习过程结束,否则,进行误差反向传播。
d .反向逐层计算网络各节点误差)(l jp δ如果l f 取为S 型函数,即xl e x f -+=11)(,则 对于输出层))(1()()()()(l jp jdp l jp l jp l jp O y O O --=δ 对于隐含层∑+-=)1()()()()()1(l kj l jp l jp l jp l jp w O O δδe .修正网络连接权值)1()()()1(-+=+l ip l jp ij ij O k W k W ηδ式中,k 为学习次数,η为学习因子。
η取值越大,每次权值的改变越剧烈,可能导致学习过程振荡,因此,为了使学习因子的取值足够大,又不至产生振荡,通常在权值修正公式中加入一个附加动量法。
模式识别实验报告iris
一、实验原理实验数据:IRIS 数据。
分为三种类型,每种类型中包括50个思维的向量。
实验模型:假设IRIS 数据是正态分布的。
实验准备:在每种类型中,选择部分向量作为训练样本,估计未知的均值和方差的参数。
实验方法:最小错误判别准则;最小风险判别准则。
实验原理:1.贝叶斯公式已知共有M 类别M i i ,2,1,=ω,统计分布为正态分布,已知先验概率)(i P ω及类条件概率密度函数)|(i X P ω,对于待测样品,贝叶斯公式可以计算出该样品分属各类别的概率,叫做后验概率;看X 属于哪个类的可能性最大,就把X 归于可能性最大的那个类,后验概率即为识别对象归属的依据。
贝叶斯公式为M i P X P P X P X P Mj jji i i ,2,1,)()|()()|()|(1==∑=ωωωωω该公式体现了先验概率、类条件概率、后验概率三者的关系。
其中,类条件概率密度函数)|(i X P ω为正态密度函数,用大量样本对其中未知参数进行估计,多维正态密度函数为)]()(21exp[)2(1)(12/12/μμπ---=-X S X SX P T n 式中,),,(21n x x x X =为n 维向量; ),,(21n μμμμ =为n 维均值向量; ]))([(TX X E S μμ--=为n 维协方差矩阵; 1-S是S 的逆矩阵;S 是S 的行列式。
大多数情况下,类条件密度可以采用多维变量的正态密度函数来模拟。
)]}()(21exp[)2(1ln{)|()(1)(2/12/i i X X S X X S X P i T in i ωωπω---=- i i T S n X X S X X i i ln 212ln 2)()(21)(1)(-----=-πωω )(i X ω为i ω类的均值向量。
2.最小错误判别准则① 两类问题有两种形式,似然比形式:⎩⎨⎧∈⇒⎩⎨⎧<>=211221)()()|()|()(ωωωωωωX P P X P X P X l 其中,)(X l 为似然比,)()(12ωωP P 为似然比阈值。
模式识别实验报告1_简单线性分类实验_实验报告(例)
二、实验环境、内容和方法
环境:windows XP,matlab R2007a
内容:有两类样本(如鲈鱼和鲑鱼),每个样本有两个特征(如长度和亮度),每类有若干个(比如20个)样本点,假设每类样本点服从二维正态分布,自己随机给出具体数据,计算每类数据的均值点,并且把两个均值点连成一线段,用垂直平分该线段的直线作为分类边界。再根据该分类边界对一随机给出的样本判别类别。并画出相应的图形。
方法:线性分类器
三、实验过程描述
1.首先用正态分布normrnd产生两类样本,每类样本两个特征。用不同的均值(ax,ay)=(18,8),(bx,by)=(12,20)。并画出两类样本点。
2.然后,求判别分界线y=k*x+b中的k,b的值。分界线垂直于两类样本的均值点的连线。K,b的值分别为:
k=-(bx-ax)/(by-ay)
y2(:,1) = normrnd(by,6,1,20);
%分解线为y=k*x+b
k=-(bx-ax)/(by-ay);%计算类样本均值连线垂直平分线的斜率k
b=(ay+by)/2+(bx^2-ax^2)/(2*by-2*ay);%计算b的值
figure;%画点
plot(x1,y1,'om',...
实验报告(例子)
课程名称:模式识别实验名称:简单线性分类
提交时间:
专业:计算机应用技术年级:2009级姓名:
一、实验目的和要求
目的:设计简单的线性分类器,了解模式识别的基本方法。
要求:
1.产生两类样本,每类样本两个特征。
2.计算每类数据的均值点,并且把两个均值点连成一线段,用垂直平分该线段的直线作为分类边界。
模式识别基础实验报告资料
2015年12月实验一 Bayes 分类器的设计一、 实验目的:1. 对模式识别有一个初步的理解,能够根据自己的设计对贝叶斯决策理论算法有一个深刻地认识;2. 理解二类分类器的设计原理。
二、 实验条件:1. PC 微机一台和MATLAB 软件。
三、 实验原理:最小风险贝叶斯决策可按下列步骤进行:1. 在已知)(i P ω,)|(i X P ω,c i ,,1 =及给出待识别的X 的情况下,根据贝叶斯公式计算出后验概率:∑==c j jj i i i P X P P X P X P 1)()|()()|()|(ωωωωω c j ,,1 =2. 利用计算出的后验概率及决策表,按下式计算出采取i α决策的条件风险: ∑==c j j j i i X P X R 1)|(),()|(ωωαλα a i ,,1 =3. 对2中得到的a 个条件风险值)|(X R i α(a i ,,1 =)进行比较,找出使条件风险最小的决策k α,即:)|(min )|(,,1X R X R k c i k αα ==, 则k α就是最小风险贝叶斯决策。
四、 实验内容:假定某个局部区域细胞识别中正常(1ω)和非正常(2ω)两类先验概率分别为: 正常状态:)(1ωP =0.9;异常状态:)(2ωP =0.1。
现有一系列待观察的细胞,其观察值为x :-3.9847 -3.5549 -1.2401 -0.9780 -0.7932 -2.8531-2.7605 -3.7287 -3.5414 -2.2692 -3.4549 -3.0752-3.9934 2.8792 -0.9780 0.7932 1.1882 3.0682-1.5799 -1.4885 -0.7431 -0.4221 -1.1186 4.2532)|(1ωx P )|(2ωx P 类条件概率分布正态分布分别为(-2,0.25)(2,4)。
决策表为011=λ(11λ表示),(j i ωαλ的简写),12λ=6, 21λ=1,22λ=0。
模式识别的报告(1)
模式识别实验报告(2)姓名:某某某班号:075113学号:2011100xxxx指导老师:马丽基于kNN算法的遥感图像分类一、目标:1. 掌握KNN算法原理2. 用MATLAB实现kNN算法,并进行结果分析二、算法分析:所谓K最近邻,就是k个最近的邻居的意思,说的是每个样本都可以用她最接近的k个邻居来代表。
kNN算法的核心思想是如果一个样本在特征空间中的k 个最相似的样本中的大多数属于某一个类别,则该样本也属于这个类别,并具有这个类别上样本的特性。
该方法在确定分类决策上只依据最邻近的一个或者几个样本的类别来决定待分样本所属的类别。
kNN方法在类别决策时,只与极少量的相邻样本有关。
由于kNN方法主要靠周围有限的邻近的样本,而不是靠判别类域的方法来确定所属类别的,因此对于类域的交叉或重叠较多的待分样本集来说,kNN方法较其他方法更为适合。
三、实验内容:1.利用所有带标记的数据作为train数据,调用KNN分类函数KNN_Cla()对整个图像进行分类,得到整个图像的分类结果图。
2.随机在所有带标记的数据中选择train和test数据(50%train数据,50%test 数据)然后进行kNN分类。
随机选择10次,计算总体分类精度OA,然后求平均结果,作为最终对算法的评价。
K值依次选择1,3,5,7,9,11,分别用这6种K的取值进行kNN算法,得到每种K值下的总体分类精度OA,然后进行比较。
分类结果:四、数据介绍:zy3sample1:资源三号卫星遥感图,Img为读入遥感图生成的400*400*4矩阵。
xy3roi:ROI数据,GT为读入ROI生成的400*400矩阵。
INP_200:INP高光谱数据145*145*200。
92A V3GT_cls:ROI数据45*145。
五、实验程序:function [result,OA]=knn_classifier(X_train,Y_train,X_test,Y_test,options)%% 实现KNN分类% 输入参数% X_train : N*D% Y_train : 1*N% X_test : N*D% 输出参数% result :N*1% OA :精确度for k=1:len%一次处理1个点len=length(X_test);d=Euclidian_distance(X_train,X_test(k,:);%计算所有待分类点到所有训练点的距离[D,n]=sort(d);ind=n(1:option.K);%找到所有距离中最小的K个距离for k=1:len%一次处理1个点C(k)=length(find(Y_train(ind)==k);endindc=find(max(C));result(k)=indc(1);end;error=length(find(result'~=Y_test));%求出差错率OA=1-error/len;六、实验结果:zy3sample数据KNN分类结果(K=1):不同k值下的OA变化曲线图:七、心得体会:这次的程序主要是弄懂KNN 算法的思想就可以画出流程图其实最主要的就是搞清楚中间迭代部分的写法。