
使用Oracle的SQL函数实现工作日和节假日分组统计
sl t 工 作 日 D y l s c u t d t c t c t i tDae ec e a C a , o n ( i i t mn ( V s s sn . i t,
维普资讯
一
医 院 数 字 化
- ■ ● l 一 -■_ , 'I【 】 三 1一 主 .
使用 O al的 S L函数实现工作 日和节假 日分组统计 rc e Q
曹秀堂1 代 伟 医 院 1 解 北 京 市 1 0 5 ; 总后 勤 部 卫 生部 0 8 32 . 北 京 市 10 4 ) 0 8 2
需要 将 工 作 日和节 假 日分 别统 计 除 了法 定 节 假 日外 . 尚有 春 节、 五一 、 一 附近 周 末 的调 休 。 作 上 具有 一 定 复 杂性 。 文 十 操 本
针对 医 院普 遍 采 用 的O al后 台数 据 库 . 绍 了 通 过 S L¥数 rc e 介 Q i i
CAO u tn ’ DAI e’ HU Hu, Xi—a g , i W , GAO u ’ HAO u J n, L’
( .e ea H s i l f L , eig1 0 5 , hn ; . e l is no n rl o i i p r n, e i 1G n rl o pt A B i 8 3 C ia 2 H a hDv i f ao P j 0 n t io Ge ea L g t sDe at tB i g sc me j n
摘 要 目的 : 工 作 日和节 假 日分 别 进行 工作 量 统 计 , 助 于合 理 调 度 人 力 物 力 资 源 . 理 制 定 节假 日劳务 补 贴 措 施 。 按 有 合 方 法 : 过0 a l的S L 通 rc e Q 函数 实现 工作 日和 节假 日的 判 断 方 法 。 结果 : 能够 方 便 地 完成 工 作 日、 节假 日工 作 量 统计 。 结论 :
O a l r s d t e aae w rig d y a d h l a .R嘲 l T e meh d c ud a c mpih h l a oko d sait s rce wee u e o sp t okn a n oi y r d h to o l c o l oi ySw rla tt i s d sc ep de t . a r do Sait so oia ' w r o d ac b c migo iaywok Ote sp ae n ls o h m h s x e inl Cm,n  ̄ tt i fh l ys ok a e o n r n r r,S h e a td a ayi frte a y l sc d l r d r s
图1 工 作 日和 节 假 日判 定 流 程
合 并 到 一 起 。 下为 完 整 的S L 句 , P /Q ee r 以 Q语  ̄ LS LD vJ 中测 叩e
试 通 过 , 工作 日 木 /
定为 节 假 日。工 作 日和节 假 日的判 断 流 程 见 图 l 。
表 1 使 用 的0rce a l 函数 及 参 数 说 明
pr cia a u . a tc lv l e
Ke o d hl a; okn a; Q yw rs o dy w ri dy S L i g
1 问题 的 提 出
为方 便 患 者 就 医 , 多 医 院 开设 了节 假 日门 诊 , 至是 夜 许 甚 间 门诊 . 使患 者 在 节假 日也 能 接受 治 疗 和 手术 。 了有 针对 性 为 地 调 度节 假 日人 力 物 力 资 源 . 订节 假 日劳务 补 贴 政 策 . 常 制 经
Ap l a i n o r u n t ts i f o k n y a d h l a h ou h f c i s p i to fg o pi g s a itco r i g da n o i yt r g un ton c w d o fSQL i a l 0r c e n
一
步实 现 工作 日和 节 假 日的分 别统 计 功 能
2 方法
主要 利 用 TO al的S L 数t ca的强 大 功能 ( 表 1 , rc e Q函 o h r 见 )
将 周 末 、 旦 、 一 和 十 一 黄金 周 作 为 默 认 节 假 日。将 黄 金 周 元 五 调 休 的周 末 设 为 工 作 日 .将 春 节 期 间周 一 至 周 五 的工 作 日设
1 0 4 , ia) 8 2 Chn 0
Abtat b ci ocl lew rla codn ow ri a n o dyspr e . b d uc o s f Q src O j t eT a ua okodacri t okn dyadhl a eaa l M— o .F nt n Li e v c t g g i ty i oS n
节假 日工作 量 统 计越 来越 成 为 常规 统计 内容 . 其 单 独 分析 具 有 实用 价值 将 关 键 词 节假 日:工 作 日: Q SL
中 图分 类 号 :P l.3 ; 9 . 2 3 1 8 R1 7 2 r 1 3 文献 标 志 码 : A 文章 编 号 :0 3 8 6 (0 7 1 - 0 8 0 1 0 — 8 8 2 0 ) 10 3 — 2
Oracle统计分析函数集,over(partitionby..)的运用

Oracle统计分析函数集,over(partitionby..)的运用Oracle统计分析函数集,over(partition by..) 的运用oracle的分析函数over 及开窗函数一:分析函数overOracle从8.1.6开始提供分析函数,分析函数用于计算基于组的某种聚合值,它和聚合函数的不同之处是对于每个组返回多行,而聚合函数对于每个组只返回一行。
下面通过几个例子来说明其应用。
1:统计某商店的营业额。
date sale1 202 153 144 185 30规则:按天统计:每天都统计前面几天的总额得到的结果:DATE SALE SUM----- -------- ------1 20 20 --1天2 15 35 --1天+2天3 14 49 --1天+2天+3天4 18 67 .5 30 97 .2:统计各班成绩第一名的同学信息NAME CLASS S----- ----- ----------------------fda 1 80ffd 1 78dss 1 95cfe 2 74gds 2 92gf 3 99ddd 3 99adf 3 45asdf 3 553dd 3 78通过:--select * from(select name,class,s,rank()over(partition by class order by s desc) mm from t2)where mm=1--得到结果:NAME CLASS S MM----- ----- ---------------------- ----------------------dss 1 95 1gds 2 92 1gf 3 99 1ddd 3 99 1注意:1.在求第一名成绩的时候,不能用row_number(),因为如果同班有两个并列第一,row_number()只返回一个结果2.rank()和dense_rank()的区别是:--rank()是跳跃排序,有两个第二名时接下来就是第四名--dense_rank()l是连续排序,有两个第二名时仍然跟着第三名3.分类统计 (并显示信息)A B C-- -- ----------------------m a 2n a 3m a 2n b 2n b 1x b 3x b 2x b 4h b 3select a,c,sum(c)over(partition by a) from t2得到结果:A B C SUM(C)OVER(PARTITIONBYA)-- -- ------- ------------------------h b 3 3m a 2 4m a 2 4n a 3 6n b 2 6n b 1 6x b 3 9x b 2 9x b 4 9如果用sum,group by 则只能得到A SUM(C)-- ----------------------h 3m 4n 6x 9无法得到B列值=====select * from test数据:A B C1 1 11 2 21 3 32 2 53 4 6---将B栏位值相同的对应的C 栏位值加总select a,b,c, SUM(C) OVER (PARTITION BY B) C_Sum from testA B C C_SUM1 1 1 11 2 2 72 2 5 71 3 3 33 4 6 6---如果不需要已某个栏位的值分割,那就要用 nulleg: 就是将C的栏位值summary 放在每行后面select a,b,c, SUM(C) OVER (PARTITION BY null) C_Sumfrom testA B C C_SUM1 1 1 171 2 2 171 3 3 172 2 5 173 4 6 17求个人工资占部门工资的百分比SQL> select * from salary;NAME DEPT SAL---------- ---- -----a 10 2000b 10 3000c 10 5000d 20 4000SQL> select name,dept,sal,sal*100/sum(sal) over(partition by dept) percent from salary;NAME DEPT SAL PERCENT---------- ---- ----- ----------a 10 2000 20b 10 3000 30c 10 5000 50d 20 4000 100二:开窗函数开窗函数指定了分析函数工作的数据窗口大小,这个数据窗口大小可能会随着行的变化而变化,举例如下:1:over(order by salary)按照salary排序进行累计,order by是个默认的开窗函数over(partition by deptno)按照部门分区2:over(order by salary range between 5 preceding and 5 following)每行对应的数据窗口是之前行幅度值不超过5,之后行幅度值不超过5例如:对于以下列aa1222345679sum(aa)over(order by aa range between 2 preceding and 2 following)得出的结果是AA SUM---------------------- -------------------------------------------------------1 102 142 142 143 184 185 226 187 229 9就是说,对于aa=5的一行,sum为 5-1<=aa<=5+2 的和对于aa=2来说,sum=1+2+2+2+3+4=14 ;又如对于aa=9 ,9-1<=aa<=9+2 只有9一个数,所以sum=9 ;3:其它:over(order by salary rows between 2 preceding and 4 following)每行对应的数据窗口是之前2行,之后4行4:下面三条语句等效:over(order by salary rows between unbounded preceding and unbounded following)每行对应的数据窗口是从第一行到最后一行,等效:over(order by salary range between unbounded preceding and unbounded following)等效over(partition by null)sum(nid) over(partition by v1 order by nid)(2007-05-16 16:22:48)分类:sql语句SQL> select n1,v1,nid,sum(nid) over(order by nid) as sum2 from t1;N1 V1 NID SUM---------- ---------- ---------- ----------1 aa 61 612 aa 62 1233 aa 63 1864 aa 64 250取nid列的累积和,即下面以emp表为例的按部门“连续”求总和====================================== ============================按v1分组取nid的和SQL> select v1,sum(nid) over (partition by v1 order by v1) as sum_nid from t1;V1 SUM_NID---------- ----------aa 187aa 187aa 187bb 83按v1分组取nid的和,并重复行只显示一行SQL> select distinct * from (select v1,sum(nid) over (partition by v1) as sum_nid from t1);V1 SUM_NID---------- ----------aa 187bb 83====================================== ============================再以emp为例使用子分区查出各部门薪水连续的总和。
oracle中group by用法

oracle中group by用法摘要:1.Oracle 中Group By 概述2.Group By 的基本语法3.Group By 的常见用法1.按某一列分组2.按多列分组3.使用聚合函数4.使用rollup 和cube5.使用having 子句4.Group By 的高级用法1.去除重复记录2.分组排序3.结合其他SQL 语句5.Group By 在实际应用中的案例正文:在Oracle 数据库中,Group By 是一个非常重要的SQL 语句组成部分,它可以帮助我们对查询结果进行分组和汇总。
本文将详细介绍Oracle 中Group By 的用法,包括基本语法、常见用法、高级用法以及在实际应用中的案例。
1.Oracle 中Group By 概述Group By 是SQL 语句中用于对查询结果进行分组和汇总的关键字。
通过使用Group By,我们可以将查询结果按照某一列或多个列进行分组,并对每组数据进行汇总。
2.Group By 的基本语法在Oracle 中,Group By 的基本语法如下:```sqlSELECT column1, column2, aggregate_function(column)FROM table_nameWHERE conditionGROUP BY column1, column2ORDER BY column1, column2;```其中,`aggregate_function` 可以是`COUNT`、`SUM`、`AVG`、`MAX`、`MIN` 等聚合函数,`column1` 和`column2` 是需要分组的列,`condition` 是查询条件,`ORDER BY` 子句用于对分组后的结果进行排序。
3.Group By 的常见用法接下来,我们将介绍Group By 的常见用法:3.1 按某一列分组```sqlSELECT department, COUNT(employee_id)FROM employeesGROUP BY department;```上述语句将按照`department` 列对`employees` 表进行分组,并计算每个部门的员工数量。
oracle分组函数
☐分组函数对表中的多行进行操作,而每组返回一个计算结果。
常用的分组函数包括✓AVG,其语法格式为AVG( [ DISTINCT|ALL ] expr ),计算某列中某种分组后,每组的平均值,计算时会忽略空值(null),用于计算数字类型。
✓SUM,其语法格式为SUM( [ DISTINCT|ALL ] expr),计算某列中某种分组后,每组的和,用于计算数字类型。
✓MAX:计算最大值✓MIN:计算最小值✓COUNT :行计数☐AVG和SUM函数☐使用AVG函数和SUM函数。
✓SQL> SELECT AVG(sal) “平均工资",SUM(sal) "总工资"FROM emp;☐MAX和MIN函数✓MAX和MIN函数即可以操作数字型数据也可以操作字符型和日期型数据。
✓示例1SQL> SELECT MAX(SAL) "Highest salary", MIN(SAL) "Lowest salary"FROM emp;✓计算最早雇佣员工的日期和最晚雇佣员工的日期。
SQL> SELECT MAX(HIREDATE) "Last day", MIN(HIREDATE) "First day"FROM EMP;☐COUNT函数该函数返回经计算得到的返回的行数,包括空行和重复的行。
✓使用COUNT()函数。
SQL> SELECT count(*) "表中的行数"FROM emp;✓使用包含DISTINCT的COUNT函数。
SQL> SELECT count(distinct job)FROM emp;☐GROUP BY 子句使用AVG和SUM函数查询了表emp中的员工平均工资和总工资数,但是如果要查询每个工作职位的员工平均工资和总工资之和又该如何计算呢。
08-oracle统计函数(单组分组函数)
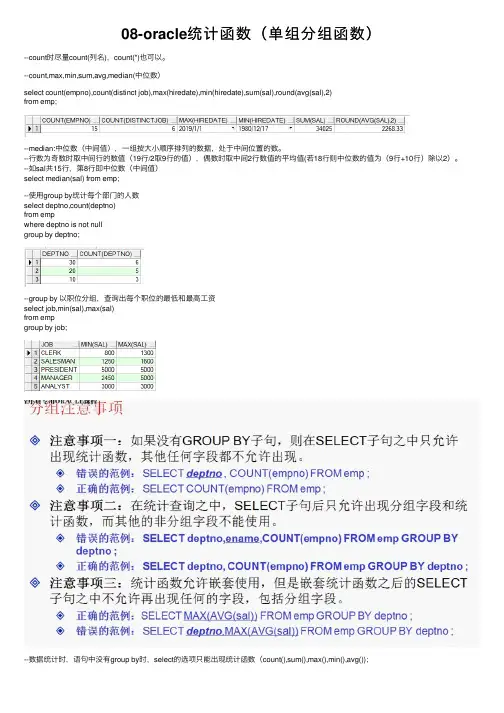
08-oracle统计函数(单组分组函数)--count时尽量count(列名),count(*)也可以。
--count,max,min,sum,avg,median(中位数)select count(empno),count(distinct job),max(hiredate),min(hiredate),sum(sal),round(avg(sal),2)from emp;--median:中位数(中间值),⼀组按⼤⼩顺序排列的数据,处于中间位置的数。
--⾏数为奇数时取中间⾏的数值(19⾏/2取9⾏的值),偶数时取中间2⾏数值的平均值(若18⾏则中位数的值为(9⾏+10⾏)除以2)。
--如sal共15⾏,第8⾏即中位数(中间值)select median(sal) from emp;--使⽤group by统计每个部门的⼈数select deptno,count(deptno)from empwhere deptno is not nullgroup by deptno;--group by 以职位分组,查询出每个职位的最低和最⾼⼯资select job,min(sal),max(sal)from empgroup by job;--数据统计时,语句中没有group by时,select的选项只能出现统计函数(count(),sum(),max(),min(),avg());--数据统计时,语句中有group by时,select的选项只能出现统计函数和group by排序使⽤的分组字段(即列名);select job,count(ename) from emp group by job;--数据统计时,使⽤嵌套函数时,⽆论与剧中有没有group by ,select选项中只允许出现嵌套⾏数,其它字段均不允许出现。
--重复的列可以进⾏分组(GROUP BY),SQL语句执⾏顺序为FROM,WHRER,GROUP BY,SELECT,ORDER BY--查询部门名称,部门⼈数,平均⼯资,平均⼯作年限SELECT D.DNAME 部门名称,count(ename)部门⼈数,ROUND(AVG(SAL),2)平均⼯资,ROUND(AVG(MONTHS_BETWEEN(SYSDATE,HIREDATE)/12),2)平均⼯作年限FROM EMP E FULL OUTER JOIN DEPT D ON( E.DEPTNO=D.DEPTNO)GROUP BY D.DNAME;--查询⼯资各个等级⼯资的雇员⼈数,平均⼯资SELECT TRIM(S.GRADE),DECODE(S.GRADE,1,'A',2,'B',3,'C',4,'D',5,'E') ⼯资等级,COUNT(E.ENAME) 雇员⼈数,ROUND(AVG(E.SAL),2)平均⼯资FROM EMP E,SALGRADE SWHERE E.SAL BETWEEN S.LOSAL AND S.HISALGROUP BY S.GRADEORDER BY ⼯资等级--查询领取佣⾦和不领取佣⾦的平均⼯资,平均⼯作年限,雇员⼈数SELECT '不领取佣⾦',AVG(SAL)平均⼯资,ROUND(AVG(MONTHS_BETWEEN(SYSDATE,HIREDATE)/12),2)平均⼯资年限,COUNT(EMPNO)雇员⼈数FROM EMP E WHERE M IS NULLUNIONSELECT '领取佣⾦',AVG(SAL)平均⼯资,ROUND(AVG(MONTHS_BETWEEN(SYSDATE,HIREDATE)/12),2)平均⼯资年限,COUNT(EMPNO)雇员⼈数FROM EMP E WHERE M IS NOT NULL;--多字段分组--GROUP BY 字段1,字段2--查询部门详细信息:部门名称,部门编号,部门位置,平均⼯资,总⼯资,雇员⼈数SELECT D.DNAME,D.DEPTNO,D.LOC,ROUND(AVG(E.SAL),2),SUM(SAL),COUNT(E.ENAME) FROM DEPT D,EMP EWHERE D.DEPTNO=E.DEPTNO(+)GROUP BY D.DNAME,D.DEPTNO,D.LOC;--HAVING 必须和GROUP BY⼀起使⽤--查询所有平均⼯资⼤于2000的职位信息,平均⼯资,雇员⼈数SELECT E.JOB,ROUND(AVG(SAL),2),COUNT(E.ENAME)FROM EMP EGROUP BY E.JOBHAVING AVG(SAL)>2000;--查询不包含销售的的⼯作名称,从事同⼀⼯作的雇员⼯资总和,且⼯资⼤于5000,并按照从低到⾼排序select E.JOB,SUM(E.SAL) Afrom emp ewhere e.job !='SALESMAN'GROUP BY E.JOBHAVING SUM(E.SAL)>5000ORDER BY A DESC;。
Oracle数据库-第7章-分组统计查询

分组统计 —— 范例
查询出公司各个工资等级雇员的数量、平均工资。
SELECT s.grade,COUNT(e.empno), ROUND(AVG(e.sal),2) FROM emp e,salgrade s WHERE e.sal BETWEEN s.losal AND s.hisal GROUP BY s.grade ;
按照雇员的职位进行分组,job字段内容重复; 按照雇员所在的部门分组,deptno字段内容重复;
分组统计语法
SELECT [DISTINCT] 分组字段 [AS] [列别 名] ,... | 统计函数 [AS] [别名] , …. FROM 表名称1 [表别名1] , 表名称2 [表别名2] …. [WHERE 条件(s)] [GROUP BY 分组字段] [ORDER BY 排序字段 ASC|DESC] ;
注意事项二:在统计查询之中,SELECT子句后只允许出现分 组字段和统计函数,而其他的非分组字段不能使用。
错误的范例: SELECT deptno,ename,COUNT(empno) FROM emp GROUP BY deptno ; 正确的范例: SELECT deptno, COUNT(empno) FROM emp GROUP BY deptno ;
8 STDDEV(列)
返回标准差
统计函数 —— 范例
查找出公司每个月支出的月工资的总和
SELECT SUM(sal) FROM emp ;
统计函数 —— 范例
查询出公司的最高工资、最低工资、平均工资
SELECT AVG(sal), ROUND(AVG(sal),2), MAX(sal), MIN(sal) FROM emp ;
SELECT COUNT(*) , COUNT(ename) , COUNT(comm) , COUNT(DISTINCT job) FROM emp ;
oracle date函数使用方法
oracle date函数使用方法Oracle数据库中的日期函数用于处理和操作日期和时间数据。
以下是一些常用的Oracle日期函数及其使用方法:1. `SYSDATE`:返回当前系统日期和时间。
```sqlSELECT SYSDATE FROM dual;```2. `TO_DATE`:将字符串转换为日期格式。
```sqlSELECT TO_DATE('', 'YYYY-MM-DD') FROM dual;```3. `ADD_MONTHS`:在给定日期上添加指定的月份数。
```sqlSELECT ADD_MONTHS(TO_DATE('', 'YYYY-MM-DD'), 3) FROM dual; ```4. `MONTHS_BETWEEN`:返回两个日期之间的月份数。
```sqlSELECT MONTHS_BETWEEN(TO_DATE('', 'YYYY-MM-DD'), TO_DATE('', 'YYYY-MM-DD')) FROM dual;```5. `NEXT_DAY`:返回给定日期后的下一个指定工作日。
```sqlSELECT NEXT_DAY(TO_DATE('', 'YYYY-MM-DD'), 'MONDAY') FROM dual;```6. `LAST_DAY`:返回给定日期的月份的最后一天。
```sqlSELECT LAST_DAY(TO_DATE('', 'YYYY-MM-DD')) FROM dual;```7. `ROUND`:将日期舍入到指定的精度。
```sqlSELECT ROUND(TO_DATE(' 14:30:45', 'YYYY-MM-DD HH24:MI:SS'), 'MONTH') FROM dual;```8. `TRUNC`:将日期截断到指定的精度。
Oracle-查询语句-分组函数
Oracle-查询语句-分组函数/*分组函数不能再select⼦句中出现普通的列,除⾮这个列在group by中给出所有的空值都会被分为⼀组分组过滤SELECT FROM WHERE GROUPBY HAVING ORDERBY*/--求出每种⼯作的平均薪资SELECT JOB,AVG(SAL),MAX(SAL),MIN(SAL) FROM EMP GROUP BY JOB;SELECT MAX(SAL) FROM EMP;SELECT DEPTNO,AVG(SAL) FROM EMP GROUP BY DEPTNO;--查询每个部门中,不同⼯作的平均薪资SELECT DEPTNO,JOB,AVG(SAL) FROM EMP GROUP BY DEPTNO ,JOB ORDER BY DEPTNO,JOB;--分组函数语句中,select⼦句中出现的每⼀个列必须出现在出现在group by后⾯,--除⾮是⼀个组函数,⽽且需要遵循组函数的使⽤规则SELECT DEPTNO,AVG(SAL),MIN(ENAME) FROM EMP GROUP BY DEPTNO;--按照津贴进⾏分组SELECT COMM,COUNT(*) FROM EMP GROUP BY COMM;--查询每个部门中薪资⼤于2000员⼯的平均薪资SELECT DEPTNO,AVG(SAL) FROM EMP WHERE SAL>2000GROUP BY DEPTNO;--查询部门的平均薪资,如果平均薪资低于2000就过滤掉SELECT DEPTNO,AVG(SAL) FROM EMP GROUP BY DEPTNO HAVING AVG(SAL)>2000;--查询薪资⼤于等于2500的员⼯,按照⼯作进⾏分组,然后求出平均薪资⼤于等于3000的⼯作SELECT*FROM EMP;--14SELECT*FROM EMP WHERE SAL>=2500;--5SELECT JOB,AVG(SAL) FROM EMP WHERE SAL>=2500GROUP BY JOB;--3SELECT JOB,AVG(SAL) FROM EMP WHERE SAL>=2500GROUP BY JOB HAVING AVG(SAL)>=3000;--2SELECT JOB,AVG(SAL) FROM EMP WHERE SAL>=2500GROUP BY JOB HAVING AVG(SAL)>=3000ORDER BY AVG(SAL) DESC;。
sql时间统计语句和实例
sql时间统计语句和实例标题:SQL时间统计语句和实例1. 统计某个表中每个日期的数据量```sqlSELECT DATE(date_column) AS date, COUNT(*) AS countFROM tableGROUP BY DATE(date_column)ORDER BY DATE(date_column);```这条语句可以统计某个表中每个日期的数据量,并按日期进行排序,以便更好地观察数据的分布情况。
2. 统计某个时间段内每天的数据量```sqlSELECT DATE(date_column) AS date, COUNT(*) AS countFROM tableWHERE date_column BETWEEN '2022-01-01' AND '2022-01-31' GROUP BY DATE(date_column)ORDER BY DATE(date_column);```这条语句可以统计某个时间段内每天的数据量,并按日期进行排序,以便更好地了解数据的变化趋势。
3. 统计某个时间段内每小时的数据量```sqlSELECT DATE_FORMAT(date_column, '%Y-%m-%d %H:00:00') AS hour, COUNT(*) AS countFROM tableWHERE date_column BETWEEN '2022-01-01' AND '2022-01-31' GROUP BY hourORDER BY hour;```这条语句可以统计某个时间段内每小时的数据量,并按小时进行排序,以便更好地观察数据的小时变化情况。
4. 统计某个时间段内每周的数据量```sqlSELECT YEARWEEK(date_column) AS week, COUNT(*) AS count FROM tableWHERE date_column BETWEEN '2022-01-01' AND '2022-12-31' GROUP BY weekORDER BY week;```这条语句可以统计某个时间段内每周的数据量,并按周进行排序,以便更好地了解数据的周变化趋势。
oracle 统计分析函数
oracle 统计/分析函数Oracle从8.1.6开始提供分析函数,分析函数用于计算基于组的某种聚合值,它和聚合函数的不同之处是对于每个组返回多行,而聚合函数对于每个组只返回一行。
语法:Sql代码1.<analytic-function>(<argument>,<argument>,...)2.over(3.<query-partition-clause>4.<order-by-clause>5.<windowing-clause>6.)说明:<1> over是关键字,用于标识分析函数。
<2> <analytic-function>是指定的分析函数的名字。
<3> <argument>为参数,分析函数可以选取0-3个参数。
<4> 分区子句<query-partition-clause>的格式为:partition by<value_exp>[,value_expr]...关键字partition by子句根据由分区表达式的条件逻辑地将单个结果集分成N组。
这里的"分区partition"和"组group" 都是同义词。
<5> 排序子句order-by-clause指定数据是如何存在分区内的。
其格式为:order[siblings]by{expr|position|c_alias}[asc|desc][nulls first|nulls last]其中:A.asc|desc:指定了排列顺序。
B.nulls first|nulls last:指定了包含空值的返回行应出现在有序序列中的第一个或最后一个位置。
<6>窗口子句windowing-clause给出一个固定的或变化的数据窗口方法,分析函数将对这些数据进行操作。
Oracle列函数和分组
分组查询
• 练习
– 查询每个部门的平均工资 – 查询每个部门的年薪和
分组查询
• 记住的规则:
– 如果在SELECT 子句中,有不在列函数中的列,则该列一定要出现在 GROUP BY 之后。
分组查询HAVING子句的使用
• 显示出平均工资大于2000的部门编号和平均工资
SELECT deptno,AVG(sal)
知识点总结
• 理解分组的概念 • 掌握常用列函数的使用 • 掌握列函数和标量函数的区别 • 掌握GROUP BY子句的使用 • 掌握 HAVING 子句的使用 • 掌握SQL语句的书写和执行顺序
• 查询20,30部门的平均工资,并将平均工资大于2000的输出,输出结果按平均工 资排序
SELECT deptno,AVG(sal) FROM emp WHERE deptno IN(20,30) GROUP BY deptno HAVING AVG(sal)>2000 ORDER BY AVG(sal);
列函数与标量函数
常用的列函数
• SUM(expres) 求最大值
• MIN(expression)
求最小值
• COUNT(expression) 统计记录数
• COUNT(DISTINCT COLNAME)
统计去除重复行记录数,
列函数的使用
• 查询员工的记录数,员工工资的总和,平均工资,最高工资, 最低工资
Oracle基础 列函数和分组
单元目标
• 理解分组的概念 • 能够记忆并熟练使用常用列函数 • 能够描述列函数和标量函数的区别 • 能够GROUP BY进行分组查询 • 能够使用 HAVING 子句对分组查询的结果进行筛选 • 能够描述SQL语句的书写和执行顺序