
实验六——平均数分析与T检验
5.1.2 假设检验的基本思想
•
5.1.3 假设检验的基本步骤
依据假设检验的基本思想,假设检验可以总结 成为以下四大基本步骤: 第一,提出原假设(记为H0)。 • 即根据推断检验的目的,对待推断的总体参 数或分布提出一个基本假设。 第二,选择检验统计量。 • 在假设检验中,样本值(或更极端值)发生 的概率并不直接由样本数据得到,而是通过计算检 验统计量观测值发生的概率而间接得到。这些检验 统计量服从或近似服从某种已知的理论分布。对于 不同的假设检验问题以及不同的总体条件,会有不 同的选择检验统计量的理论、方法和策略。
定义两总体的标识值
框中输入一个数字,大于 等于该值的对应一个总体 ,小于该值的对应另一个 总体
•
本市户口和外地户口的家庭人均住房面积的样 本平均值有一定的差距。
结论
• • •
分析结论应通过两步完成: 第一步,两总体方差是否相等的F检验。 该检验的F统计量的观察值为65.469,对应 的概率P-为0.00。如果显著性水平a为0.05,由 于概率P-小于0.05,可以认为两总体的方差有显 著差异。 • 第二步,两总体均值的检验。 • t统计量的观测值为-3.369,对应的双尾概率 P-值为0.001.如果显著性水平a为0.05,由于概 率P-小于0.05,因此认为两总体的均值有显著地 差异,及本市户口的家庭人均住房面积的平均值存 在显著差异。
统计方法
描述统计
推断统计
估计
假设检验
参数检验
非参数检验
• 假设检验的基本思路是首先对总体参数提出假设,
然后再利用样本告之的信息去验证先前提出的假设 是否成立。 • 如果样本数据不能够充分证明和支持假设, 则在一定的条件下,应拒绝假设;相反,如果样本 数据不能够充分证明和支持假设是不成立的,则不 能推翻假设成立的合理性和真实性。 • 上述假设检验推断过程所依据的基本信念是 小概率原理,即发生概率很小的随机事件,在某一 次特定的实验中是几乎不可能发生的。
• 两总体方差是否相等是决定如何计算抽样分布方差的
关键,因此有必要通过有效地方式对其进行统计检验 。
27
• 两总体方差是否相等检验的原假设是:
两总体方差无显著差异— H0:12 22 采用方差齐性检验(Levene F方法),基本思路: 计算两组样本的均值 计算各个样本与本组均值的平均离差绝对值; 利用单因素方差分析推断两独立总体平均离差绝对 值是否有显著差异。 用户需要根据F检验的结果自己判断选择t检验输出中 的哪个结果,得出最后结论。如果推断两总体方差 相等则看方差相等的T检验值和P值,如果推断两总 体方差不相等则看方差不相等的T检验值和P值。
1、Analyze-Compare means-One-Samples T test
2、Test Variable: 选择分析变量 3、Test Value:输入检验值 4、Option:确定置信度和缺失值的处理方法 Exclude cases analysis by analysis表示计算时涉及的变量上有缺 失值,则剔除在该变量上为缺失值的个案; Exclude cases listwise表示剔除所有在任意变量上含有缺失值的个 案后再进行分析。 可见,较第二种方式,第一种处理方式较充分地利用了样本数据。在 后面的分析方法中,SPSS对缺失值的处理方法与此相同,不再赘述。 另外,还可以输出默认95%的置信区间。
二、两独立样本的T检验
检验的基本思路
• 按照一定的分组原则将所有的个案分为两部分,
将其视为两个独立的样本,对两个样本分别进行 描述统计。然后对两个样本进行方差性检验,或 称为等方差检验。确认两个总体具有等方差性以 后,用T检验的方法对两个样本的均值差进行检 验。 • 如果均值差过大,则说明这两个样本来源于均值 不同的两个总体,就可以拒绝两个总体均值相等 的原假设。
实验六
SPSS 平均数分析与T检验
1.SPSS简介 5.1 参数检验概述
• •
5.1.1推断统计与参数检验 推断统计方法是根据样本数据推断总体特征 的方法,它在对样本数据描述的基础上,以概率 的形式对统计总体的未知数量特征(如均值、方 差等)进行表述。 • 通过对样本数据的研究来研究推断总体特征 主要是出于以下两个原因:第一,总体数据无法 全部收集;第二,在某些情况下虽然总体数据能 够收集到,但操作时将会耗费大量的人力、物力 和财力。
• 一、提出原假设
两独立样本T检验的基本步骤
两总体均值不存在显著差异: 1 2 0 二、选择检验统计量
Z
( X 1 X 2 ) ( 1 2 )
2 1
n1
2 2
~ N (0,1)
n2
当12、 22 相等,两总体均值差检验的统计量T为: ( X 1 X 2 ) (1 2 ) t ~ t (n1 n2 2) 2 2 1 1 ( n 1 ) S ( n 1 ) S 2 1 1 2 2 Sp S 其中: p n1 n2 n1 n2 2
•
得到检验统计量的概率P-值后的决策就是判定 应拒绝原假设还是不应拒绝原假设。如果检验统计 量的概率P-值小于显著性水平a,则认为如果此时 拒绝假设犯错误的可能性小于显著性水平a,其概 率低于预先控制的水平,不太可能犯错误,可以拒 绝原假设;反之,如果检验统计量的概率P-值大于 显著性水平a,则认为如果此时拒绝原假设犯错误 的可能性大于显著性水平a,其概率比预先控制的 水平高,很有可能犯错误,不应拒绝原假设。
5.2.3 单样本t检验的应用举例
•
案例:利用“住房状况调查.sav”,推断家 庭人均住房面积的平均值是否为20平方米。 • 分析:由于该问题涉及的是单个总体,且要 进行总体均值检验,同时家庭人均住房面积的总体 近似认为服从正态分布,因此,可以采用单样本t 检验进行分析。 • 原假设:总体均值与检验值之间不存在显著 差异: H0:u=u0=20。U为总体均值,u0为检 验值 操作:analyze-compare means-one samples T Test
T统计量的观测值为8.64
自由度为2992(即:n-1=2993-1) T统计量观测值的双尾概率P-值
总体均值与原假设值差的95% 的置信区间为(1.55, 2.46), 由此计算出总体均值的95%的 置信区间为(2量的分子部分)
结论
•
• 当12、 22 不等,两总体均值差检验的统计量T为:
S12 S 22 ( )2 ( X 1 X 2 ) (1 2 ) n1 n2 t ~ t( 2 ) 2 2 2 S1 S2 S1 S 2 ( )2 /( n1 1) ( )2 /( n2 1) n1 n2 n1 n2
假设检验的步骤
提出原假设(零假设)H ;
0
确定适当的检验统计量;
计算检验统计量的值发生的概率(P值);
给定显著性水平,作出统计决策。
参数分析——平均数分析
平均数分析就是用样本均值来推论总体均值的 方法。
一是单个样本的T检验。这是用样本的均值对总体均 值的假设进行检验的方法。 二是独立样本的T检验。这是用两个样本的均值差得 大小来检验对应的两个总体的均值是否相等的方法。 三是配对样本的T检验。这是通过对配对样本的两次 测量结果的差异的大小来检验两个总体的差异是否显 著的分析方法。
28
三、计算统计量和P值 四、根据显著性水平和概率P值进行统计决策 首先利用F检验确定两个总体的方差是否相等; 当P值<a值,拒绝原假设,认为两总体方差有显著差 异;反之,两总体方差无显著差异。 然后利用T检验判断两总体均值是否存在显著差异。 当P值<a值,拒绝原假设,认为两总体均值有显著差 异;反之,认为两总体均值无显著差异。
第三,计算检验统计量观测值发生的概率 • 选定检验统计量之后,在认为原假设成立的条 件下,利用样本数据便可计算出检验统计量观测值 发生的概率,即概率P-值或相伴概率(即指该检 验统计量在某个特定的极端区域取值在H0成立时 的概率),该概率间接地给出了样本值(或更极端 值)在原假设成立条件下发生的概率。对此可以依 据一定的标准来判定其发生的概率是否为小概率, 是否是一个小概率事件。 第四,给定显著性水平a,并作出统计决策 • 显著性水平a是指原假设准确但却被错误地拒 绝了的概率或风险,一般人为确定为0.05或0.01 等,意味着不拒绝原假设正确的可能性(概率)为 95%或99%。
10
5.2 单样本t检验
• 5.2.1 单样本t检验的目的 • 单样本t检验的目的是利用来自某总体的样本
数据,推断该总体的均值是否与指定的检验值之 间存在显著差异。它是对总体均值的假设检验。 • 单样本t检验是指研究问题中仅涉及一个总体 ,且采用t检验的方法进行分析。单样本t检验的 前提是样本来自总体应服从或近似服从正态分布 。
根据各保险公司人员构成情况数据,对我国目 前保险公司从业人员的受高等教育的程度和年轻化 的程度进行推断: • 保险公司具有高等教育水平的员工比例的平均值不 低于0.8; • 年轻人比例的平均值与0.5无显著差异。
5.3 两独立样本t检验
• 5.3.1 两个独立样本t检验的目的
两独立两样本t检验的目的是利用来自两个总体的 独立样本,推断两个总体的均值是否存在显著差异。 • 5.3.2 两独立样本t检验的基本步骤(同独立样本t 检验) 两独立样本t检验的前提是: 1.样本来自的总体应服从或近似服从正态分布。 2.两样本相互独立,即从一总体中抽取一组样本 对从另一总体中抽取一组样本没有任何影响,两组样 本的个案数目可以不等。
分析:由于本市户口人均住房面积和外地户口人均住 房面积可以看成两个总体,且住房面积可近似认为服从正 态分布,样本数据的获取是独立抽样的,因此,可以用独 立样本t检验的方法进行。
• 原假设:本市户口和外地户口的家庭人均住房面
t检验f检验及公式
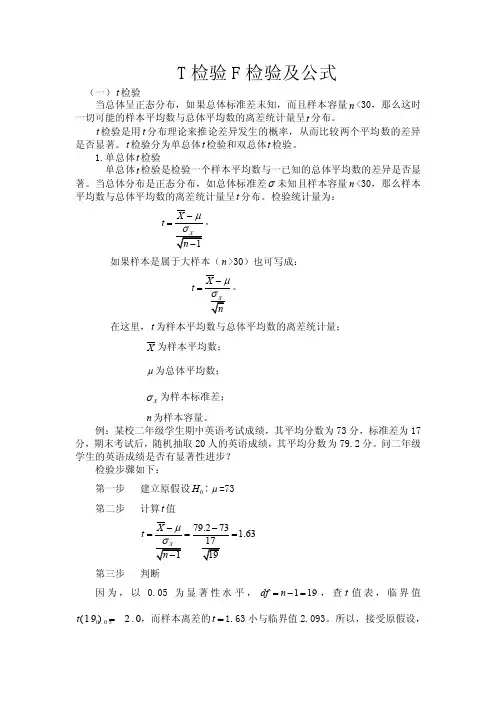
T 检验F 检验及公式(一)t 检验当总体呈正态分布,如果总体标准差未知,而且样本容量n <30,那么这时一切可能的样本平均数与总体平均数的离差统计量呈t 分布。
t 检验是用t 分布理论来推论差异发生的概率,从而比较两个平均数的差异是否显著。
t 检验分为单总体t 检验和双总体t 检验。
1.单总体t 检验单总体t 检验是检验一个样本平均数与一已知的总体平均数的差异是否显著。
当总体分布是正态分布,如总体标准差σ未知且样本容量n <30,那么样本平均数与总体平均数的离差统计量呈t 分布。
检验统计量为:X t μσ-=。
如果样本是属于大样本(n >30)也可写成:X t μσ-=。
在这里,t 为样本平均数与总体平均数的离差统计量; X 为样本平均数; μ为总体平均数; X σ为样本标准差;n 为样本容量。
例:某校二年级学生期中英语考试成绩,其平均分数为73分,标准差为17分,期末考试后,随机抽取20人的英语成绩,其平均分数为79.2分。
问二年级学生的英语成绩是否有显著性进步?检验步骤如下:第一步 建立原假设0H ∶μ=73 第二步 计算t 值79.2731.6317X t μσ--=== 第三步 判断因为,以0.05为显著性水平,119df n =-=,查t 值表,临界值0.05(19) 2.093t =,而样本离差的t =1.63小与临界值2.093。
所以,接受原假设,即进步不显著。
2.双总体t 检验双总体t 检验是检验两个样本平均数与其各自所代表的总体的差异是否显著。
双总体t 检验又分为两种情况,一是相关样本平均数差异的显著性检验,用于检验匹配而成的两组被试获得的数据或同组被试在不同条件下所获得的数据的差异性,这两种情况组成的样本即为相关样本。
二是独立样本平均数的显著性检验。
各实验处理组之间毫无相关存在,即为独立样本。
该检验用于检验两组非相关样本被试所获得的数据的差异性。
现以相关检验为例,说明检验方法。
t检验的资料与习题
第四章:定量资料的参数估计与假设检验基础1抽样与抽样误差抽样方法本身所引起的误差。
当由总体中随机地抽取样本时,哪个样本被抽到是随机的,由所抽到的样本得到的样本指标x与总体指标μ之间偏差,称为实际抽样误差。
当总体相当大时,可能被抽取的样本非常多,不可能列出所有的实际抽样误差,而用平均抽样误差来表征各样本实际抽样误差的平均水平。
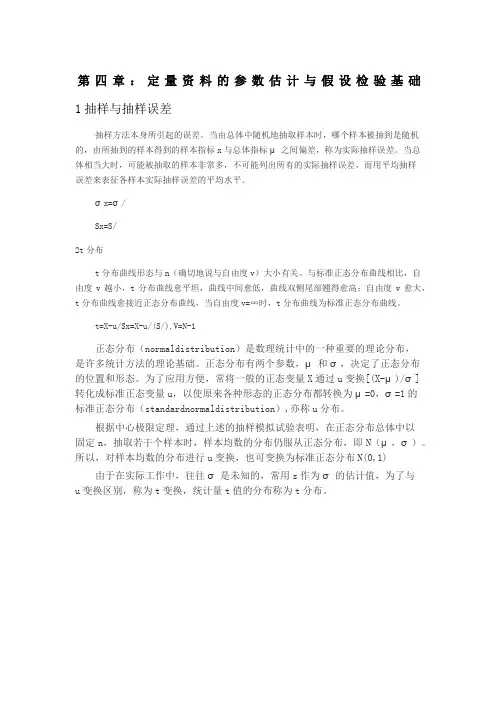
σx=σ/Sx=S/2t分布t分布曲线形态与n(确切地说与自由度v)大小有关。
与标准正态分布曲线相比,自由度v越小,t分布曲线愈平坦,曲线中间愈低,曲线双侧尾部翘得愈高;自由度v愈大,t分布曲线愈接近正态分布曲线,当自由度v=∞时,t分布曲线为标准正态分布曲线。
t=X-u/Sx=X-u/(S/),V=N-1正态分布(normaldistribution)是数理统计中的一种重要的理论分布,是许多统计方法的理论基础。
正态分布有两个参数,μ和σ,决定了正态分布的位置和形态。
为了应用方便,常将一般的正态变量X通过u变换[(X-μ)/σ]转化成标准正态变量u,以使原来各种形态的正态分布都转换为μ=0,σ=1的标准正态分布(standardnormaldistribution),亦称u分布。
根据中心极限定理,通过上述的抽样模拟试验表明,在正态分布总体中以固定n,抽取若干个样本时,样本均数的分布仍服从正态分布,即N(μ,σ)。
所以,对样本均数的分布进行u变换,也可变换为标准正态分布N(0,1) 由于在实际工作中,往往σ是未知的,常用s作为σ的估计值,为了与u变换区别,称为t变换,统计量t值的分布称为t分布。
假设X服从标准正态分布N(0,1),Y服从χ2(n)分布,那么Z=X/sqrt(Y/n)的分布称为自由度为n的t分布,记为Z~t(n)。
特征:1.以0为中心,左右对称的单峰分布;2.t分布是一簇曲线,其形态变化与n(确切地说与自由度ν)大小有关。
自由度ν越小,t分布曲线越低平;自由度ν越大,t分布曲线越接近标准正态分布(u分布)曲线,如图.t(n)分布与标准正态N(0,1)的密度函数对应于每一个自由度ν,就有一条t分布曲线,每条曲线都有其曲线下统计量t的分布规律,计算较复杂。
配对样本的T检验
本科学生实验报告学号:*********** 姓名:&&&&&&学院:生命科学学院专业、班级:11级应用生物教育A班实验课程名称:生物统计学实验教师:孟丽华(讲师)开课学期:2012 至2013 学年下学期填报时间:2013 年 4 月22 日云南师范大学教务处编印的均值;2)、构造统计量:其中:为两配对样本差值的均值,为两总体均值之差,两配对样本T检验采用T统计量。
其思路是:首先,对两组样本分别计算出每对观测值的差值得到差值样本;然后,体用差值样本,通过对其均值是否显著为0的检验来推断两总体均值的差是否显著为0.如果差值样本的均值与0有显著差异,则可以认为两总体的均值有显著差异;反之,如果差值系列的均值与0无显著差异。
则可以认为两总体均值不存在显著差异;3)、计算检验统计量观测值和概率P-值:SPSS将计算两组样本的差值,并将相应数据代入式①,计算出T统计量的观测值和对应的概率P-值;4)、给定显著水平α,并作出决策:给定显著水平α,与检验统计量的概率P-值作比较。
如果概率P-值小于显著水平α,则应拒绝原假设,认为差值样本的总体均值与0有显著不同,两总体的均值有显著差异;反之,如果概率P-值大于显著水平α,则不应拒绝原假设,认为差值样本的总体均值与0无显著不同,两总体的均值不存在显著差异。
(四)、实验内容:内容:生物统计学(第四版)第73页第四章习题 4.9实验方法步骤1、启动spss软件:开始→所有程序→SPSS→spss for windows→spss 18.0 for windows,直接进入SPSS数据编辑窗口进行相关操作;2、定义变量,输入数据。
点击“变量视图”定义变量工作表,用“name”命令定义变量“治疗前”(小数点零位)及标签为“治疗前的舒张压(mmHg)”;变量“治疗后”(小数点零位)及标签为“治疗后的舒张压(mmHg)”;点击“变量视图工作表”,把治疗前后的舒张压的数据输入到单元格中;3、设置分析变量。
实验二 利用EXCEL软件进行平均数的t测验

实验二利用EXCEL软件进行平均数的t测验
一、实验目的:
1.巩固成组资料t测验及其区间估计的方法与步骤。
2.巩固成对资料t测验及其区间估计的方法与步骤。
3.熟练掌握Excel数据分析中“数据分析”工具使用方法与技能。
二、原理与步骤:
1.在同一行连续输入两个处理的名称;
2.在名称下方输入数据;
3.打开“工具”菜单,“数据分析…”项选“t测验:平均值的成对二样本分析”或“t测验:双样本等方差假设”,单击“变量1的区域框”内,选定处理1及其数据区,单击“变量2的区域框”内,选定处理2及其数据区,选中“标志”复选框,单击“输出区域”选指定的单元格,单击确定按钮。
4.输出结果判读、区间估计、作结论。
三、数据资料:
1.可用书中例题中的数据资料,作为验证性试验。
2.数据资料:
四、实验方式与分组要求:
一人一组,一人一台计算机。
五、作业:
使用Excel数据分析计算。
作t检验或成对t检验,并比较两种分析结果的异同,指出正确的分析方法,并解释为什么它是正确的分析方法。
第一章 试验设计与数据分析-概述

论文工作中反映的问题: 1) 只求平均数 2) 试验做1-2次就算。 原因:与工程试验的性质及理解有关 例:电量、非电量电测技术的应用:
模拟量的测试(传感器) 信号放大 模数转换(A/D)
计算机数据处理
仪器是很准确的
被测对象是随机变量!
论文工作中反映的问题:
3)试验设计应逐步深化,通常一种错误的做法,是在一 开始就去设计一个单一、庞大和内容广泛的实验, 一个 成功的实验是要先弄清楚重要变量和变量的范围; 4) 专业知识的作用 试验统计方法不能决定一个变量的作用,它仅对试验 结果的可靠性和有效性提供准则。结论还依赖于对问题 的工程知识的了解和把握; 例:一篇投农业工程学报的论文 修改意见: “3)文中一些拟合方程无意义,可以删除 相关内容。请您在附件中进行修改,修改部分务必用红 色标记出。”
试验统计学简史
3)山口弘一正交设计、可靠性设计价值工程类设计方法 (20世纪70年代),强调整体效果:如日本汽车的质量 在工业界得到广泛应用,但在理论上有很大争议; 4)随着科学的发展,学科交叉越来越普遍,试验设计方 法在许多领域得到广泛的认同和应用:禽流感传感器。 实验设计已远不止农业,奇怪现象:在农业相关领域的 兴趣反而下降——仪器设备的改进、标准化生产的影响
试验设计与数据统计分析
Experimental Design and Data Statistical Analysis 华南农业大学工程学院 刘庆庭
2012-9
关于本课程 学生:2012级——57人 (工程39、水利土木3、林学4 、园艺1、 食品10) 时间:2012年9月-2013年1月 学时:36 上课:28 周学时:3节/周 上机:8(SPSS数据处理软件应用) 作业: 建议先用手工做,以后用计算机做 考试:开卷
试验统计方法

4、样本标准差
S (x x)2 n 1
S2 的正平方根。
直接法: δ x μ2 N
矫正数法:
5、全距近等于 6 倍的标准差。
6、变异系数:标准差与平均数的比值(相对值) C·V =(S /x)×100% 作业 1、生物统计中常用的平均数有几种?各在什么情况下应用?
算术平均数(正态);中位数(正态);众数(偏态);几何平均数(遗传)
-
x2)(- μ1 -μ2) δ2 δ 2
;
x
u x
1 2
x -μ x δ x
。
n1 n2
四、分布
t 分布受自由度的约束,每一个自由度都有一条分布密度曲线。
五、作业
1、必然事件、不可能事件、随机事件。
必然事件:对于一类事件来说,在同一组条件的实现之下必然要发生的事件。
不可能事件:在同一组条件的实现之下必然 不发生的事件。
(3) S S 8 2.53 x n 10
;
t
x -μ x
70 - 75
-1.976
xS
2.53
X
(4)查表知 r = 10 - 1 = 9 时,P = 0.05 ,t = 2.262
∵1.976 < 2.262 ; ∴P ≥ 0.05
结论:这个平均数能代替总体平均数。
六、显著性检验的计算 (一)单样本平均数显著性检验
随机事件:某特定事件只是可能发生的几种事件中的一种的事件。
2、小概率事件实际不可能原理
3、标准误;标准误与标准差联系与区别。
4、样本平均数抽样总体与原始总体的两个参数间的联系。
5、t 分布与标准正态分布的区别与联系。
第五章 统计假设检验
一、思路 1、假设对试验样本所在的总体; 2、确定显著水平;
i第八章单因素方差分析
第二节 固定效应模型
一、线性统计模型
yij i ij
要检验a个处理效应的相等性,就要判断各αi是否为0。
H0:α1= α2 =……= αa =0
HA:αi ≠ 0
(至少有1个
i)
若接受H0,则不存在处理效应,每个观测值是由总
平均数加上随机误差构成;
若拒绝H0,则存在处理效应,每个观测值是由总平
34.7 33.3 26.2 31.6 125.8 31.450
33.2 26.0 28.6 32.3 120.1 30.025
27.1 23.3 27.8 26.7 104.9 26.225
32.9 31.4 25.7 28.0 118.0 29.500
2、单因素方差分析的数据格式:
Y1
Y2
Y3
均数、处理效应及误差三部分构成。
总变异
处理间 (组间)变异
误差或处理内 (组内)变异
1. 总变异是测量值yij与总的均数间的差异。
2. 处理间变异是由处理效应引起的变异。 3. 处理内变异是由随机误差引起的变异。
用离均差平方和的平均(均方、方差)反映变异的大小
二、平方和与自由度的分解
1. 总平方和(total sum of squares, SST): 每
著性t 检验的延伸。
ANOVA 由 英 国 统 计 学 家 R.A.Fisher 首 创 , 用 于 推 断多个总体均数有无差异。
单因素方差分析(一种方式分组的方差分析): 研究对象只包含一个因素(factor)的方差分析 。单因素实验:实验只涉及一个因素,该因素
有a个水平(处理),每个水平有n次实验重复
na 4 4
SST
a i1
07t检验--方差分析(医学统计学)
• 例1(P60例7-1) 以往通过大规模调查已知某地新生 儿出生体重为3.30kg.从该地难产儿中随机抽取35 名新生儿作为研究样本,平均出生体重为3.42kg,标 准差为0.40kg,问该地难产儿出生体重是否与一般 新生儿体重不同?
例题里涉及两个总体:
• 一般新生儿出生体重(已知总体,µ0=3.30kg) • 该地难产儿出生体重(未知总体,µ未知) • 3.42 >3.30既可能是抽样误差所致,或本质上不同
(n1
1)S12
(n2
1)S
2 2
n1 n2 2
若n1=n2时:
S X1X 2
S2 S2 X1 X2
S12
n1
S
2 2
n2
例3 测得14名慢性支气管炎病人与11名健
康人的尿中17酮类固醇(mol/24h)排出量 如下,试比较两组人的尿中17酮类固醇的 排出量有无不同。
• 原始调查数据如下:
t | 1.33 | 0.58 7.91 12
• (3)确定P值,作出推断结论 自由度=n-1=12-1=11,查附表2,t界值表,得
单侧t0.05,11=1.796,t=0.58<t0.05,11=1.796,故P > 0.05。 按α=0.05水准,不拒绝H0, 差异无统计学意义。
• 结论:故尚不能认为该减肥药有减肥效果。
t ' 10.38 6.62 2.0639 6.322 2.162 14 16
v 15.6447 16,
查 t 界 值 表 , t t0 . 0 5 / 2=(21.61)1 9 。 P > , 不 拒 绝 H0, 尚 不 能 认 为 两 种 药 的 疗 效 不 等 。
三、t检验与Z检验
心理学研究方法第七讲心理统计方法
1、平均数(2)
几何平均数
几何平均数(geometric mean)用Mg表示。 当计算的数据中有极端数据时,一般使用几何平均
数来表示数据的集中趋势。 n为数据的个数,X1为数据的值。
Mg n X1 X2 Xn
心理学研究方法
第七讲心理统计方法
21
2、中数
中数(median)
是在一系列按大小顺序排列的数据中的一个 点,在这个系列中有一半数据在这个点以上, 有一半数据在这个点以下。
心理学研究方法
第七讲心理统计方法
25
2、四分差
四分差用Q表示,说明按大小顺序排列的一系列数据中间 50%个数据的分散程度。
四分差指的是第一个四分点Q1和第三个四分点Q3的差的一 半。
中数实际上就是第二个四分点 Q2。Q可以说明一个分布的 中间部分数据的密度。如果一个分布中间部分的数据比较 集中,则两个四分点就离得近些,Q的数值也就小些;如 果一个分布中间部分的数据比较分散,则两个四分点就离 得远些,Q的数值也就大些。所以Q的大小可以说明一个 分布中间部分的数据分散程度。
Q Q3 Q1 2
心理学研究方法
第七讲心理统计方法
26
3、平均差
平均差是一个分布中每个变量和平均数的差的绝 对值的平均值,用AD表示。
如果每个数值和平均数的差越大,它离平均数就 越远,表明这个分布也就越分散,平均差也就越 大,所以和平均数一样,平均差也是容易受极端 数值影响的。
XX
AD n
心理学研究方法
第七讲心理统计方法
12
2、统计表的内容(3)
表注
写于表的下面。它不是统计表的必要组成部 分。用来解释标题的内容,数据来源和数据 含义等。
心理学研究方法
平均数实验报告(3篇)
教育学中的教育研究与实证研究教育学作为一门学科,研究的核心是教育。
而教育研究则是教育学中一项重要的学术活动,旨在通过科学的方法和实证的研究,探索教育问题、提高教育质量、改进教育实践。
本文将重点讨论教育学中的教育研究与实证研究。
一、教育研究的定义与特点教育研究是通过研究教育现象、教育问题,以期获得有关教育的知识、理论、原则和规律的一种学术活动。
它具有以下几个特点:1.多学科交叉:教育研究涉及心理学、社会学、经济学等多个学科,从多个角度分析教育问题。
2.理论与实践结合:教育研究既关注理论建构,又关注对教育实践的指导。
3.问题导向:教育研究关注解决实际问题,旨在提高教育质量和实践水平。
4.科学化和系统化:教育研究需要运用科学的方法和系统的研究设计,确保研究结果的可靠性和有效性。
二、实证研究在教育研究中的地位与作用实证研究是教育研究的一种重要方法。
它注重通过实证的方式,即观察、收集和分析数据,从而验证教育理论的有效性,推动教育实践的改进。
1.提供实证支持:实证研究通过数据和实际观察,为教育理论提供实证支持,验证其有效性。
例如,研究表明针对个体差异的不同教育策略对学生学习成绩的影响,促进了个性化教育的实施。
2.改进教育实践:实证研究可以发现和解决实际教育中的问题,提出改进教育实践的有效策略。
例如,实证研究发现少儿早期教育对孩子语言能力和认知发展的重要性,为设计优质的早期教育课程提供了依据。
3.政策制定与评估:实证研究在教育政策的制定和评估中具有重要作用。
通过实证研究获取的数据和结论可作为决策者制定政策和评估政策效果的依据。
例如,基于实证研究结果,政府可以调整教师培训政策,提高教育质量。
三、教育学中的实证研究方法与技巧在教育学中,实证研究方法与技巧千差万别,这些方法可以根据具体问题和研究目的的不同而选择。
常见的实证研究方法包括问卷调查、实验研究、案例研究等。
1.问卷调查:通过设计问卷并对被研究者进行调查,收集大量数据,并通过统计分析来验证研究假设。