
核函数
核函数(2010-12-23 23:08:30)分类:工作篇标签:校园高斯核函数所谓径向基函数(Radial Basis Function 简称 RBF), 就是某种沿径向对称的标量函数。
通常定义为空间中任一点x到某一中心xc之间欧氏距离的单调函数, 可记作 k(||x-xc||), 其作用往往是局部的 , 即当x远离xc时函数取值很小。
高斯核函数 - 常用公式最常用的径向基函数是高斯核函数 ,形式为 k(||x-xc||)=exp{- ||x-xc||^2/(2*σ)^2) } 其中xc为核函数中心,σ为函数的宽度参数 , 控制了函数的径向作用范围。
核函数简介(1)核函数发展历史早在1964年Aizermann等在势函数方法的研究中就将该技术引入到机器学习领域,但是直到1992年Vapnik等利用该技术成功地将线性SVMs推广到非线性SVMs时其潜力才得以充分挖掘。
而核函数的理论则更为古老,Mercer定理可以追溯到1909年,再生核希尔伯特空间(ReproducingKernel Hilbert Space, RKHS)研究是在20世纪40年代开始的。
(2)核函数方法原理根据模式识别理论,低维空间线性不可分的模式通过非线性映射到高维特征空间则可能实现线性可分,但是如果直接采用这种技术在高维空间进行分类或回归,则存在确定非线性映射函数的形式和参数、特征空间维数等问题,而最大的障碍则是在高维特征空间运算时存在的“维数灾难”。
采用核函数技术可以有效地解决这样问题。
设x,z∈X,X属于R(n)空间,非线性函数Φ实现输入间X到特征空间F的映射,其中F属于R(m),n<<m。
根据核函数技术有:K(x,z) =<Φ(x),Φ(z) >(1)其中:<, >为内积,K(x,z)为核函数。
从式(1)可以看出,核函数将m维高维空间的内积运算转化为n维低维输入空间的核函数计算,从而巧妙地解决了在高维特征空间中计算的“维数灾难”等问题,从而为在高维特征空间解决复杂的分类或回归问题奠定了理论基础。
(3)核函数特点核函数方法的广泛应用,与其特点是分不开的:1)核函数的引入避免了“维数灾难”,大大减小了计算量。
而输入空间的维数n对核函数矩阵无影响,因此,核函数方法可以有效处理高维输入。
2)无需知道非线性变换函数Φ的形式和参数.3)核函数的形式和参数的变化会隐式地改变从输入空间到特征空间的映射,进而对特征空间的性质产生影响,最终改变各种核函数方法的性能。
4)核函数方法可以和不同的算法相结合,形成多种不同的基于核函数技术的方法,且这两部分的设计可以单独进行,并可以为不同的应用选择不同的核函数和算法。
(4)常见核函数核函数的确定并不困难,满足Mercer定理的函数都可以作为核函数。
常用的核函数可分为两类,即内积核函数和平移不变核函数,如:1)高斯核函数K(x,xi) =exp(-||x-xi||2/2σ2;2)多项式核函数K(x,xi)=(x〃xi+1)^d, d=1,2,…,N;3)感知器核函数K(x,xi) =tanh(βxi+b);4)样条核函数K(x,xi) = B2n+1(x-xi)。
(5)核函数方法实施步骤核函数方法是一种模块化(Modularity)方法,它可分为核函数设计和算法设计两个部分,具体为:1)收集和整理样本,并进行标准化;2)选择或构造核函数;3)用核函数将样本变换成为核函数矩阵,这一步相当于将输入数据通过非线性函数映射到高维特征空间;4)在特征空间对核函数矩阵实施各种线性算法;5)得到输入空间中的非线性模型。
显然,将样本数据核化成核函数矩阵是核函数方法中的关键。
注意到核函数矩阵是l×l的对称矩阵,其中l为样本数。
(6)核函数在模式识别中的应用1)新方法。
主要用在基于结构风险最小化(Structural Risk Minimization,SRM)的SVM中。
2)传统方法改造。
如核主元分析(kernel PCA)、核主元回归(kernel PCR)、核部分最小二乘法(kernel PLS)、核Fisher判别分析(Kernel Fisher Discriminator, KFD)、核独立主元分析(Kernel Independent Component Analysis,KICA)等,这些方法在模式识别等不同领域的应用中都表现了很好的性能。
SVM,核函数,MercerSVM,支持向量机,很神奇的一个东西,能想出用核函数来免去高维变换,直接用低维度的参数带入核函数来等价计算高维度的向量的内积的人真是天才。
Mercer,凡是满足Mercer条件的,都能用于免除变化,而直接利用低纬度的矢量计算高纬度矢量的内积的函数,Mercer定理还说明了我们要求解的问题的对偶形式的函数是凸函数,不存在局部最优解,而只有全局最优解。
而内积,正是SVM求最优化分割面需要用到的。
而维度变换,正是SVM用来求解线性不可分的一个手段。
而有了核函数,你就可以绕过维度变换,直接利用核函数进行变换求解高纬度的点的内积。
/vivounicorn/archive/2010/12/13/1904720.htmlSVM学习——核函数还记得上篇末提到的对于优化问题:的求解需要计算这个内积,而如果输入样本线性不可分的话,我们采取的方法是通过函数映射将输入样本映射到另外一个高维空间并使其线性可分。
以库克定律为例(/zh-cn/静电力):一个电量为的点电荷作用于另一个电量为的点电荷,其静电力的大小,可以用方程表达为:,其中,是两个点电荷之间的距离,是库仑常数。
显然这个定律无法用线性学习器来表达,看到乘积想到ln函数,对原始形式两边取ln,得到:,令,,,,,那么就得到一个线性学习器:这个过程可以用下图说明:这样就将内积就变成了。
求可以有两种方法:1、先找到这种映射,然后将输入空间中的样本映射到新的空间中,最后在新空间中去求内积;2、或者是找到某种方法,它不需要显式的将输入空间中的样本映射到新的空间中而能够在输入空间中直接计算出内积。
先看第一种方法,以多项式为例,对其进行变换,,,,,得到:,也就是说通过把输入空间从二维向四维映射后,样本由线性不可分变成了线性可分,但是这种转化带来的直接问题是维度变高了,这意味着,首先可能导致后续计算变复杂,其次可能出现维度之咒,对于学习器而言就是:特征空间维数可能最终无法计算,而它的泛化能力(学习器对训练样本以外数据的适应性)会随着维度的增长而大大降低,这也违反了“奥坎姆的剃刀”,最终可能会使得内积无法求出,于是也就失去了这种转化的优势了;再看第二种方法,它其实是对输入空间向高维空间的一种隐式映射,它不需要显式的给出那个映射,在输入空间就可以计算,这就是传说中的核函数方法:定义1:核是一个函数,对于所有的满足,,这里的为从到内积特征空间的映射。
于是输入空间的标准内积就被推广了。
什么时候才是核函数呢?假设有输入空间且为对称函数,那么对于所有样本得到下面矩阵:,显然,这个是个对称矩阵,那么对于对称矩阵一定存在一个正交矩阵,使得,这里是包含k的特征值的对角矩阵,特征值对应的特征向量为,其中n为样本数,对输入空间做如下映射:于是有,(其中为特征向量组成的矩阵,为相应特征值组成的三角矩阵),也就是说K 是对应于映射的核函数。
例子:有,由解得特征值:,,对2重特征根4求的基础解系、正交化、单位化后得到特征向量:和,对的特征向量单位化后得到,于是有,满足,对所有输入样本做映射得:;;。
随便选两个做内积,如。
由此可见:就是对应于特征映射的核函数,也就得到下面的结论:定理1:存在有限输入空间,为上的对称函数,那么是核函数的充要条件是矩阵半正定,此时相当于对输入空间向特征空间进行了隐式的映射。
对于上面的映射,令,于是,进而。
定理3:设是的一个紧子集(闭合且有界子集),为上的对称函数,如果它在希尔伯特空间上的积分算子满足:这里指的是由满足条件的所有函数组成的空间。
在上扩展到一个一致收敛的序列,该序列由的特征函数构成,归一化使得,且所有特征值,则核函数可以被特征分解为:在核方法中有一个相当重要的、不得不说的概念(先打个标记):定义2:设是希尔伯特函数空间,其元素是某个抽象集合上的实值或复值函数,如果对于任何,作为的函数都是中的元素,而且对于任何及取内积有:则称为为再生核希尔伯特空间(Reproducing Kernel Hilbert Space,RKHS);称为再生核空间的再生核(简称RK)。
定理4:对于定义在域上的每一个核,存在一个定义在上的函数的再生希尔伯特空间,其中是再生核。
反过来,对于线性有界函数的任意希尔伯特空间,存在再生核这个命题也成立。
当然也可以利用核函数来构造核函数,有时候这种构造会很有效的解决问题:条件:设、是上的核,,是上的实值函数,,是上的核,是一个对称半正定矩阵,则下面的函数都是核:1、;2、;3、;4、;5、;6、。
核的选择对于支持向量机至关重要,选定核后,原问题就变成了:这个优化问题有最优解么?记得核要满足Mercer 条件,即矩阵在所有训练集上半正定,这说明这个优化是凸优化,于是这个条件保证了最大化间隔优化问题有唯一解,简直是天作之合啊,配合的天衣无缝;最后求的和,那么从输入空间向特征空间隐式映射后得到的最大间隔超平面也就出来了:,且有几何间隔。
常用核函数总结如下:线性核函数:多项式核函数:高斯核函数:核函数:下面这个链接收集了若干核函数:/html/y2010/2292.html关于核方法的理论部分涉及到泛函分析、微积分等等,水比较深,我推荐一本书:《Kernel Methods for Pattern Analysis》(模式分析的核方法),作者是:John Shawe-Taylor和Nello Cristianini 。
SVM学习——统计学习理论关于统计学习的理论博大精深,想要弄明白是需要花费很大功夫的,涉及到方方面面的数学知识(比如泛函分析、高等数学、概率论、统计学…….),我这里也就是把一些基本概念、理论规整一下。
存在一个未知的系统、给定的输入样本空间和这些输入样本通过处理后的输出。
机器学习的过程可以看做是这样的:利用机器学习的方法,根据和得到一个学习机(也可以叫模型),学习机在接受训练、测试样本以外的样本后得到的输出可以被认为是未知系统针对输入得到的输出的近似,所以这个学习机可以认为是对的内在规律的近似。
实际上,可以将从输入空间产生样本(向量)看做从于某个客观存在的、确定的但是未知的概率分布函数中相互独立地抽取出来的;显然由这些通过产生的输出服从,而我们的学习器应该是一个函数集合,这里的为参数集合,例如:线性分类器集合为,通过对参数的不同取值,我们可以得到一个函数集合;那么寻找这个学习器的过程就变成了从这个函数集合中找出能最佳逼近输入样本的函数。
拉普拉斯核函数
拉普拉斯核函数拉普拉斯核函数是机器学习中一个重要的非线性核函数,它在图像识别、语音识别、自然语言处理、数据挖掘等领域具有广泛的应用。
在对数据进行处理和特征提取时,拉普拉斯核函数可以将数据映射到高维空间中,并在高维空间中进行处理,从而更好地发现数据之间的关系。
拉普拉斯核函数的数学形式为:$$ K(x_i,x_j)=\exp(-\frac{||x_i-x_j||}{2\sigma^2}) $$其中,$x_i$和$x_j$表示数据样本,$||\cdot||$表示欧几里得距离,$\sigma$表示拉普拉斯核函数的参数,也被称为带宽(bandwidth)。
拉普拉斯核函数与高斯核函数十分相似,但也有一些不同之处。
拉普拉斯核函数对样本之间的相似度计算更加“硬”,即可以更好地保留数据之间的局部特征。
而高斯核函数则更加“软”,对于样本之间的相似度计算更加平滑,有一定的平滑作用。
在使用拉普拉斯核函数进行数据处理时,主要有以下两步:1.将数据映射到高维空间中拉普拉斯核函数可以将数据映射到高维空间中,这样可以更好地发现并利用数据的局部特征。
例如在图像识别中,一个图像可以表示为一个由像素点组成的向量,拉普拉斯核函数可以将这个向量映射到一个更高维的向量空间中。
在高维空间中,图像中的不同颜色和图案等局部信息可以更好地被区分和利用,从而实现更加准确的图像识别。
2.利用计算机算法处理数据在高维空间中,数据的非线性特征更加明显,但计算量也会增加,因此需要利用一些机器学习算法来进行处理。
例如,支持向量机(SVM)是一种常用的机器学习算法,它可以在高维空间中进行分类和回归等任务。
利用SVM算法,可以更加准确地分类图像、文字和语音等数据。
在实际使用中,拉普拉斯核函数可以与其他机器学习算法相结合,例如K近邻算法和逻辑回归等,以实现更加精准和全面的数据分析和应用。
综上所述,拉普拉斯核函数是机器学习中应用广泛的非线性核函数,可以将数据映射到高维空间中,更好地发现和利用局部特征。
cuda核函数调用核函数的方法

cuda核函数调用核函数的方法CUDA是一种并行计算平台和编程模型,可以在NVIDIA的GPU上进行高性能并行计算。
在CUDA中,核函数是GPU上执行的并行计算任务的基本单位。
通常情况下,核函数只能由主机代码调用并在GPU上执行。
然而,有时候我们需要在核函数中调用其他的核函数。
下面将介绍一种CUDA核函数调用核函数的方法。
在CUDA中,我们可以使用CUDA运行时API提供的`cudaLaunchKernel`函数来调用其他的核函数。
该函数可以在当前的核函数中启动另一个核函数的执行。
步骤如下:1. 首先,在当前的主核函数中定义要调用的子核函数。
子核函数应该使用`__device__`修饰符进行标识,以使其可以在GPU上执行。
例如:```cuda__device__ void childKernel(int* data){// 子核函数的实现// ...}```2. 在主核函数中使用`cudaLaunchKernel`函数来调用子核函数。
例如:```cuda__global__ void parentKernel(int* data){// 调用子核函数cudaLaunchKernel((void*)childKernel, gridDim.x, blockDim.x, args, 0, stream);// args是子核函数的参数列表// gridDim.x表示子核函数的网格维度// blockDim.x表示子核函数的块维度// stream表示要执行子核函数的流}```在调用`cudaLaunchKernel`函数时,需要传递子核函数的地址,子核函数的网格维度、块维度和参数列表,以及要在其中执行子核函数的流。
通过以上步骤,我们可以在CUDA中实现核函数调用核函数的功能。
这种方法可以帮助我们更好地组织并行计算任务,提高GPU上的计算效率。
但需要注意的是,由于核函数调用核函数会引入额外的开销,应谨慎使用并根据具体情况进行优化。
svm 高斯核函数
svm 高斯核函数支持向量机(Support Vector Machine,SVM)是一种常用的机器学习算法,广泛应用于数据分类和回归分析等领域。
其中,高斯核函数(Gaussian Kernel)是SVM中常用的核函数之一,也称为径向基函数(Radial Basis Function,RBF)。
本文将重点介绍SVM高斯核函数的原理和应用。
一、SVM简介支持向量机是一种监督学习算法,通过寻找一个最优超平面来实现数据的分类。
在线性可分的情况下,SVM可以直接找到一个线性的超平面将数据分开;而在线性不可分的情况下,SVM通过引入核函数来将数据映射到高维空间,从而实现数据的非线性分类。
二、高斯核函数高斯核函数是一种常用的非线性核函数,其作用是将数据映射到无穷维的特征空间中,使得原本线性不可分的数据在新的特征空间中变得线性可分。
高斯核函数的计算方式是通过计算输入特征与支持向量之间的高斯距离来确定数据点在新空间中的位置,从而实现数据的分类。
三、高斯核函数的优势1. 非线性映射:高斯核函数能够将数据映射到高维空间中,使得原本线性不可分的数据在新空间中变得线性可分,提高了分类的准确性。
2. 鲁棒性:高斯核函数对数据的分布不敏感,能够处理非线性和复杂的数据分布,适用于各种分类问题。
3. 灵活性:高斯核函数的参数可以调节,可以根据具体问题来选择合适的参数,提高模型的泛化能力。
四、高斯核函数的应用高斯核函数在图像识别、文本分类、生物信息学等领域都有广泛的应用。
例如,在图像识别中,高斯核函数可以有效地处理图像中的复杂特征,提高图像分类的准确性;在文本分类中,高斯核函数可以处理文本数据中的非线性关系,提高分类的精度和泛化能力。
SVM高斯核函数作为一种强大的非线性分类工具,在实际应用中表现出了良好的性能和稳定性。
通过合理选择参数和优化模型,高斯核函数可以有效地处理复杂的分类问题,为数据分析和模式识别提供了重要的支持。
希望本文对读者对SVM高斯核函数有所了解,能够在实际应用中发挥其优势,取得更好的分类效果。
svm 高斯核函数

svm 高斯核函数SVM(Support Vector Machine)是一种常用的机器学习算法,而高斯核函数是SVM中常用的核函数之一。
本文将介绍SVM和高斯核函数的基本概念和原理,并探讨其在实际应用中的优势和局限性。
SVM是一种监督学习算法,用于进行分类和回归分析。
其基本思想是通过在特征空间中构建一个最优超平面来实现数据的分类。
SVM 在解决线性可分问题时效果较好,但在处理线性不可分问题时,需要借助核函数来进行非线性映射,从而将样本映射到高维特征空间中。
高斯核函数是SVM中常用的一种核函数,也被称为径向基函数(Radial Basis Function,RBF)。
它的数学表达形式是一个高斯分布函数,其作用是将数据从原始特征空间映射到无穷维的特征空间中。
高斯核函数的参数决定了数据映射后的特征空间的维度和形状。
使用高斯核函数的SVM具有以下优势。
首先,高斯核函数能够处理非线性问题,通过将数据映射到高维空间中,使得原本线性不可分的问题变得线性可分。
其次,高斯核函数可以灵活地调节特征空间的维度和形状,适应不同的数据分布和分类要求。
最后,高斯核函数的计算速度较快,适用于大规模数据的处理。
然而,高斯核函数也存在一些局限性。
首先,高斯核函数的参数选择对结果影响较大,需要通过交叉验证等方法来确定最佳参数。
其次,高斯核函数在处理高维数据时会面临维度灾难的问题,导致计算复杂度增加。
另外,高斯核函数对于噪声和异常值较为敏感,容易造成过拟合或欠拟合。
在实际应用中,SVM和高斯核函数被广泛应用于图像识别、文本分类、生物信息学等领域。
例如,在图像识别中,通过将图像特征映射到高维空间中,SVM能够实现对图像的准确分类。
在文本分类中,SVM结合高斯核函数可以对文本进行有效的分类和情感分析。
尽管SVM和高斯核函数在理论上有一定的局限性,但在实际应用中它们仍然是一种强大而有效的机器学习工具。
通过合理选择参数和特征,以及优化算法的实现,可以充分发挥SVM和高斯核函数的优势,实现对复杂问题的准确分类和回归分析。
核函数的计算与应用
核函数的计算与应用核函数在机器学习和模式识别领域中扮演着重要的角色。
它们能够将输入数据映射到更高维度的特征空间,从而解决线性不可分的问题。
本文将介绍核函数的计算方法,并探讨其在支持向量机(SVM)和主成分分析(PCA)等算法中的应用。
一、核函数的计算方法核函数是一种在机器学习中常用的函数,用于将低维空间的数据映射到高维空间。
常见的核函数包括线性核函数、多项式核函数、高斯径向基函数等。
1. 线性核函数线性核函数是最简单的核函数之一,它可以直接对原始特征进行线性变换。
其计算方法为:K(x, y) = x·y2. 多项式核函数多项式核函数通过多项式的方式将数据映射到高维空间。
其计算方法为:K(x, y) = (x·y + c)^d3. 高斯径向基函数(RBF)高斯径向基函数是一种常用的核函数,它可以将数据映射到无穷维的特征空间。
其计算方法为:K(x, y) = exp(-γ ||x-y||^2)其中,γ为高斯核函数的带宽参数,||x-y||表示输入数据x和y之间的欧氏距离。
二、核函数在支持向量机中的应用支持向量机是一种常用的分类器,它能够在非线性可分问题上取得较好的性能。
核函数在支持向量机中起到了关键作用。
1. 线性支持向量机线性支持向量机通过线性核函数对数据进行映射,从而实现特征的扩展。
它在处理线性可分问题时表现出色,计算效率高。
2. 非线性支持向量机非线性支持向量机通过非线性核函数对数据进行映射,从而解决非线性可分问题。
常用的非线性核函数包括多项式核函数和高斯径向基函数。
三、核函数在主成分分析中的应用主成分分析是一种常用的降维技术,它通过将高维数据映射到低维空间,提取出最重要的特征。
核函数在主成分分析中也有广泛的应用。
1. 核主成分分析(Kernel PCA)核主成分分析是主成分分析的扩展形式,它通过非线性核函数将数据映射到高维空间,再进行降维操作。
相比传统主成分分析,核主成分分析能够更好地处理非线性关系。
核函数
生存?还是毁灭?——哈姆雷特可分?还是不可分?——支持向量机之前一直在讨论的线性分类器,器如其名(汗,这是什么说法啊),只能对线性可分的样本做处理。
如果提供的样本线性不可分,结果很简单,线性分类器的求解程序会无限循环,永远也解不出来。
这必然使得它的适用范围大大缩小,而它的很多优点我们实在不原意放弃,怎么办呢?是否有某种方法,让线性不可分的数据变得线性可分呢?有!其思想说来也简单,来用一个二维平面中的分类问题作例子,你一看就会明白。
事先声明,下面这个例子是网络早就有的,我一时找不到原作者的正确信息,在此借用,并加进了我自己的解说而已。
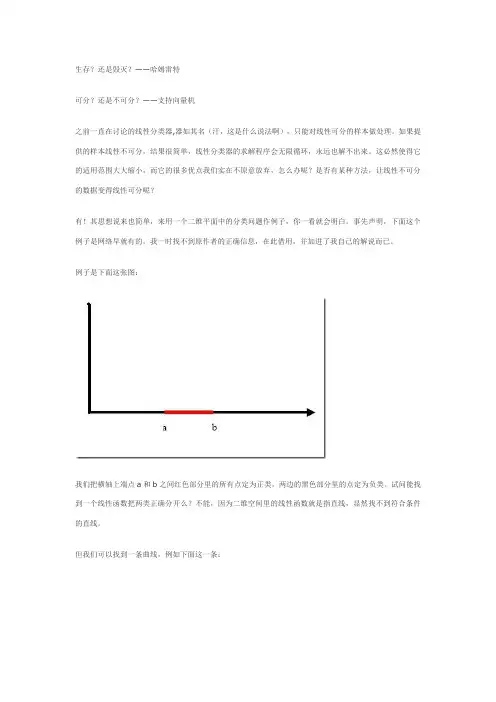
例子是下面这张图:我们把横轴上端点a和b之间红色部分里的所有点定为正类,两边的黑色部分里的点定为负类。
试问能找到一个线性函数把两类正确分开么?不能,因为二维空间里的线性函数就是指直线,显然找不到符合条件的直线。
但我们可以找到一条曲线,例如下面这一条:显然通过点在这条曲线的上方还是下方就可以判断点所属的类别(你在横轴上随便找一点,算算这一点的函数值,会发现负类的点函数值一定比0大,而正类的一定比0小)。
这条曲线就是我们熟知的二次曲线,它的函数表达式可以写为:问题只是它不是一个线性函数,但是,下面要注意看了,新建一个向量y和a:这样g(x)就可以转化为f(y)=<a,y>,你可以把y和a分别回带一下,看看等不等于原来的g(x)。
用内积的形式写你可能看不太清楚,实际上f(y)的形式就是:g(x)=f(y)=ay在任意维度的空间中,这种形式的函数都是一个线性函数(只不过其中的a和y都是多维向量罢了),因为自变量y的次数不大于1。
看出妙在哪了么?原来在二维空间中一个线性不可分的问题,映射到四维空间后,变成了线性可分的!因此这也形成了我们最初想解决线性不可分问题的基本思路——向高维空间转化,使其变得线性可分。
而转化最关键的部分就在于找到x到y的映射方法。
遗憾的是,如何找到这个映射,没有系统性的方法(也就是说,纯靠猜和凑)。
核函数表示欧式距离
核函数表示欧式距离标题:以核函数表示欧式距离一、引言在机器学习和模式识别领域,核函数被广泛用于处理非线性问题。
核函数可以将低维输入数据映射到高维特征空间,并在此基础上进行线性分类或回归。
然而,核函数并不直接计算高维特征向量的内积,而是通过一种叫做“核技巧”的方法来避免了直接在高维空间中的运算,大大提高了计算效率。
二、核函数与欧式距离在许多应用中,我们希望找到一个核函数,它能够表达两个样本之间的相似度或者距离。
特别地,如果我们考虑的是欧氏距离,那么这样的核函数应该满足以下性质:设d(x, y)为x和y之间的欧氏距离,则理想的核函数K(x, y)应满足:1. K(x, x) = 12. K(x, y) = 0 if d(x, y) = ∞ (即x和y完全不相关)3. K(x, y)是关于d(x, y)的单调递减函数三、几种常见的核函数及其与欧氏距离的关系1. 多项式核函数:K(x, y) = (γ<sup>θ</sup>(x·y + c)<sup>θ</sup>),其中θ是多项式的次数,c是偏置,γ是缩放因子。
当θ=1时,多项式核函数可以近似于欧氏距离。
2. 高斯核函数(RBF核):K(x, y) = exp(-γ||x-y||<sup>2</sup>),其中γ是控制函数宽度的参数。
高斯核函数是一种常用的核函数,它的值随着x和y的距离增大而减小,符合我们对核函数与欧氏距离关系的要求。
3. Sigmoid核函数:K(x, y) = tanh(αx·y + c),其中α和c是可调参数。
Sigmoid核函数的取值范围在-1和1之间,其值也随x和y的距离增大而减小。
四、结论核函数提供了一种有效的方法来处理非线性问题,特别是在高维特征空间中。
对于欧氏距离,虽然没有一个完美的核函数可以完全表示它,但多项式核函数和高斯核函数等常用核函数都可以很好地近似欧氏距离。
高斯过程回归核函数
高斯过程回归核函数高斯过程回归是一种非参数的回归方法,它可以用来预测一个连续变量的值。
在高斯过程回归中,核函数是非常重要的,因为它决定了预测结果的精度和稳定性。
本文将介绍高斯过程回归核函数的实现方法。
1. 高斯核函数高斯核函数是最常用的核函数之一。
它的形式如下:K(x, x') = exp(-||x - x'||^2 / (2 * l^2))其中,x和x'是输入向量,||.||表示欧几里得距离,l是一个控制核函数形状的参数。
当两个输入向量越接近时,它们之间的距离越小,高斯核函数值越大。
2. 实现方法下面给出一个完整的高斯过程回归核函数实现方法:import numpy as npdef gaussian_kernel(X1, X2, l=1.0):"""Compute the Gaussian kernel between two sets of vectors.Parameters----------X1 : numpy array of shape (n_samples_1, n_features)The first set of vectors.X2 : numpy array of shape (n_samples_2, n_features)The second set of vectors.l : floatThe length scale parameter.Returns-------K : numpy array of shape (n_samples_1, n_samples_2)The kernel matrix between X1 and X2."""n_samples_1, n_features = X1.shapen_samples_2, _ = X2.shapeK = np.zeros((n_samples_1, n_samples_2))for i in range(n_samples_1):for j in range(n_samples_2):diff = X1[i] - X2[j]K[i, j] = np.exp(-np.dot(diff, diff) / (2 * l**2))return K在这个实现方法中,我们首先计算了输入向量的数量和维度。
cuda 核函数内for循环
CUDA(Compute Unified Device Architecture)是由NVIDIA推出的并行计算架构,可以利用GPU(Graphics Processing Unit)进行高性能计算。
在CUDA中,核函数(kernel function)是在GPU上执行的并行函数,它可以由多个线程同时执行,以加速计算过程。
对于一些需要大量重复计算的任务,可以使用核函数内的for循环来实现并行化计算,从而提高计算效率。
1. 核函数的概念和作用核函数是在CUDA中执行的并行函数,可以由多个线程同时执行,以加速计算过程。
在核函数中,可以对数据进行并行处理,利用GPU的并行计算能力来加速计算任务。
核函数的使用可以极大地提高计算性能,尤其是对于需要重复计算的任务来说,可以实现更高效的并行计算。
2. 核函数内的for循环在核函数内部,通常需要对数据进行遍历和计算,而这些计算往往需要通过循环来实现。
在CUDA中,可以使用for循环来对数据进行并行处理,实现并行化计算。
在核函数内部使用for循环,可以将计算任务分配给多个线程来并行处理,以提高计算效率。
通过核函数内的for循环,可以充分利用GPU的并行计算能力,加速计算过程。
3. 实现核函数内的for循环要实现核函数内的for循环,首先需要了解GPU的并行计算模式。
在CUDA中,核函数内的每个线程都会处理一个数据元素,因此可以通过for循环将计算任务平均分配给每个线程来实现并行化计算。
还需要考虑数据的划分和线程的同步等问题,确保计算任务能够正确并且高效地并行化执行。
4. 示例代码下面是一个在核函数内实现for循环的示例代码:```c__global__ void parallel_for_loop(float* input, float* output, int N) {int tid = blockIdx.x * blockDim.x + threadIdx.x;for (int i = tid; i < N; i += blockDim.x * gridDim.x) {// 对数据进行计算output[i] = input[i] * 2;}}```在这个示例代码中,核函数`parallel_for_loop`内使用了for循环来处理数据。
cuda核函数 数组参数
cuda核函数数组参数【原创实用版】目录1.CUDA 核函数概述2.CUDA 核函数的数组参数3.数组参数的传递方式4.数组参数的优化正文一、CUDA 核函数概述CUDA(Compute Unified Device Architecture)是 NVIDIA 推出的一种通用并行计算架构,它允许开发人员利用 NVIDIA 的 GPU 进行高性能计算。
在 CUDA 中,核函数是一种可以运行在 GPU 上的函数,它可以接受输入参数并返回输出结果。
核函数的参数可以是标量、向量或者数组。
二、CUDA 核函数的数组参数在 CUDA 核函数中,数组参数是一种非常重要的参数类型。
数组参数可以在 GPU 上实现高效的数据操作,从而加速计算过程。
数组参数可以是一维数组、二维数组或者更高维的数组。
三、数组参数的传递方式在 CUDA 编程中,数组参数的传递方式主要有两种:1.拷贝数组:将整个数组从主机内存拷贝到设备内存,这种方式的优点是数据访问速度快,缺点是内存占用较高。
2.指向数组的指针:只将数组的首地址拷贝到设备内存,这种方式的优点是内存占用较低,缺点是数据访问速度较慢。
四、数组参数的优化为了提高 CUDA 核函数的性能,需要对数组参数进行优化。
以下是一些常见的优化方法:1.使用常量数组:对于不会改变的数组,可以将其声明为常量数组,这样可以避免重复拷贝数组,提高性能。
2.使用共享内存:对于多个线程需要访问的数组,可以将其存储在共享内存中,这样可以避免重复拷贝数组,提高性能。
3.使用纹理映射:对于较大的数组,可以将其映射到纹理内存中,这样可以提高数据访问速度,但需要注意纹理内存的使用限制。
4.优化数组访问模式:避免使用过于复杂的数组访问模式,尽量使用线性或者块状的数组访问模式,以提高性能。