
WEKA平台下的聚类分析算法比较研究
第21卷第1期
重庆科技学院学报(自然科学版)2019年2月
WEKA
平台下的聚类分析算法比较研究
韩存"",2
叶球孙1
(1.
武夷学院数学与计算机学院,福建武夷山354300
;
2.
认知计算与智能信息处理福建省高校重点实验室,武夷山354300
)
摘要:介绍
K -
means、
DBSCAN、
EM、
FarthestFGt等4种常用的聚类算法,
并在
WEKA中使用这些算法对
RG数据
集进行了聚类实验。
实验结果表明,
与
DBSCAN、
EM、
FarthestFlrst等聚类算法相比,
K -
means算法在误判率、
运行时
间、
生成簇数、
迭代次数方面与人工判断的吻合度最高。
关键词:聚类分析;
聚类算法;
实验;
WEKA %
I
d
中图分类号:
TP301.6
文献标识码:
A
聚类分析是数据挖掘研究中一个非常活跃的研
究领域。
数据挖掘的一个重要任务是发现众多数据
中的积聚现象,
然后对其进行定量化描述。
聚类分
析是在对数据不作任何假设的条件下,
用数学方法
研究和处理所给对象的分类以及各类之间的亲疏程
度,
其目标是要将具有相似特征的样本数据归为一
类,
并使得类内差异小、
类间差异大。
聚类与分类不
同。
在分类模型中存在样本数据,
这些数据的类标
号是已知的,
分类的目的是从训练样本集中提取出
分类的规则,
用于对其他类标号未知的对象进行类
表示。
聚类是在不知道目标数据的有关类的信息的
情况下,
以某种度量为标准将所有的数据对象划分
到各个簇中。
聚类分析因此又被称为无监督的学
习[1]。
聚类算法的目的是要寻找数据中潜在的自然
分组结构和特定的关系。
目前已经存在许多聚类算
法。
本次研究,
将通过实验对几种常用的聚类算法
进行比较分析。
1
常用的几种聚类算法概述
不同的聚类算法在进行决策树分析时存在一定
的差异。
评价聚类算法性能的指标主要有3
个:一
是正确预测的能力,
即预测的准确率;
二是可解释
性,
产生的有关模型要易于理解;
三是速度,
即产生
规则的时间越短越好[2]。
另外,
与人工判断的吻合
度是最直观的评判准则之一。
在众多的聚类算法文章编号
:1673 -1980(2019)01 -0090
-04
中,基于划分的K- means
算法、基于模型的EM
算
法、基于密度的DBSCAN
算法和基于分层的Far-
thetFGt
算法是比较常用的算法,我们主要比较分
析这4
种聚类算法的性能。
1.1 K - means
算法
1.1.1 K - means
的原理及流程
1967
年由 1 B. Macqueen
提出的 K- means
算
法,目前已经成为数理统计、模式识别、机器学习和
数据挖掘等领域应用最普遍的一种聚类算法,并有
多种变形算法,组成了 K - means
算法家族。
按照K - means
算法,先是进行粗略的分类,然
后根据某种最优的原则修改不合理的分类,直到类
分比较合理,形成最终的分类结果。因此,首先需要
随机地选择A
个对象,每个对象初始代表一个簇的
平均值或中心。接着将剩余的每个对象,根据其与
各个簇均值的距离,分派给最近的簇;
然后计算每个
簇的新均值。这个过程不断重复,直到准则函数收
敛。通常采用平方误差准则,其定义如下[3]:
%
E%\
p-
ml\2
f=1
p/Ci
其中:P
是空间中的点,表示给定的数据对象;T
是
簇[
的平均值。
K - means
均值划分算法的流程如下。
Input:K(
簇的数目),4(
包含ra
个对象的数
集)
收稿日期
:2018
-11
-20
基金项目
:福建省科技厅自然科学基金项目“
VCN智模变进制乘法计算杂性研究$(201711406)
作者简介
:韩存鸽(1979 —),女,硕士,讲师,研究方向为数据库、数据挖掘。
•
90 •韩存鸽,等:WEKA平台下的聚类分析算法比较研究
Output -X个簇的集合
方法
:(
1)从
D中任意选择
A个对象作为初始
簇中心;(
2) repeat;( 3 )根据簇中对象的均值,将每
个对象指派到最相似的簇;(
4)更新簇均值,即计算
每个簇中对象的均值;(
5)簇均值不再发生变化,则
结束)
1.1.2 K - means应用举例
坐标上有
5个点丨
i■,进行聚类
分析。
5个二维样本为
-?=(0,0),?
= (5,2),
? = (1. 5,0),? = (0,2),? = (5,0)〇
假设
O = 2〇
Step 1 -随机分为
2个簇,计算质心
M。
C1 =(?,?,?) C2 = (?,?)
M1 = {0+5+1.5/3,0+2+0/33 =|2.17,0.673
M2 = {0+5/2,2+2/23 = {2.5,13
& = [(0-2.17)2 + (0-0.67)2 + (5-2.17)2 +
(2 -0.67)2 + (1.5 -2.17)2 + (0 -0.67)2 ] =15.83
&2
=14.5
e2 =15.83 +14.5 =30.33
step 2 -计算质心到样本的距离,并取距离最小
的重新分配到簇。
P(M1,?)
=[(0-2.17)2 + (0-0.67)2]1T =2.27
P(M2,?) = 2. 69 => ? / C1
P(M1,?) =3. 12
P(M2,?) =2. 69 =>?/C2
P(M1,?) =0. 95
P(M2,?) =1.414 =>?/C1
P(M1,?) =2. 54
P(M2,?) =2. 69 =>?/C1
P(M1,?) =2. 91
P(M2,?) =2. 69 =>? /C2
step 3 -根据重新分配的簇
,计算新质心。
C1 =(?,?,?) C2 = (?,?)
M1 = {0.5,0.673 M2 = {5,1 (
相应的方差是
-e2 =4.166 7 +2 =6.166 7
第一次迭代后,总体误差显著减小(由
30. 33减
小到
6.166 7),算法终止。
!2 EM算法
EM 算法
(Expectation Maximization Algorithm)*4]
是一种逐次逼近算法,包括计算期望值和求极大值,
主要运用高斯混合模型的参数估计。该模型可以解
决聚类分析、机器学习等领域中的许多实际问题。
该算法的步骤如下:
Input -观测数据
(5 ,5 '…,5 )'高斯混合模型
Output-高斯混合模型参数(1) 取参数的初始值,开始迭代。
(2) 求期望值。依据当前模型参数,计算
lgP(5y+,的期望,即
N(,,0) =:[lgF(5/VI) I
5,)]。
(3) 求极大值。求函数
N(,,')对,的极
大值,即计算新一轮迭代的模型参数
-,(I+1)=
argmaxN(,,,(')。
(4) 重复第(
2)步和第(
3)步,直至收敛,即直
到对数似然函数值,不再有明显的变化为止。
! 3 DBSCAN 和
FarthestFirst 算法
DBSCAN( Density - Based Spatial Clustering Ap
plication with Noise)算法是一种经典的基于密度的
聚类算法,用于过滤噪声数据
,实现快速发现任意形
状的类的分析
[5]。执行流程
:扫描数据库,找到每个
点的邻居个数
e。如果
e大于阈限值,则该记录作为
中心记录,随即以这个记录为中心的类就产生了
[6]。
DBSCAN算法使用欧式距离度量,确定哪些实例属
于哪个簇。与
X均值算法不同,
DBSCAN算法可以
自动确定簇的数目,发现任意形状的簇,并纳入离群
概念。
FarthestFirst算法是快速地近似
X均值的聚类
算法,每一次取最远的那个点。该算法主要包括
2
个部分
-FarthestFirst遍历和层次聚类。
FarthestFirst
遍历的思想类似于构造一棵最小生成树(针对点到
集合)。算法过程如下
[7]-
Input-n data points wtli a distance metric d(. ”)
Pick a point and label it 1
For' =2,
3,
•••,
,
Fint the point furthest from { 1,2,…,'-1 ( and
label it
Let '(i)
= argmin j
P( i,j)
.
Let 8 = P(''(')
2 WEKA平台下的聚类过程
怀卡托智能分析环境(
Waikato Environment for
Knowledge Analysis,缩写为
“WEKA”),是
一
■种使用
Java语言编写的数据挖掘机器学习软件,其中包括
处理标准数据挖掘问题的所有方法,如分类、回归、
聚类、关联规则以及在新的交互式界面上的可视化。
WEKA是开放源代码,新编写的算法只要符合其接
口规范,就可以嵌入其中,从而扩充其原有算法。
以
K - means算法为例,介绍在
WEKA平台下
如何聚类。
WEKA平台把
K- means算法的实现命
名为
“ SimpleKMeans ” 算法,位于
weka. clusterers.
SimpleKMeans包中。以此构建聚类器,包括以下
4
•
91 •
基于Weka平台的机器学习方法探究
ISSN 1009-3044 Computer Knowledge and Technology电脑知识与技术
Vo1.8,No.10,April 2012. E—mail:eduf@CCCC.net.en
http://www.dnzs.net.en Teh+86—55 1—5690963 5690964
基于Weka平台的机器学习方法探究
李德有,李凌霞,郭瑞波
(哈尔滨金融学院,黑龙江哈尔滨150030)
摘要:针对机器学习技术理论性强、内容抽象、实践难的特点,提出了以weka软件为平台的机器学习实践方案,并详细阐述了实施
过程。通过对结果分析,达到使用Weka实践机器学习技术解决实际问题的目的。
关键词:机器学习;数据挖掘;WEKA
中图分类号:G642 文献标识码:A 文章编号:1009—3044(2012)10—2334—04
Research of Machine Learning Based on Weka Platform
LI De—you,LI Ling—xia,GUO Rui—bo
(Harbin Finance University,Harbin 1 50030,China)
Abstract:For the characteristics of the strong theoretical,content abstraction and hard practice during the Machine learning,we present
Machine learning practical solutions based on Weka platform in this paper,and elaborate the implementation process of the experimental
program.By analyzing the results,.Achieved using the Weka practice ofmachine learning technology tO solve practical problems.
基于Weka关联规则挖掘的针灸腧穴规律研究
龙源期刊网
基于Weka关联规则挖掘的针灸腧穴规律研究
作者:胡绿慧 任玉兰
来源:《电脑知识与技术》2014年第07期
摘要:针灸腧穴规律在针灸临床治疗中起着十分重要的作用,针对古今针灸临床治疗方案数据量大、关联性强的特点,运用关联分析中的Apriori算法,结合针灸学科特点和临床诊治规律,将经过筛选转换的数据在Weka平台中分析,充分利用其中的类和可视化功能,得出用穴规律、腧穴配伍规律等的分析结果。实验结果表明,基于WEKA的关联规则挖掘技术能有效的为针灸腧穴规律研究提供信息支持。
关键词: Weka;针灸腧穴规律;数据挖掘;关联规则
中图分类号:TP311 文献标识码:A 文章编号:1009-3044(2014)07-1361-03
针灸学是以中医理论为指导,在继承和发扬古代针灸学术思想和实践经验的基础之上,运用传统和现代科学技术研究经络、腧穴、操作技能、治疗法则、作用机制和防治疾病的一门学科,作为中医学科体系中最具特色和优势的学科,以其独特的治疗方法和卓越的临床疗效得到了国内外广泛关注和高度重视。临床上,由腧穴、施术方法和治疗时间组成的针灸处方是实现针灸疗效的重要条件,但在针灸临床治疗决策中,如何选取最优化的针灸处方是针灸医生面临的一大难题。随着信息技术的发展,医学信息的迅猛增加,而人脑的储存和处理信息的能力又有一定的局限性,因此会对临床问题的思考、信息的判断、寻找解决问题的办法和制定临床治疗方案决策造成必然的困扰。
本文针对针灸临床治疗方案的数据特点,借鉴循证医学的理念和方法整理、加工、更新以及评价古今针灸治疗疾病的临床证据,通过运用数据仓库存储、管理针灸诊断、治疗疾病的古代和现代临床证据以及相关针灸知识,结合针灸学科特点和临床诊治规律;通过对关联规则及相关算法进行分析,将针灸穴位数据与关联规则相结合,将历代针灸数据在WEKA软件中进行挖掘,得出用穴规律、腧穴配伍规律等的分析结果,从而指导医生的临床治疗方案决策。
!!!使用Weka进行数据挖掘
1.简介
数据挖掘、机器学习这些字眼,在一些人看来,是门槛很高的东西。诚然,如果做算法实现甚至算法优化,确实需要很多背景知识。但事实是,绝大多数数据挖掘工程师,不需要去做算法层面的东西。他们的精力,集中在特征提取,算法选择和参数调优上。那么,一个可以方便地提供这些功能的工具,便是十分必要的了。而weka,便是数据挖掘工具中的佼佼者。
Weka的全名是怀卡托智能分析环境(Waikato Environment for Knowledge Analysis),是一款免费的,非商业化的,基于JAVA环境下开源的机器学习以及数据挖掘软件。它和它的源代码可在其官方网站下载。有趣的是,该软件的缩写WEKA也是New Zealand独有的一种鸟名,而Weka的主要开发者同时恰好来自新西兰的the University of
Waikato。(本段摘自百度百科)。
Weka提供的功能有数据处理,特征选择、分类、回归、聚类、关联规则、可视化等。本文将对Weka的使用做一个简单的介绍,并通过简单的示例,使大家了解使用weka的流程。本文将仅对图形界面的操作做介绍,不涉及命令行和代码层面的东西。
2.安装
Weka的官方地址是/ml/weka/。点开左侧download栏,可以进入下载页面,里面有windows,mac os,linux等平台下的版本,我们以windows系统作为示例。目前稳定的版本是3.6。
如果本机没有安装java,可以选择带有jre的版本。下载后是一个exe的可执行文件,双击进行安装即可。
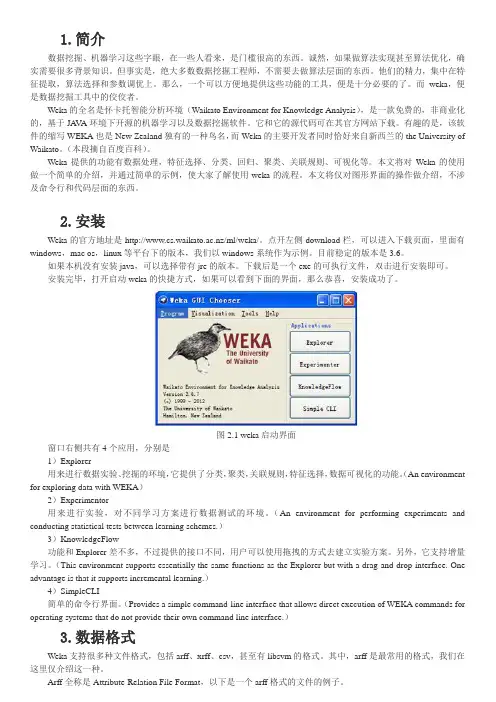
安装完毕,打开启动weka的快捷方式,如果可以看到下面的界面,那么恭喜,安装成功了。
图2.1 weka启动界面
窗口右侧共有4个应用,分别是
1)Explorer
用来进行数据实验、挖掘的环境,它提供了分类,聚类,关联规则,特征选择,数据可视化的功能。(An environment
for exploring data with WEKA)
weka二次开发

1 本科毕业设计论文 课题名称 基于JAVA的WEKA数据挖掘 平台分析及二次开发 学生姓名 林莉莉 学号 20032311 专业名称 计算机科学与技术 指导教师姓名 陈 慧 萍 申请学位级别 工学学士 学位授予单位 河海大学 论文提交日期 2007年6月 计算机及信息工程学院(常州) 2 河 海 大 学 本科毕业设计(论文)任务书 (理 工 科 类) Ⅰ、毕业设计(论文)题目: 基于JAVA的WEKA数据挖掘平台分析及二次开发 Ⅱ、毕业设计(论文)工作内容(从综合运用知识、研究方案的设计、研究方法和手段的运用、应用文献资料、数据分析处理、图纸质量、技术或观点创新等方面详细说明): 数据挖掘是目前计算机科学中活跃的研究领域之一, 所谓数据挖掘就是采用机器学习算法从大量数据中提取和挖掘知识,因此广泛用于智能数据分析和处理中。WEKA是基于java的数据挖掘平台,其中集合了大量能承担数据挖掘任务的机器学习算法,包括对数据进行预处理,分类,聚类,关联规则,属性选择以及在新的交互式界面上的可视化。由于其源码的开放性,WEKA不仅可以用于完成常规的数据挖掘任务,也可以用于数据挖掘的二次开发中。 本课题属研究性课题,要求学生阅读大量资料,自学数据挖掘方面的知识,分析WEKA数据挖掘的平台,写出全面的文献综述。并综合利用数据结构、算法设计与分析、JAVA语言等知识,进行基于WEKA平台的二次开发。具体任务如下: ①阅读国内外文献,了解数据挖掘技术的基本方法与应用;对数据挖掘的方法之一如分类或聚类算法作更深入的了解。 ②WEKA数据挖掘平台的分析:阅读WEKA数据挖掘平台的大量文档,分析其实现机理,了解WEKA进行数据挖掘的基本过程。结合①和②写出WEKA数据挖掘工具的文献综述。 ③WEKA平台的数据挖掘实验:分析WEKA的数据挖掘过程,分析WEKA所要求的数据集的格式和WEKA Explorer的功能模块,并准备典型的数据集,在WEKA平台上做大量数据挖掘测试实验,并分析其实现机理及存在问题。 ④研究WEKA开放源码,利用其提供的类,进行二次开发,实现数据挖掘的一个典型算法。 3 Ⅲ、进度安排: 第1—2周:确定设计任务。 第3—4周:阅读相关文献,外文翻译。 第5—7周:写出WEKA数据挖掘工具的文献综述; 第8—12周:WEKA数据挖掘平台的挖掘实验; 第13—15周:WEKA数据挖掘平台上的二次开发(使用JAVA); 第16周: 写毕业论文 第17周:资料整理、程序打包、准备答辩。 Ⅳ、主要参考资料: ① (美)Jiawei Han, Micheline Kamber. 数据挖掘: 概念与技术[M], 北京:机械工业出版社, 2001. ② Ian H.Witten.Data Mining:Practical Machine Learning Tools and Techniques (Second Edition) [M] , 北京:机械工业出版社, 2005 . ③ (美)米哈尔斯基. 机器学习与数据挖掘[M], 北京:电子工业出版社, 2004 ④ WEKA Tutorial. Machine Learning Algorithms in Java 指导教师: 陈慧萍 , 2007 年 3 月 1 日 学生姓名: 林莉莉 , 专业年级: 计算机03 系负责人审核意见(从选题是否符合专业培养目标、是否结合科研或工程实际、综合训练程度、内容难度及工作量等方面加以审核): 系负责人: , 年 月 日 4 摘 要 数据挖掘是在“信息爆炸,知识缺乏”的背景下提出的新技术。所谓数据挖掘就是从大量的、不完整的、有噪声的、模糊的、随机的数据中,提取隐含在其中的、人们事先不知道的、但又是潜在有用的信息和知识的过程。该技术在银行业、市场业、零售业、保险业及电信业等诸多领域的数据分析中有着广阔的应用前景。 本文首先针对数据挖掘技术作了比较全面的综述,并深入分析聚类方法。其次,针对学术界典型的开放数据挖掘工具WEKA,进行数据挖掘测试,主要包括预处理、分类、聚类、属性选择、关联规则及可视化等,并对挖掘结果进行统计分析,指出WEKA系统存在的缺陷及发展前景。为了弥补WEKA系统存在的一些缺陷,本文还在WEKA平台下进行二次开发,根据描述的k-中心点轮换法的算法流程,利用eclipse在WEKA平台下嵌入该算法,并对其进行优化以提高其聚类效果。 虽然本文研究的WEKA数据挖掘工具目前还处于研究阶段,但它却汇集了多样化的机器学习算法,是数据挖掘研究的理想选择。同时,本文所研究的k-中心点轮换算法改进了传统的k-中心点算法,避免陷入局部最优,并进行了属性正常化、处理残缺值等优化,聚类效果明显提高了。 关键词:数据挖掘 WEKA 聚类分析 k-中心点轮换算法 5 Abstract Data Mining is a new technology which is put forward with the background of data rich but knowledge poor. Generally, Data Mining is the process of extracting the connotative, unknown but potentially useful data and knowledge from the data that is plentiful, incomplete, noisy, fuzzy and stochastic. The technology has a widest application foreground in the data analysis on dozens of fields such as banking, marketing, retailing, insurance, telecom and so on. First, the paper makes a comprehensive summarization for the data mining technology and analyzes the clustering methods in depth. Second, the paper does some tests about data mining on WEKA which is a typical and open data mining tool in the academe. The tests mainly include preprocessing、classifying、clustering、associating、selecting attributes and visualization. Moreover, the paper statistically analyzes the test results and indicates the faults of the WEKA system and its development foreground. Last, in order to supply a gap for the WEKA system, the paper also makes secondary development on the WEKA platform according to the k-medoids substitution method’s flow chart by using eclipse IDE, and then optimizes this algorithm to improve the clustering effect. Although the data mining tool named WEKA that being investigated currently is on its research phase, but it integrates various machine learning methods and so it’s really a perfect choice for data mining research. At the same time, the k-medoids substitution method improves on the traditional k-medoids method, preventing it from getting into partial optimum solution. And the paper also makes some optimizations such as attributes normalizing, default value processing and so on, with what the clustering effect has been improved a lot. Key Words: Data Mining WEKA Cluster Analysis K-medoids Substitution Method 6 目 录 1 前言···························································································································································7 1.1 课题背景·······································································································································7 1.2 本文所做的主要工作····················································································································7 1.3 本文结构·······································································································································8 2 数据挖掘技术综述···································································································································9 2.1 数据挖掘的定义····························································································································9 2.2 数据挖掘的基本功能····················································································································9 2.3 数据挖掘的流程··························································································································10 2.4 数据挖掘的常用方法和技术······································································································11 2.5 数据挖掘的应用领域··················································································································12 2.6 国内外数据挖掘工具现状··········································································································13 2.7 聚类分析概述·····························································································································14 2.7.1 聚类概念··························································································································14 2.7.2 主要聚类方法的分类······································································································14 3 基于WEKA平台的数据挖掘测试············································································································16 3.1 WEKA系统简介····························································································································16 3.2 WEKA系统的特点·························································································································16 3.2.1 WEKA系统的文件格式·····································································································16 3.2.2 WEKA系统的界面·············································································································17 3.2.3 WEKA实现的功能及算法·································································································19 3.2.4 WEKA系统的包结构·········································································································22 3.3 WEKA系统的挖掘测试及结果分析·····························································································24 3.3.1 WEKA系统的数据挖掘过程·····························································································24 3.3.2 WEKA系统的挖掘实验·····································································································25 3.3.3 WEKA系统中存在的问题·································································································34 3.4 WEKA系统的发展前景·················································································································34 4 WEKA平台下的二次开发·························································································································35 4.1 二次开发背景及一般过程··········································································································35 4.1.1 二次开发背景··················································································································35 4.1.2 二次开发一般过程··········································································································35 4.1.3 系统的开发与运行环境··································································································35 4.2 K-中心点轮换算法······················································································································35 4.3 K-中心点轮换算法的实现··········································································································37 4.3.1 K-中心点轮换算法的类模块关系···················································································37 4.3.2 K-中心点轮换算法的流程图··························································································38 4.3.3 K-中心点轮换算法的类说明··························································································39 4.4 K-中心点轮换算法的测试··········································································································45 5 总结·························································································································································49 致谢································································································································································50 参考文献·························································································································································50 附录································································································································································51
weka数据挖掘实验报告
weka数据挖掘实验报告
Weka数据挖掘实验报告。
数据挖掘是一门利用各种算法和技术来发现数据中隐藏模式和规律的学科,而Weka作为一款开源的数据挖掘软件,提供了丰富的算法和工具,可以帮助用户进行数据挖掘实验和分析。本实验旨在利用Weka软件对给定的数据集进行数据挖掘分析,并撰写实验报告,以总结实验过程和结果。
首先,我们使用Weka软件载入了所提供的数据集,并对数据进行了初步的观察和分析。数据集包括了多个属性和类别,我们需要对数据进行预处理,包括处理缺失值、异常值和离群点等。在数据预处理完成后,我们选择了适当的数据挖掘算法进行建模和分析,包括分类、聚类、关联规则挖掘等。
在进行分类分析时,我们选择了决策树算法进行建模,并通过交叉验证和混淆矩阵等方法对模型进行评估。通过实验结果发现,决策树算法在该数据集上表现良好,能够对数据进行有效的分类和预测。接着,我们进行了聚类分析,选择了K均值算法对数据进行聚类,并对聚类结果进行了可视化展示和分析。在关联规则挖掘方面,我们利用Apriori算法挖掘了数据集中的频繁项集和关联规则,并对规则进行了解释和应用。
总结本次实验,我们通过Weka软件对给定的数据集进行了全面的数据挖掘分析,包括数据预处理、分类、聚类和关联规则挖掘等。实验结果表明,在该数据集上我们成功地应用了Weka软件提供的算法和工具,得到了有意义的分析结果,并对数据集中的模式和规律进行了深入挖掘和分析。通过本次实验,我们不仅熟悉了Weka软件的使用方法,还加深了对数据挖掘理论和算法的理解,提升了数据分析和挖掘的能力。
综上所述,本实验报告总结了我们在Weka软件上进行的数据挖掘实验过程和结果,通过实验我们对数据挖掘的方法和技术有了更深入的理解和应用。希望通过本次实验,能够对数据挖掘领域的学习和研究有所帮助,为今后的数据分析工作打下坚实的基础。
基于weka的数据挖掘实验报告

基于weka的数据挖掘实验报告
基于Weka的数据挖掘实验报告
数据挖掘是一种通过分析大量数据来发现隐藏在其中的模式和关联的技术。Weka是一个流行的数据挖掘工具,它提供了各种算法和工具,可以帮助研究人员和分析师挖掘数据中的有用信息。在本实验中,我们将使用Weka来进行数据挖掘,并撰写实验报告,以展示我们的研究成果和结果。
实验目的:
本次实验的目的是使用Weka工具对给定的数据集进行数据挖掘分析,探索数据中的模式和规律,并利用挖掘结果进行预测和决策。
实验步骤:
1. 数据收集和准备:首先,我们需要收集并准备实验所需的数据集。在本次实验中,我们选择了一个包含大量样本和多个属性的数据集,以便进行全面的数据挖掘分析。
2. 数据预处理:在进行数据挖掘之前,我们需要对数据进行预处理,包括数据清洗、缺失值处理、数据变换等步骤,以确保数据的质量和完整性。
3. 数据挖掘算法选择:Weka工具提供了多种数据挖掘算法,包括分类、聚类、关联规则挖掘等。我们将根据实验需求选择合适的算法进行分析。
4. 模型建立和评估:在选择了合适的算法后,我们将使用Weka工具建立数据挖掘模型,并对模型进行评估和验证,以确保模型的准确性和可靠性。
5. 结果分析和报告撰写:最后,我们将对实验结果进行分析和总结,并撰写实验报告,以展示我们的研究成果和发现。
实验结果: 通过使用Weka工具进行数据挖掘分析,我们得到了一些有价值的挖掘结果和模型预测。我们发现了数据中的一些隐藏模式和规律,并利用挖掘结果进行了一些预测和决策,为实验提供了有益的信息和见解。
结论:
本次实验通过使用Weka工具进行数据挖掘分析,取得了一些有意义的研究成果和结果。Weka工具提供了丰富的算法和工具,可以帮助研究人员和分析师挖掘数据中的有用信息,为决策和预测提供支持。我们相信,通过不断的实验和研究,我们可以进一步挖掘数据中的更多有价值的信息和知识。
基于Weka的MOOC学习者学习成绩影响因素分析——以Coursera网站北京大学一门课程为例
68数字教育DIGITAL EDUCATION
基于Weka的MOOC学习者学习
成绩影响因素分析
——以Coursera网站北京大学一门课程为例
王小越1 贾积有2
(1.江苏开放大学 设计学院,江苏 南京 210000; 2.北京大学 教育学院,北京 100871)
摘 要:本文应用数据挖掘软件Weka,对北京大学2015年在Coursera平台上线的一门课程中学员的网上学习行为数据进行了相关分析。对全体学员和有学习成绩的学员的学习行为分析结果均表明:学员的学习成绩与课程网页浏览次数、平时测验总成绩、论坛发帖数、论坛回帖得票呈正相关关系。对无学习成绩的学员学习行为分析结果表明:他们的论坛讨论参与度不高,不重视平时测验。出现这个现象的原因可能是他们不关注考试成绩和证书,只关注学习过程。基于以上数据挖掘结果,为了取得较好的教学效果,我们建议MOOC课程应该积极引导学生参与论坛的发帖,重视课程网页和课件的设计,同时可考虑改进平时测验的内容和方式,关注学习者的需求,以便引起学员注意,让学员积极主动地完成测验。关键词:Weka;学习成绩;数据分析;MOOC中图分类号:G4 文献标志码:A 文章编号:2096-0069(2021)02-0068-07
百到几十万不等,但学员中断学习现象依旧突出,真
正完成学习并获得结业证书的人数相对较少。因此,
本文以北京大学2015年在Coursera平台上线的一门课
程(简称为A课程)为例,基于学校提供的课程后台
数据,从学员在该课程中的网上学习行为包括发帖、
作业、测试等方面入手,使用数据挖掘工具Weka分析
影响学员学习成绩的因素[1]。
一、数据处理及描述性统计分析
(一)课程注册人数及及格率
该课程共有8019位学员注册,去除授课教师、
助教以及没有参与任何学习活动的学员之后,剩余
真正学员6167位,其中919位学员有学习成绩(即grade>0),约占真正学员总人数的14.9%,5248位学
聚类分析实验报告体会(3篇)
第1篇
随着大数据时代的到来,数据挖掘技术在各个领域得到了广泛应用。聚类分析作为数据挖掘中的关键技术之一,对于发现数据中的潜在结构具有重要意义。近期,我参与了一次聚类分析实验,通过实践操作,我对聚类分析有了更深入的理解和体会。
一、实验背景与目的
本次实验旨在通过实际操作,掌握聚类分析的基本原理和方法,并运用SQL
Server、Weka、SPSS等工具进行聚类分析。实验过程中,我们构建了合规的数据集,并针对不同的数据特点,选择了合适的聚类算法进行分析。
二、实验过程与步骤
1. 数据准备:首先,我们需要收集和整理实验所需的数据。数据来源可以是公开数据集,也可以是自行收集的数据。在数据准备过程中,我们需要对数据进行清洗和预处理,以确保数据的准确性和完整性。
2. 数据探索:对数据集进行初步探索,了解数据的分布特征、数据量、数据类型等。这一步骤有助于我们选择合适的聚类算法和数据预处理方法。
3. 建立数据模型:根据实验目的和数据特点,选择合适的聚类算法。常见的聚类算法有K-means、层次聚类、密度聚类等。在本实验中,我们选择了K-means算法进行聚类分析。
4. 聚类分析:使用所选算法对数据集进行聚类分析。在实验过程中,我们需要调整聚类参数,如K值(聚类数量)、距离度量方法等,以获得最佳的聚类效果。
5. 结果分析:对聚类结果进行分析,包括分类关系图、分类剖面图、分类特征和分类对比等。通过分析结果,我们可以了解数据的潜在结构和规律。
6. 实验总结:对实验过程和结果进行总结,反思数据理解、特征选择与预处理、算法选择、结果解释和评估等方面的问题。
三、实验体会与反思
1. 数据理解的重要性:在进行聚类分析之前,我们需要对数据有深入的理解。只有了解数据的背景、分布特征和潜在结构,才能选择合适的聚类算法和参数。
2. 特征选择与预处理:特征选择和预处理是聚类分析的重要步骤。通过选择合适的特征和预处理方法,可以提高聚类效果和模型的可靠性。 3. 算法选择:不同的聚类算法适用于不同的数据类型和场景。在选择聚类算法时,我们需要考虑数据特点、实验目的和计算效率等因素。
数据挖掘weka实现步骤
1.数据格式转换(xml-csv-arff)
2.数据挖掘 (离散化)
weka.filters.unsupervised.attribute.Discretize”,(用此算法离散)
实现后可以统计不同流量集中情况。
3实现可视化 步骤:
(需要修改数据(使数据只剩时间和流量:每个用1,2个数字表示))
4 实现关联分析:(关联分析概念)
:使用 先转换格式:
实际操作:
再选算法和修改属性
结论:
另外i还可以实现:分类与回归:(建议:再网上找几张图,借一个图,做简单的解释)
回归于分类:实现的是对未来的上网时间段(或者上网流量)预测分析
聚类分析:k-means算法;
实现把分散的点 聚类到一起。从而实现上网时间段的集中百分比。
基于Weka平台的会员制超市客户分类分析
经营管理
基于Weka平台的会员制
超市客户分类分析
一朱慧云李正扬南京信息工程大学经济管理学院
[摘要]会员制超市的客户数据直接反映了客户的购买行
为,对其研究可以了解客户的特点和偏好。使用weka系统,运用
分类分析中的不同算法对会员制超市的客户数据进行分析,得到了
一些有益的分析结果,对会员制超市管理人员更好的了解用户,并
制定出有益于企业的决策有重要意义..
[关键词]weka客户分类决策树贝叶斯支持向量机
根据著名的--/\法则,企业80%的利润来源于20%的客户,所
以。对于企业而言,对客户进行细分,并分析不同类别客户的特点
和偏好,以采取不同的管理措施是很重要的。数据挖掘技术可以帮
助企业分析其海量的客户数据,获得有用的客户信息。FoodMart
是美国一家大型的连锁会员制超市,以会员制作为基本的销售和服
务方式。本文采用理论与实践相结合的研究方法,应用Weka中的
分类技术,依据FoodMart会员制超市的客户数据,挖掘数据库中
隐含的客户分类信息。
一、Weka及相关算法简介
Weka的全名是怀卡托智能分析环境,是一款免费的,非商业
化的,基于JAVA环境下的,开源的数据挖掘软件。Weka集合了大
量的数据挖掘算法,可以实现数据预处理、属性选择、关联分析、
分类分析、回归、聚类分析等功能,同时还提供了数据可视化功
能。Weka系统得到了广泛的认可,是现今最完备的数据挖掘工具
之一。
决策树算法通过应用简单的决策规则,建立树状图,可用于
分类分析和预测。C4.5决策树算法是数据挖掘领域的经典算法,
它构造简单,速度较快,产生的分类规则易于理解,准确率较高。
Weka的J48决策树模型是对Quinlan的C4 5决策树算法的实现,并加
入了比较好的剪枝过程,有非常好的精度。
随机森林算法生成k个决策树组成随机森林,其输出的类别是
由k个决策树输出的类别的众数而定。随机森林算法可以评估变量