
对《多元线性回归模型在物流成本预测中的应用》的解读
对《多元线性回归模型在物流成本预测中的应用》的解读一. 内容简介本文以国家宏观物流成本数据为研究对象,应用多元回归分析理论,对影响物流成本的相关指标进行分析,建立了线性回归模型,通过物流成本的统计分析,使企业可以从全局的角度了解自身的物流运作现状,明确目前关键的瓶颈问题以及突破口,提出解决的方法,以提高企业整体的运作绩效。
二.研究过程(一)变量选择全国宏观物流成本总额(Y )由运输成本(1X )、保管成本(2X )、包装及货损成本(3X )、信息及管理成本(4X )组成,根据1996—2012年统计数据(见表1)进行多元线性回归分析。
表1 1996-2012年我国宏观物流成本T1X2X3X4XY1996 3320.27 831.81863.98755.213775.271997 3479.92 1073.15 923.43 800.078 4279.5781998 3835.47 1080.25 1084.51 920.77 4923 19994484.621180.79 1324.61046.46037.4120004814.341484.351599.781169.67068.0720015332.082093.072341.1616579422.3120026284.412506.52815.152065.811669.8620036181.032699.62908.682191.811978.1120045909.082593.623372.542676.8612548.120056726.752150.533361.872631.3912865.5420067293.91828.344083.12839.0714038.4120077719.871934.324500.93010.1415158.2320088125.481886.165119.063419.1216541.8220098759.882088.966340.672921.8818102.39201010165.862316.257794.663208.1620474.92201110879.822510.538776.163379.2322847.54201211955.272667.649684.273864.2924231.14(二)数据分析输入数据到EViews,进行回归分析,回归分析结果(见表2)。
表2 Y-X1、X2、X3、X4最小二乘法回归结果Dependent Variable: YMethod: Least SquaresSample: 1996 2012Included observations: 17Variable Coefficient Std. Error t-Statistic Prob.C-1757.210768.0691-2.2878280.0411X10.9284330.285424 3.2528270.0069X20.9276050.206280 4.4968340.0007X3 0.767229 0.221608 3.462104 0.0047 X41.4770410.2397656.1603660.0000R-squared 0.998212 Mean dependent var 12703.63 Adjusted R-squared 0.997616 S.D. dependent var 6362.436 S.E. of regression 310.6257 Akaike info criterion 14.55498 Sum squared resid 1157860. Schwarz criterion 14.80005 Log likelihood -118.7174 Hannan-Quinn criter. 14.57934 F-statistic 1675.155 Durbin-Watson stat 2.156717Prob(F-statistic)0.00000020.998R = 1675.155F = 2.15..6717DW =由运行结果看出,可决系数2R 与2R 均接近于1,综合度量回归模型对样本观测值拟合优较好;取α=0.05,F 检验值为1675.155,P 值约等于0,说明结果显著;再通过自变量1X 、2X 、3X 、4X 的pro(t-Statistic)值看它们的拟合效果,分别是0.0411、0.0069、0.0007、0.0047和0.0000,,其pro(t-Statistic)值均小于α,结果显著,拒绝原假设,说明它们与Y 显著相关,通过t 检验。
回归方程为:12341757.21042656 0.9284334868* 0.927605379971* 0.767228510887* 1.47704071679*Y X X X X =-++++ (1)(三)统计检验1.异方差性检验对上述模型(1)利用怀特(White )检验方法:首先,利用OLS 估计模型(1)获得残差2e i ;其次,作残差平方2e i 对所有原始变量、变量平方、变量交叉乘积的回归分析,得到辅助方程;最后,检验的零假设是:不存在异方差,对辅助方程的2R 作2χ检验。
回归模型(1)的残差平方2e i 与1X 、2X 、3X 、4X 及其平方项与交叉项作辅助回归,得表3:由此,可以得到:Dependent Variable: E2 Method: Least Squares Sample: 1996 2012 Included observations: 17VariableCoefficient Std. Error t-Statistic Prob. C 2236829. 2269530. 0.985591 0.4282 X1 -2075.663 1820.925 -1.139895 0.3724 X2 568.8256 908.4419 0.626155 0.5951 X3 2479.778 2007.109 1.235497 0.3421 X4 73.03167 1326.322 0.055063 0.9611 X1^2 0.362248 0.326036 1.111066 0.3822 X2^2 -0.162650 0.191098 -0.851134 0.4843 X3^2 0.630742 0.372518 1.693184 0.2325 X4^2 -1.769893 0.320301 -5.525715 0.0312 X1*X2 -0.103007 0.326672 -0.315322 0.7824 X1*X3 -1.277665 0.661778 -1.930654 0.1933 X1*X4 0.744850 0.351265 2.120475 0.1681 X2*X3 -0.128733 0.362658 -0.354970 0.7565 X2*X4 0.478599 0.416110 1.150173 0.3690 X3*X40.7784900.2140713.6365940.0680R-squared 0.993744 Mean dependent var 68109.41 Adjusted R-squared 0.949948 S.D. dependent var 152879.0 S.E. of regression 34202.52 Akaike info criterion 23.34263 Sum squared resid 2.34E+09 Schwarz criterion 24.07781 Log likelihood -183.4123 Hannan-Quinn criter. 23.41571 F-statistic 22.69058 Durbin-Watson stat 2.335532Prob(F-statistic)0.042982212342212223412132236828.510842075.66289125*568.825578278*2479.77814849*73.0316721908*0.36224765939*0.162649583518*0.630742305614* 1.76989327541*0.103006871448** 1.27766492815**e X X X X X X X X X X X X =-++++-+---+142324340.744849572006**0.128732802655**0.478598946928**0.778490064165**X X X X X X X X -++(2)20.993R =,怀特统计量216.8936nR =,在5%的显著性水平下,自由度为14的2χ分布的相应临界值20.0523.7χ=> 16.8936,因此接受原假设,即不存在异方差。
2.序列自相关性检验对模型(1)采用D.W.检验法检验序列的自相关性,在上述的表1结果中已经显示:.. 2.1567DW =,当n=17,k=4(不包含常数项),查表得 1.03L d = , 1.67U d =,由于[].. 2.15674U U d DW d <=<-,得该模型无自相关性。
3.比较预测结果与真实值表4 模型预测结果与真实值比较YY21996 3775.270 3875.377 1997 4279.578 4359.353 1998 4923.000 4997.896 1999 6037.410 6063.614 2000 7068.070 7044.419 2001 9422.310 9378.475 2002 11669.86 11613.62 2003 11978.11 11954.63 2004 12548.10 12676.17 2005 12865.54 12948.97 2006 14038.41 14036.76 2007 15158.23 15103.78 200816541.8216514.042009 18102.39 17493.96 2010 20474.92 20548.55 2011 22847.54 22397.34 201224231.1424954.7404,0008,00012,00016,00020,00024,00028,000图1 模型预测结果与真实值比较-.04-.03-.02-.01.00.01.02.03.04Relative Error图2 模型预测结果与真实值的相对误差合图1和图2,真实值与预测值的相对误差在0.04以内变化,模型的拟合结果较好。
预测模型在物流公司业务中的应用研究

预测模型在物流公司业务中的应用研究随着物流行业的不断发展壮大,越来越多的物流公司开始转向数字化、信息化发展,大多数物流公司开始采用各种信息系统管理业务,其中,预测模型应用技术越来越受到关注。
预测模型是指通过对历史数据进行统计、分析并建立数学模型,从而预测未来的趋势或结果。
预测模型在物流公司中的应用研究越来越受到关注,本文将就这一话题展开探讨。
一、预测模型在物流公司中的基本原理预测模型是通过对大量的历史数据进行分析和统计分析,来确定影响物流公司经营成功与否的各种因素,并建立数学模型来预测未来的趋势。
预测模型常用的方法有时间序列分析法、回归分析法、灰色预测法和神经网络法等。
其中,通过时间序列分析法的预测模型所得到的预测结果往往比较可信,因为该方法所研究的数据序列是时间上的连续序列,因此具有很强的可靠性和准确性。
二、预测模型应用于物流企业的优势1. 降低物流成本物流企业可以通过建立时间序列模型来进行需求预测,从而实现对公司物流成本的优化调整。
通过建立由供应商到消费者的物流可视化模型,物流企业可以预测出物流需求,并根据需求量和客户规模制定合理的运输方案,从而降低物流成本。
2. 提高物流服务质量通过预测模型的应用,物流企业可以提高其服务质量,例如对于季节性需求的高峰期间,企业可以对预测到的订单量提前采取一定的物流措施,避免过期、短缺等现象产生,提高物流服务质量。
3. 优化仓储管理通过预测未来的需求和销售量,物流企业可以调整其仓储储备、库存量等方面,从而优化仓储管理,减少库存积压,降低存储成本,提高利润水平。
4. 实现安全高效的运输物流企业可以通过将预测模型应用于实时跟踪和路线规划中,提高车辆和货物的安全性,在保障运输安全的同时,增加运输效率,提高企业管理效益。
三、预测模型在物流公司中的应用案例1. 顺丰速运顺丰速运利用自主研发的智能分拣装备、地面虚拟监管系统和智能化运输管理系统,打造出来具有高效、安全和可靠特点的高品质物流服务。
基于多元线性回归模型的物流领域标准实施效益评价

学术交流基于多元线性回归模型的物流领域标准实施效益评价江平 路欢欢(上海市质量和标准化研究院)摘要:以2001~2018年物流行业GDP、运输线路长度、货运量、平均就业人数、标准化水平等统计数据作为基础样本数据,建立物流领域标准实施效益分析多元线性回归模型。
通过Eviews统计分析软件,对回归方程进行估计并检验,分析标准实施对物流行业经济发展的边际影响。
结果表明,标准实施对物流行业经济发展具有显著的正相关关系,标准化水平每提高1个单位,GDP将增长0.03%。
关键词:多元线性回归模型 物流 标准实施效益评价Evaluation of Standards Implementation Benefit in Logistics Field Based on Multiple Linear Regression ModelJiang Ping, Lu Huanhuan(Shanghai Institute of Quality and Standardization)Abstract: Based on the statistical data of GDP, length of transportation routes, freight volume, average number of employed person and standardization level of logistics industry from 2001 to 2018 as the basic sample data, this paper establishes a multiple linear regression model for the benefit analysis of logistics standards implementation. In Eviews software, we tried to estimate and test the regression equation of the model. Then we evaluated the marginal impact of standard implementation on the economic development of logistics industry. The results show that: the implementation of standards has a significant positive correlation with the economic development of logistics industry, and the GDP will increase by 0.03% for one unit increase of standardization level.Key words: multiple linear regression model, logistics, evaluation of standards implementation benefit1 引言标准的实施可有效提高行业的标准化水平,为行业发展带来切实的经济效益[1-2]。
基于多元线性回归的区域物流需求组合预测方法_毛敏
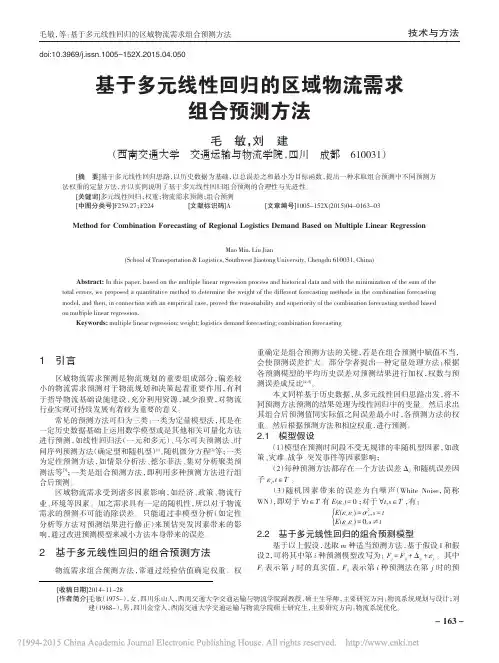
ë1
...
1
0û
ë1
û
当
d
≠
0
时,α∗k
=
dk
/d(或可写成
α∗ i
=
di
/d
);当
d
=
0
时,有
无限个解,任取其中一组可行解,该解说明其中一些预测方法
可以用其他预测方法线性表示。
nm
m
∑∑ ∑ 然后证明 ( αiFij - Fj)2 + λ( αi - 1) 的海森矩阵为半正
j=1 i=1
i=1
定的。根据定义求出其海森矩阵,如下:
毛敏,等:基于多元线性回归的区域物流需求组合预测方法
技术与方法
doi:10.3969/j.issn.1005-152X.2015.04.050
基于多元线性回归的区域物流需求 组合预测方法
毛 敏,刘 建
(西南交通大学 交通运输与物流学院,四川 成都 610031)
[摘 要]基于多元线性回归思路,以历史数据为基础,以总误差之和最小为目标函数,提出一种求取组合预测中不同预测方
êê j = 1 êê ⋮
∑ êêêê2 n F F mj 1j
ê j=1
... ⋱ ...
n
∑ 2 F F 1j mj j=1
⋮
n
∑ 2 F F mj mj j=1
∑ 1ùúúú
⋮úú
∑ 1úúúú
ú
éêα⋮1ùú ëêêαλmûúú
=
éêêêêêêêêêê22
j j
n = n =
11⋮FF1mjjFFjjùúúúúúúúúúú
∑∑ ∑ 方 法 ,改 目 标 函 数 为 Minìí n ( m αiFij - Fj)2üý ,其 中
浅谈多元线性回归模型及其应用

浅谈多元线性回归模型及其应⽤1多元线性回归模型的概念及基本假设1.1多元线性回归模型的概念多元线性回归模型是⽤两个或两个以上的解释变量来解释因变量的⼀种模型[]1。设为Y 因变量,k X X X ,21 ,,为k 个⽤来说明Y 的被称为解释变量的不同变量,其中1X 恒等于1,则),,2,1(,221n i X X Yi ki k i i =++++=µβββ (1)式 称为多元线性回归模型。其中,),,2,1(n i i =µ为随即扰动项;参数k βββ,,,21 称为回归系数。若令
=? =?=? =n k kn nnk k n X X X X X X X X X X Y Y Y Y µµµµββββ212121222121211121,,,,则(1)式可⽤矩阵形式表⽰为:µβ+=X Y (2)式。 1.2多元线性回归模型的基本假设 1.2.1 随机扰动项的数学期望为零即0)()()()(21=?
=n E E E E µµµµ,这意味着βX Y E =)(为线性回归模型(2)的总体回归函数。 1.2.2 随机扰动项i µ的⽅差相等即221)()()(σµµµ====n D D D ,也称为同⽅差性。 1.2.3 随机扰动项µ和解释变量X 不相关 数学表达式为:0),(=X COV µ。1.2.4 解释变量之间不存在多重共线性
所谓多重共线性是指解释变量之间存在完全或近似完全的线性相关[]2。 1.2.5 随机扰动项µ为服从正态分布的随机向量2多元线性回归模型的参数估计要想确定多元线性回归模型),,2,1(,221n i X X Y i ki k i i =++++=µβββ,则必须估计出回归系数k βββ,,,21 的值。在回归分析中,使⽤最⼴泛的⽅法是最⼩⼆乘法,⼀般称为普通最⼩⼆乘法[]3,即使残差平⽅和最⼩的回归系数的估计。设与总体回归模型(1)式对应的样本回归模型为:
),,2,1(,221n i X X Y i ki k i i =++++=∧∧∧∧µβββ (4)式,或⽤矩阵表⽰为:∧∧+=µβX Y ,其中∧β为总体回归系数β的最⼩⼆乘估计,∧µ为残差向量。根据最⼩⼆乘法的定义,在线性样本回归模型中,使残差平⽅和最⼩的回归系数的估计称为最⼩⼆乘估计。即使)()(''∧∧∧∧--=ββµµX Y X Y 最⼩的∧β。其中∧'µ是∧µ的转置。为使∧β最⼩,可将)()(''∧∧∧∧--=ββµµX Y X Y 看作是∧β的函数,则其关于∧β的⼀阶偏导数必须为零,即02'2''=+-=??∧∧∧∧ββµµX X Y X )(,因此得到⽅程Y X X X ''=∧β,所以Y X X X '1')(-∧=β。虽然计算过程⼗分复杂,但是在如今的计算机时代可以运⽤相关的统计软件(如Eviews3.0)对回归系数进⾏估计。3回归系数及回归⽅程的显著性检验3.1 回归系数的显著性检验运⽤上⾯的计算⽅法或者通过计算机的运⾏可以得出回归系数k βββ,,,21 的估计,但所估计的回归系数在给定的显著性⽔平α下是否具有显著性呢?这需
多元线性回归模型的估计与解释

多元线性回归模型的估计与解释多元线性回归是一种广泛应用于统计学和机器学习领域的预测模型。
与简单线性回归模型相比,多元线性回归模型允许我们将多个自变量引入到模型中,以更准确地解释因变量的变化。
一、多元线性回归模型的基本原理多元线性回归模型的基本原理是建立一个包含多个自变量的线性方程,通过对样本数据进行参数估计,求解出各个自变量的系数,从而得到一个可以预测因变量的模型。
其数学表达形式为:Y = β0 + β1X1 + β2X2 + ... + βnXn + ε其中,Y为因变量,X1、X2、...、Xn为自变量,β0、β1、β2、...、βn为模型的系数,ε为误差项。
二、多元线性回归模型的估计方法1. 最小二乘法估计最小二乘法是最常用的多元线性回归模型估计方法。
它通过使残差平方和最小化来确定模型的系数。
残差即观测值与预测值之间的差异,最小二乘法通过找到使残差平方和最小的系数组合来拟合数据。
2. 矩阵求解方法多元线性回归模型也可以通过矩阵求解方法进行参数估计。
将自变量和因变量分别构成矩阵,利用矩阵运算,可以直接求解出模型的系数。
三、多元线性回归模型的解释多元线性回归模型可以通过系数估计来解释自变量与因变量之间的关系。
系数的符号表示了自变量对因变量的影响方向,而系数的大小则表示了自变量对因变量的影响程度。
此外,多元线性回归模型还可以通过假设检验来验证模型的显著性。
假设检验包括对模型整体的显著性检验和对各个自变量的显著性检验。
对于整体的显著性检验,一般采用F检验或R方检验。
F检验通过比较回归平方和和残差平方和的比值来判断模型是否显著。
对于各个自变量的显著性检验,一般采用t检验,通过检验系数的置信区间与预先设定的显著性水平进行比较,来判断自变量的系数是否显著不为零。
通过解释模型的系数和做假设检验,我们可以对多元线性回归模型进行全面的解释和评估。
四、多元线性回归模型的应用多元线性回归模型在实际应用中具有广泛的应用价值。
多元线性回归分析预测法

多元线性回归分析预测法(重定向自多元线性回归预测法)多元线性回归分析预测法(Multi factor line regression method,多元线性回归分析法)[编辑]多元线性回归分析预测法概述在市场的经济活动中,经常会遇到某一市场现象的发展和变化取决于几个影响因素的情况,也就是一个因变量和几个自变量有依存关系的情况。
而且有时几个影响因素主次难以区分,或者有的因素虽属次要,但也不能略去其作用。
例如,某一商品的销售量既与人口的增长变化有关,也与商品价格变化有关。
这时采用一元回归分析预测法进行预测是难以奏效的,需要采用多元回归分析预测法。
多元回归分析预测法,是指通过对两上或两个以上的自变量与一个因变量的相关分析,建立预测模型进行预测的方法。
当自变量与因变量之间存在线性关系时,称为多元线性回归分析。
[编辑]多元线性回归的计算模型[1]一元线性回归是一个主要影响因素作为自变量来解释因变量的变化,在现实问题研究中,因变量的变化往往受几个重要因素的影响,此时就需要用两个或两个以上的影响因素作为自变量来解释因变量的变化,这就是多元回归亦称多重回归。
当多个自变量与因变量之间是线性关系时,所进行的回归分析就是多元性回归。
设y为因变量,为自变量,并且自变量与因变量之间为线性关系时,则多元线性回归模型为:其中,b0为常数项,为回归系数,b1为固定时,x1每增加一个单位对y的效应,即x1对y的偏回归系数;同理b2为固定时,x2每增加一个单位对y的效应,即,x2对y的偏回归系数,等等。
如果两个自变量x1,x2同一个因变量y呈线相关时,可用二元线性回归模型描述为:其中,b0为常数项,为回归系数,b1为固定时,x2每增加一个单位对y的效应,即x2对y的偏回归系数,等等。
如果两个自变量x1,x2同一个因变量y呈线相关时,可用二元线性回归模型描述为:y = b0 + b1x1 + b2x2 + e建立多元性回归模型时,为了保证回归模型具有优良的解释能力和预测效果,应首先注意自变量的选择,其准则是:(1)自变量对因变量必须有显著的影响,并呈密切的线性相关;(2)自变量与因变量之间的线性相关必须是真实的,而不是形式上的;(3)自变量之彰应具有一定的互斥性,即自变量之彰的相关程度不应高于自变量与因变量之因的相关程度;(4)自变量应具有完整的统计数据,其预测值容易确定。
基于多元线性回归模型的上海市物流需求分析
基于多元线性回归模型的上海市物流需求分析谈成薇;朱贺;赵晓敏【摘要】In this paper, selecting the cargo transportation volume as the index measuring the logistics demand level, we analyzed empirically the economic data of Shanghai for the period between 2000 and 2013, used the Eviews program to build a multiple linear regression model and found that the total import/export volume had the most marked impact on the cargo transportation volume of the city.%选取货运量作为物流需求水平的指标,通过对上海市2000年至2013年的GDP、三大产业产值、进出口贸易总额、居民消费水平、社会消费品零售总额等经济数据进行实证分析,运用Eviews构建多元线性回归模型,且研究发现进出口贸易总额对上海货运量的影响最为显著。
因此,大力发展进出口贸易将推动上海市物流需求水平的大幅提高。
【期刊名称】《物流技术》【年(卷),期】2016(035)001【总页数】4页(P34-37)【关键词】物流需求;多元线性回归模型;实证分析;上海【作者】谈成薇;朱贺;赵晓敏【作者单位】上海大学管理学院,上海 200444;上海大学管理学院,上海200444;上海大学管理学院,上海 200444【正文语种】中文【中图分类】F259.27;F224现代物流作为一种从生产到消费对产品进行高效率组织和管理的方式,被认为是继生产和营销之后的“第三利润源泉”。
物流业作为现代服务行业中一个极其重要的组成部分,正在全球范围内飞速发展,俨然已成为一个具有广阔前景和增值功能的新兴服务业[1]。
多元线性回归模型
多元线性回归模型多元线性回归模型是一种广泛应用于统计学和机器学习领域的预测模型。
它通过使用多个自变量来建立与因变量之间的线性关系,从而进行预测和分析。
在本文中,我们将介绍多元线性回归模型的基本概念、应用场景以及建模过程。
【第一部分:多元线性回归模型的基本概念】多元线性回归模型是基于自变量与因变量之间的线性关系进行建模和预测的模型。
它假设自变量之间相互独立,并且与因变量之间存在线性关系。
多元线性回归模型的数学表达式如下:Y = β0 + β1X1 + β2X2 + … + βnXn + ε其中,Y表示因变量,X1、X2、…、Xn表示自变量,β0、β1、β2、…、βn表示回归系数,ε表示误差项。
回归系数表示自变量对因变量的影响程度,误差项表示模型无法解释的部分。
【第二部分:多元线性回归模型的应用场景】多元线性回归模型可以应用于各种预测和分析场景。
以下是一些常见的应用场景:1. 经济学:多元线性回归模型可以用于预测GDP增长率、失业率等经济指标,揭示不同自变量对经济变量的影响。
2. 医学研究:多元线性回归模型可以用于预测患者的生存时间、治疗效果等医学相关指标,帮助医生做出决策。
3. 市场研究:多元线性回归模型可以用于预测产品销量、市场份额等市场相关指标,帮助企业制定营销策略。
4. 社会科学:多元线性回归模型可以用于研究教育水平对收入的影响、家庭背景对孩子成绩的影响等社会科学问题。
【第三部分:多元线性回归模型的建模过程】建立多元线性回归模型的过程包括以下几个步骤:1. 数据收集:收集自变量和因变量的数据,确保数据的准确性和完整性。
2. 数据清洗:处理缺失值、异常值和离群点,保证数据的可靠性和一致性。
3. 特征选择:根据自变量与因变量之间的相关性,选择最相关的自变量作为模型的输入特征。
4. 模型训练:使用收集到的数据,利用最小二乘法等统计方法估计回归系数。
5. 模型评估:使用误差指标(如均方误差、决定系数等)评估模型的拟合程度和预测性能。
多元回归分析结果解读
多元回归分析结果解读一、多元回归分析简介用回归方程定量地刻画一个应变量与多个自变量间的线性依存关系,称为多元回归分析(multiple linear regression),简称多元回归(multiple regression)。
多元回归分析是多变量分析的基础,也是理解监督类分析方法的入口!实际上大部分学习统计分析和市场研究的人的都会用回归分析,操作也是比较简单的,但能够知道多元回归分析的适用条件或是如何将回归应用于实践,可能还要真正领会回归分析的基本思想和一些实际应用手法!回归分析的基本思想是:虽然自变量和因变量之间没有严格的、确定性的函数关系,但可以设法找出最能代表它们之间关系的数学表达形式。
二、多元回归线性分析的运用具体地说,多元线性回归分析主要解决以下几方面的问题。
(1)确定几个特定的变量之间是否存在相关关系,如果存在的话,找出它们之间合适的数学表达式;(2)根据一个或几个变量的值,预测或控制另一个变量的取值,并且可以知道这种预测或控制能达到什么样的精确度;(3)进行因素分析。
例如在对于共同影响一个变量的许多变量(因素)之间,找出哪些是重要因素,哪些是次要因素,这些因素之间又有什么关系等等。
在运用多元线性回归时主要需要注意以下几点:首先,多元回归分析应该强调是多元线性回归分析!强调线性是因为大部分人用回归都是线性回归,线性的就是直线的,直线的就是简单的,简单的就是因果成比例的;理论上讲,非线性的关系我们都可以通过函数变化线性化,就比如:Y=a+bLnX,我们可以令t=LnX,方程就变成了Y=a+bt,也就线性化了。
第二,线性回归思想包含在其它多变量分析中,例如:判别分析的自变量实际上是回归,尤其是Fisher线性回归方程;Logistics回归的自变量也是回归,只不过是计算线性回归方程的得分进行了概率转换;甚至因子分析和主成分分析最终的因子得分或主成分得分也是回归算出来的;当然,还有很多分析最终也是回归思想!第三:什么是“回归”,回归就是向平均靠拢。
多元线性回归及logistics回归模型在上海市房价预测中的分析与应用
多元线性回归及logistics回归模型在上海市房价预测中的分析与应用山东大学威海分校吴铖、钟迪威、高利翠摘要国家统计局发布的信息显示,近几年我国房地产价格呈显著上升趋势。
而在全国各大中城市中一线城市如上海、北京、广州等俨然成为房价上涨的领头羊。
房价持续高速增长,无论对房地产业自身运营,还是对国民经济健康发展,乃至整个社会的和谐稳定,都将产生一定的负面影响。
对大中城市,尤其是一线城市的房价进行研究分析和预测,具有很强的实际意义。
本文选取上海为例,对房价的主要影响因素进行研究分析。
基于供求、成本理论及经济因素,本文从上海统计年鉴、国家统计年鉴收集官方数据,通过比较选取2002年至2009年上海市人均GDP、人均消费支出、商品房平均造价、中长期年平均贷款利率、商品房竣工面积、商品房销售面积、房地产业总投资额等作为影响房价的因素,建立多元线性回归模型,运用spss进行参数估计和检验,并利用2010年数据进行预测和检验,从而筛选出对房价影响的主要因素。
并用logistics模型对房价进行预测未来房价上涨的概率。
最后提出相关的控制房价过快上涨的建议。
通过多元线性回归模型我们得到,上海市人均GDP、中长期年平均贷款利率以及商品房销售面积是影响房价的主要因素,其中人均GDP更是首当其冲。
因此,政府若想有效的控制房价过快增长,首先应考虑控制经济过快增长。
同时,由于08年金融危机的到来导致房地产暂时出现平缓,而09年金融浪潮退去后,国家所实施的4万亿投资政策极大的刺激了房地产业,使得上海房地产业出现全面井喷现象,但由于近几年上海商品房销售面积并没有表现出强劲势头,因此未来几年这种势头将不会持续。
通过Logistics回归模型,我们得到房价上涨的概率是87.6%,这将影响经济的发展和加重人民的负担,由此政府必须采取相关政策来加强控制。
未来几年,如何抓住其增长较缓的拐点进行投资,是投资者所需关注的。
关键字:房价预测上海市多元线性回归模型Logistics回归模型目录摘要 (I)一.研究背景及现状 (1)二.问题的提出 (1)三.模型构建前的准备 (2)3.1模型假设 (2)3.2房价影响因素分析及变量选择 (2)3.3数据来源 (3)3.4数据处理 (4)四、多元线性回归预测及logistics回归模型 (5)4.1多元线性模型 (5)4.2 logistics回归模型及logistics回归分析的房地产预测模型 (6)五.实证分析 (6)5.1模型的参数估计 (6)5.2回归模型的检验 (7)5.2.1多元线性回归的残差检验 (7)5.2.2用逐步回归对模型进行分析 (8)5.2.3用Cook统计量进行异常值检验 (10)5.2.4 预测2010房价 (12)5.3结果分析 (12)5.3.1各因素与房价变动的相关关系 (12)5.3.2各因素对房价变动的贡献 (12)5.3.3异常值分析 (12)5.4结论及建议: (13)六.模型优点缺点及模型的改进 (13)参考文献 (13)附录 (14)一.研究背景及现状我国房地产业自20世纪80年代以来得到了快速发展,而且随着人们生活水平的提高和社会城镇化程度的增强,全国各大城市房地产业迅速崛起,这使得房地产业一直处于过热状态。