
第6讲 方差分析-拉丁方实验分析
拉丁方简介
以 n 个 拉 丁 字 母 A, B, C……,为元素,列出一个 n 阶方阵, ……,为元素, 阶方阵, 若这 n 个拉丁方字母在这 n 阶方阵 的每一行、 每一列都出现、 的每一行、 每一列都出现、且只出现 一次, 一次,则称该 n 阶方阵 为n×n 阶 拉 丁方阵。 丁方阵。
例如: 例如:
随机单位组设计的主要缺点 随机单位组设计的主要缺点
处理数目过多 ,各单位组内的供试动物数数 目也多, 使各单位组内供试动物的初始条件一致 目也多 , 使各单位组内供试动物的 初始条件一致 有一定难度, 故在随机单位组设计中, 有一定难度 , 故在随机单位组设计中 , 处理数要 不超过20为宜 不超过20为宜。 为宜。 配对设计是处理数为 的随机单位组设计, 配对设计是处理数为2的随机单位组设计,其 是处理数为2 优点是结果分析简单, 优点是结果分析简单 , 试验误差通常比非配对设 计小, 计小,但 试验动物配对要求严格,不允许将不满 试验动物配对要求严格 不允许将不满 配对要求严格, 足配对要求的试验动物随意配对 足配对要求的试验动物随意配对。 随意配对。
试验处理间遵循唯一差异原则
处理间比较时,除了试验处理不同外,其 处理间比较时,除了试验处理不同外, 它所有条件应当尽量一致 才具有可比性 它所有条件应当尽量一致,才具有可比性,使 条件应当尽量一致, 可比性, 比较结果可靠。 处理间的比较结果可靠 处理间的比较结果可靠。 如 不同种鼠的药物比较试验 ,各参试鼠 除了品种不同外,其它如性别、年龄、体重等 除了品种不同外,其它如性别 年龄、体重等 性别、 应一致,饲料和饲养管理等条件都应相同,才 应一致,饲料和饲养管理等条件都应相同, 等条件都应相同 能准确评定品种的优劣。 能准确评定品种的优劣。
完全随机设计的主要缺点 完全随机设计的主要缺点
1、由于未应用试验设计三原则中的 局部控制原则 ,非 试 验因素的影响被归 入试验误差,试验误差较大,试验的精确 入试验误差,试验误差较大, 性较低。 性较低。 2、在试验条件、环境、试验动物差 在试验条件、环境、 异较大时,不宜采用此种设计方法。 异较大时,不宜采用此种设计方法。
各个处理可互为对照 不必再设对照。 各个处理可 互为对照 , 不必再设对照 。 在 互为对照, 对某种动物作生理生化指标检验时, 对某种动物作生理生化指标检验时 , 所得数据 是否异常应与动物的正常值作比较, 是否异常应与动物的正常值作比较 , 动物的正 标准对照。 常值就是所谓的标准对照 在杂交试验中, 常值就是所谓的 标准对照 。 在杂交试验中 , 要 确定杂交优势的大小,须以亲本作对照, 确定杂交优势的大小 , 须以亲本作对照 , 这就 是试验对照。 试验对照。 另外, 自身对照, 另外, 自身对照,即处理与对照在同一动 用药前与 物上进行,如动物用药前 用药后生理指标的 物上进行 , 如动物 用药前 与 用药后 生理指标的 比较等。 比较等。
16
试验处理数 = 横行单位组数 = 直列单位组数=试验处理的重复数。 直列单位组数=试验处理的重复数。
• 在拉丁方设计试验结果统计分析时 , 在拉丁方设计试验结果统计分析时,
由于能将横行、 由于能将横行 、 直列二个单位组间的 变异从试验误差中分离出来, 变异从试验误差中分离出来 , 故拉丁 方设计的试验误差比随机单位组设计 方设计的 试验误差比随机单位组设计 小,试验精确性比随机单位组设计高
( 3 ) 试验方案中各因素水平的排列要灵 活掌握
采用等差法(等间距法) 等比法和随机法3 采用等差法(等间距法)、等比法和随机法3 玉米赤霉醇为例说明 为例说明: 种。以玉米赤霉醇为例说明: 等差法 是指各相邻两个水平数量之差相等, 是指各相邻两个水平数量之差相等, 如赋形剂( 不含玉米赤霉醇) 各水平的排列为 : 如赋形剂 ( 不含玉米赤霉醇 ) 各水平的排列为: 10mg 、 20mg 、 30mg , 其中 20mg 为中心水平 , 10mg、20mg、30mg,其中20mg为中心水平 为中心水平, 向上向下都相隔10mg。 向上向下都相隔10mg。 等比法 是指各相邻两个水平的数量比值相同, 是指各相邻两个水平的数量比值相同, 如赋形剂各水平的排列为7 mg、 15mg、 30mg、 如赋形剂各水平的排列为 7.5mg 、 15mg 、 30mg 、 60mg, 相邻两水平之比为1:2。 60mg, 相邻两水平之比为1
第六讲方差分析(四):
拉丁方实验 设计及统计分析
1
知识目标: 知识目标: • 掌握拉丁方试验设计方法; 掌握拉丁方试验设计方法; • 掌握拉丁方试验结果统计分析方法。 掌握拉丁方试验结果统计分析方法。
技能目标: 技能目标: • 学会拉丁方试验设计; 学会拉丁方试验设计; • 学会拉丁方试验结果统计分析。 学会拉丁方试验结果统计分析。
随机法 是指因素各水平随机排列,如赋形剂 是指因素各水平随机排列, 各水平排列为15mg、 10mg 、 40mg 、 30mg 各水 各水平排列为 15mg 、 10mg、 40mg、 30mg各水 平的数量无一定关系。 平的数量无一定关系。 3、试验方案中必须设立作为比较标准的对照 动物试验 目的:通过比较来鉴别处理效应大 目的: 好坏等。则试验方案应包括:各试验处理, 小、好坏等。则试验方案应包括:各试验处理, 任何试验都不能缺少对照, 比较的对照 。任何试验都不能缺少对照,否则就 不能显示出试验的处理效果 。根据研究的目的与 内容,选择不同的对照形式。 内容,选择不同的对照形式。 如进行添加微量元素试验中,添加微量元素为 如进行添加微量元素试验中, 处理组,不添加微量元素为对照,此时对照为空 处理组,不添加微量元素为对照,此时对照为空 白对照。进行几种微量元素添加量的比较试验。 白对照。进行几种微量元素添加量的比较试验。
三、完全随机设计的优缺点
完全随机设计是一种最简单的设计方法: 完全随机设计是一种最简单的设计方法:
完全随机设计的主要优点
1、设计容易 处理数与重复数都不受限制, 处理数与重复数都不受限制, 适用于试验条件、环境、 适用于试验条件、环境、试验动物差异较小的 试验。 试验。 2、统计分析简单 无论所获得的试验资 料各处理重复数相同与否,都可采用 t 检验或 料各处理重复数相同与否, 方差分析法进行统计分析。 方差分析法进行统计分析。
随机单位组设计
随机单位组设计的主要优点: 随机单位组设计的主要优点:
* 设计与分析方法简单易行。 设计与分析方法简单易行 简单易行。
* 由于随机单位组设计体现了试验设计三原 在对试验结果进行分析时, 则 , 在对试验结果进行分析时 , 将 单位组间的变 异从试验误差中分离出来, 有效地降低试验误差, 异从试验误差中分离出来 , 有效地降低试验误差 , 提高了试验精确性。 提高了试验精确性。 * 把条件一致的实验动物分在同一单位组, 把条件一致的实验动物分在同一单位组, 再将同一单位组的实验动物随机分配到不同处理 再将同一单位组的实验动物随机分配到不同处理 组内,加大了处理组间的可比性。 组内,加大了处理组间的可比性。
或设置几个加不同剂量微量元素处理组、 或设置几个加不同剂量微量元素处理组、一个 不添加微量元素对照, 不添加微量元素对照,即一个包含多个处理的单因 素试验方案。若进行微量元素不同添加剂量 不同添加剂量与 素试验方案。若进行微量元素不同添加剂量与不同 品种猪的饲养试验 则安排一个二因素试验方案。 的饲养试验, 品种猪的饲养试验,则安排一个二因素试验方案。 注意:一个试验中研究的因素不宜过多, 注意:一个试验中研究的因素不宜过多,否则 处理数太多,试验过于宠大, 处理数太多,试验过于宠大,试验干扰因素难以控 凡是能用简单方案的试验,就不用复杂方案。 制。凡是能用简单方案的试验,就不用复杂方案。 2、根据各试验因素的性质分清水平间差异 各因素水平可根据不同课题、 各因素水平可根据不同课题 、 因素的特点及 动物的反应能力来确定, 动物的反应能力来确定,以使处理的效应容易表现 出来。 出来。
第六节 拉丁方实验设计
拉丁方设计是从横行 直列两 拉丁方设计是从 横行 和 直列 两 横行和 双重局部控制, 个方向进行双重局部控制 使得横 个方向进行 双重局部控制 , 使得 横 直列两向皆成单位组的设计 两向皆成单位组的设计。 行 和 直列 两向皆成单位组的设计 。 在拉丁方设计中, 在拉丁方设计中 , 每一行或每一列 都成为一个完全单位组, 都成为一个完全单位组 , 而每一处 理在每一行或每一列都只出现一次, 理在每一行或每一列都只出现一次 , 即在拉丁方设计中: 即在拉丁方设计中:
(二)拟定试验方案
1、根据试验的目的、任务和条件挑选试验因 根据试验的目的、 拟定方案时, 素 拟定方案时,在正确掌握生产中存在的问 题后,对试验目的、任务进行仔细分析, 题后,对试验目的、任务进行仔细分析,抓住关 突出重点。 键,突出重点。 首先要挑选对试验指标影响较大的关键因素 首先要挑选对试验指标影响较大的关键因素。 要挑选对试验指标影响较大的关键因素。 若只考察一个因素,则可采用单因素试验。 若只考察一个因素,则可采用单因素试验。若是 考察两个以上因素,则应采用多因素试验。如进 考察两个以上因素,则应采用多因素试验。 行猪饲料添加某种微量元素的饲养试验, 行猪饲料添加某种微量元素的饲养试验,在拟定 试验方案时, 试验方案时,设置一个添加一定剂量微量元素的 处理和不添加微量元素的对照, 处理和不添加微量元素的对照,得到 一 个包 含2 个处理的单因素试验方案
A B B A
B A A B
为2×2阶拉丁方,2×2阶拉丁方只 阶拉丁方, 有这两个。 有这两个。
A B C B C A C A B
为3×3阶拉丁方。 阶拉丁方。
第一行与第一列的拉丁字母按自然顺序 排列的拉丁方, 标准型拉丁方。 排列的拉丁方,叫标准型拉丁方。 3×3阶标准型拉丁方只有上面1种, 标准型拉丁方只有上面1 4×4阶标准型拉丁方有4种, 标准型拉丁方有4 5×5阶标准型拉丁方有56种。若变换标 标准型拉丁方有56种 准型的行或列,可得到更多种的拉丁方。 准型的行或列,可得到更多种的拉丁方。 进行拉丁方设计时, 进行拉丁方设计时 , 可从上述多种拉丁 方中随机选择一种;或选择一种标准型, 方中随机选择一种;或选择一种标准型,随 机改变其行列顺序后再使用。 机改变其行列顺序后再使用。
6 单因素拉丁方实验设计
b2
b3
b4
6、实验设计模型 YiJkl = μ + αj +βk +γ l+εpooled (i=1,2,……,n; j=1,2, ……,p) (k=1,2, ……,p;l=1,2, ……,p) 其中:YiJ:被试 i 在处理水平 j 上的分数 μ :总体平均数 αj:水平j的处理效应 β k :水平K的无关变量B的变异 γ l:水平L的无关变量C的变异 εpooled:误差变异,包括:方格单元内误差变异 和残差变异 二、单因素拉丁方验设计与计算举例 (一)研究的问题与实验设计 文章生字密度对阅读理解的影响研究
B、拉丁方实验的误差变异
首先进行F检验,以考察两个误差变异是否存在显著性差 异,F=MS残差/MS单元内,如果差异显著,表明实验设计是 不合适的;如果不显著,则两个误差项都可以用来作为F 检验的误差项,也可以合并,公式为:
SS残差 SS单元内 MS残差 pooled 0.966 2 p c1 c2
a2 2 3 a1 2 2 a4 12 13 a3 8 7
c3 c4
a3 6 5 a2 4 3 a1 5 6 a4 12 11 a4 9 8 a3 7 6 a2 6 4 a1 7 5
b1
b2
b3
b4
a1 3 4 a4 8 7 a3 8 9 a2 5 4
c1
b1 N=2 a1 7 a4 15 a3 17
拉丁方实验设计的简单评价:
优点:比完全随机、随机区组实验设计更加有效,可以分
离出两个无关变量
通过对方格单元内误差与残差做F检验,可以检验
实验设计的正确性
缺点:自变量与无关变量之间没有交互作用的假设在很多
情况下保证
方差分析
二期矽肺 100.67 93.47 74.97 88.06 113.52 101.14 95.10 118.98
三期矽肺 97.58 83.58 103.81 107.10 108.42 82.58 89.01 77.11
方差分析的基本思想
总变异:从例中看出,32个观察值大小参差不 齐,这种个体值与总均数之间的差异称为总变 异。
多个样本均数间的多重比较
多个样本均数间的多重比较:也称为两两 比较,主要用于探索与证实多组均数中, 哪两个总体均数间有差别,哪两个均数间 没有差别。 如果多组均数的比较采用两样本均数比较 的t检验,会加大I型错误。
多个样本均数间的多重比较
LSD-t检验:最小显著差法
容易获得P<0.05,但是假阳性率较高;
完全随机设计资料的方差分析
方差分析结果表 变异来源 总 组间 组内 SS 86.740 45.091 41.649 ν 39 3 36 MS F P <0.05
15.030 12.990 1.157
3.确定P值和作出推断结论:以ν组间=3,ν组内=36, 查F界值表得P<0.05, 按α=0.05水准拒绝H0 ,接受 H1,故可以认为给予不同剂量的三菱莪术液,小鼠瘤 重间差别有统计学意义。
方差分析
主要内容
方差分析的基本思想 完全随机设计、随机区组设计、拉丁方设 计、交叉设计和析因设计资料方差分析的 基本过程
多个样本均数的比较
两个样本均数的比较:
1次t-test,α=0.05;
三个样本均数的比较:
3次t-test,α=1-(1-0.05)3=0.14;
四个样本均数的比较:
6次t-test,α=1-(1-0.05)6=0.26;
方差分析1132页PPT

单因子方差分析的统计模型
在例中我们只考察了一个因子,称其为单因子 试验。
通常,在单因子试验中,记因子为 A, 设其有r 个水平,记为A1, A2,…, Ar。
在每一水平下考察的指标可以看成一个总体 ,因为现共有 r 个水平,故有 r 个总体, 假定:
数理统计在化学中的应用
各总体的方差相同:
nm
SSe
(Xij Xi)2
i1 j1
mn
mn
SST
(Xij X)2
[(Xij Xi)(Xi X)]2
i1 i1
i1 j1
mn
mn
mn
(Xij Xi)2
(Xi X)]2 2
(Xij Xi)(Xi X)
i1 j1
i1 j1
i1 j1
mn
mn
m
n
(Xij Xi)2
(Xi X)2 2 (Xi X) (Xij Xi)
1
2=
22=…=
2 r
=
2
;(即
,具有方差齐次性)
从每一总体中抽取的样本是相互独立的, 即 所有的试验结果 yij 都相互独立。
每一总体均为正态总体,记为 N(i , i 2), i =1, 2,…, r ;
数理统计在化学中的应用
我们要比较各水平下的均值是否相同, 即要对如下的一个假设进行检验:
1、从总变差中区分出试验变差和条件变差,也就是将 不同因素的影响给区分开来。
2、利用F检验比较这两个变差的大小,确定出主要变 差。
3、根据主要的变差,去选择较好的分析条件,或确定 进一步试验的方向。
数理统计在化学中的应用
方差分析的基本思想
方差分析的依据是建立在变差平方和具有加和性的基础 上的。因此,如果用变差平方和来表征测定结果的总变 差,那么总变差的平方和就等于各变异因素形成的变差 平方和的总和。
拉丁方资料方差分析-PPT资料28页

排序:得秩次
R=1, 2, 6, 5, 4, 3
BCDEFA ABCDEF EFABCD FABCDE CDEFAB DEFABC
1,2列对调
C BD E F A B AC D E F F EA B C D A FB C D E D CE F A B E DF A B C
设计步骤
列变换:
读取6个两位数的随机数27,29,99,72,68,53
拉丁方设计资料的方差分析
拉丁方
• 用r个拉丁字母排成r行r列的方阵,使每行 每列中每个字母都只能出现一次,这样的 方阵叫r阶拉丁方或r×r拉丁方。
ABC BCD CDE
ABCDE BCDEF CDEFA DEFAB EFABC
特点
• 同时分别研究三个因素:一个处理因素, 两个控制因素
• 设计严密,双向误差控制 • 样本含量小
注射部位编号(列区组)
2 B(75) A(81) E(73) F(68) C(64) D(77)
3 E(81) D(87) B(74) C(69) F(72) A(82)
4 D(75) C(85) A(78) B(74) E(76) F(61)
5 A(84) F(64) D(73) E(76) B(70) C(82)
C
4
A
F
C
B
E
D
5
D
C
F
E
B
A
6
E
D
A
F
C
B
表4-11 例4-5拉丁方设计与试验结果(皮肤疱疹大小,mm2)
家兔编号 (行区组)
1 2 3 4 5 6
1 C(87) B(73) F(73) A(77) D(64) E(75)
第六章方差分析详解演示文稿

C
i1 j1
i1 j1
N
Yij2 C=(N 1)S 2
i, j
总 N 1
校正系数:
第十四页,共67页。
a
(
ni
Yij
)2
N
(Yij )2
C i1 j1
i,j
N
N
ni
a
a (
Y )2 ij
SS组间 ni (Yi Y )2
i1
i1
j 1
ni
C
SS组内
a ni
(Yij
Yi )2
药剂
苗高观察值
A
18 21 20 13
B
20 24 26 22
C
10 15 17 14
D
28 27 29 32
总和Ti 72 92 56
116
平均 xi
18 23 14 29
经方差分析得下表:
变异来源
DF SS
MS
F
显著F值
药剂处理间
3
504
168.00 20.56** F 0.05(3,12)=3.49
均方差,均方(mean square,MS)
各部分偏差平方和除以各自的自由度便可得到
总均方、处理间均方和处理内均方, 分别记为
MST(或 )、SMT2St(或 )和MSSt2 e(或
Se2
即
MST ST2 SST / dfT
MS t
S
2 t
SSt
/ df t
MS e
S
2 e
SS e
/ df e
D
28 27 29 32
116
平均 xi
18 23 14 29
拉丁方试验设计方案统计分析
拉丁方实验设计及分析1前言“拉丁方”的名字最初是由R、A、Fisher给出的。
拉丁方设计(latin square design)是从横行和直列两个方向进行双重局部控制,使得横行和直列两向皆成单位组,是比随机单位组设计多一个单位组的设计。
在拉丁方设计中,每一行或每一列都成为一个完全单位组,而每一处理在每一行或每一列都只出现一次,也就是说,在拉丁方设计中,实验处理数=横行单位组数=直列单位组数=实验处理的重复数。
在对拉丁方设计实验结果进行统计分析时,由于能将横行、直列二个单位组间的变异从实验误差中分离出来,因而拉丁方设计的实验误差比随机单位就在于提供对实验处理顺序的控制,使实验条件均衡,抵消由于实验处理的先后顺序的影响而产生的顺序误差,因而也可称之为抵消法设计。
组设计小,实验精确性比随机单位组设计高。
拉丁方设计又叫平衡对抗设计(baIanced design)、轮换设计。
这三个名称是从其模式、作用和方法三个不同的角度来说明这种设计的意义。
所谓平衡对抗设计,是指在实验中,由于前一个实验处理往往会影响后一个实验处理的效果,而该实验设计的作用。
所谓轮换设计,是指在实验中,由于学习的首因效应,先实验的内容,被试容易记住;又因为学习的近因效应,对于刚刚学过的内容,被试回忆的效果一般也较好。
因此、在实验方法上,有必要使不同实验条件出现的先后顺序轮换,使情境条件以及先后顺序对各个实验组的机会均等,打破顺序界限。
所谓拉丁方设计,是指平衡对抗设计的结构模式,犹如拉丁字母构成的方阵。
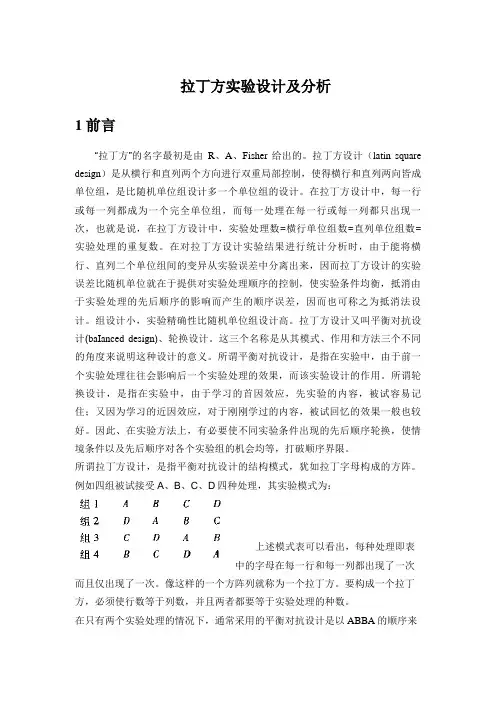
例如四组被试接受A、B、C、D四种处理,其实验模式为:上述模式表可以看出,每种处理即表中的字母在每一行和每一列都出现了一次而且仅出现了一次。
像这样的一个方阵列就称为一个拉丁方。
要构成一个拉丁方,必须使行数等于列数,并且两者都要等于实验处理的种数。
在只有两个实验处理的情况下,通常采用的平衡对抗设计是以ABBA的顺序来安排实验处理的顺序。
或者把单组被试分为两半.一半按照ABBA的顺序实施处理,另一半按照BAAB的顺序实施处理。
5第六章方差分析
练习
• 以小鼠研究正常肝核糖核酸(RNA)对癌细 胞的生物学作用,试验分为对照组(生理 盐水)、水层 RNA组和酚层RNA组,分别用 此三种不同处理诱导肝细胞的FDP酶活力, 得数据如下。该三组资料均服从正态分布, 试比较三组均数有无差别?
ex_36.sas
表 6.1 对照组
2.79 2.69 3.11 3.47 1.77 2.44 2.83 2.52
复相关系数(确定系数),变异系数,均方根,总均数
对自变量的检验
R-Square:等于模型的平方和除以总 平方和,用于度量在因变量的变差 里能够由模型决定的比例有多少, 越接近1,效果越好。
检验的显著水平、自由度、 误差均方
具有相同字母的组间 均值差异没有统计学意义。
第2组具有A和B两个字母,所以 第二组和第三组,第一组均没有差异。
单因素方差分析
假设某单因素试验有k个处理,每个处理有n次重 复,共有nk个观测值。这类试验资料的数据模式
如下表所示。
(一)总平方和的分解 在上表中,反映全部观测值总变异的总平方和
是各观测值xij与总平均数的离均差平方和,记 为SST。即
kn
SST
( xij x.. ) 2
i1 j 1
nj 组内样本容量j 1,2,,n ki 组数,即水平数i 1,2,,k x.. 总平均数 xij i水平下第 j个样样本
变 差
组间 变差
总 变 差 组内 变差
组数(水平数)
(二)总自由度的剖分
在计算总平方和时,资料中的各个观测值要
kn
受 (xij x这..) 一0 条件的约束,故总自由度等于 i1 j1
资料中观测值的总个数减1,即kn-1。
dfT kn 1 df t k 1 df e dfT df t
卫生统计学第六章方差分析详解演示文稿
三、方差分析的基本思想: 总变异可分解为组间变异和组内变异两个部
分,相应的总自由度也分解为组间自由度和 组内自由度。如果各样本均数来自同一总体, 即各组之间无差别,则组间变异和组内变异 均只反映随机误差,这时若计算组间均方与 组内均方的比值,F=MS组间/MS组内,应接 近1。反之,若各样本均数不是来自同一总 体,组间变异较大,F值将明显大于1。要大 到多大程度才有统计学意义?
第七页,共37页。
基本思想:根据资料变异的不同来源,将全 部观察值总的离均差平方和和自由度分解为 两个或多个部分,除随机误差外,其余每个 部分的变异可由某个因素的作用(或某几个因 素的交互作用)加以解释,如各组均数间的变 异SS组间,可由处理因素的作用加以解释, 通过比较不同变异来源的均方,用F分布作 出统计推断,从而了解该因素对观察指标有 无影响。
中1指分子均方的自由度, 2为分母均方的 自由度。F=11.164>F0.01(3,16)=5.29,故 P<0.01。认为四组均数间差别有高度统计学 意义
第十三页,共37页。
各组样本含量相等和各组样本含量不等时, 计算的基本方法完全一样,只是在计算l组间 时有所不同,相等时将ni直接用n计算即可。
4、求l日期 5、求l防护服 6、求l误差 7、自由度:总格子数减1为总变异自由度,
第十五页,共37页。
2、此外,同一受试对象不同时间点上的观 察,或同一样本给予不同处理的比较,亦当 作随机区组设计进行分析。
3、由于区组内个体特征比较一致,减少了 个体间变异对结果的影响,统计效率高,易 检出组间的差别。
4、用两因素方差分析two-way ANOVA,两 因素指研究因素和区组因素。研究因素有k 个水平,共n个区组。
4、三种变异的关系
拉丁方试验设计及统计分析
拉丁方试验设计及分析1前言“拉丁方”的名字最初是由R、A、Fisher给出的。
拉丁方设计(latin square design)是从横行和直列两个方向进行双重局部控制,使得横行和直列两向皆成单位组,是比随机单位组设计多一个单位组的设计。
在拉丁方设计中,每一行或每一列都成为一个完全单位组,而每一处理在每一行或每一列都只出现一次,也就是说,在拉丁方设计中,试验处理数=横行单位组数=直列单位组数=试验处理的重复数。
在对拉丁方设计试验结果进行统计分析时,由于能将横行、直列二个单位组间的变异从试验误差中分离出来,因而拉丁方设计的试验误差比随机单位就在于提供对实验处理顺序的控制,使实验条件均衡,抵消由于实验处理的先后顺序的影响而产生的顺序误差,因而也可称之为抵消法设计。
组设计小,试验精确性比随机单位组设计高。
拉丁方设计又叫平衡对抗设计(baIanced design)、轮换设计。
这三个名称是从其模式、作用和方法三个不同的角度来说明这种设计的意义。
所谓平衡对抗设计,是指在实验中,由于前一个实验处理往往会影响后一个实验处理的效果,而该实验设计的作用。
所谓轮换设计,是指在实验中,由于学习的首因效应,先实验的内容,被试容易记住;又因为学习的近因效应,对于刚刚学过的内容,被试回忆的效果一般也较好。
因此、在实验方法上,有必要使不同实验条件出现的先后顺序轮换,使情境条件以及先后顺序对各个实验组的机会均等,打破顺序界限。
所谓拉丁方设计,是指平衡对抗设计的结构模式,犹如拉丁字母构成的方阵。
例如四组被试接受A、B、C、D四种处理,其实验模式为:上述模式表可以看出,每种处理即表中的字母在每一行和每一列都出现了一次而且仅出现了一次。
像这样的一个方阵列就称为一个拉丁方。
要构成一个拉丁方,必须使行数等于列数,并且两者都要等于实验处理的种数。
在只有两个实验处理的情况下,通常采用的平衡对抗设计是以ABBA 的顺序来安排实验处理的顺序。
或者把单组被试分为两半.一半按照ABBA的顺序实施处理,另一半按照BAAB的顺序实施处理。
拉丁方试验设计及统计分析
拉丁方试验设计及分析1前言“拉丁方”的名字最初是由R、A、Fisher给出的。
拉丁方设计(latin square design)是从横行和直列两个方向进行双重局部控制,使得横行和直列两向皆成单位组,是比随机单位组设计多一个单位组的设计。
在拉丁方设计中,每一行或每一列都成为一个完全单位组,而每一处理在每一行或每一列都只出现一次,也就是说,在拉丁方设计中,试验处理数=横行单位组数=直列单位组数=试验处理的重复数。
在对拉丁方设计试验结果进行统计分析时,由于能将横行、直列二个单位组间的变异从试验误差中分离出来,因而拉丁方设计的试验误差比随机单位就在于提供对实验处理顺序的控制,使实验条件均衡,抵消由于实验处理的先后顺序的影响而产生的顺序误差,因而也可称之为抵消法设计。
组设计小,试验精确性比随机单位组设计高。
拉丁方设计又叫平衡对抗设计(baIanced design)、轮换设计。
这三个名称是从其模式、作用和方法三个不同的角度来说明这种设计的意义。
所谓平衡对抗设计,是指在实验中,由于前一个实验处理往往会影响后一个实验处理的效果,而该实验设计的作用。
所谓轮换设计,是指在实验中,由于学习的首因效应,先实验的内容,被试容易记住;又因为学习的近因效应,对于刚刚学过的内容,被试回忆的效果一般也较好。
因此、在实验方法上,有必要使不同实验条件出现的先后顺序轮换,使情境条件以及先后顺序对各个实验组的机会均等,打破顺序界限。
所谓拉丁方设计,是指平衡对抗设计的结构模式,犹如拉丁字母构成的方阵。
例如四组被试接受A、B、C、D四种处理,其实验模式为:上述模式表可以看出,每种处理即表中的字母在每一行和每一列都出现了一次而且仅出现了一次。
像这样的一个方1 / 15阵列就称为一个拉丁方。
要构成一个拉丁方,必须使行数等于列数,并且两者都要等于实验处理的种数。
在只有两个实验处理的情况下,通常采用的平衡对抗设计是以ABBA 的顺序来安排实验处理的顺序。