
机内码与国标码的关系
西文字符由于数量较少(通常不超过128个),所以采用1个字节(8位)就能完成对所有的西文字符的编码,ASCⅡ码规定西文字符的编码只使用字节的低7位(从第1位到第7位),最高位设为0。
所以ASCⅡ码的编码范围是十进制数0~127(写成十六进制即00H~7FH)。
汉字的个数远比西文字符多,国家标准规定的最常用和较常用的汉字便近8000个。
显然,如果象西文字符那样采用1个字节对汉字编码就不够了。
所以国家标准规定,每个汉字的编码都采用2个字节表示。
汉字国标码的一个特点是,尽可能与西文字符的ASCⅡ码相一致。
所以汉字国标码的每个字节都只采用其最低7位(从第1位到第7位)。
最高位仍然取0。
汉字国标码的取值范围是十进制数33~126(写成十六进制即21H~7EH)。
举例来说,“天”字国标码的两个字节分别是76、108(十进制),写成十六进制是4CH,6CH,写成二进制便是01001100B,01101100B:“天”的国标码:
0100110001101100
第2字节第1字节
汉字国标码作为一种国家标准,是所有汉字编码都必须遵循的一个共同标准,但由于国标码每个字节的最高位都是0,这正好与ASCⅡ码相冲突。
例如“天”字的国标码是76、108,而西文字符“L”和“l”的ASCⅡ码也恰好是76和108,现在假如内存中有两个字节76、108,这到底是一个汉字“天”呢,还是两个西文字符“L”和“l”?都有可能,这就出现了二义性。
显然国标码在计算机内部是不可能直接使用的,必须对其进行某种变换后才可以使用。
其变换方法便是将国标码双字节的每个字节都加上128,相当于将国标码每个字节的最高位即第8位都由0变成1,其余7位不变。
这种经过变换的国标码就是汉字的机内码。
显然汉字机内码的每个字节都大于128,这就与西文字符的ASCⅡ码区分开了(ASCⅡ码都小于128)。
例如,上面举的汉字“天”的国标码是76、108,将国标码的每个字节都加128,就得到其机内码204、236(均是十进制),写成十六进制就是CCH、ECH,写成二进制便是11001100B、11101100B。
每个字节的第8位都由0变成了1,其余位不变。
“天”的机内码:
1100110011101100
第2字节第1字节
通过以上分析可看出,汉字国标码在两个字节中占用7位,而汉字机内码在每个字节中的8位全占用了。
在计算机内部实际采用都是机内码而不是国标码。
还要指出的是,机内码是个相当广泛的概念,凡是计算机内部实际采用的汉字代码都叫机内码,我们以上所说的是采用双字节并且将国标码的每个字节的最高位都置为1,这只是目前一种最常用的汉字机内码方案,但汉字内码不止这一种,如台湾等地采用的就不是这种机内码方案,但这同样也叫机内码。
汉字的机内码、国标码和机内码关系

汉字的机内码机内码是内部存储、处理汉字时使用的编码,用两个字节表示一个汉字;将国标码的两个字节高位置1,避免与ASCII码冲突;区位码、国标码和机内码关系:区位码是一种基于GB2312-80字符集(94行×94列)的输入码,使用十进制表示其区码(范围01~94)和位码(范围01~94),各占两位,故每个汉字对应4位十进制数码(范围0101~9494)。
国标码则用16进制表示两个字节,其每字节编码范围21h~7Eh(即十进制33~126二进制00100001~01111110),前后字节分别对应区位码的区码(加上32或20h)和位码(加上32或20h),故汉字国标码编码范围2121h~7E7Eh。
机内码也用16进制表示两个字节,将国标码的前后两个字节最高位置1(即各加80h)就变成机内码,其每字节编码范围A1h~FEh(即二进制10100001~11111110),故汉字机内码编码范围为A1A1h~FEFEh。
例: 汉字区位码国标码机内码沪270600011011 00000110+ 00100000 0010000000111011 00100110 =3B2610111011 10100110=BBA6久303500011110 00100011+ 00100000 0010000000111110 01000011 =3E4310111110 11000011=BEC3区位码区码位码各加上32或20h国标码两个字节最高位置1(即各加128或80h)机内码A1A1~FEFE(十进制) (十六进制) (十六进制)0101~5E5E(十六进制)沪: 2706(十进制) 3B26 (十六进制)BBA6 (十六进制) 1B06 (十六进制)久: 3035(十进制) 3E43 (十六进制)BEC3 (十六进制) 1E23 (十六进制)。
汉字区位码、国标码(交换码)和机内码转换方法

汉字区位码、国标码(交换码)和机内码转换方法一般换算全部用十六进制。
机内码、国际码是十六进制的,区位码是十进制的。
具体换算步骤:(H表示十六进制,D表示十进制)1.将四位区号分为两部分,两位数为一组。
2.把这两个数字转换成十六进制,用公式计算。
国际码=区位码(十六进制)+2020H机内码=国际码+8080H例如:某汉字的区位码是2534。
则25D=19H,34D=22H则国际码=1922H+2020H=3952H,机内码=3952H+8080H=B9D2H 1、转换关系:【设转为十六进制的区位码为区位码I;转换原因在第3点】•区位码I=区位码的区码(前两位)和位码(后两位)分别转十六进制再按原顺序组合起来•国标码•=区位码I+2020H 【2020H不拆分】•机内码=国标码+8080H【8080H不拆分】•机内码=区位码I+A0A0H【A0A0H不拆分】注意:区位码是十进制表示,由区(行)和位(列)组成一个二维结构,所以转换过程需要将区位码拆分后分别转十六进制。
2、例子:•将“江”的区位码2913转为机内码【末尾D代表十进制,末尾H代表十六进制】:1、2913D中区和位分别转十六进制:29D=1DH,13D=DH2、国标码=区位码+2020H=1D0DH+2020H=3D2DH3、机内码=国标码+8080H=3D2DH+8080H=BDADHor 机内码=区位码+A0A0H=1D0DH+A0A0H=BDADH3、扩展【扩展内容主要与为什么要加2020H或8080H这些有关】:区位码:每个汉字都有唯一的定位码,定位码一个字节,定位码一个字节,总共占用两个字节。
国标码:。
共7445个字符,其中一级3755个,二级3008个,图形符号682个【一级汉字按拼音排序,二级用部首排序】,全部国家标准代码被放置在94个区域中,每个区域中有94个矩阵。
每个字节占用8位,主要使用7位编码(高位为0)。
- 为啥要将区位码转为国标码?汉字编码之前,已经有了标准的ASCII,开发者只沿用了ASCII中32个控制字符其他ASCII被覆盖。
初级电子商务技术员上午试题-1_真题-无答案
初级电子商务技术员上午试题-1(总分77,考试时间90分钟)单项选择题1. HTTP默认的TCP端口号是 (66) 。
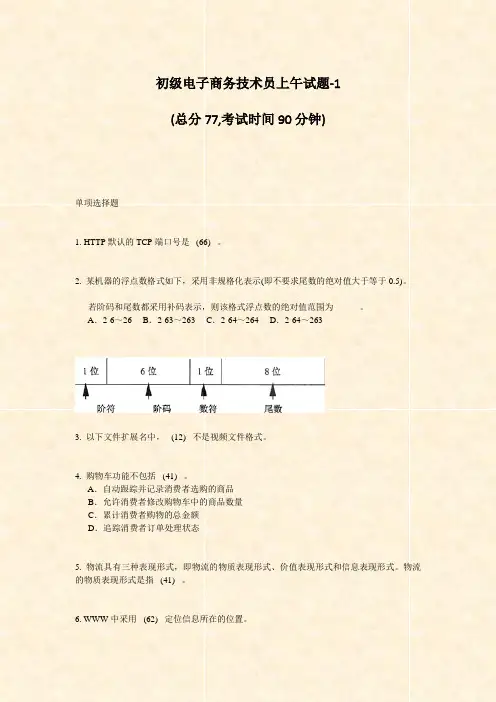
2. 某机器的浮点数格式如下,采用非规格化表示(即不要求尾数的绝对值大于等于0.5)。
若阶码和尾数都采用补码表示,则该格式浮点数的绝对值范围为______。
A.2-6~26 B.2-63~263 C.2-64~264 D.2-64~2633. 以下文件扩展名中, (12) 不是视频文件格式。
4. 购物车功能不包括 (41) 。
A.自动跟踪并记录消费者选购的商品B.允许消费者修改购物车中的商品数量C.累计消费者购物的总金额D.追踪消费者订单处理状态5. 物流具有三种表现形式,即物流的物质表现形式、价值表现形式和信息表现形式。
物流的物质表现形式是指 (41) 。
6. WWW中采用 (62) 定位信息所在的位置。
在Word编辑状态下,若要多次复制Word中的格式,使用方法为:首先选中设置好格式的文字,在工具栏上 (1) 按钮,光标将变成格式刷的样式;然后,选中需要设置同样格式的 (2) ,即可将选定格式复制到多个位置。
取消格式刷时,只需在工具栏上再次单击格式刷按钮,或者按下Esc键即可。
7. A.双击“”图标 B.双击“”图标C.单击“”图标 D.单击“”图标8. A.文字,按下Ctrl+V组合键B.图像,按下Ctrl+V组合键C.文字,或将鼠标移到需要复制格式的段落内,再单击鼠标左键D.图像,或将鼠标移到需要复制格式的图像内,再单击鼠标左键9. “B to C”模式是指 (31) 模式。
10. 网站设计优化应以______为出发点。
A.用户需求 B.搜索引擎优化C.方便管理维护 D.网站安全11. (57) 不属于TCP/IP协议集。
12. (48) 技术可以保证信息的完整性和用户身份的确定性。
13. 在电子商务系统规划方法中,关键成功因素法(CSF)是通过了解企业目标、识别关键成功因素、识别性能的指标和标准、______四个步骤来实现的。
国标码区位码说明

1.国标码:“国家标准信息交换用汉字编码”(GB2312-80标准),简称国标码。
国标码是二字节码, 用两个七位二进制数编码表示一个汉字。
2.区位码:为了使每一个汉字有一个全国统一的代码,区位码是国家规定的94*94的一个方阵,其中每行叫做一个区,每列叫做一个位,组合起来就组成了区位码,我们可以在相关网站查询某个汉字的区位码,例如汉字“我”的区位码是46 50 ,标识“我”在46区,50位。
3.机内码:机内码是在计算机中存储的汉子编码。
三者之间的关系。
国标码=16进制的区位码+2020H机内码=国标码+8080H例如“我”的的区位码是46 50 这是10进制的转化为16进制:2E32H所以“我”的国标码:2E32H+2020H=4E52H所以“我”机内码:4E52H+8080H=CED2(其实就是把二进制国标码的最高位置1,注意看E和2都没有变化)机内码转化为2进制就可以再计算机中存储,这里面转化为10进制可以输出。
CED2的10进制为:52946,这里我们打开记事本,按住alt建,输入52946即可以看见“我”,因为52946是“我”的机内码的10进制。
这里面有两个问题:1.为什么不用区位码直接表示国标码,为要加上2020H?2.机内码为什么要在国标码的基础上加上8080H,而不是直接只用国标码作为机内码?这里我先解决第二个问题,国标码就是由2个ASCII码组成,为什么呢(这里简单介绍一下,后面会详细说明)?因为在英文中只有26个字母,所以用一个字节就可以表示了,用一个字节的话可以表示2^8个符号,就是256个符号,绰绰有余啊,于是外国人制订了规范,规定0-127(00000000-01111111)个字符他们用了,用来表示英文字符和一些符号,就是ASCII码,但是汉字有很多,256个根本就不够,于是国家就用两个ASCII来表示一个汉字,就是2个字节标识一个汉字,例如“保”的区位码为:1703,所以国标码为:1703的10进制+2020H=3123H,然而:31H 和23H在ASCII中式有值的,31H在ASCII中表示数字1,23H表示的是“#”(这个可以在网上查询),那么如果我以国标码作为机内码的话,如果内存中有两个字节为31H和23H,那么到底是表示汉字“保”呢?还是字符1#呢?这样就有了歧义,但是解决办法就有了,0-127不是被英文字符占了吗?那么我就用127之后的来表示不就可以了吗?于是我把汉字的两个字节每个字节机上128(16进制就是80H),于是问题解决了,汉字“保”的机内码变为:3123H+8080H=B2A3H(10进制就是45475),打开记事本按住alt+45475看看是不是“保”,这样就不会和英文的ASCII冲突了。
国标码、机内码、区位码、ASCⅡ

国标码、机内码、区位码国家标准代码:国标码国家标准代码,简称国标码。
是中华人民共和国的中文常用汉字编码集,亦为新加坡采用。
国家标准强制标准冠以“GB”,推荐标准冠以“GB/T”,国标码是一个四位十六进制数。
现时中华人民共和国官方强制使用GB 18030标准,但较旧的计算机仍然使用GB 2312。
“GB”在计算机领域中常常表示GB 2312-80或GB 18030-2005。
两者是汉语编码系统的标准,在中国大陆和新加坡用于简体中文。
机内码:国标码是不可能在计算机内部直接采用的,于是,;汉字的机内码采用变形国标码,其变换方法为:将国标码的每个字节都加上128,即将两个字节的最高位由0改1,其余7位不变,如:由上面我们知道,“保”字的国标码为3123H,前字节为00110001B,后字节为00100011B,高位改1为10110001B和10100011B 即为B1A3H,因此,“保”字的机内码就是B1A3H。
区位码1980年,为了使每一个汉字有一个全国统一的代码,我国颁布了第一个汉字编码的国家标准:GB2312-80《信息交换用汉字编码字符集》基本集,这个字符集是我国中文信息处理技术的发展基础,也是目前国内所有汉字系统的统一标准。
区位码是一个四位的十进制数,每个区位码都对应着一个唯一的汉字或符号,但因为十六进制数我们很少用到,所以大家常用的是区位码,它的前两位叫做区码,后两位叫做位码。
ASCⅡ目前计算机中用得最广泛的字符集及其编码,是由美国国家标准局(ANSI)制定的ASCII 码(American Standard Code for Information Interchange,美国标准信息交换码),它已被国际标准化组织(ISO)定为国际标准,称为ISO 646标准。
适用于所有拉丁文字字母,ASCII码有7位码和8位码两种形式。
简介因为1位二进制数可以表示(2^1)2种状态:0、1;而2位二进制数可以表示(2^2)4种状态:00、01、10、11;依次类推,7位二进制数可以表示(2^7)128种状态,每种状态都唯一地编为一个7位的二进制码,对应一个字符(或控制码),这些码可以排列成一个十进制序号0~127。
全国计算机等级考试二级MS Office高级应用选择题及答案

全国计算机等级考试二级MS Office高级应用全国计算机等级考试二级MS Office高级应用选择题:1、世界上第一台电子数字计算机ENIAC是(1946)年在美国问世的。
分析:1946年美国宾夕法尼亚大学研制的ENIAC是世界上第一台真正的电子计算机。
2、第三代计算机的主要元件是(中小规模集成电路)。
分析:第一代计算机的主要元件是电子管,第二代计算机的主要元件是晶体管,第三代计算机的主要元件是中小规模集成电路,第四代计算机的主要元件是大规模集成电路和超大规模集成电路。
3、英文CAM的含义是()。
分析:计算机辅助制造的英文缩写是CAM,计算机辅助设计的英文缩写是CAD,计算机集成制造系统的英文缩写是CIMS,计算机辅助教学的英文缩写是CAI。
4、.用计算机管理科技情报资料,是计算机在()的应用。
分析:用计算机管理科技情报资料,是计算机在信息处理方面的应用5、计算机语言的发展过程,依次是机器语言、()和高级语言。
分析:计算机语言依次经历了机器语言、汇编语言、高级语言三个阶段。
6、汉字机内码与国标码的关系是()。
分析:汉字机内码=汉字国标码+8080H7、计算机病毒是可以造成机器故障的()。
分析:计算机病毒是可以造成机器故障的一种破坏性程序。
8、计算机系统包括()两大部分。
分析:计算机系统包括硬件系统和软件系统两大部分。
9、一台完整的计算机硬件系统是由()、存储器、输入设备和输出设备等部分组成。
分析:一台完整的计算机硬件系统是由运算控制单元、存储器、输入设备和输出设备等部分组成。
10、影响磁盘存储容量的因素是()。
分析:影响磁盘存储容量的因素包括:磁盘面数、磁道数目、扇区数目等。
11、Cache的含义是()。
分析:Cache的含义是高速缓冲存储器,是为了协调CPU和RAM之间的速度差问题。
12、直接受CPU控制的存储器是()分析:直接受CPU控制的存储器是高速缓冲存储器。
13、操作系统的功能包括处理器管理、存储器管理、设备管理、文件管理和()分析:操作系统的功能包括五大部分:处理器管理、存储器管理、设备管理、文件管理和作业管理14、多媒体电脑的最重要特点是()。
一个汉字的机内码与国标码之间的差别是
一个汉字的机内码与国标码之间的差别是汉字在计算机中的表示方式非常重要,它涉及到了汉字的编码问题。
在早期的计算机系统中,由于存储容量有限,为了能够表示汉字字符,人们需要采用一种特殊的编码方式。
机内码(Internal Code)和国标码(GB Code)就是其中两种常见的编码方式。
首先,我们先来了解一下机内码。
机内码是计算机中用于表示字符的二进制代码。
在早期的计算机系统中,由于存储限制和Unicode 标准尚未广泛采用,每个计算机厂商都有自己的机内码标准。
这意味着不同的计算机系统在表示相同的汉字时,所用的机内码可以是不同的。
机内码采用的是定长编码方式,即每个字符都用固定的二进制位数来表示。
不同的机内码标准可以有不同的位数,常见的有16位和32位。
例如,国内著名的计算机厂商中海尔计算机采用的汉字机内码是16位的,而联想计算机则采用的是32位的机内码。
与机内码不同的是,国标码是中国制定的一种字符编码标准。
国标码也叫GB码,它是为了解决在计算机系统中表示汉字的问题而制定的。
国标码最初由中国电子工业部在1981年发布,后来又不断进行了更新和修订,目前最新的版本是GB18030。
国标码采用的是变长编码方式,即每个字符用不固定的二进制位数来表示。
国标码将汉字按照发音和字形进行分类,并为每个汉字分配了一个唯一的编码。
这种编码方式可以实现对几万个常用汉字进行表示。
所以,一个汉字的机内码与国标码之间的主要差别可以总结为以下几点:1. 编码方式不同:机内码采用的是定长编码方式,而国标码采用的是变长编码方式。
2. 编码位数不同:机内码可以是16位或32位,而国标码可以是不固定的位数,因为国标码采用的是变长编码方式。
3. 编码标准不同:不同的计算机厂商可能采用不同的机内码标准,而国标码是中国制定的一种字符编码标准。
4. 适用范围不同:机内码通常是特定计算机系统的内部编码方式,而国标码是用于在计算机系统中表示汉字的标准编码方式。
输入码、国标码、机内码、字型码
88--94区:自定义汉字区,可留作用户自己定义。
3.机内码
根据国标码的规定,每一个汉字都有了确定的二进制代码,但是这个代码在计算机内部处理时会与ASCII码发生冲突,为解决这个问题,把国标码的每一个字节的首位上加1。由于ASCII码只用7位,所以,这个首位上的“1”就可以作为识别汉字代码的标志,计算机在处理到首位是“1”的代码时把它理解为是汉字的信息,在处理到首位是“0”的代码时把它理解为是ASCII码。经过这样处理后的国标码就是机内码。
01--15区:是各种图形符号、制表符和一些主要国家的语言字母,其中01--09区为标准符号区,共有682个常用符号。
10--15区:为自定义符号区,可留作用户自己定义。
16--55区:是一级汉字区,共有3755个常用汉字,以拼音为序排列。
56--87区:是二级汉字区,共有3008个次常用汉字,以部首为序排列。
西文是拼音文字,基本符号比较少,编码比较容易,因此,在一个计算机系统中,输入、内部处理、存储和输出都可以使用同一代码。汉字种类繁多,编码比拼音文字困难,因此在不同的场合要使用不同的编码。通常有4种类型的编码,即输入码、国标码、内码、字形码。
① 输入码
输入码所解决的问题是如何使用西文标准键盘把汉字输入到计算机内。有各种不同的输入码,主要可以分为三类:数字编码、拼音编码和字编型码。
● 拼音编码。是以汉字读音为基础的输入方法。由于汉字同音字太多,输入后一般要进行选择,影响了输入速度。
● 字型编码。是以汉字的形状确定的编码,即按汉字的笔画部件用字母或数字进行编码。如五笔字型、表形码,便属此类编码,其难点在于如何拆分一个汉字。
② 国标码
又称为汉字交换码,在计算机之间交换信息用。用两个字节来表示,每个字节的最高位均为0,因此可以表示的汉字数为214=16384个。将汉字区位码的高位字节、低位字节各加十进制数32(即十六进制数的20),便得到国标码。例如“中”字的国标码为8680(十进制)或7468(十六进制)。这就是国家标准局规定的GB2312—80信息交换用汉字编码集。
汉字的国标码机内码区位码区别
汉字的国标码机内码区位码区别文字编码系列--汉字的国标码,机内码,区位码(gbcode查出的是区位码)1.国标码:“国家标准信息交换用汉字编码”(GB2312-80标准),简称国标码。
国标码是二字节码, 用两个七位二进制数编码表示一个汉字。
2.区位码:为了使每一个汉字有一个全国统一的代码,区位码是国家规定的94*94的一个方阵,其中每行叫做一个区,每列叫做一个位,组合起来就组成了区位码,我们可以在相关网站查询某个汉字的区位码,例如汉字“我”的区位码是46 50 ,标识“我”在46区,50位。
3.机内码:机内码是在计算机中存储的汉子编码。
三者之间的关系。
国标码=16进制的区位码+2020H机内码=国标码+8080H例如“我”的的区位码是46 50 这是10进制的转化为16进制:2E32H(46==2E,50==32)所以“我”的国标码:2E32H+2020H=4E52H所以“我”机内码:4E52H+8080H=CED2(其实就是把二进制国标码的最高位置1,注意看E和2都没有变化)机内码转化为2进制就可以再计算机中存储,这里面转化为10进制可以输出。
CED2的10进制为:52946,这里我们打开记事本,按住alt建,输入52946即可以看见“我”,因为52946是“我”的机内码的10进制。
这里面有两个问题:1.为什么不用区位码直接表示国标码,为要加上2020H?2.机内码为什么要在国标码的基础上加上8080H,而不是直接只用国标码作为机内码?这里我先解决第二个问题,国标码就是由2个ASCII码组成,为什么呢(这里简单介绍一下,后面会详细说明)?因为在英文中只有26个字母,所以用一个字节就可以表示了,用一个字节的话可以表示2^8个符号,就是256个符号,绰绰有余啊,于是外国人制订了规范,规定0-127(00000000-01111111)个字符他们用了,用来表示英文字符和一些符号,就是ASCII码,但是汉字有很多,256个根本就不够,于是国家就用两个ASCII来表示一个汉字,就是2个字节标识一个汉字,例如“保”的区位码为:1703,所以国标码为:1703的10进制+2020H=3123H,然而:31H 和23H在ASCII中式有值的,31H在ASCII中表示数字1,23H表示的是“#”(这个可以在网上查询),那么如果我以国标码作为机内码的话,如果内存中有两个字节为31H和23H,那么到底是表示汉字“保”呢?还是字符1#呢?这样就有了歧义,但是解决办法就有了,0-127不是被英文字符占了吗?那么我就用127之后的来表示不就可以了吗?于是我把汉字的两个字节每个字节机上128(16进制就是80H),于是问题解决了,汉字“保”的机内码变为:3123H+8080H=B2A3H(10进制就是45475),打开记事本按住alt+45475看看是不是“保”,这样就不会和英文的ASCII冲突了。
区位码,国标码和机内码
3
ASCII码编码表
000 0000 0001 0010 0011 0100 0101 0110 0111 1000 1001 1010 1011 1100 1101 1110 1111 NUL SOH STX ETX EOT ENQ ACK BEL BS HT LF VT FF CR SO SI 001 DLE DC1 DC2 DC3 DC4 NAK SYN ETB CAN EM SUB ESC FS GS RS US 010 SP ! “ # ¥ % & ′ ( ) * + , . / 011 0 1 2 3 4 5 6 7 8 9 : ; 〈 = 〉 ? A B C D E F G H I J K L M N O 100 101 P Q R S T U V W X Y Z [ 、 ] ^ _ 110 ‵ a b c d e f g h i j k l m n o 111 p q r s t u v w x y z { | } ~ DEL
9
二、汉字编码
2、汉字内码
汉字内码是用于汉字信息的存储、交换、检索 等操作的机内代码,一般采用两个字节表示。 汉字可以通过不同的输入法输入,但其内码在 计算机中是唯一的。 英文字符的机内代码是七位的ASCII码,当用一 个字节表示时,最高位为“0”。为了与英文字 符能相互区别,汉字机内代码中两个字节的最 高位均规定为“1”。 机内码等于汉字国标码加上8080H。例如“中” 字的机内码为D6D0H。
10
二、汉字编码
3、汉字字形码
汉字字形码是将汉字字形经过点阵数字化后形成 的一串二进制数,用于汉字的显示和打印。 根据汉字输出的要求不同,点阵有以下几种: 简易型汉字:16×16, 32字节/汉字 普通型汉字:24×24, 72字节/汉字 提高型汉字:32×32,128字节/汉字。 汉字字库:将所有汉字的字模点阵代码按内码顺 序集中起来,构成了汉字库。